数组把多个同类型的数据放在一起,元素个数至少为 1,类型必须相同。它在内存里占一整块连续空间,元素一个接一个排下去。这个布局决定了后面所有用法:下标怎么算、二维数组为什么按行排、sizeof 为什么能数出元素个数。
创建、类型和初始化
type arr_name[常量值];type 是元素类型,可以是 char、short、int、float,也可以是结构体这类自定义类型;arr_name 是数组名;方括号里是元素个数。存一个班 20 人的数学成绩:
int math[20];
char ch[8];
double score[10];
数组也有类型,去掉数组名剩下的部分就是类型:
| 声明 | 类型 |
|---|---|
int arr1[10]; | int[10] |
int arr2[12]; | int[12] |
char ch[5]; | char[5] |
int[10] 和 int[12] 是两个不同的类型,元素个数写在类型里。数组类型由元素类型和元素个数组合而成,所以这两种数组不能互相赋值;sizeof 也不必数元素,看类型就知道整块占多少字节。课件说“数组算是一种自定义类型”,这个说法不准确。数组是派生类型(derived type),由元素类型和元素个数组合出来,编译器自己就能算出它的大小,不需要使用者先造一个类型名。
初始化用大括号:
int a[5] = {1, 2, 3, 4, 5};   /* 完全初始化 */
int b[6] = {1};              /* 不完全初始化,第一个是 1,其余补 0 */
int c[3] = {1, 2, 3, 4};      /* 错误:初始化项太多,编译器必须报错 */
int b[6] = {1} 后面五个 0 是标准规定的:初始化列表没覆盖到的元素按零初始化。= {0} 常用来“全部清零”,它的含义是“第一个显式写 0,其余同样补 0”,不是只改第一个。
int c[3] 多写一个 4,MSVC 报“初始值太多”,GCC 报 excess elements in array initializer。
下标是相对首地址的偏移量
C 规定下标从 0 开始,n 个元素的下标是 0 到 n-1。访问用的 [] 叫下标引用操作符,它只做偏移和取值,不检查下标有没有越界。arr[i] 在标准里的定义是 *((arr) + (i)):先拿数组首地址,向后偏移 i 个元素,再解引用。偏移 0 就是第一个元素,所以从 0 开始不是历史习惯,是这条公式的直接结果。
#include <stdio.h>

int main(void)
{
    int arr[10] = {1, 2, 3, 4, 5, 6, 7, 8, 9, 10};

    printf("%d\n", arr[7]);   /* 8 */
    printf("%d\n", arr[3]);   /* 4 */
    return 0;
}
遍历整个数组,让循环变量产生全部下标:
int i = 0;

for (i = 0; i < 10; i++)
{
    printf("%d ", arr[i]);
}
输入也一样,把 printf 换成 scanf,取地址写成 &arr[i]:
for (i = 0; i < 10; i++)
{
    scanf("%d", &arr[i]);
}
下标的合法范围只有 0 到 n-1。arr[10] 已经越过末尾元素,*(arr + 10) 是未定义行为。C 不检查下标,越界写入不会立刻报错,可能改掉旁边一个变量的值,也可能什么都不发生;换编译器、换优化级别,结果又变。越界读同理,读到的不是数组里的数据。
两种最常见的越界来源,一个是边界多写一步,另一个是无符号倒序:
for (i = 0; i <= 10; i++)            /* 10 个元素,i 走到 10 就出界 */
{
    sum += arr[i];
}

for (size_t i = n - 1; i >= 0; i--)  /* i >= 0 恒真,0 再减 1 变成 SIZE_MAX */
{
    printf("%d ", arr[i]);
}
相邻元素的地址差一个 sizeof
把每个元素的地址打出来,连续性一目了然:
#include <stdio.h>

int main(void)
{
    int arr[10] = {1, 2, 3, 4, 5, 6, 7, 8, 9, 10};
    int i = 0;

    for (i = 0; i < 10; i++)
    {
        printf("&arr[%d] = %p\n", i, (void *)&arr[i]);
    }
    return 0;
}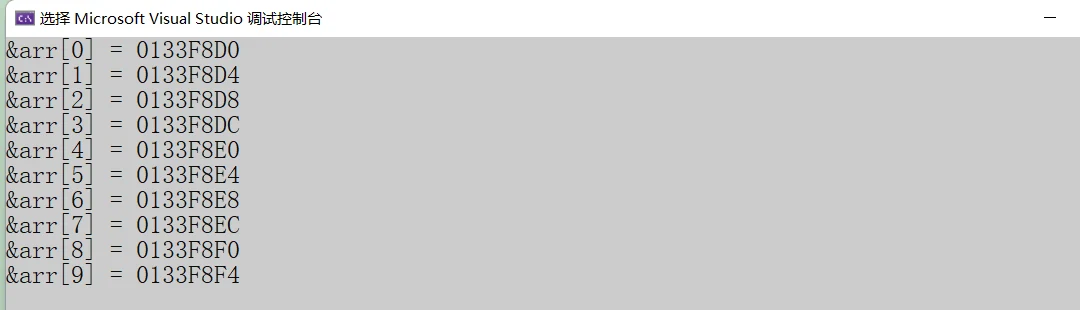
差值 4 不是常数,它等于元素类型的 sizeof。换成 double 数组,每两个相邻元素就差 8。知道首地址和步长之后,后面用指针遍历数组,无非是在这条关系上加偏移。
知道元素类型相同、大小相同,元素个数就能算:
#include <stdio.h>

int main(void)
{
    int arr[10] = {0};

    printf("%zu\n", sizeof(arr));          /* 40:整个数组的字节数 */
    printf("%zu\n", sizeof(arr[0]));       /* 4:一个元素的字节数 */
    printf("%zu\n", sizeof(arr) / sizeof(arr[0]));   /* 10:元素个数 */
    return 0;
}
上面三个数字都以 int 占 4 字节为前提;换一个 int 为 2 字节的平台,前两个会变成 20 和 2,元素个数仍是 10。
课件的三处示例都写成了 #include <stido.h>,这不是任何标准头文件,正确拼写是 stdio.h,照抄会直接找不到文件。同一段里还用 printf("%d\n", sizeof(arr)) 打印结果,sizeof 的类型是 size_t,应该配 %zu,%d 属于格式串和参数类型对不上。
sizeof(arr) / sizeof(arr[0]) 只在 arr 还是数组时成立。把数组名传给函数,它会退化成指向首元素的指针,函数里的 sizeof(arr) 变成指针大小,这个除法就失效了。所以数组传参要另外传一个长度参数。数组名只在少数场合保持“整个数组”的身份,例如作为 sizeof 或一元 & 的操作数;其余表达式里它都会退化成首元素指针。
二维数组是“数组的数组”
把一维数组当作另一个数组的元素,就得到二维数组:
type arr_name[行数][列数];int arr[3][5]; /* 3 行,每行 5 个 int */
double data[2][8];int arr[3][5] 的元素类型是 int[5],整个数组由 3 个这样的元素组成。它没有一张独立的“二维表类型”,只有嵌套的数组。拆开看:arr 的类型是 int[3][5],arr[0] 的类型是 int[5],arr[0][0] 才是 int。总元素数是行数乘列数,3×5 是 15 个 int,共 60 字节;由此也能算出 sizeof(arr[0]) 是 20。
初始化有四种写法:
int arr1[3][5] = {1, 2};                              /* 不完全初始化,其余补 0 */
int arr2[3][5] = {0};                                 /* 全部为 0 */
int arr3[3][5] = {1, 2, 3, 4, 5, 2, 3, 4, 5, 6, 3, 4, 5, 6, 7};   /* 按顺序填满 */
int arr4[3][5] = {{1, 2}, {3, 4}, {5, 6}};            /* 按行初始化 */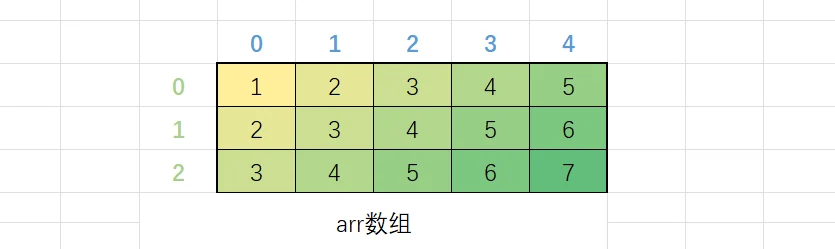
按行初始化时,每对内层大括号对应一行,没写到的位置补 0:
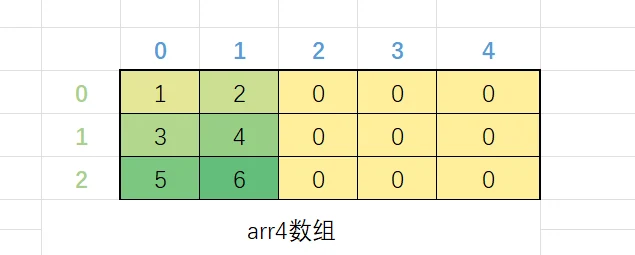
行数可以省,列数不能省:
int arr5[][5] = {1, 2, 3};              /* 编译器算出 1 行 */
int arr6[][5] = {1, 2, 3, 4, 5, 6, 7};  /* 2 行 */
int arr7[][5] = {{1, 2}, {3, 4}, {5, 6}};   /* 3 行 */
元素类型 int[5] 是完整的,编译器知道一行占 20 字节,才能由初值总数算出行数。写成 int a[][],元素类型是 int[],大小未知,而数组的元素类型不允许是不完整类型,直接非法。
平面初始化和按行初始化的区别在一处:平面写法不看换行,初值从左到右依次填进每一行。int arr6[][5] = {1, 2, 3, 4, 5, 6, 7} 先填满第一行的五个,再把 6、7 放进第二行前两列,剩下三个补 0,所以是 2 行。int arr7[][5] = {{1, 2}, {3, 4}, {5, 6}} 每对内层大括号对应一行,所以是 3 行,每行只有前两列有值。
访问用两个下标,行和列都从 0 开始:
int arr[3][5] = {1, 2, 3, 4, 5, 2, 3, 4, 5, 6, 3, 4, 5, 6, 7};

printf("%d\n", arr[2][4]);   /* 7 */
遍历整个二维数组要两层循环,外层产生行号,内层产生列号:
int i = 0, j = 0;

for (i = 0; i < 3; i++)
{
    for (j = 0; j < 5; j++)
    {
        scanf("%d", &arr[i][j]);
    }
}

for (i = 0; i < 3; i++)
{
    for (j = 0; j < 5; j++)
    {
        printf("%d ", arr[i][j]);
    }
    printf("\n");
}循环里的行数和列数可以直接从类型算:sizeof(arr) / sizeof(arr[0]) 是行数,sizeof(arr[0]) / sizeof(arr[0][0]) 是列数。数组大小改了,循环边界跟着变,不用回头改两处魔数。
二维数组在内存里同样连续,按行优先排列。先放完第一行,再放第二行:
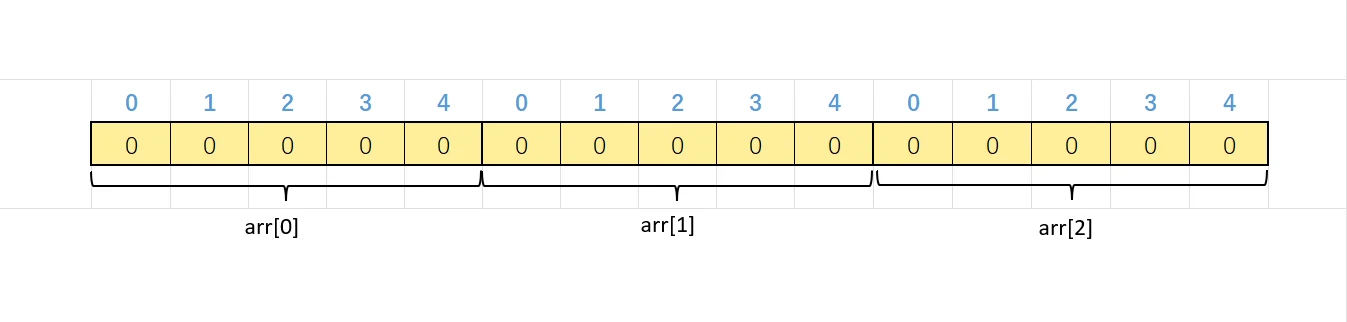
地址输出也印证这一点:
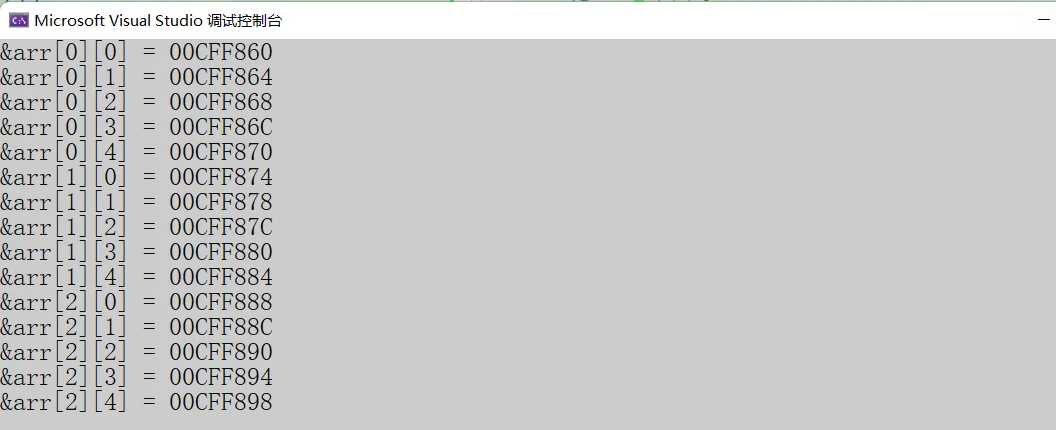
寻址公式因此带上了列数:
&arr[i][j] = 首地址 + (i * 列数 + j) * sizeof(元素)列数决定每行跨多少字节,也是“列数不能省”的根本原因。按行遍历比按列遍历快,因为按行走每一步都落在相邻的内存里,按列走每取一个元素就跳一整行。一个缓存行通常 64 字节,一行 5 个 int 只占 20 字节,按行读能把整行装进缓存;按列读时,同一列的五个元素分散在三行里,每次都要重新取缓存行。
变长数组:长度在运行时才算出来
C89 要求数组长度是常量表达式:int arr[10]、int arr[3 + 5] 都行,初始化时可以省长度 int arr[] = {1, 2, 3}。想在运行时按输入决定长度,C89 只能用“够大”的数组或 malloc。
C99 加了变长数组(variable-length array,VLA),长度表达式可以含变量:
int n = a + b;
int arr[n];
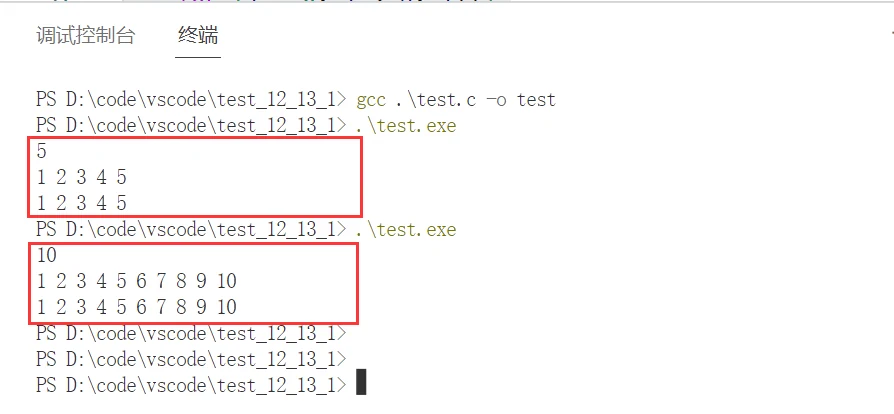
“变长”容易误解。数组一旦创建,大小就定了,不会自己变长变短;它真正的意思是长度在运行时才求值,编译期不知道。
#include <stdio.h>

int main(void)
{
    int n = 0;
    int i = 0;

    scanf("%d", &n);
    int arr[n];

    for (i = 0; i < n; i++)
    {
        scanf("%d", &arr[i]);
    }
    for (i = 0; i < n; i++)
    {
        printf("%d ", arr[i]);
    }
    return 0;
}
VLA 不能初始化,int arr[n] = {0}; 不行,因为编译器不知道要展开几个初值。它的长度也没有下限检查,n <= 0 是未定义行为;n 填得很大还会把栈撑爆,VLA 通常分配在栈上,随所在块结束自动释放,大小在创建那一刻定死,之后不会跟着 n 变化。
能不能用取决于编译器。C11 把 VLA 变成可选特性,不支持的实现会定义 __STDC_NO_VLA__。MSVC 至今不支持 VLA,所以同一段代码在 VS2022 里编不过,在 GCC 下可以。跨平台时用 malloc 更稳:
#include <stdio.h>
#include <stdlib.h>

int main(void)
{
    int n = 0;
    int i = 0;

    if (scanf("%d", &n) != 1 || n <= 0)
    {
        return 1;
    }

    int *arr = malloc((size_t)n * sizeof(int));
    if (arr == NULL)
    {
        return 1;
    }

    for (i = 0; i < n; i++)
    {
        scanf("%d", &arr[i]);
    }
    for (i = 0; i < n; i++)
    {
        printf("%d ", arr[i]);
    }

    free(arr);
    return 0;
}
两个练习:两端汇聚和二分查找
第一个练习用两个下标从两端向中间靠,把左边字符串的字符逐个搬进右边:
#include <stdio.h>
#include <string.h>
#include <windows.h>

int main(void)
{
    char arr1[] = "welcome to bit...";
    char arr2[] = "#################";
    int left = 0;
    int right = (int)strlen(arr1) - 1;

    printf("%s\n", arr2);
    while (left <= right)
    {
        Sleep(1000);
        arr2[left] = arr1[left];
        arr2[right] = arr1[right];
        left++;
        right--;
        printf("%s\n", arr2);
    }
    return 0;
}
left 从头往后走,right 从末尾往前走,每轮各覆盖一个字符,直到交错。arr2 的长度必须和 arr1 相同,否则 right 会指到 arr2 之外。strlen 来自 <string.h>,Sleep 来自 <windows.h>,课件那段两样都没包含,还把 return 0; 拼成了 retutn 0;,直接编译不过。Sleep 是 Windows 的函数,换平台要改成对应的延时接口。
第二个练习是二分查找。前提是数组已经升序:每次取中间元素和要找的值比较,小了就把左边界移到中间右边,大了就把右边界移到中间左边,范围每轮减半。
#include <stdio.h>

int main(void)
{
    int arr[] = {1, 2, 3, 4, 5, 6, 7, 8, 9, 10};
    int left = 0;
    int right = (int)(sizeof(arr) / sizeof(arr[0])) - 1;
    int key = 7;
    int mid = 0;
    int find = 0;

    while (left <= right)
    {
        mid = left + (right - left) / 2;
        if (arr[mid] > key)
        {
            right = mid - 1;
        }
        else if (arr[mid] < key)
        {
            left = mid + 1;
        }
        else
        {
            find = 1;
            break;
        }
    }

    if (find == 1)
    {
        printf("找到了,下标是%d\n", mid);
    }
    else
    {
        printf("找不到\n");
    }
    return 0;
}
求中点写成 left + (right - left) / 2,不写 (left + right) / 2。后者在 left 和 right 都很大时会先让和溢出,再除以 2,结果不再可靠。两个式子在正常情况下结果相同,差别只在边界。
二分查找每轮把区间减半,n 个元素最多比较约 log2(n) 次。遍历要逐个看,n 越大差距越明显;二分的前提是数据有序,无序数组上它不成立。
循环条件写 left <= right,因为区间是闭区间 [left, right],left == right 时还剩末尾一个元素要看。移动边界时写 right = mid - 1、left = mid + 1,把已经比较过的 mid 排除掉;写成 right = mid 会让区间在只剩两个元素时不再缩小,循环卡死。找不到时 left 会越过 right,循环自然结束,find 标志用来区分“下标恰好是 0 的命中”和“什么都没找到”。
还没有评论 — 第一条由你来留。