#include <stdio.h>

int main(void)
{
    int arr[10] = {1, 2, 3, 4, 5, 6, 7, 8, 9, 10};

    printf("&arr[0]   = %p\n", (void *)&arr[0]);
    printf("arr       = %p\n", (void *)arr);
    printf("&arr      = %p\n", (void *)&arr);
    printf("&arr[0]+1 = %p\n", (void *)(&arr[0] + 1));
    printf("arr+1     = %p\n", (void *)(arr + 1));
    printf("&arr+1    = %p\n", (void *)(&arr + 1));
    return 0;
}前三个打印结果完全相同,后三个却分成了两组:&arr[0] + 1 和 arr + 1 都比首地址大 4,&arr + 1 大 40。地址的值一样,表达式走一步的距离不一样,差别在类型。
arr 的类型是 int[10],&arr[0] 的类型是 int *,&arr 的类型是 int (*)[10]。指针加法按“指向对象的大小”走,int 是 4 字节,int[10] 是 40 字节。三个表达式起点相同,落点由类型决定。
课件用 %p 直接打印 arr 这类 int *。严格按标准,%p 对应的是 void *,实参应当先转换;主流实现上两种指针表示相同,打印结果看不出区别。上面统一加了 (void *),换成别的编译器或开启更严格的格式检查时就不会有类型争议。
数组名不是指针变量
arr 是 40 字节内存的名字,不是存地址的变量。它能赋给 int *p,靠的是标准里一条转换规则:数组类型的表达式在大多数语境里会转换成指向首元素的指针,这个转换叫数组退化(array-to-pointer decay)。C11 6.3.2.1 列了不转换的语境:作为 sizeof 或一元 & 的操作数,以及作为初始化字符数组的字符串字面量。
课件常说的“两个例外”是 sizeof(数组名) 和 &数组名;字符串字面量初始化也在不转换的清单里,它的对象是字面量而不是数组名。按这条规则读开头的表达式:
arr出现在printf实参里,转换成int *,加一跨 4 字节;&arr[0]本来就是int *;&arr是取地址作用在整个数组上,不转换,得到int (*)[10],加一跨 40 字节。
sizeof 是这条规则最常考的落点:
#include <stdio.h>

int main(void)
{
    int arr[10] = {0};

    printf("%zu\n", sizeof(arr));       /* 40,整个数组 */
    printf("%zu\n", sizeof(arr + 0));   /* 8,加 0 也退化了 */
    printf("%zu\n", sizeof(*arr));      /* 4,首元素 */
    printf("%zu\n", sizeof(&arr));      /* 8,数组指针 */
    printf("%zu\n", sizeof(*&arr));     /* 40,解引用又回到数组 */
    return 0;
}
sizeof(arr + 0) 最容易答错。+ 一出现,数组名就先转换成指针,加 0 不改变值,但类型已经是 int *。只有数组名单独站在 sizeof 里,它才代表整个数组。sizeof 的结果类型是 size_t,打印用 %zu;课件里一律写 %d,在 64 位平台上属于格式串与实参类型不匹配。
数组名不能自增,也不能整体赋值,例如 arr++、arr = other 都不合法。原因不是“数组名是常量指针”,而是数组不是可修改的左值;整体复制只能逐元素循环或者用 memcpy。
下标是加法加解引用的简写
标准把 E1[E2] 定义为 *((E1) + (E2))。所以 arr[i] 与 *(arr + i) 是同一个表达式,i[arr] 也能编译,因为加法可交换。数组元素的访问在编译器那里就是“首元素地址加偏移量,再解引用”。
#include <stdio.h>

int main(void)
{
    int arr[5] = {10, 20, 30, 40, 50};
    int *p = arr;
    int i;

    for (i = 0; i < 5; i++)
    {
        printf("%d %d %d\n", arr[i], *(arr + i), p[i]);
    }

    p++;                 /* p 移到 arr[1],arr 仍然钉在起点 */
    printf("%d\n", p[0]);   /* 20 */
    printf("%d\n", arr[0]); /* 10 */
    return 0;
}
指针能移动,数组名不能。调试时“下标整体偏移一格”,多半是某个指针在中途被自增过。
数组传参传的是首地址,长度跟着丢
#include <stdio.h>

void test(int arr[])
{
    printf("函数内 sizeof = %zu\n", sizeof(arr));
}

int main(void)
{
    int arr[10] = {0};

    printf("main 里 sizeof = %zu\n", sizeof(arr));
    test(arr);
    return 0;
}
64 位平台上输出 40 和 8。形参写成 int arr[],编译器会把它调整成 int *arr,int arr[10]、int arr[]、int *arr 三种写法声明的是同一个函数,方括号里的数字既不检查也不保留。函数内部的 sizeof(arr) 量的是指针本身。
这就是数组接口普遍长成“数组 + 长度”的原因。长度必须在数组还没退化时算好传进去:
#include <stdio.h>

void PrintArr(const int *arr, size_t n)
{
    size_t i;

    for (i = 0; i < n; i++)
    {
        printf("%d ", arr[i]);
    }
    printf("\n");
}

int main(void)
{
    int arr[10] = {1, 2, 3, 4, 5, 6, 7, 8, 9, 10};
    size_t n = sizeof(arr) / sizeof(arr[0]);

    PrintArr(arr, n);
    return 0;
}
形参加 const 有实际作用:const int *arr 让函数里的 arr[i] = 0 编译不过,约束的是函数实现,不是调用者手里的数组。二维数组的形参规则多一条:行数可以省,列数不能省,void f(int a[][5]) 合法,void f(int a[3][]) 不合法。编译器要靠列数算 a[i][j] 的偏移,形参写成 int (*)[5] 时这个 5 同样不能省。
冒泡排序的上界
冒泡的思想是一句话:相邻两个比较,顺序不对就交换。代码里 sz - i - 1 那个上界不是背下来的:
- 第 0 趟从下标 0 比到
sz - 2,共sz - 1对,结束后最大值落在末尾一格; - 第 1 趟只需要管前
sz - 1个,共sz - 2对; - 第
i趟开始时,末尾已经有i个排好,剩下sz - i个,相邻对数是sz - i - 1。
#include <stdio.h>

void BubbleSort(int arr[], int sz)
{
    int i;
    int j;

    for (i = 0; i < sz - 1; i++)
    {
        int swapped = 0;

        for (j = 0; j < sz - i - 1; j++)
        {
            if (arr[j] > arr[j + 1])    /* 相等不交换,保持稳定 */
            {
                int tmp = arr[j];
                arr[j] = arr[j + 1];
                arr[j + 1] = tmp;
                swapped = 1;
            }
        }

        if (swapped == 0)               /* 一趟没交换,已经有序 */
        {
            break;
        }
    }
}

int main(void)
{
    int arr[] = {3, 1, 7, 5, 8, 9, 0, 2, 4, 6};
    int sz = (int)(sizeof(arr) / sizeof(arr[0]));
    int i;

    BubbleSort(arr, sz);
    for (i = 0; i < sz; i++)
    {
        printf("%d ", arr[i]);
    }
    printf("\n");
    return 0;
}
不加 swapped,即使数组已经有序,两层循环照样跑满 n(n-1)/2 次比较;加上之后,最好情况是 n - 1 次比较就退出。最坏和平均仍是 O(n²)。交换次数等于逆序对的数量,所以面对“基本有序、只有几个元素错位”的数据,交换开销很小,慢的是比较。
二级指针改的是中间那个格子
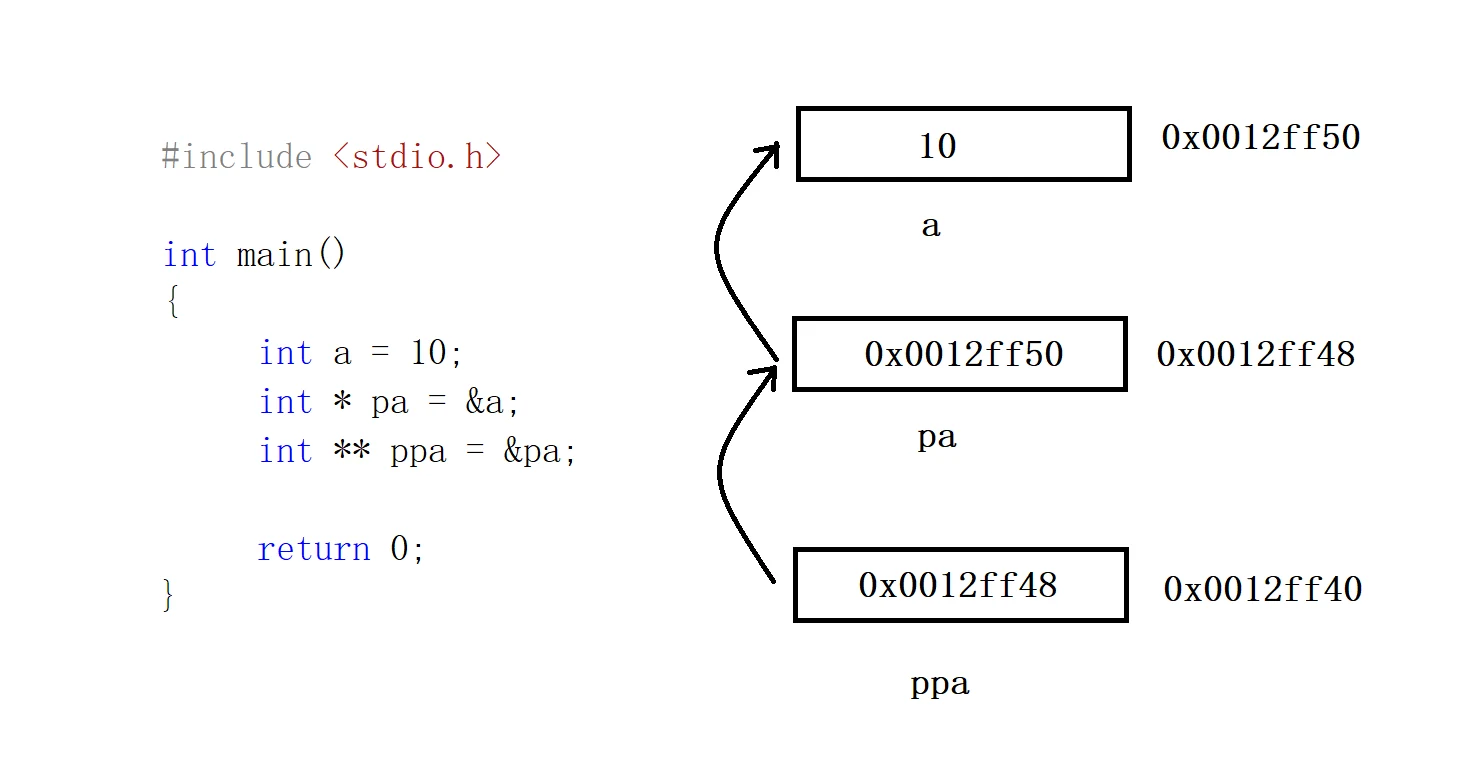
指针变量也是变量,也有地址。int **ppa = &pa; 之后,三层关系是:
#include <stdio.h>

int main(void)
{
    int a = 10;
    int b = 20;
    int *pa = &a;
    int **ppa = &pa;

    **ppa = 30;          /* 等价于 *pa = 30,也等价于 a = 30 */
    printf("a = %d\n", a);

    *ppa = &b;           /* 等价于 pa = &b,改的是指针的指向 */
    printf("*pa = %d\n", *pa);
    return 0;
}
*ppa 的类型是 int *,值是 pa 里存的地址;**ppa 再往下解一层,才是 a 的整数。*ppa = &b 改中间格子的地址,**ppa = 30 改最上面格子的整数。
二级指针真正需要出现的场合,是函数要修改调用者的指针变量本身。C 只有传值,形参是实参的拷贝,想让函数把新地址写回调用者的指针,就要把那个指针的地址传进去:
#include <stdio.h>

void Reset(int **pp, int *target)
{
    *pp = target;        /* 写回调用者的指针变量 */
}

int main(void)
{
    int x = 1;
    int y = 2;
    int *p = &x;

    Reset(&p, &y);
    printf("%d\n", *p);   /* 2 */
    return 0;
}
形参若写成 int *pp,函数里的 pp = target 只改副本,调用者的 p 不会变。规律只有一条:想改几级的对象,就传比它多一级的指针。
指针数组是一排地址
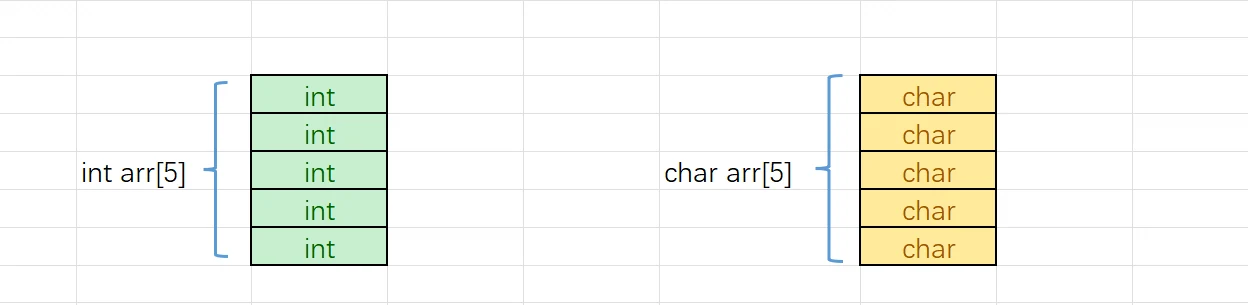
整型数组每格装 int,字符数组每格装 char;元素类型换成 int *,得到的就是指针数组。
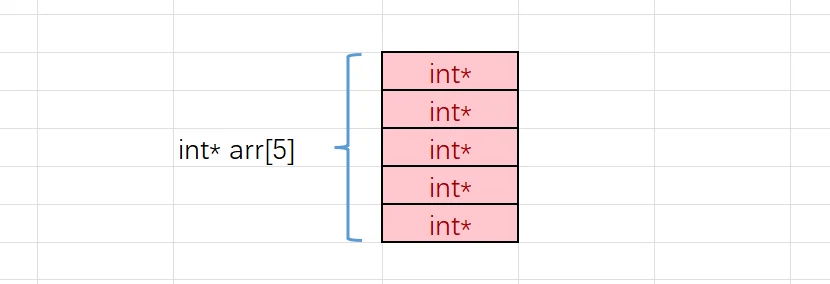
int *parr[3];      /* 数组:3 个元素,每个是 int * */
int (*p)[3];       /* 指针:指向一个 int[3] */
[] 的优先级高于 *,int *parr[3] 里 parr 先和 [] 结合,所以它是数组;要让 p 先和 * 结合,必须加括号。前者在 64 位平台上占 24 字节,后者占 8 字节,p + 1 跨 12 字节。
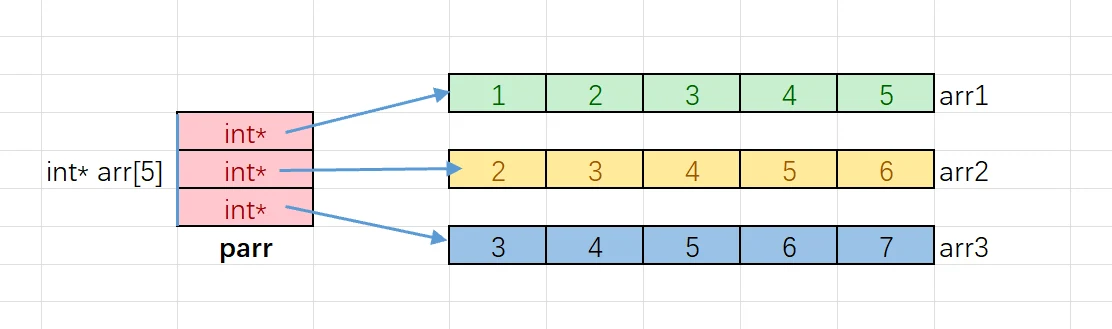
指针数组最常见的用法,是把几个独立的一维数组拼成“看起来像二维”的结构:
#include <stdio.h>

int main(void)
{
    int arr1[] = {1, 2, 3, 4, 5};
    int arr2[] = {2, 3, 4, 5, 6};
    int arr3[] = {3, 4, 5, 6, 7};
    int *parr[3] = {arr1, arr2, arr3};
    int i;
    int j;

    for (i = 0; i < 3; i++)
    {
        for (j = 0; j < 5; j++)
        {
            printf("%d ", parr[i][j]);   /* 等价于 *(*(parr + i) + j) */
        }
        printf("\n");
    }
    return 0;
}
parr[i][j] 分两步:parr[i] 先从数组里取出第 i 个地址,它指向某个一维数组的首元素;[j] 再在那个一维数组里取第 j 个元素。它能模拟二维数组的访问形式,但内存不是一整块:三行各自独立,每行长度可以不同,行距不由编译器统一计算。
真正的二维数组 int a[3][5] 是一块连续的 60 字节,退化后类型是 int (*)[5];指针数组传参时退化后是 int **。这两种类型看起来都像“两个下标”,底层偏移算法完全不同。指针数组的每一行地址要单独取,真二维数组的行距由列数定死。
还没有评论 — 第一条由你来留。