strlen 数到 '\0' 停,strcpy 把 '\0' 一起搬过去,strcmp 在第一个不同的字符处给出正负,strtok 把分隔符本身改写成 '\0'。字符串这一组函数都围绕同一个字节展开:它既是长度的终点,也是拷贝的终点,还是比较的终点。字符分类函数单独住在 ctype.h,处理单个字符,和终止符无关。
ctype.h 里的 11 个判断函数
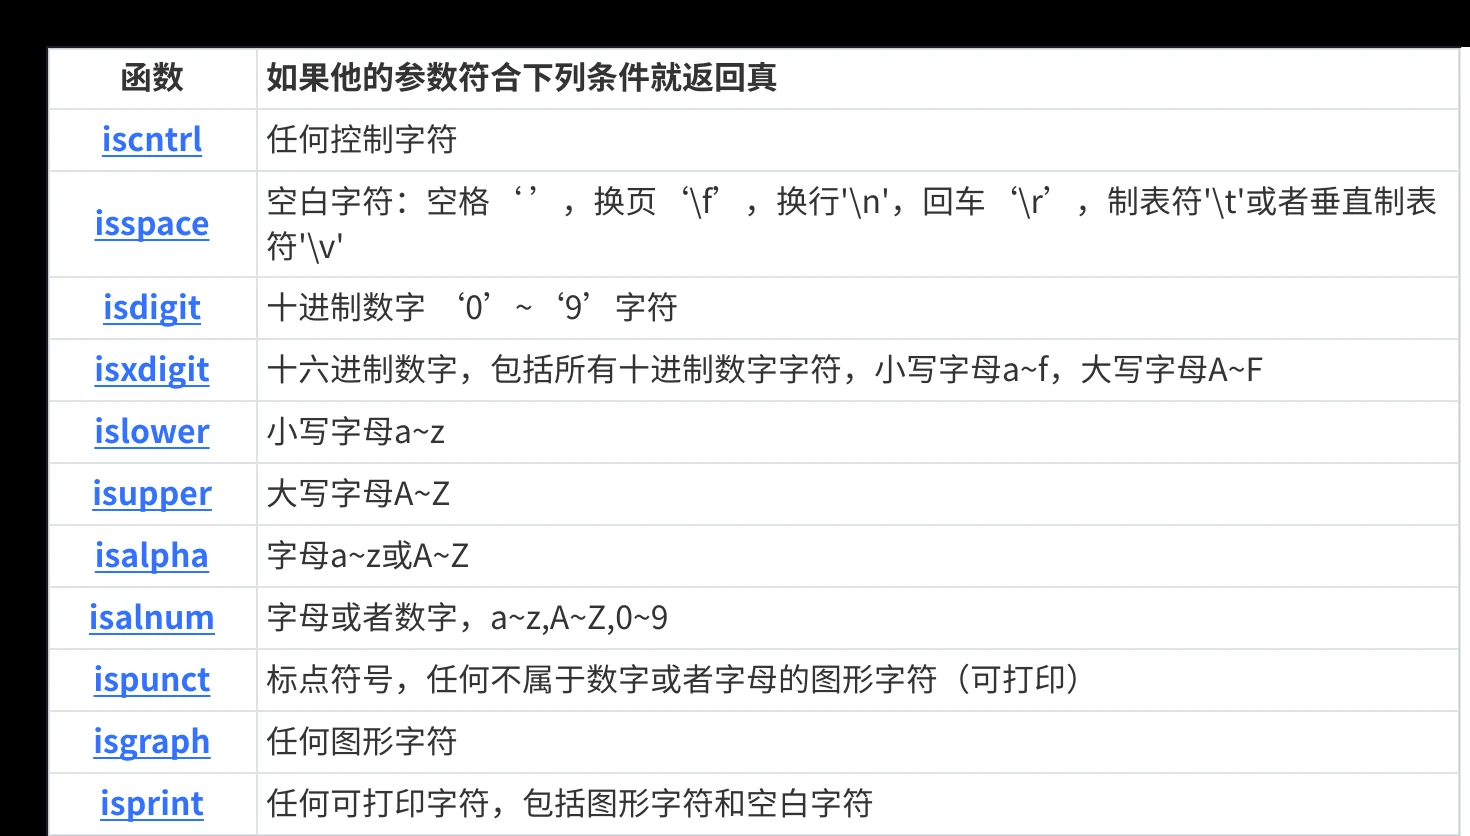
iscntrl 判控制字符,isspace 判空白(空格、\f、\n、\r、\t、\v),isdigit 判十进制数字,isxdigit 判十六进制数字(含 af、AF),islower、isupper、isalpha、isalnum、ispunct、isgraph、isprint 各管一类。容易混的只有 isgraph 和 isprint:图形字符不含空格,可打印字符包含空格。
它们的原型都长成 int isxxx(int c);。参数声明成 int 是为了能接收 EOF(通常是 -1),返回值用非 0 表示真,具体是几由实现决定。所以判断时写 if (islower(c)),不要写 if (islower(c) == 1)。
课件的小写转大写练习,按标准写法改成这样:
#include <ctype.h>
#include <stdio.h>

int main(void)
{
    char str[] = "Test String.\n";
    int i = 0;

    while (str[i] != '\0')
    {
        unsigned char c = (unsigned char)str[i];

        if (islower(c))
            c = (unsigned char)toupper(c);
        putchar(c);
        i++;
    }
    return 0;
}
toupper 把参数里的小写字母转成大写,tolower 把大写转成小写,方向相反。课件正文写“有了转换函数,就可以直接使用 tolower 函数”,紧跟着的示例调用的却是 toupper。这两句对不上:示例做的是小写转大写,该用 toupper;照正文抄成 tolower,条件里的小写字母转完还是原样,大写字母也碰不到,输出仍然是 Test String.。
课件练习里的 c -= 32 能跑,是因为 ASCII 里大小写字母刚好差 32。这个 32 来自编码表,不是 C 语言的规则,换一种字符集就不成立。用 toupper 更稳。
还有一条前提写在手册里:传给这些函数的参数,值必须能表示成 unsigned char,或者等于 EOF。char 在多数平台上默认有符号,字节大于 127 时传进去就是负数,行为未定义。纯 ASCII 输入不会触发,但库函数不承诺兜底,养成先转 unsigned char 的习惯。
strlen 的三种写法,和一个无符号减法
原型是 size_t strlen(const char *str);。规则三条:字符串以 '\0' 结束;返回值是 '\0' 前面的字符个数,不含 '\0';返回类型是 size_t,无符号。传进来的数组如果没有终止符,函数会一路读到越界,长度算出来是偶然值。
三种模拟实现:
#include <assert.h>
#include <stddef.h>

/* 计数器 */
size_t my_strlen1(const char *s)
{
    size_t count = 0;

    assert(s != NULL);
    while (*s != '\0')
    {
        count++;
        s++;
    }
    return count;
}

/* 递归,不建计数器 */
size_t my_strlen2(const char *s)
{
    assert(s != NULL);
    if (*s == '\0')
        return 0;
    return 1 + my_strlen2(s + 1);
}

/* 指针相减 */
size_t my_strlen3(const char *s)
{
    const char *p = s;

    assert(s != NULL);
    while (*p != '\0')
        p++;
    return (size_t)(p - s);
}
三种写法都用了 assert,所以要包含 assert.h。课件方式 3 的参数名是 s,assert 里写的却是 str,这个标识符在函数里不存在,打开断言会直接编译失败。返回类型也写成了 int,字符串长度超过 INT_MAX 时会被截断;标准原型是 size_t。递归版在超长字符串上会耗尽栈,计数版最稳。
size_t 是无符号,两个长度相减就会回绕:
#include <stdio.h>
#include <string.h>

int main(void)
{
    const char *str1 = "abcdef";   /* 6 */
    const char *str2 = "bbb";      /* 3 */

    if (strlen(str2) - strlen(str1) > 0)
        printf("str2 更长\n");
    else
        printf("str1 更长\n");

    return 0;
}
3 - 6 在 size_t 上不会得到 -3,结果回绕成 SIZE_MAX - 2,跟 0 相比永远更大,屏幕上打印“str2 更长”,而实际上 str1 更长。课件用这段代码说明“返回值是 size_t,无符号,易错”,指的就是这件事。
比较长度不要先减,写 if (strlen(str2) > strlen(str1))。倒序遍历同理,for (size_t i = strlen(s) - 1; i >= 0; i--) 在空串时下标越界,非空时 i >= 0 恒真,减到 0 再减一次又回绕。安全写法是先判断再减:
#include <stdio.h>
#include <string.h>

void print_reverse(const char *s)
{
    size_t n = strlen(s);

    while (n > 0)
    {
        n--;
        putchar(s[n]);
    }
}
strcpy 与 memcpy:谁能越过那个 0
char *strcpy(char *destination, const char *source);。四条约束:源串必须 '\0' 结尾;'\0' 会被复制过去;目标空间必须放得下整个源串;目标必须可写。
#include <assert.h>
#include <stddef.h>

char *my_strcpy(char *dest, const char *src)
{
    char *ret = dest;

    assert(dest != NULL);
    assert(src != NULL);

    while ((*dest++ = *src++))
    {
    }
    return ret;
}
*dest++ = *src++ 的表达式值是刚写入的字符。非 0 就继续;'\0' 先被写进去,再让条件为假,循环正好停在那里,终止符一定跟着走。函数不知道 dest 还剩多少字节,长度只能由调用者保证。
这里就是 strcpy 和 memcpy 的分界:
| 对比项 | strcpy | memcpy |
|---|---|---|
| 停止条件 | 写完 '\0' 就停 | 拷满 num 个字节 |
| 长度来源 | 源串自己 | 调用者给 |
数据中间有 '\0' | 后面的内容丢掉 | 原样搬完 |
| 源与目标重叠 | 未定义 | 未定义 |
中间可能夹 0 的数据(图片、结构体、含 0 的编码)只能用 memcpy;纯文本串两边都靠 '\0',用 strcpy 省事,容量风险照旧。strcpy 写超了不报错,栈上相邻字节碰巧没用,看起来“正常”,这是缓冲区溢出最常见的入口。
strncpy 限制了拷贝个数,边界更绕。源串短于 num 时,剩下的位置补 0,直到写满 num 个;源串长度等于或大于 num 时,一个 '\0' 都不补:
#include <string.h>

int main(void)
{
    char a[10];

    strncpy(a, "HelloWorld123", 5);   /* 前 5 个字节是 Hello,没有终止符 */
    a[5] = '\0';                      /* 自己补 */
    return 0;
}
所以 strncpy 不是“安全的 strcpy”,它只限制从源里拿几个字节,目标容量照样不检查。
strcat 与 strncat:先找到串尾,再决定写多少
char *strcat(char *destination, const char *source); 从 dest 的 '\0' 处开始覆盖,写完新内容再补一个 '\0'。约束和 strcpy 类似,多一条:dest 自己必须有 '\0',否则找不到追加起点。
#include <assert.h>
#include <stddef.h>

char *my_strcat(char *dest, const char *src)
{
    char *ret = dest;

    assert(dest != NULL);
    assert(src != NULL);

    while (*dest != '\0')
        dest++;

    while ((*dest++ = *src++))
    {
    }
    return ret;
}
调用前需要的空间是 strlen(dest) + strlen(src) + 1,最后一个 1 是新终止符。
自己给自己追加(strcat(s, s))在标准里是未定义行为。看流程就明白:dest 先走到原串末尾,src 从开头读;写到末尾之后,写的位置正好是源还要继续读的位置,原来的 '\0' 被覆盖,循环再也停不下来。
strncat 最多从源里拿 num 个字符,然后无条件补一个 '\0',最坏写入量是 num + 1:
#include <stdio.h>
#include <string.h>

int main(void)
{
    char str1[20] = "To be ";
    char str2[20] = "or not to be";

    strncat(str1, str2, 6);
    printf("%s\n", str1);   /* To be or not */

    return 0;
}
注意它和 strncpy 的差别:strncat 一定补终止符,strncpy 不一定。
strcmp 与 strncmp:只有符号有意义
int strcmp(const char *str1, const char *str2); 从第一个字符开始逐对比较,遇到不同或遇到 '\0' 停止。标准只规定三种结果:大于 0、等于 0、小于 0。具体返回几由实现决定,strcmp(a, b) == 1 不可移植,判相等只能写 == 0。
比较按 unsigned char 进行。课件模拟实现的最后一行是 return *str1 - *str2;。char 若为有符号,大于 127 的字节会先符号扩展成负数:0x80 和 'a'(97)比较,按无符号是 128 对 97,前者大;按有符号是 -128 对 97,结论反了。改成先转 unsigned char:
#include <assert.h>

int my_strcmp(const char *s1, const char *s2)
{
    assert(s1 != NULL);
    assert(s2 != NULL);

    while (*s1 == *s2)
    {
        if (*s1 == '\0')
            return 0;
        s1++;
        s2++;
    }
    return (int)((unsigned char)*s1 - (unsigned char)*s2);
}
strncmp(str1, str2, num) 最多比 num 个字符,中途不同就提前结束,全相同返回 0。它常用来判前缀:
#include <string.h>

int is_https(const char *url)
{
    return strncmp(url, "https://", 8) == 0;
}
课件把 strncmp 描述成“最多比较 num 个字母”。比的是字符或字节,数字、标点一样参与。
strstr 找子串,strtok 就地切分
char *strstr(const char *str1, const char *str2); 返回 str2 在 str1 中第一次出现的地址,找不到返回 NULL。匹配不包含终止符,遇到 '\0' 就结束;str2 是空串时返回 str1 本身。
#include <stddef.h>

char *my_strstr(const char *haystack, const char *needle)
{
    const char *h = haystack;

    if (*needle == '\0')
        return (char *)haystack;

    while (*h != '\0')
    {
        const char *a = h;
        const char *b = needle;

        while (*a != '\0' && *b != '\0' && *a == *b)
        {
            a++;
            b++;
        }
        if (*b == '\0')
            return (char *)h;
        h++;
    }
    return NULL;
}
课件示例用它做原地替换:
#include <stdio.h>
#include <string.h>

int main(void)
{
    char str[] = "This is a simple string";
    char *pch = strstr(str, "simple");

    if (pch != NULL)
        strncpy(pch, "sample", 6);

    printf("%s\n", str);
    return 0;
}
simple 和 sample 都是 6 个字符,原地覆盖不会碰掉后面的 '\0'。换成更长的替换词就要重新算空间。
strtok 的接口在这一组里最特别:
#include <stdio.h>
#include <string.h>

int main(void)
{
    char arr[] = "192.168.6.111";
    const char *sep = ".";
    char *tok = NULL;

    for (tok = strtok(arr, sep); tok != NULL; tok = strtok(NULL, sep))
        printf("%s\n", tok);

    return 0;
}
sep 是分隔符的集合,不是一整个分隔串,",;" 里的逗号和分号都算。函数做三件事:跳过前导分隔符;把遇到的下一个分隔符改写成 '\0';把内部位置存进静态变量,下次传 NULL 时接着往下找。没有更多标记时返回 NULL。
由此带出几条限制:原串会被改坏,只能传可写数组,不能传字符串字面量;连续的分隔符被当成一个,CSV 里的空字段会消失;内部状态是全局的,多线程或嵌套调用会互相覆盖进度,需要重入时用 POSIX 的 strtok_r 或 Windows 的 strtok_s。
strerror 与 perror:把 errno 翻译成一句话
char *strerror(int errnum); 返回错误码对应的说明字符串地址。错误码定义在 errno.h,运行库用 errno 记录最近一次失败:程序启动时是 0,标准库函数出错时被写入对应值。成功调用不会把它清零,所以要先确认函数真的失败了,再去读 errno。
#include <errno.h>
#include <stdio.h>
#include <string.h>

int main(void)
{
    FILE *fp = fopen("unexist.ent", "r");

    if (fp == NULL)
        printf("打开失败:%s\n", strerror(errno));

    return 0;
}
课件还打印了 0 到 10 的错误码,输出从 No error、Operation not permitted 一直到 No child processes。这段代码的价值在于看清编号和文字的对应,具体文案随 C 运行库变化,不能拿它做字符串比较。
strerror 返回的指针指向运行库内部的一块缓冲区,下一次调用可能把它覆盖,要长期保存就自己复制一份。
perror 把上面两步合成一步:打印参数里的字符串,接着一个冒号和空格,再打印错误信息。
#include <stdio.h>

int main(void)
{
    FILE *fp = fopen("unexist.ent", "r");

    if (fp == NULL)
        perror("打开失败");

    return 0;
}
输出形如 打开失败: No such file or directory。strerror 返回字符串,perror 直接输出,两者都依赖 errno 当时的值,中间不要插入别的库调用。
这一组函数都在回答同一个问题:这段字节到哪里算结束。strlen 用 '\0' 找终点,strcpy、strcat 把终点一起搬,strcmp 在终点前比大小,strstr 在终点前找模式,strtok 把终点插在分隔符的位置。终点之外的空间,它们一概不管。
还没有评论 — 第一条由你来留。