二叉搜索树(binary search tree,BST)是一棵二叉树,任意结点满足两条:左子树里所有结点的值都不大于它,右子树里所有结点的值都不小于它,左右子树各自也是二叉搜索树。这三句话合起来的结果很直接:中序遍历输出一个有序序列。但反过来不成立,输出同一串有序值,树的形状可以完全不同,这是后面所有平衡结构的起点。
定义约束的是整棵子树,不是两个孩子
新手最常读错的一句是"左边比根小、右边比根大"。如果只要求孩子满足,下面这棵树也能通过逐层检查:
    8
   /
  3
   \
    9
3 < 8、9 > 3,局部都对,但 9 落在 8 的左子树里却比 8 大。查找 9 时第一比较就判定"比 8 大,往右走",从此再也碰不到它。定义里的主语是"左子树上的所有结点",不是"左孩子",查找算法每往左走一步都依赖这个承诺。
课件的定义把两条写成"小于等于"和"大于等于",紧接着又说"可以支持插入相等的值,也可以不支持"。这两句放在一起,规则是松的:允许重复时,相等的值从左侧或右侧进来都合定义;不允许重复时,两条都带等号就自相矛盾,一个相等的值两侧都合法。真正拦住它的是插入代码里的 else return false,而不是定义。这两套规则要分开写:不允许重复的版本用严格的小于和大于;允许重复的版本保留等号,但插入方向必须固定。
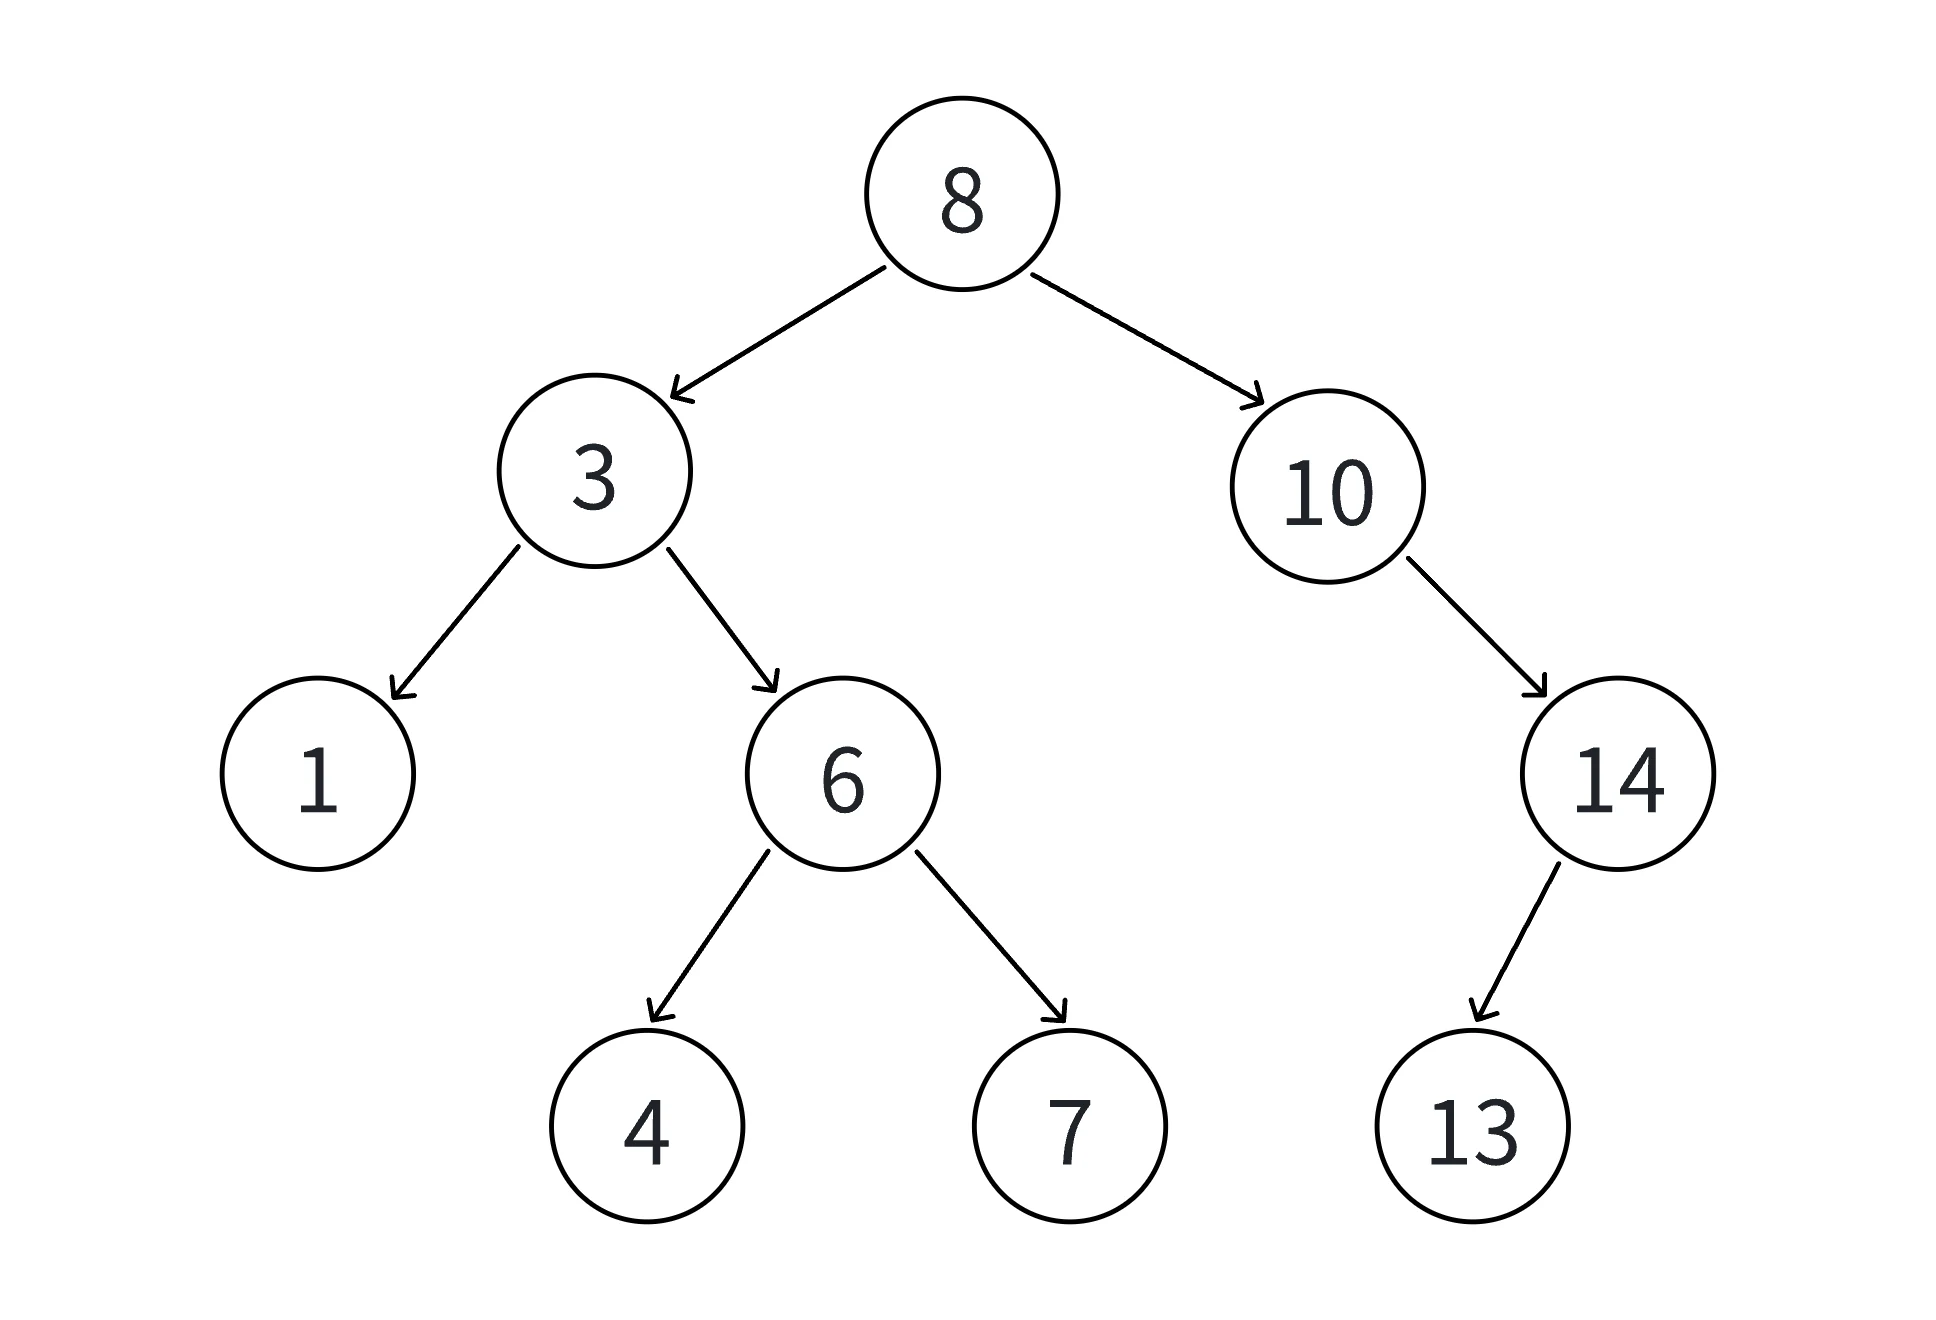
二叉搜索树能支持重复值,也能不支持,取决于使用场景。标准库这一族容器就是按这条分的:map/set 不接受相等的键,multimap/multiset 接受。相等值怎么走,课件在插入步骤里给了唯一一条硬要求:前后一致,不能一次往右、一次往左。
插入和查找走的是同一条路径
插入只有两种情况:树空,新结点直接当根;树不空,从根开始比,比当前结点大往右、小往左、相等按约定方向走,直到走出空位。空位不是"结点",所以需要一个 parent 记住落脚点的父亲,最后把新结点挂到 parent 的对应成员上。
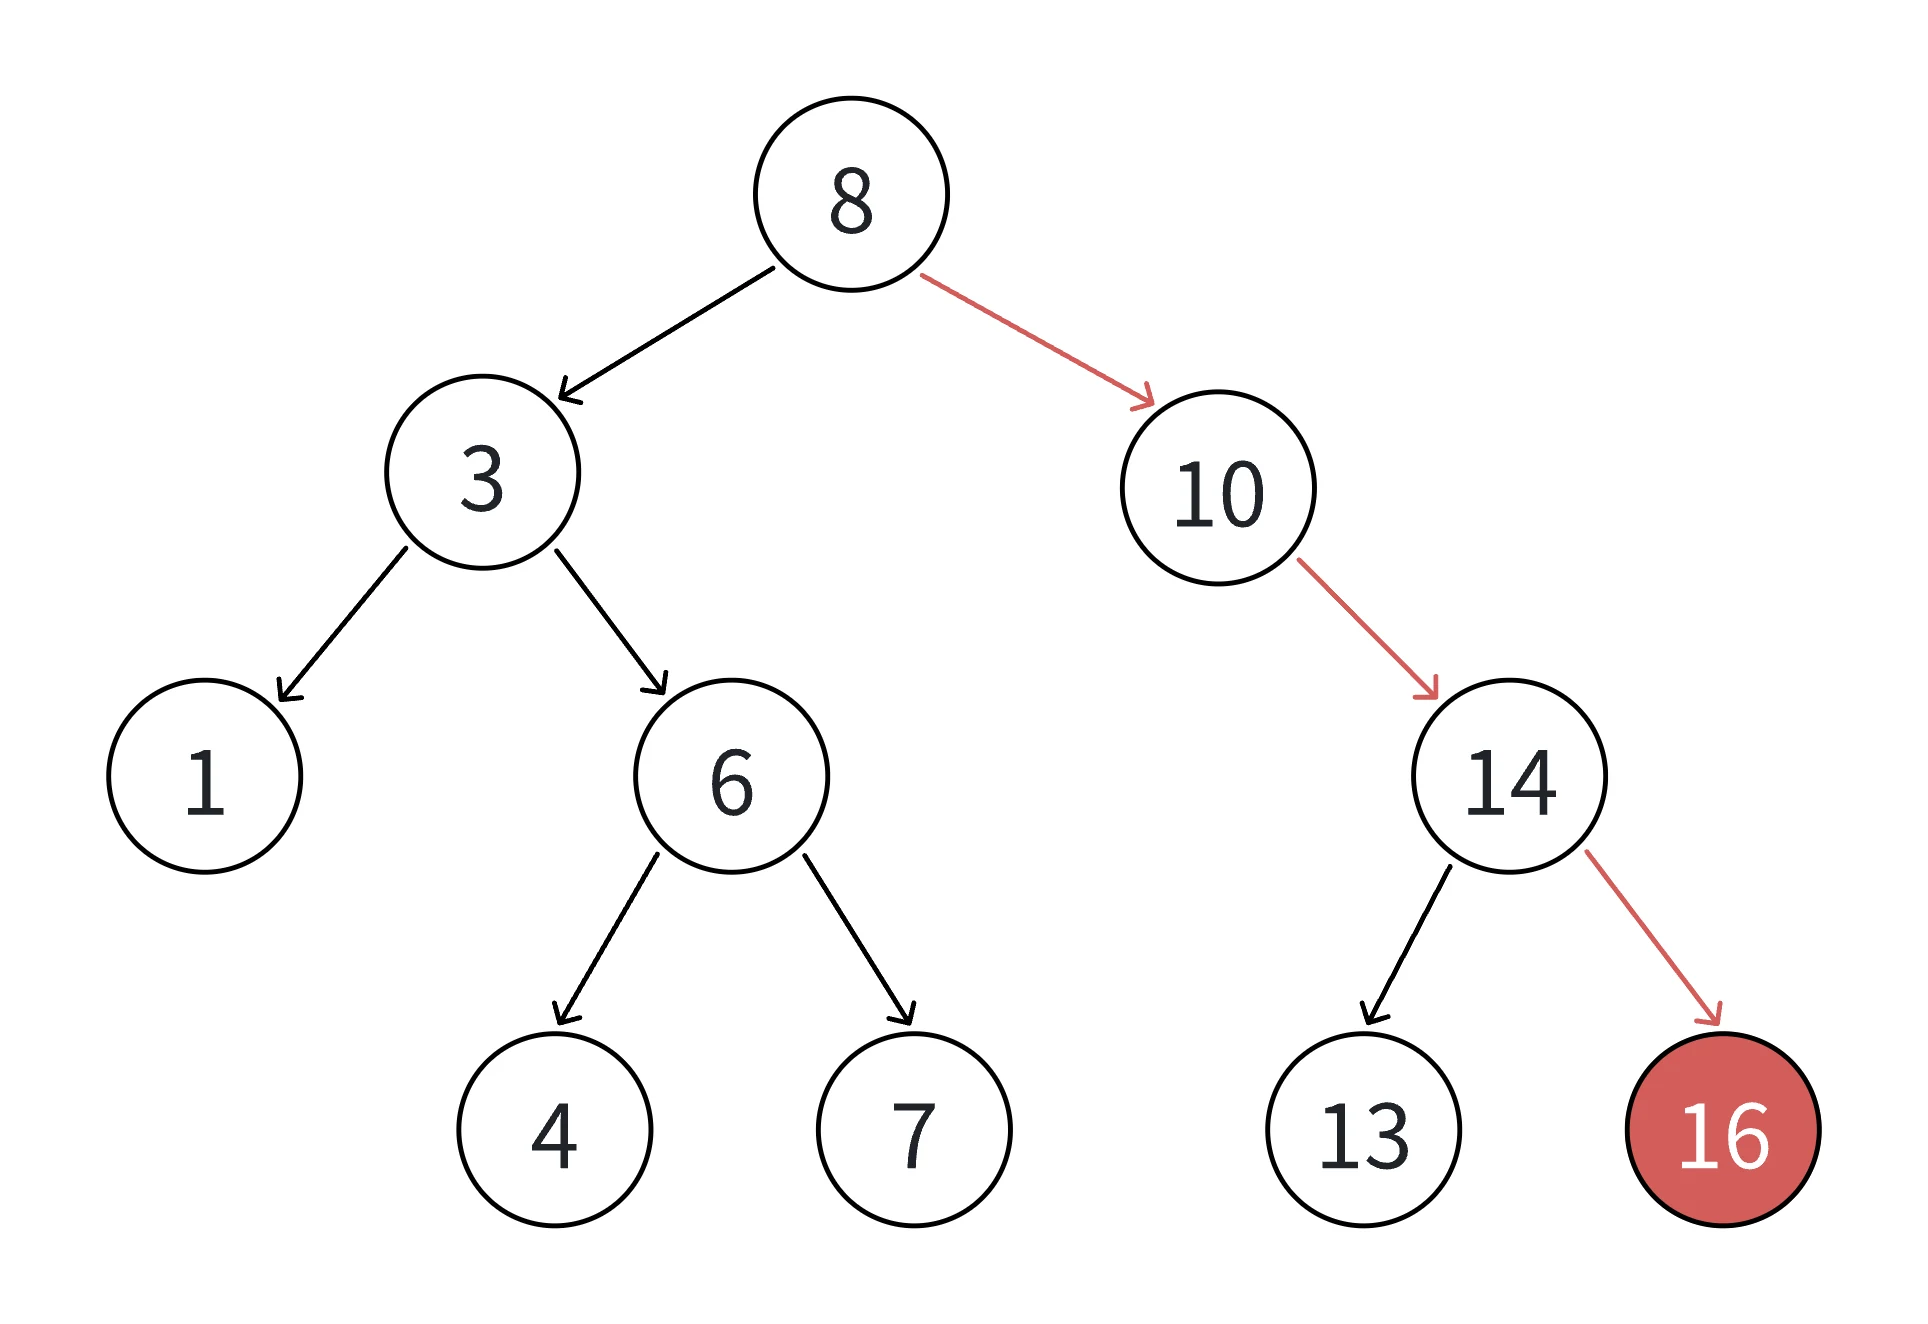
下面几段是 template<class K> class BSTree 的成员函数,Node 是 BSTNode<K> 的别名,_root 是根指针。
#include <iostream>

template<class K>
struct BSTNode
{
    K _key;
    BSTNode<K>* _left;
    BSTNode<K>* _right;

    BSTNode(const K& key)
        : _key(key), _left(nullptr), _right(nullptr)
    {}
};

    bool Insert(const K& key)
    {
        if (_root == nullptr)
        {
            _root = new Node(key);
            return true;
        }

        Node* parent = nullptr;
        Node* cur = _root;
        while (cur)
        {
            if (cur->_key < key)
            {
                parent = cur;
                cur = cur->_right;
            }
            else if (cur->_key > key)
            {
                parent = cur;
                cur = cur->_left;
            }
            else
            {
                return false;
            }
        }

        Node* newNode = new Node(key);
        if (parent->_key < key)
        {
            parent->_right = newNode;
        }
        else
        {
            parent->_left = newNode;
        }
        return true;
    }

    Node* Find(const K& key)
    {
        Node* cur = _root;
        while (cur)
        {
            if (cur->_key < key)
            {
                cur = cur->_right;
            }
            else if (cur->_key > key)
            {
                cur = cur->_left;
            }
            else
            {
                return cur;
            }
        }
        return nullptr;
    }
查找和插入的循环结构一模一样,区别只在命中时返回结点、走空时返回空指针。代价都由树高决定:最多走高度步,走到空就说明值不存在。课件这句"最多查找高度次"是整篇里最该记住的复杂度结论。
有重复值时,"找到"不等于"找对"。课件在查找那一节要求返回中序里第一个 x,并画了一棵树:8 左边是 3,3 左边是 1,1 的右孩子还是 3。
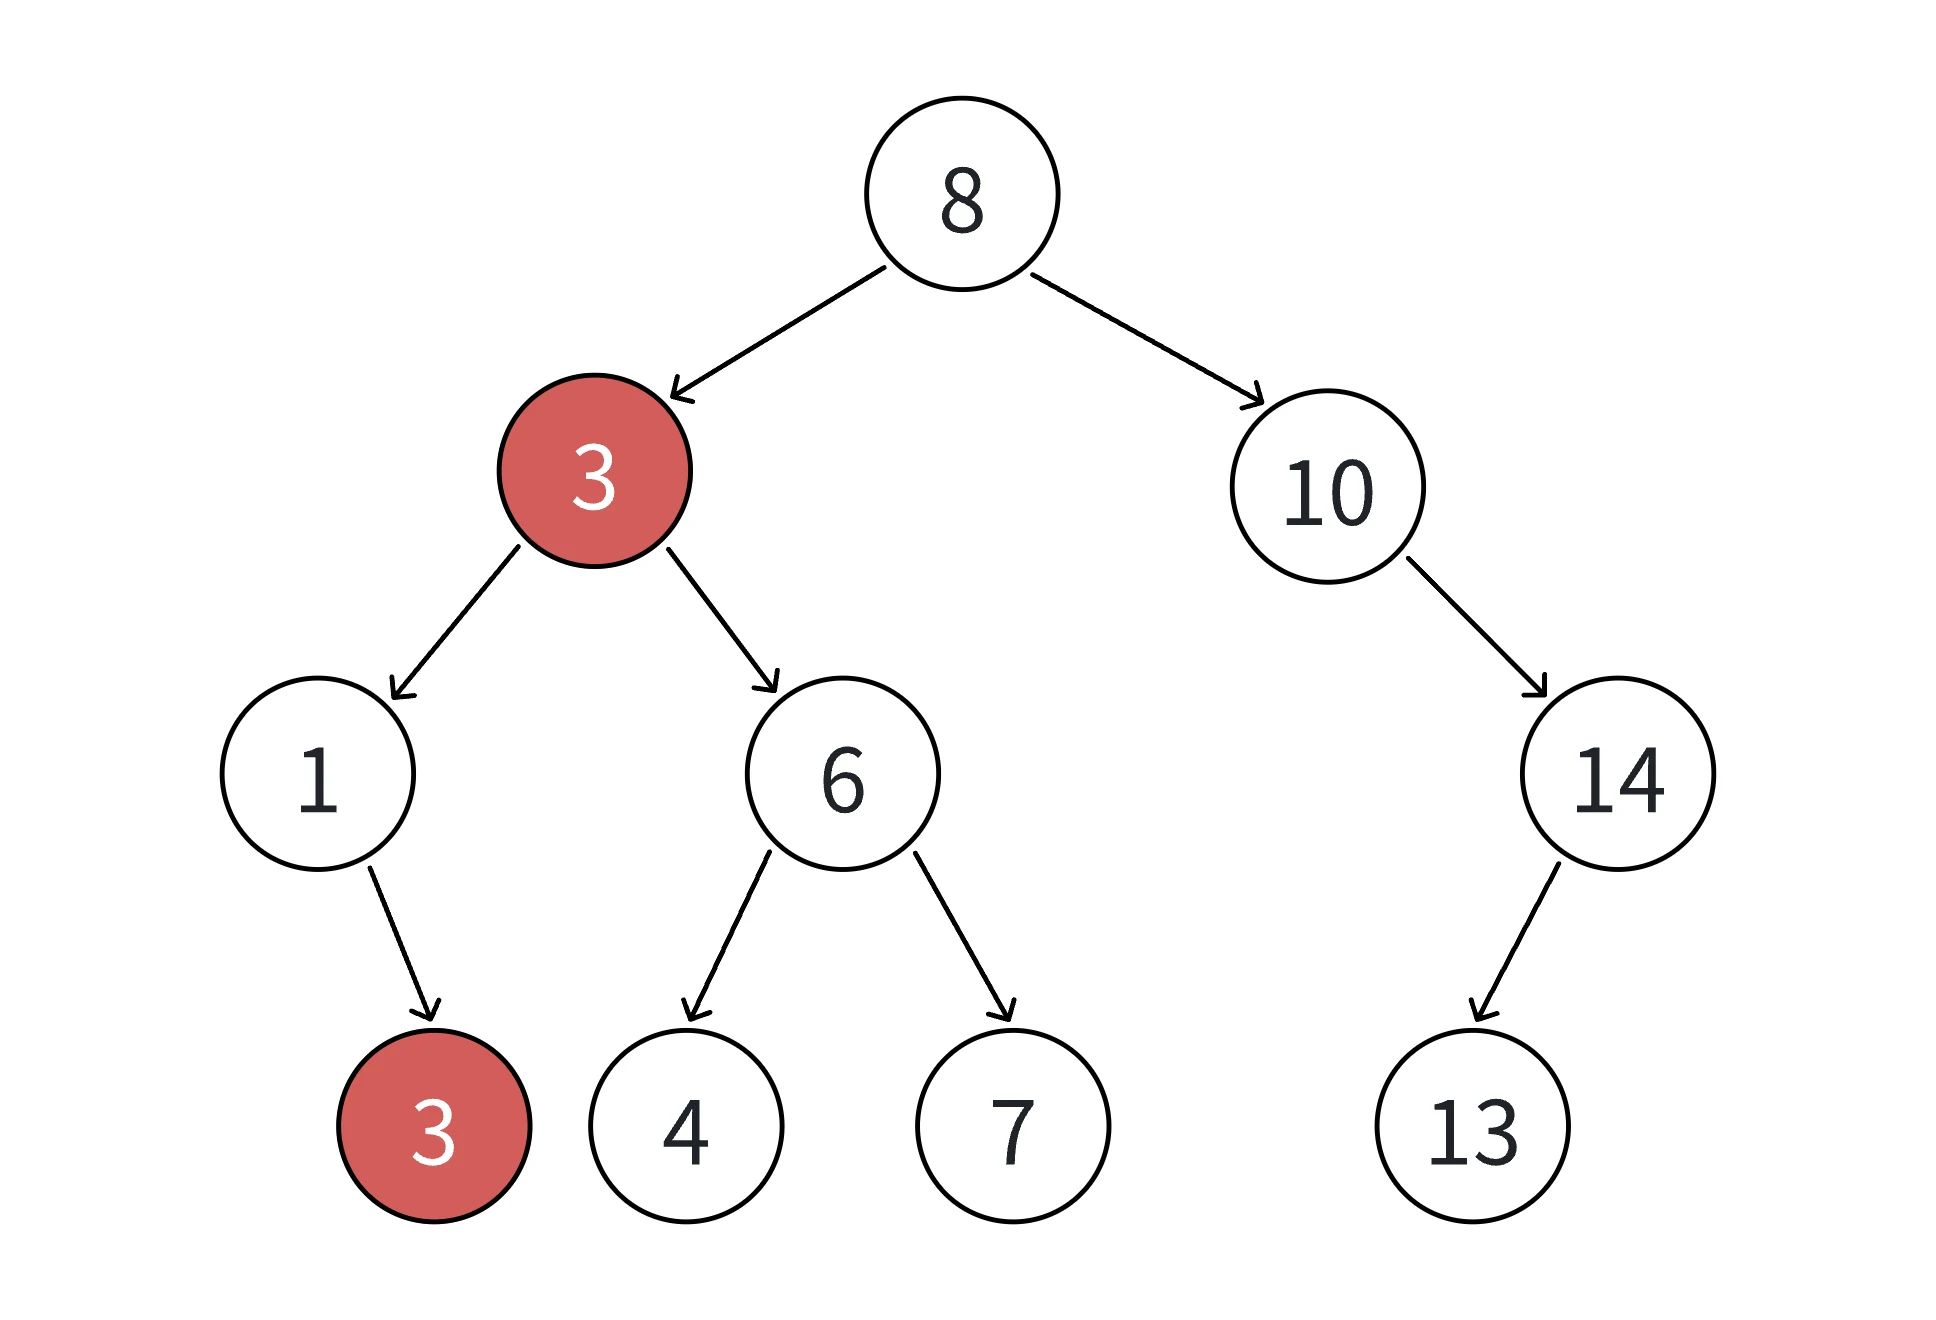
课件在这一节给的查找代码一遇到相等就 return true。如果照那棵树走,从根到 3 的第一站是左上那个 3,返回的就是它,而不是 1 的右孩子——这一节的文字和代码在这里对不上。要满足"中序第一个",只在命中时记下候选、然后继续往左:
    Node* FindFirst(const K& key)
    {
        Node* cur = _root;
        Node* candidate = nullptr;
        while (cur)
        {
            if (cur->_key < key)
            {
                cur = cur->_right;
            }
            else if (cur->_key > key)
            {
                cur = cur->_left;
            }
            else
            {
                candidate = cur;
                cur = cur->_left;
            }
        }
        return candidate;
    }
这段对两种插入约定都成立:相等值都往右走时,路径上第一个相等的结点本来就是所有相等结点的祖先,也就是中序第一个;相等值都往左走时,继续往左才会走到更靠前的那一个,候选会一直被刷新。前提仍是课件那句——相等值的方向不能一会儿左一会儿右,否则"第一个"没有定义。
删除:四种情况,三种形状
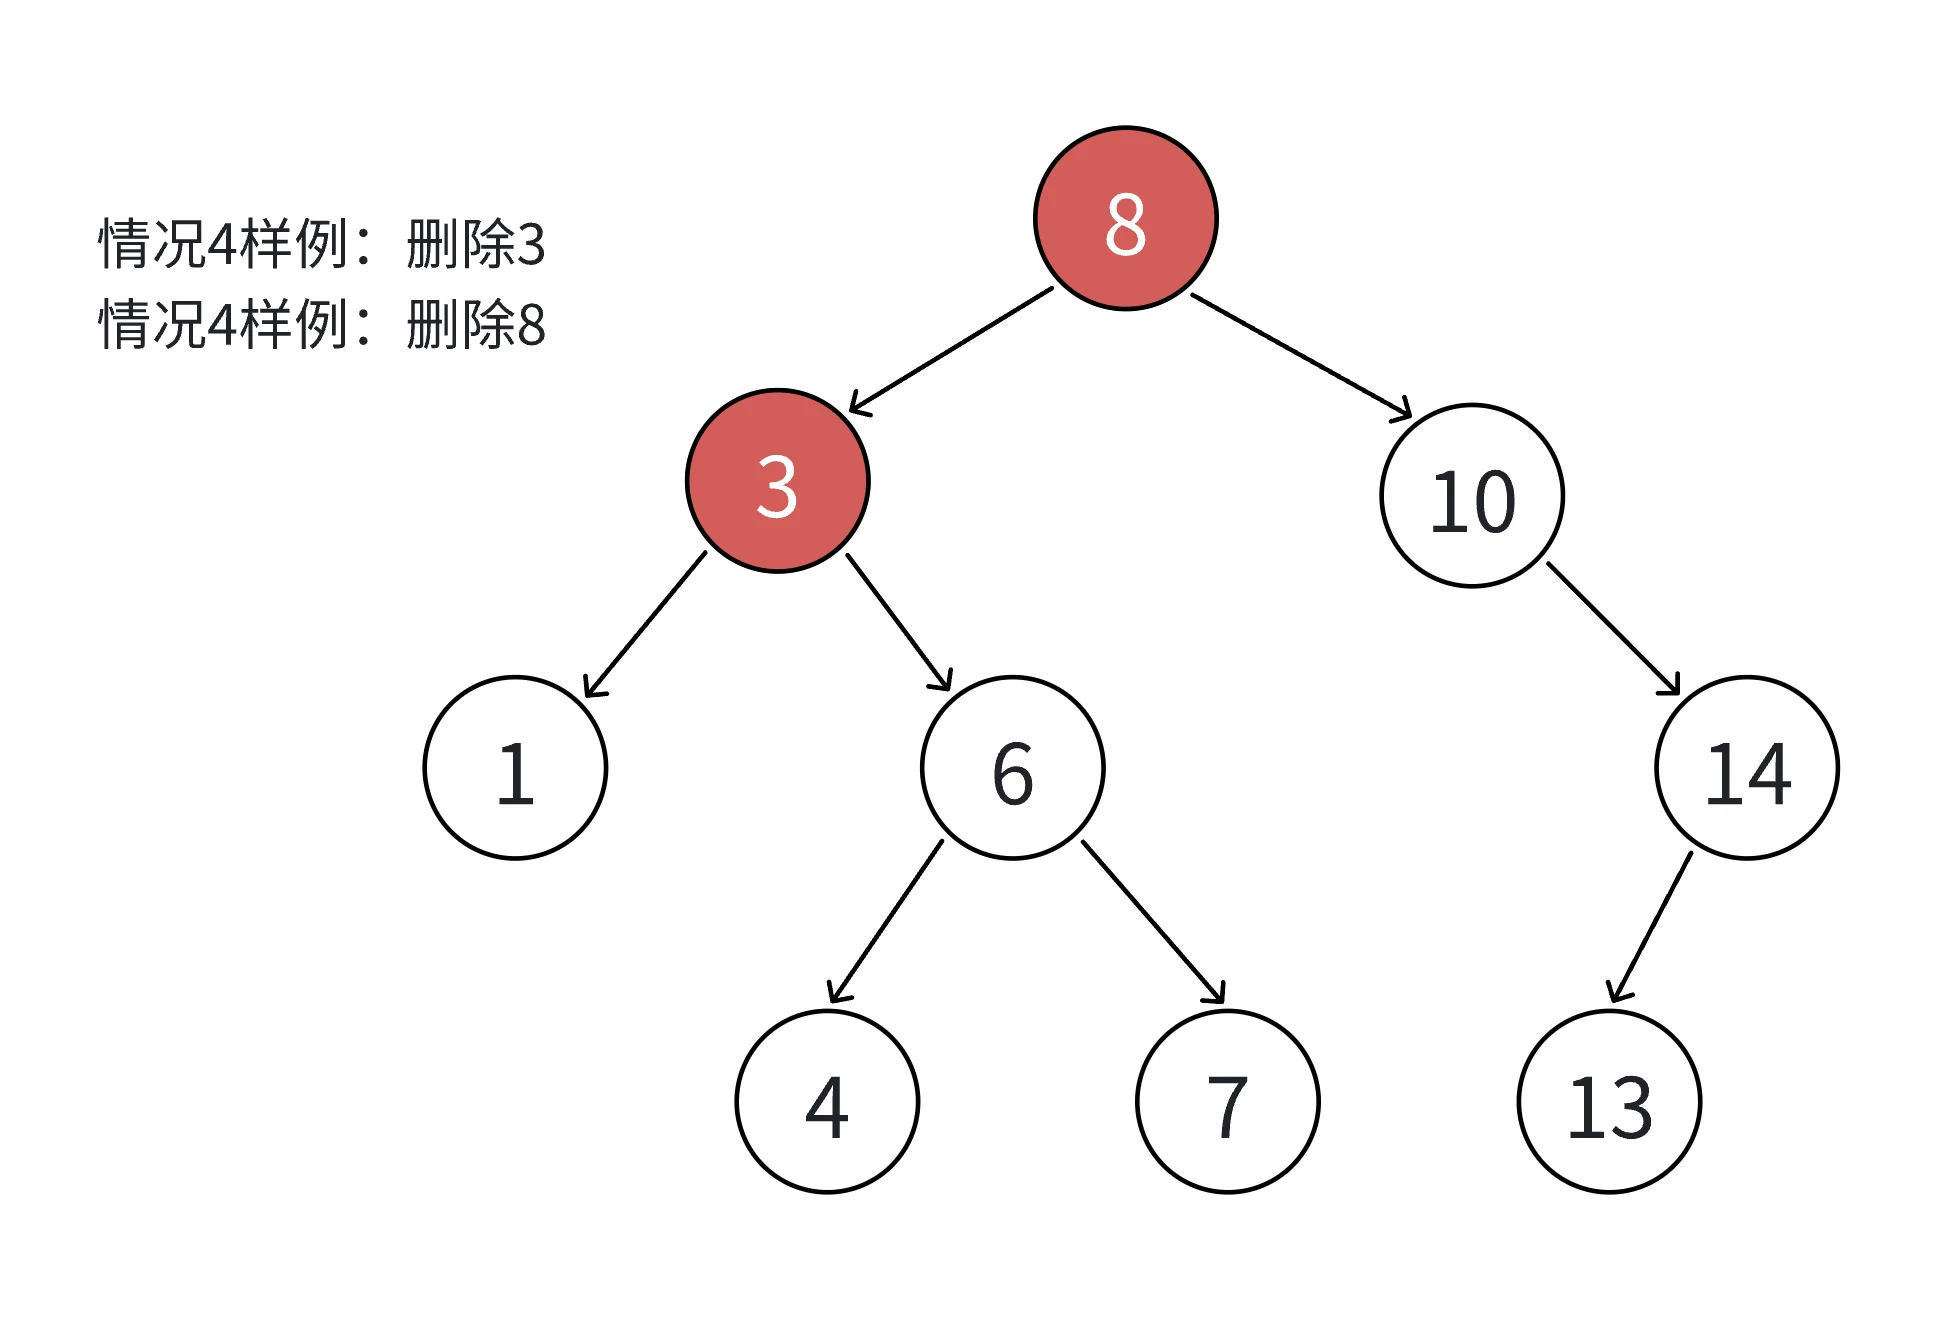
课件把删除拆成四种:左右都空、左空、右空、两个孩子都在。前三种的处理动作只差"接上哪个孩子",所以代码里合成两个分支:
| 待删结点 N 的孩子 | 动作 |
|---|---|
| 左空(含叶子) | 父亲的孩子指针改指 N 的右孩子 |
| 右空 | 父亲的孩子指针改指 N 的左孩子 |
| 两个孩子都在 | 用左子树最大值或右子树最小值替换 N 的值,转而删除那个结点 |
两个孩子都在时为什么能换?右子树的最小结点是 N 的中序后继,它左边所有值都比 N 小,右边所有值都比 N 大,放到 N 的位置,整棵树的有序关系不动。它还有一个结构上的好处:右子树最小结点一定没有左孩子,左子树最大结点一定没有右孩子,替换之后问题自动落到前两种形状。删根时父亲是空指针,必须先改 _root,不能走 parent->_left。
    bool Erase(const K& key)
    {
        Node* parent = nullptr;
        Node* cur = _root;
        while (cur)
        {
            if (cur->_key < key)
            {
                parent = cur;
                cur = cur->_right;
            }
            else if (cur->_key > key)
            {
                parent = cur;
                cur = cur->_left;
            }
            else
            {
                break;
            }
        }
        if (cur == nullptr)
        {
            return false;
        }

        if (cur->_left == nullptr)
        {
            Node* child = cur->_right;
            if (parent == nullptr)
            {
                _root = child;
            }
            else if (parent->_left == cur)
            {
                parent->_left = child;
            }
            else
            {
                parent->_right = child;
            }
            delete cur;
            return true;
        }

        if (cur->_right == nullptr)
        {
            Node* child = cur->_left;
            if (parent == nullptr)
            {
                _root = child;
            }
            else if (parent->_left == cur)
            {
                parent->_left = child;
            }
            else
            {
                parent->_right = child;
            }
            delete cur;
            return true;
        }

        Node* rightMinP = cur;
        Node* rightMin = cur->_right;
        while (rightMin->_left)
        {
            rightMinP = rightMin;
            rightMin = rightMin->_left;
        }
        cur->_key = rightMin->_key;

        if (rightMinP->_left == rightMin)
        {
            rightMinP->_left = rightMin->_right;
        }
        else
        {
            rightMinP->_right = rightMin->_right;
        }
        delete rightMin;
        return true;
    }

    void InOrder() const
    {
        _InOrder(_root);
        std::cout << '\n';
    }

private:
    void _InOrder(Node* root) const
    {
        if (root == nullptr)
        {
            return;
        }
        _InOrder(root->_left);
        std::cout << root->_key << ' ';
        _InOrder(root->_right);
    }

    Node* _root = nullptr;
int main()
{
BSTree<int> t;
int a[] = {8, 3, 1, 10, 6, 4, 7, 14, 13};
for (int e : a)
{
t.Insert(e);
}
t.InOrder(); // 1 3 4 6 7 8 10 13 14
t.Erase(8);
t.InOrder(); // 1 3 4 6 7 10 13 14
return 0;
}Node* rightMinP = cur; 而不是 nullptr,是这段代码最容易写错的一行。待删结点的右子树根本身就可能是最小结点(根没有左孩子),此时 while 一次都不进,rightMinP 只能靠初值。课件在替换分支里留了注释"一定要把 cur 给 rightMinP",说的就是这件事。
删除还有一个只在 key/value 版本里出现的问题。课件 key/value 版的 Erase 在替换时写的是 cur->_key = rightMin->_key;,只搬了 key,没搬 value。结点里存着两个字段,只搬一个会让键和值错位:字典里删 left(根),后继是 right,根结点的 key 变成 "right"、value 还是 "左边",之后再查 right,屏幕上出来的是"左边",而树的形状和中序看起来都正常。
中序有序证明不了树高
中序遍历的代码就是递归的三行,已经在 InOrder 和 _InOrder 里。它能证明"树里存了哪些值、顺序对不对",证明不了"这棵树长什么样"。下面两张图是同一组键的两种形态:
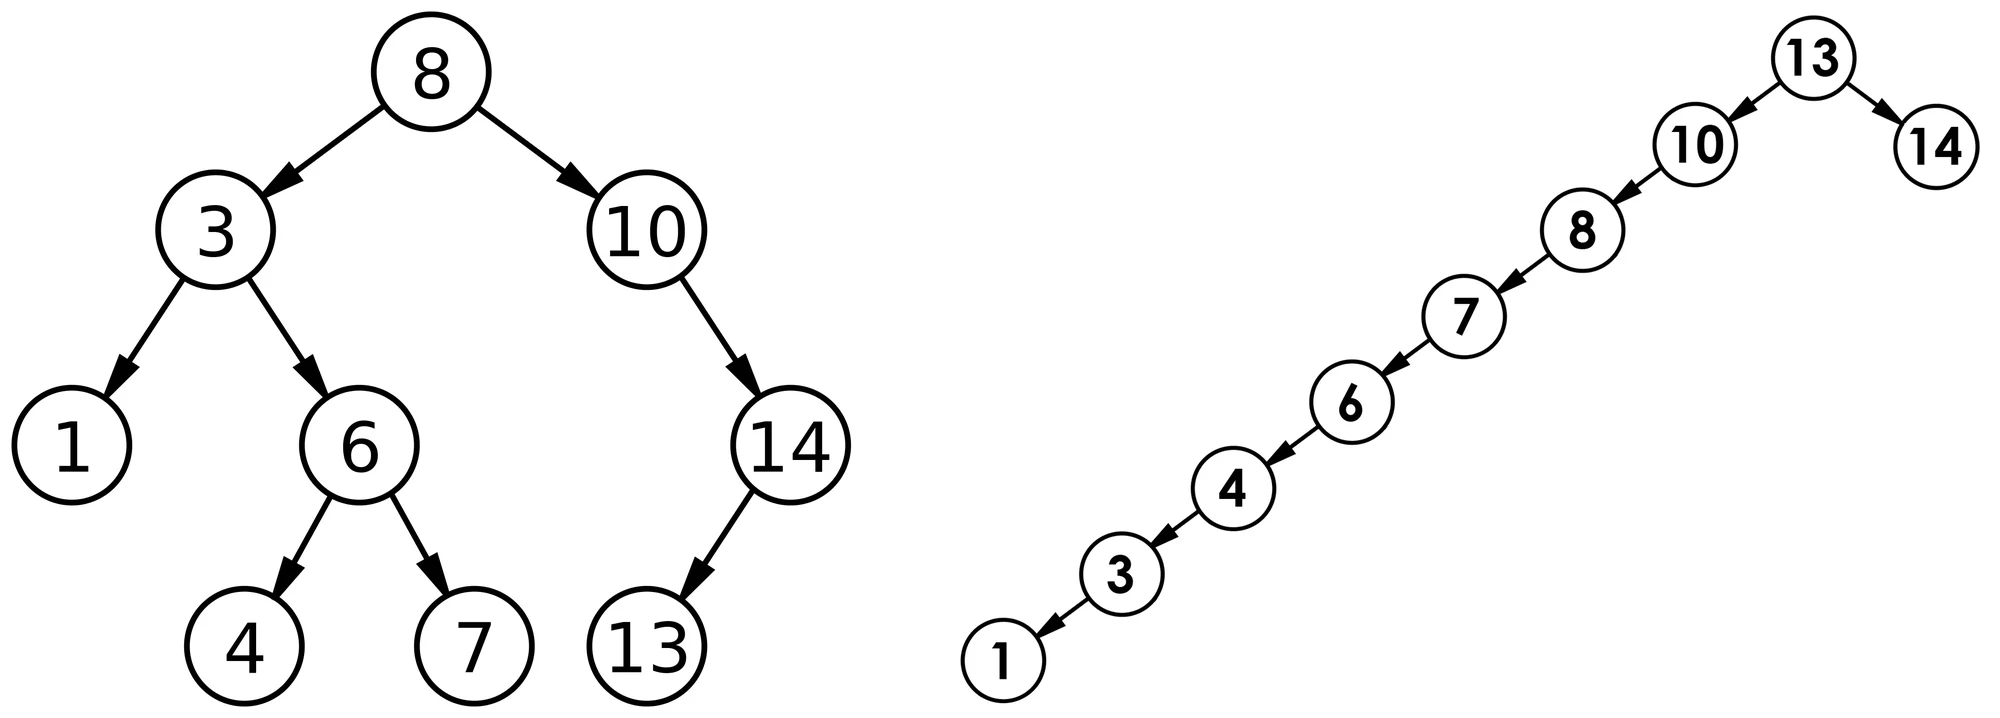
把差距量出来:1023 个整数按 1 到 1023 依次插入,树高等于 1023,查找退化成线性扫描;按中点顺序插入,树高是 10。同样的结点数,路径长度差两个数量级。
课件在性能分析里写"最优情况下,二叉搜索树为完全二叉树(或接近完全二叉树),其高度为 log₂N",接着写"最差情况下退化为单支树,高度为 N",最后给出"增删查改时间复杂度为 O(N)"。这三句的口径需要对齐:
- 高度按层数算是
⌊log₂N⌋ + 1,按边数是⌊log₂N⌋;同一段里 N 一会儿指结点数、一会儿指高度,读起来会差一层。 - O(N) 是最坏界,不是平均界。插入序列足够乱时,随机二叉搜索树的期望高度是
4.311 ln N(约2.99 log₂N),这是 Devroye 和 Reed 证明的结论。 - 二叉搜索树没有"改"这个操作。改 key 等于把结点挪出了它该在的位置,课件后面讲 key/value 场景时自己写了"不支持修改 key"。
"期望"两个字要读准:它对随机序列取平均,不对任何具体序列作保证。按时间戳递增到达的日志、按自增 id 到达的订单、按字母序读进来的词库,都是天然的升序插入。所以标准库不可能用裸 BST,只能自己把树高按住。
另一条常被拿来做对比的路径是二分查找:它能做到 O(log₂N),但要求数据存在支持下标随机访问的结构里并且有序;插入删除要挪动大量元素,平均 O(N)。平衡二叉搜索树要解决的正是这两头。
key 场景与 key/value 场景
二叉搜索树的结点只存 key 时,它只回答"这个值在不在",支持增删查,不支持修改 key。课件给的两个场景很典型:小区无人值守车库把买下车位的车牌号存进树,车来时扫车牌查在不在;英文拼写检查把词库放进树,读文章里的每个单词查一次,不在就标红。这两个场景都只需要 key。
结点多存一个 value,就成了 key/value 结构:增删查仍以 key 为关键字走同一套规则,但允许修改 value。字典存"英文 → 中文",停车系统存"车牌 → 入场时间"(出口用当前时间减入场时间算费用),词频统计存"单词 → 次数"。这三种用法共同点是:查找要拿到 key 对应的数据,而不是只回答在不在。
template<class K, class V>
struct BSTNode
{
    K _key;
    V _value;
    BSTNode<K, V>* _left;
    BSTNode<K, V>* _right;

    BSTNode(const K& key, const V& value)
        : _key(key), _value(value), _left(nullptr), _right(nullptr)
    {}
};
课件在这里留了一行被注释掉的 // pair<K, V> _kv;,最终用两个独立成员。两种存法都能工作,分开写的好处是比较时只看 _key,不用记住"pair 默认先比 first 再比 second"。
把上一节的 BSTree<K> 换成 BSTree<K, V>,三个函数改这几处:Insert 多收一个 value 并传给结点构造;Find 返回 Node* 而不是 bool,调用者拿到结点后可以直接改 _value;Erase 的替换分支要同时搬 key 和 value。
    bool Insert(const K& key, const V& value)
    {
        if (_root == nullptr)
        {
            _root = new Node(key, value);
            return true;
        }

        Node* parent = nullptr;
        Node* cur = _root;
        while (cur)
        {
            if (cur->_key < key)
            {
                parent = cur;
                cur = cur->_right;
            }
            else if (cur->_key > key)
            {
                parent = cur;
                cur = cur->_left;
            }
            else
            {
                return false;
            }
        }

        Node* newNode = new Node(key, value);
        if (parent->_key < key)
        {
            parent->_right = newNode;
        }
        else
        {
            parent->_left = newNode;
        }
        return true;
    }

    Node* Find(const K& key)
    {
        Node* cur = _root;
        while (cur)
        {
            if (cur->_key < key)
            {
                cur = cur->_right;
            }
            else if (cur->_key > key)
            {
                cur = cur->_left;
            }
            else
            {
                return cur;
            }
        }
        return nullptr;
    }
Erase 的主体与 key 版相同,只把替换那两行改成:
        cur->_key = rightMin->_key;
        cur->_value = rightMin->_value;
结点里持有裸指针,类就需要管住拷贝和释放。课件给的是标准的"三件套":析构里后序释放整棵树,拷贝构造深拷贝一棵新树,赋值用"传值 + swap"。
    BSTree() = default;

    BSTree(const BSTree<K, V>& t)
    {
        _root = Copy(t._root);
    }

    BSTree<K, V>& operator=(BSTree<K, V> t)
    {
        std::swap(_root, t._root);
        return *this;
    }

    ~BSTree()
    {
        Destroy(_root);
        _root = nullptr;
    }

private:
    Node* Copy(Node* root)
    {
        if (root == nullptr)
        {
            return nullptr;
        }
        Node* newRoot = new Node(root->_key, root->_value);
        newRoot->_left = Copy(root->_left);
        newRoot->_right = Copy(root->_right);
        return newRoot;
    }

    void Destroy(Node* root)
    {
        if (root == nullptr)
        {
            return;
        }
        Destroy(root->_left);
        Destroy(root->_right);
        delete root;
    }
形参按值接收,进入函数时已经是一份副本,交换 _root 之后副本随作用域结束自动析构,原对象拿到对方的数据。这种写法的好处是自赋值和异常都不会留下半个对象;代价是多一次深拷贝。
词频统计把上面这些东西拼起来:
int main()
{
    std::string arr[] = {"苹果", "西瓜", "苹果", "西瓜", "苹果", "苹果",
                         "西瓜", "苹果", "香蕉", "苹果", "香蕉"};
    BSTree<std::string, int> countTree;

    for (const auto& str : arr)
    {
        BSTNode<std::string, int>* ret = countTree.Find(str);
        if (ret == nullptr)
        {
            countTree.Insert(str, 1);
        }
        else
        {
            ret->_value++;
        }
    }

    countTree.InOrder();      // 按字典序输出每个单词和次数
    return 0;
}
最坏 O(N) 之后
二叉搜索树的价值在于"插入只改一条指针""中序天然有序""按 key 查找",它的短板也全在树高:同一个 key 集合,插入顺序能把树高从 log₂N 推到 N。标准库不能要求用户按随机顺序插入,只能把树高做成不依赖插入顺序的保证。
AVL 树在每个结点上记一个平衡因子,把左右子树高度差压到不超过 1,树高稳定在 1.44 log₂(N+2) 以内;红黑树用颜色规则放宽到"最长路径不超过最短路径的两倍",换来更少的旋转。这两棵树的结点结构、插入挂接、替换删除、后序释放与本篇这棵裸 BST 完全一致,区别只在插入之后多出的那一段维护逻辑。
还没有评论 — 第一条由你来留。