SGI-STL30 的 stl_set.h 和 stl_map.h 都很薄,真正的实现全在 stl_tree.h 的 rb_tree 里。把源码的关键几行抽出来看,两个容器几乎是同一份代码套了两件外套:
template <class Key, class Compare = less<Key>, class Alloc = alloc>
class set
{
public:
    typedef Key key_type;
    typedef Key value_type;

private:
    typedef rb_tree<key_type, value_type,
                    identity<value_type>, key_compare, Alloc> rep_type;
    rep_type t;
};

template <class Key, class T, class Compare = less<Key>, class Alloc = alloc>
class map
{
public:
    typedef Key key_type;
    typedef T mapped_type;
    typedef pair<const Key, T> value_type;

private:
    typedef rb_tree<key_type, value_type,
                    select1st<value_type>, key_compare, Alloc> rep_type;
    rep_type t;
};
rb_tree 的第二个模板参数 Value 决定结点里存什么:set 传 Key,map 传 pair<const Key, T>。第三个参数 KeyOfValue 决定怎么从这个 Value 里取出键:set 用恒等函数 identity,map 用取 first 的 select1st。一棵红黑树因此既能做 key 场景,也能做 key/value 场景。
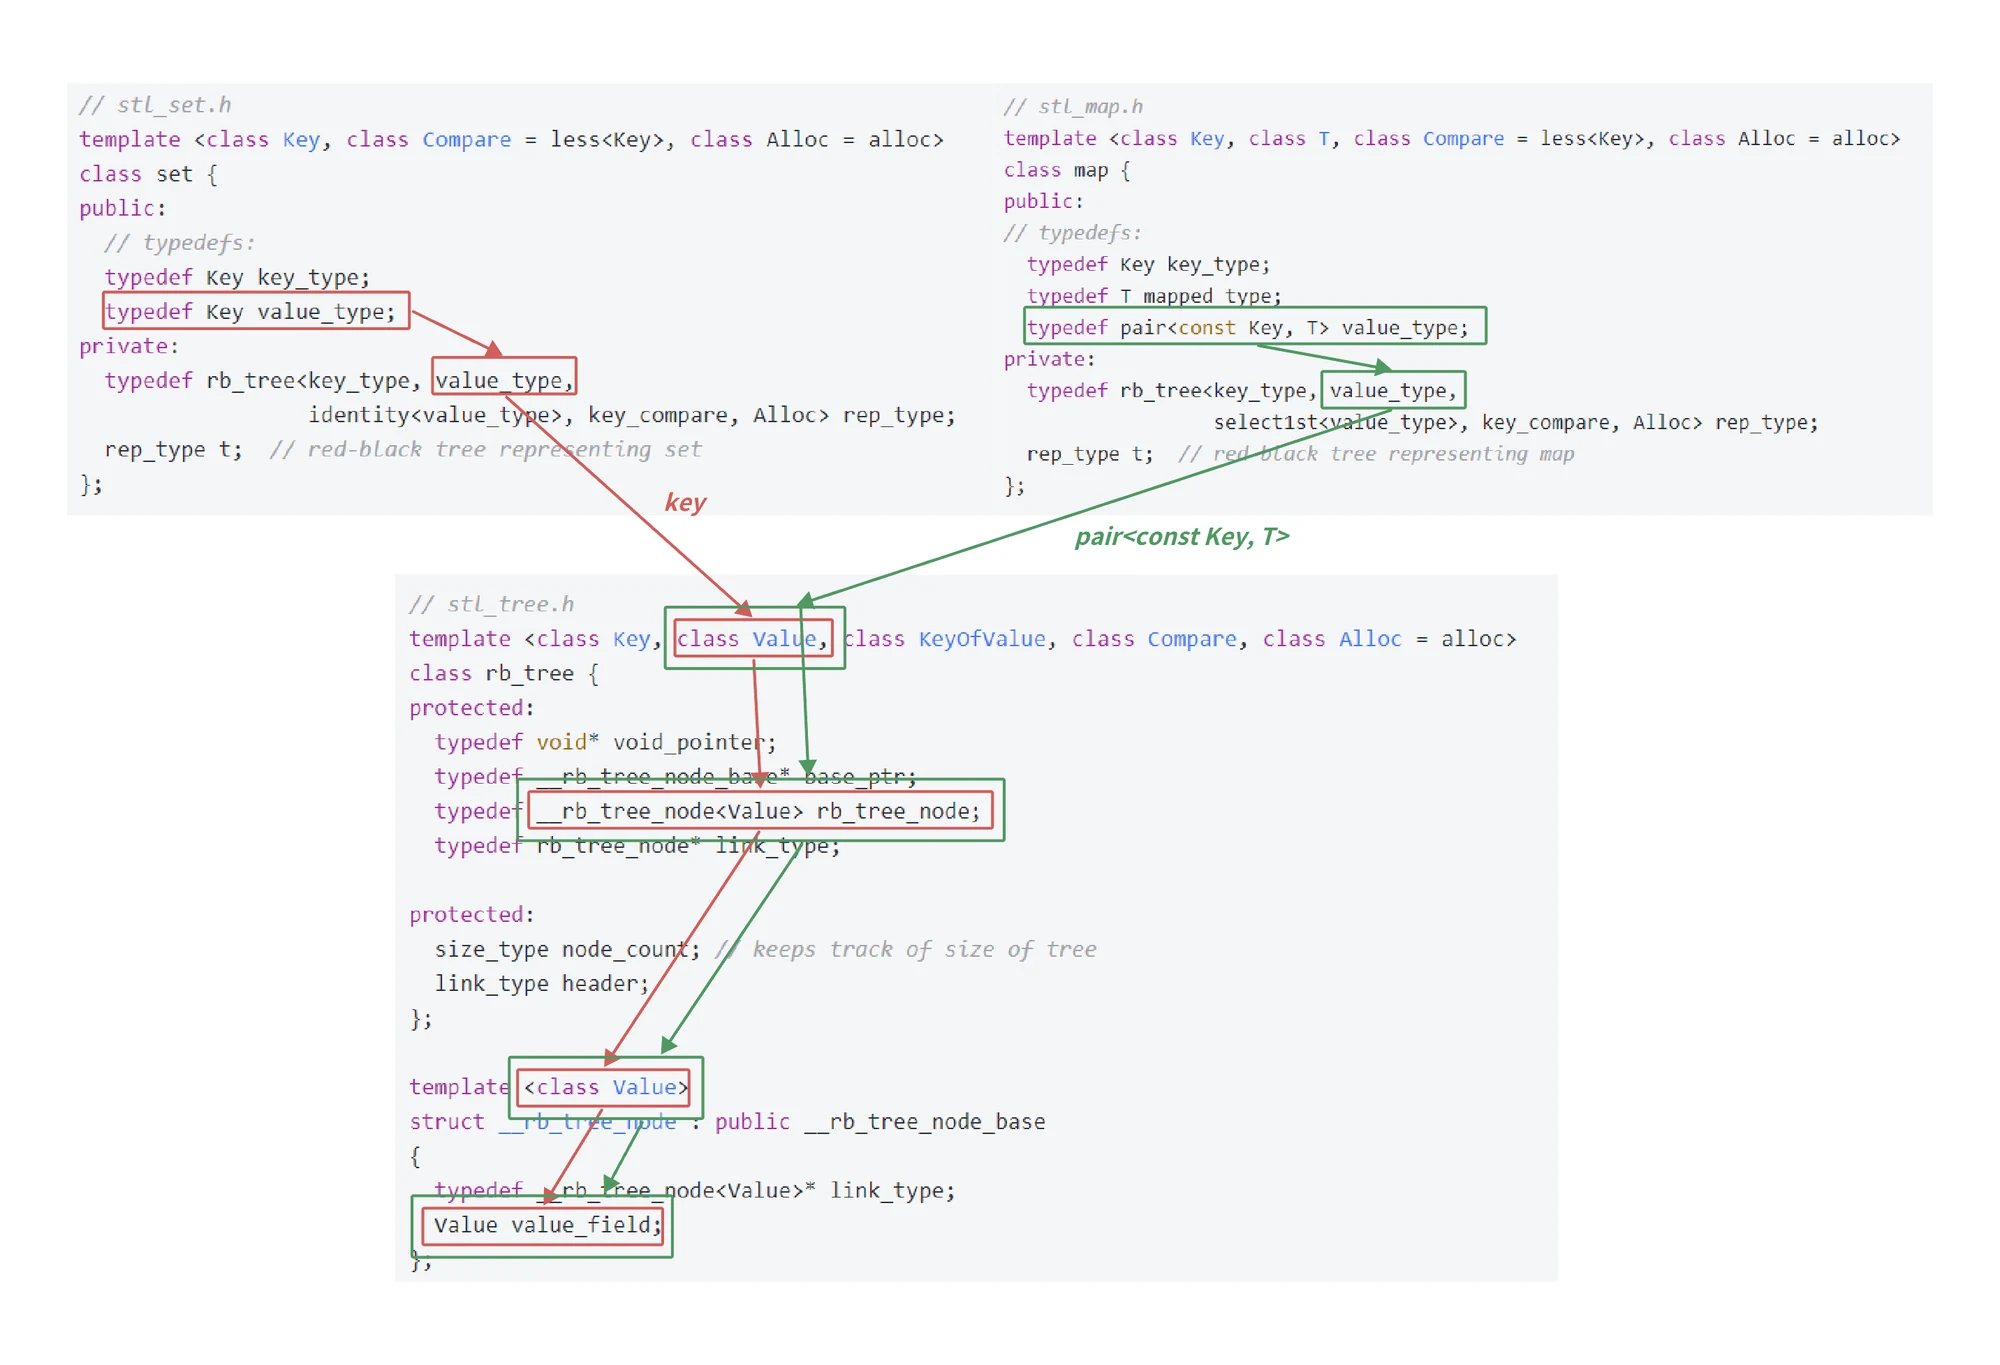
课件顺带吐槽了源码命名不统一:set 用 Key,map 用 Key 和 T,rb_tree 又用 Key 和 Value。这确实是历史包袱,读源码时记不住哪个名字对应哪一层,最好的办法是盯住"结点里存的那个类型"。
结点泛型化之后,树不知道自己该比谁
按源码的形状把结点改成只认一个类型参数:
#include <iostream>
#include <string>
#include <utility>

using std::pair;

enum Colour
{
    RED,
    BLACK
};

template<class T>
struct RBTreeNode
{
    T _data;
    RBTreeNode<T>* _left;
    RBTreeNode<T>* _right;
    RBTreeNode<T>* _parent;
    Colour _col;

    RBTreeNode(const T& data)
        : _data(data), _left(nullptr), _right(nullptr), _parent(nullptr), _col(RED)
    {}
};
T 是 set 的 K,也是 map 的 pair<const K, V>。树不再硬编码"结点里存的是什么",但立刻带来一个问题:插入时怎么比较两个 T?
set 实例化时 T 是 const K,结点里那个 _data 本身就是 const K 成员,构造完成之后任何路径都改不了它。
map 的 T 是 pair,而 std::pair 的 operator< 是字典序:先比 first,相等再比 second。如果直接拿 T 比大小,{"apple", 1} 和 {"apple", 2} 会被判成两个不同的元素:
bit::map<std::string, int> dict;
dict.insert({"apple", 1});
dict.insert({"apple", 2});   // key 相同,但 pair 的 second 不同
遍历时会打印两个 apple,size 也是 2。set 不会犯这个错,因为它的 T 就是 key 本身。所以泛型化的关键不是结点,而是把"比哪个字段"从结点里拿出去:给红黑树再传一个仿函数 KeyOfT,专门从 T 里把键取出来。
struct MapKeyOfT
{
    const K& operator()(const pair<const K, V>& kv) const
    {
        return kv.first;
    }
};

struct SetKeyOfT
{
    const K& operator()(const K& key) const
    {
        return key;
    }
};
课件这一版把 MapKeyOfT 的形参写成了 const pair<K, V>&,而树里存的是 pair<const K, V>。这样也能编译,靠的是 pair 的转换构造函数临时造一个 pair<K, V>;键是 string 时,每次比较都要拷一份字符串。改成 const pair<const K, V>& 就只传引用。
仿函数本身没有成员,kot(x) 一般会被内联成一次成员访问,运行时开销可以忽略;代价是 set 和 map 各自要定义一份,模板参数也因此多了一个。
模板参数最终是三个:template<class K, class T, class KeyOfT>。T 已经决定结点存什么了,K 为什么还要单独传?因为两个接口收的东西不一样:insert 收完整的 T(map 是一对键值,set 是一个键),find 和 erase 只收 K。find 的签名要是只有 T,map 就没法只用一个键来查。set 里这两个参数恰好相同,map 里完全不同。
树里的所有比较都改成通过仿函数取键,写成 kot(cur->_data) < kot(data) 和 kot(data) < kot(cur->_data)。只写 <、不写 >,是因为 a > b 可以写成 b < a,这样自定义类型只需要一个严格弱序;相等也不靠 ==,而是"既不小于、也不大于"。
迭代器:++ 只看当前结点和祖先
树的结点之间没有物理上的"下一个",++ 只能靠结构推算。规则两句:
- 右子树不为空,下一个是右子树的最左结点;
- 右子树为空,沿着祖先往上爬,直到"当前结点是父亲的左孩子"为止,那个父亲就是下一个。
如果一路爬上去都没遇到"孩子是父亲的左",说明当前结点是整棵树的最右结点,parent 最终变成空,正好用空指针表示 end()。
迭代器类别是双向:++ 和 -- 都能走,但没有 it + n,想跳 n 步只能循环。begin()/end() 各有 const 重载,const set 拿到的是 ConstIterator,所以 Print 的参数写成 const set& 也能遍历。
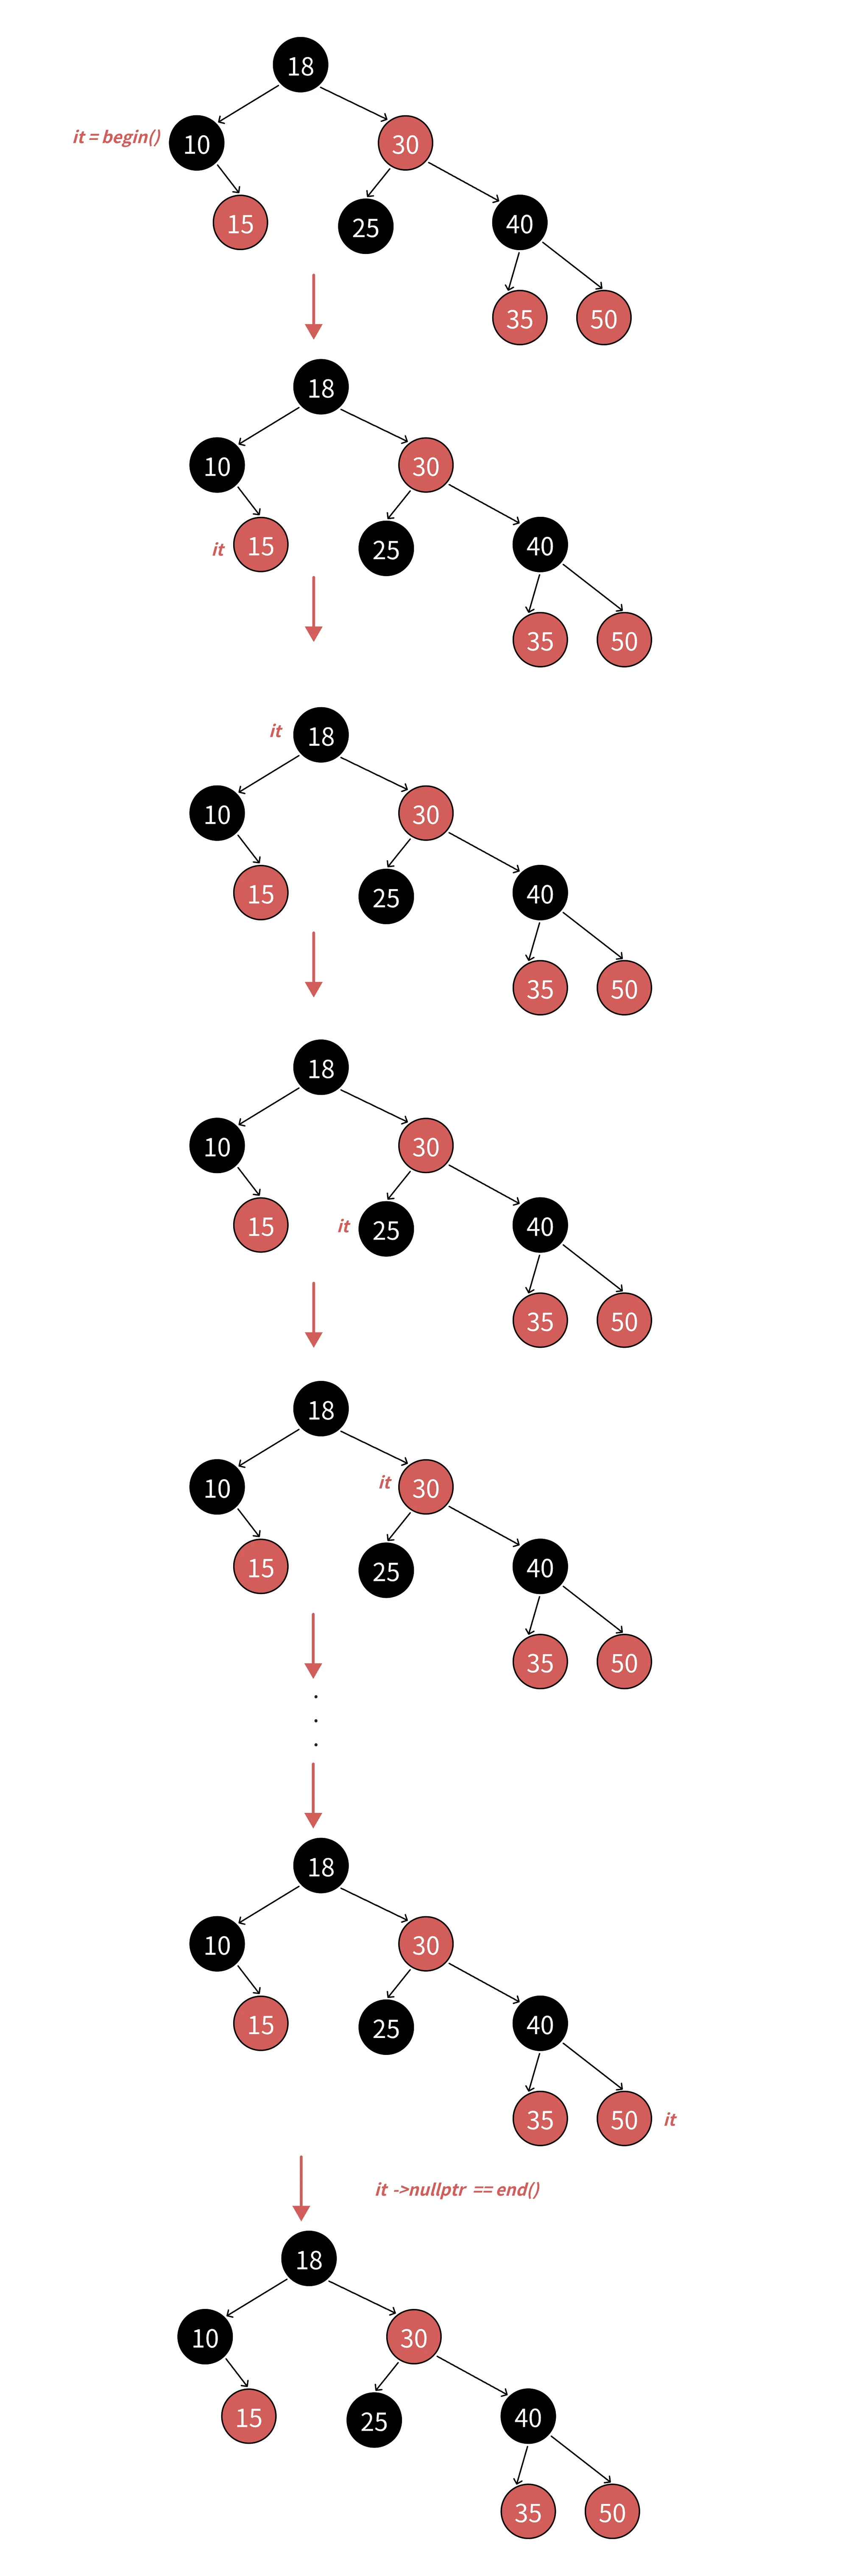
-- 是 ++ 的镜像:左子树不为空就取左子树最右结点;否则往上找"孩子是父亲的右"。--end() 是个特殊情形:_node 是空,推不出前驱,所以迭代器里多存一个 _root,从根一路往右走到底。
SGI 源码不付这个代价,它给红黑树加了一个哨兵头结点 header:header 与根互为父亲,header.left 指向最左结点,header.right 指向最右结点。
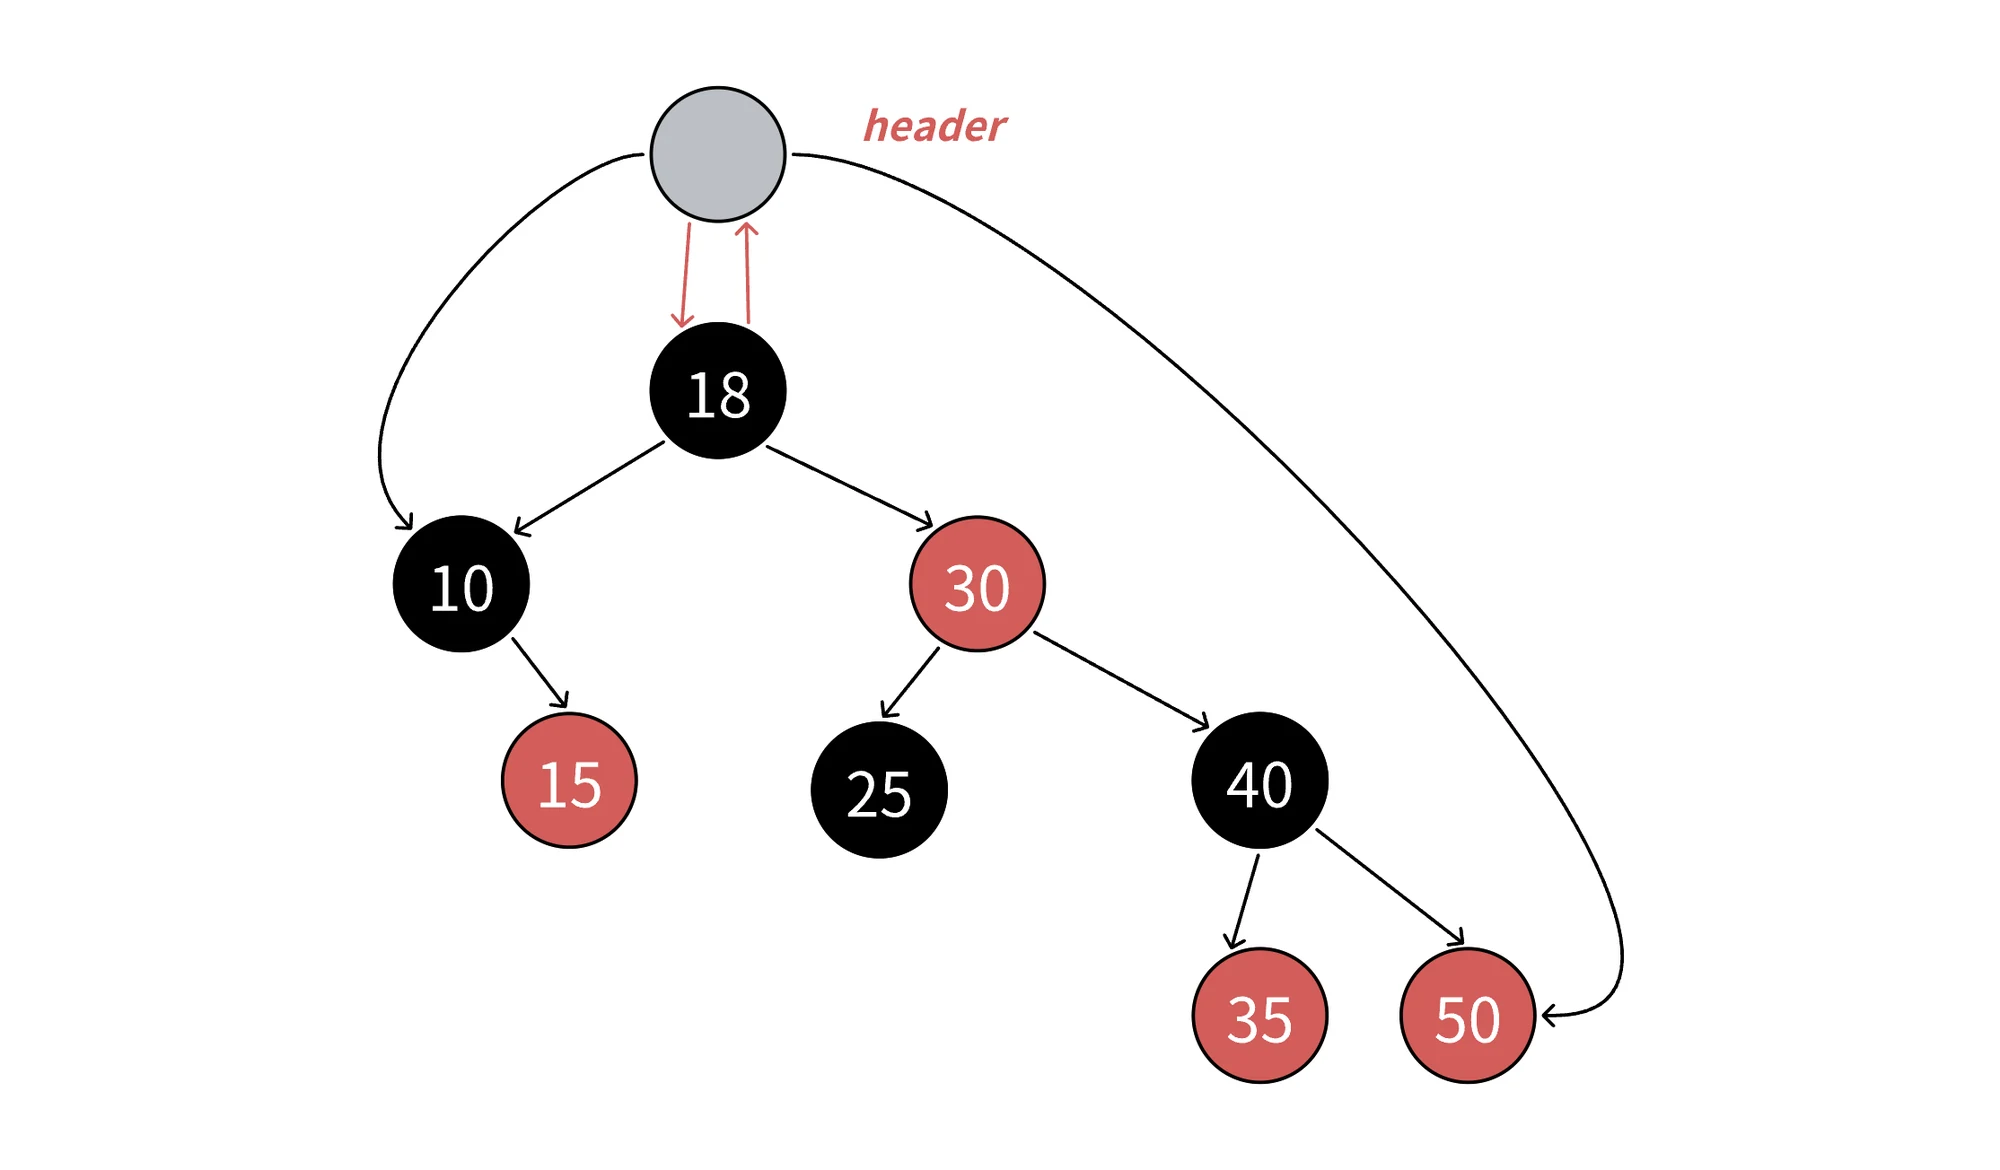
有了它,begin()、end()、--end() 都不用特判,空树也能统一处理。源码里 decrement() 那句"红结点且父亲的父亲是自己"看着莫名其妙,其实就是在认"当前结点是不是 header"。教学版用多存一个指针换掉了这份特判,代价是每个迭代器多 8 字节。
template<class T, class Ref, class Ptr>
struct RBTreeIterator
{
    typedef RBTreeNode<T> Node;
    typedef RBTreeIterator<T, Ref, Ptr> Self;

    Node* _node;
    Node* _root;

    RBTreeIterator(Node* node, Node* root)
        : _node(node), _root(root)
    {}

    Ref operator*() const
    {
        return _node->_data;
    }

    Ptr operator->() const
    {
        return &_node->_data;
    }

    Self& operator++()
    {
        if (_node->_right)
        {
            Node* leftMost = _node->_right;
            while (leftMost->_left)
            {
                leftMost = leftMost->_left;
            }
            _node = leftMost;
        }
        else
        {
            Node* cur = _node;
            Node* parent = cur->_parent;
            while (parent && cur == parent->_right)
            {
                cur = parent;
                parent = cur->_parent;
            }
            _node = parent;
        }
        return *this;
    }

    Self& operator--()
    {
        if (_node == nullptr)
        {
            Node* rightMost = _root;
            while (rightMost && rightMost->_right)
            {
                rightMost = rightMost->_right;
            }
            _node = rightMost;
        }
        else if (_node->_left)
        {
            Node* rightMost = _node->_left;
            while (rightMost->_right)
            {
                rightMost = rightMost->_right;
            }
            _node = rightMost;
        }
        else
        {
            Node* cur = _node;
            Node* parent = cur->_parent;
            while (parent && cur == parent->_left)
            {
                cur = parent;
                parent = cur->_parent;
            }
            _node = parent;
        }
        return *this;
    }

    bool operator==(const Self& s) const
    {
        return _node == s._node;
    }

    bool operator!=(const Self& s) const
    {
        return _node != s._node;
    }
};
一棵完整的泛型红黑树
Insert 除了比较换成 KeyOfT,其余与普通红黑树一致:新结点涂红,父亲是红才修,叔叔红只变色,叔叔黑按形状单旋或双旋,最后无条件把根刷黑。返回类型是 pair<Iterator, bool>,两个结果都指向这个 key 最终所在的结点——失败时 insert 顺便当了一次查找,operator[] 要的就是这一点。
template<class K, class T, class KeyOfT>
class RBTree
{
    typedef RBTreeNode<T> Node;

public:
    typedef RBTreeIterator<T, T&, T*> Iterator;
    typedef RBTreeIterator<T, const T&, const T*> ConstIterator;

    RBTree() = default;

    RBTree(const RBTree&) = delete;
    RBTree& operator=(const RBTree&) = delete;

    ~RBTree()
    {
        Destroy(_root);
        _root = nullptr;
    }

    Iterator Begin()
    {
        Node* leftMost = _root;
        while (leftMost && leftMost->_left)
        {
            leftMost = leftMost->_left;
        }
        return Iterator(leftMost, _root);
    }

    Iterator End()
    {
        return Iterator(nullptr, _root);
    }

    ConstIterator Begin() const
    {
        Node* leftMost = _root;
        while (leftMost && leftMost->_left)
        {
            leftMost = leftMost->_left;
        }
        return ConstIterator(leftMost, _root);
    }

    ConstIterator End() const
    {
        return ConstIterator(nullptr, _root);
    }

    pair<Iterator, bool> Insert(const T& data)
    {
        if (_root == nullptr)
        {
            _root = new Node(data);
            _root->_col = BLACK;
            return pair<Iterator, bool>(Iterator(_root, _root), true);
        }

        KeyOfT kot;
        Node* parent = nullptr;
        Node* cur = _root;
        while (cur)
        {
            if (kot(cur->_data) < kot(data))
            {
                parent = cur;
                cur = cur->_right;
            }
            else if (kot(data) < kot(cur->_data))
            {
                parent = cur;
                cur = cur->_left;
            }
            else
            {
                return pair<Iterator, bool>(Iterator(cur, _root), false);
            }
        }

        cur = new Node(data);
        Node* newnode = cur;
        cur->_col = RED;
        if (kot(parent->_data) < kot(data))
        {
            parent->_right = cur;
        }
        else
        {
            parent->_left = cur;
        }
        cur->_parent = parent;

        while (parent && parent->_col == RED)
        {
            Node* grand = parent->_parent;

            if (parent == grand->_left)
            {
                Node* uncle = grand->_right;
                if (uncle && uncle->_col == RED)
                {
                    parent->_col = uncle->_col = BLACK;
                    grand->_col = RED;
                    cur = grand;
                    parent = cur->_parent;
                }
                else
                {
                    if (cur == parent->_left)
                    {
                        RotateR(grand);
                        parent->_col = BLACK;
                        grand->_col = RED;
                    }
                    else
                    {
                        RotateL(parent);
                        RotateR(grand);
                        cur->_col = BLACK;
                        grand->_col = RED;
                    }
                    break;
                }
            }
            else
            {
                Node* uncle = grand->_left;
                if (uncle && uncle->_col == RED)
                {
                    parent->_col = uncle->_col = BLACK;
                    grand->_col = RED;
                    cur = grand;
                    parent = cur->_parent;
                }
                else
                {
                    if (cur == parent->_right)
                    {
                        RotateL(grand);
                        parent->_col = BLACK;
                        grand->_col = RED;
                    }
                    else
                    {
                        RotateR(parent);
                        RotateL(grand);
                        cur->_col = BLACK;
                        grand->_col = RED;
                    }
                    break;
                }
            }
        }

        _root->_col = BLACK;
        return pair<Iterator, bool>(Iterator(newnode, _root), true);
    }

    Iterator Find(const K& key)
    {
        KeyOfT kot;
        Node* cur = _root;
        while (cur)
        {
            if (kot(cur->_data) < key)
            {
                cur = cur->_right;
            }
            else if (key < kot(cur->_data))
            {
                cur = cur->_left;
            }
            else
            {
                return Iterator(cur, _root);
            }
        }
        return End();
    }

private:
    void RotateL(Node* parent)
    {
        Node* subR = parent->_right;
        Node* subRL = subR->_left;

        parent->_right = subRL;
        if (subRL)
        {
            subRL->_parent = parent;
        }

        Node* parentParent = parent->_parent;

        subR->_left = parent;
        parent->_parent = subR;

        if (parentParent == nullptr)
        {
            _root = subR;
            subR->_parent = nullptr;
        }
        else
        {
            if (parent == parentParent->_left)
            {
                parentParent->_left = subR;
            }
            else
            {
                parentParent->_right = subR;
            }
            subR->_parent = parentParent;
        }
    }

    void RotateR(Node* parent)
    {
        Node* subL = parent->_left;
        Node* subLR = subL->_right;

        parent->_left = subLR;
        if (subLR)
        {
            subLR->_parent = parent;
        }

        Node* parentParent = parent->_parent;

        subL->_right = parent;
        parent->_parent = subL;

        if (parentParent == nullptr)
        {
            _root = subL;
            subL->_parent = nullptr;
        }
        else
        {
            if (parent == parentParent->_left)
            {
                parentParent->_left = subL;
            }
            else
            {
                parentParent->_right = subL;
            }
            subL->_parent = parentParent;
        }
    }

    void Destroy(Node* root)
    {
        if (root == nullptr)
        {
            return;
        }
        Destroy(root->_left);
        Destroy(root->_right);
        delete root;
    }

    Node* _root = nullptr;
};
课件最后一版 Find 的函数体里还写着 cur->_kv.first,而泛型结点里根本没有 _kv 这个成员,照抄会直接编译失败。泛型化之后,取键必须走 kot(cur->_data)。
while 每一轮开头都要重新取 grand = parent->_parent,不能缓存。上一轮走了变色分支后,cur 变成了原来的 grand,parent 也跟着换了,缓存下来的 grand 已经过期。旋转里 parentParent 必须在 parent->_parent = subL; 之前取,subLR、subRL 可能为空。这三处都是断链的来源。
Insert 成功和失败两个分支都构造 Iterator(结点, _root),因为迭代器要存根指针才能处理 --end();只传结点的话,-- 到端点就没法回头。每个迭代器因此多存一个指针,代价是两个指针而不是一个;和遍历时少写一份特判相比,这个换法在教学代码里划算。
Find 走空时返回 End(),也就是空指针包装出来的迭代器,调用方统一用 != end() 判断,不需要另一套约定。
const 写在 T 里,不是写在迭代器外面
容器按键排好序,键一旦被用户改掉,整棵树就废了,而且不会立刻报错,只会在下次 find 时莫名其妙落空。所以"键不可改"必须做成类型层面的保证,不能只靠文档提醒。
做法是把它塞进 T 本身:
RBTree<K, const K, SetKeyOfT> _t;              // set:元素整体只读
RBTree<K, pair<const K, V>, MapKeyOfT> _t;     // map:first 只读,second 可写
set 的 T 是 const K,迭代器解引用得到 const K&,*it += 2 编译期就被拒。map 的 const 只加在 pair 的第一个成员上,it->first = "x" 同样编不过,it->second 却可以照改。标准库的 value_type 就是 std::pair<const Key, T>,cppreference 的 std::map 页面写得很明确。
Iterator 和 ConstIterator 是同一个模板用不同的 Ref、Ptr 实例化出来的两个类型,不能互相赋值;const 成员函数返回的是 ConstIterator,非 const 对象调用 begin() 返回 Iterator。这也是 begin/end 要写两份的原因。
为什么不把 set 的 iterator 直接 typedef 成 ConstIterator 就完事?那只是接口层面的承诺,结点里的数据本身仍然可写,任何拿到内部指针的路径都能改,比如 Insert 里的 newnode。把 const 放进 T,则指向这个结点的任何指针、引用、迭代器天生只能读。
这一层还会带出一个模板语法坑:导出依赖类型时 typename 不能省。
typedef typename RBTree<K, const K, SetKeyOfT>::Iterator iterator;RBTree<K, const K, SetKeyOfT>::Iterator 依赖模板参数,编译器不知道它是类型还是静态成员,漏掉 typename 就是一行编译错误。
operator[] 的魔法,前提是 insert 返回两个值
dict["没见过的 key"] = 值 能凭空造出词条,靠的不是 [] 本身,而是 Insert 的返回值。[] 同时要知道两件事:key 以前在不在,对应的结点在哪。只返回 bool 的话,[] 拿到结果还得再 Find 一次,白多走一趟 O(logN)。
    V& operator[](const K& key)
    {
        pair<iterator, bool> ret = insert(pair<const K, V>(key, V()));
        return ret.first->second;
    }
key 不存在就插一个值初始化的 V 再返回引用,存在就直接拿到旧结点的引用。于是同一个 [] 具备插入、查找、修改三种语义:dict["left"] = "左边" 是插入加赋值,dict["left"] = "左边、剩余" 是纯修改,dict["string"]; 这种看起来只读的写法也会真的插一条空 value 进去。
这里还有一次容易被忽略的转换:外部传进来的是 pair<const K, V>,构造时 key、value 各拷一次。标准库因此另外提供了收 value_type 的重载,让调用方自己决定在哪一步转换;教学版图省事,把这次拷贝留在函数里。
V() 要求 V 能默认构造。自定义类型不写默认构造函数时,[] 直接编译失败;只读的接口标准库提供的是 at(),找不到抛 std::out_of_range,也不会往表里插东西。标准库也没有给 map 提供 const 版的 operator[]:一个只读接口却可能修改容器,语义上说不通。
组装成 mymap 与 myset
set 只有一层转发:插入收 K,查出 Iterator,内部树实例化成 RBTree<K, const K, SetKeyOfT>。
namespace bit
{
template<class K>
class set
{
    struct SetKeyOfT
    {
        const K& operator()(const K& key) const
        {
            return key;
        }
    };

public:
    typedef typename RBTree<K, const K, SetKeyOfT>::Iterator iterator;
    typedef typename RBTree<K, const K, SetKeyOfT>::ConstIterator const_iterator;

    iterator begin() { return _t.Begin(); }
    iterator end() { return _t.End(); }
    const_iterator begin() const { return _t.Begin(); }
    const_iterator end() const { return _t.End(); }

    pair<iterator, bool> insert(const K& key) { return _t.Insert(key); }
    iterator find(const K& key) { return _t.Find(key); }

private:
    RBTree<K, const K, SetKeyOfT> _t;
};
}
map 多一个 operator[],insert 收的是整个键值对。insert 的形参写成 const pair<const K, V>&,dict.insert({"sort", "排序"}) 的花括号会直接构造一个临时 pair 绑定到 const 引用,不用显式写 make_pair 或 pair<std::string, std::string>("sort", "排序")。
namespace bit
{
template<class K, class V>
class map
{
    struct MapKeyOfT
    {
        const K& operator()(const pair<const K, V>& kv) const
        {
            return kv.first;
        }
    };

public:
    typedef typename RBTree<K, pair<const K, V>, MapKeyOfT>::Iterator iterator;
    typedef typename RBTree<K, pair<const K, V>, MapKeyOfT>::ConstIterator const_iterator;

    iterator begin() { return _t.Begin(); }
    iterator end() { return _t.End(); }
    const_iterator begin() const { return _t.Begin(); }
    const_iterator end() const { return _t.End(); }

    pair<iterator, bool> insert(const pair<const K, V>& kv)
    {
        return _t.Insert(kv);
    }

    iterator find(const K& key) { return _t.Find(key); }

    V& operator[](const K& key)
    {
        pair<iterator, bool> ret = insert(pair<const K, V>(key, V()));
        return ret.first->second;
    }

private:
    RBTree<K, pair<const K, V>, MapKeyOfT> _t;
};
}
两棵树都持有裸指针,析构函数会 delete 每个结点,所以拷贝必须管住。默认生成的拷贝构造和赋值是浅拷贝,两棵树指向同一批结点,析构时二次释放。上面 RBTree 里用 = delete 关掉了拷贝;要支持拷贝就得自己实现深拷贝:先序复制结点,递归接上左右和父指针,销毁则后序释放。三件套写全之后,树才能安全地按值传递或返回。课件给的类里只写了析构,没写拷贝控制,直接使用会踩到这个问题。
跑一遍:
void Print(const bit::set<int>& s)
{
    bit::set<int>::const_iterator it = s.end();
    while (it != s.begin())
    {
        --it;
        std::cout << *it << ' ';
    }
    std::cout << '\n';
}

int main()
{
    bit::set<int> s;
    int a[] = {4, 2, 6, 1, 3, 5, 15, 7, 16, 14};
    for (int e : a)
    {
        s.insert(e);
    }
    for (auto e : s)
    {
        std::cout << e << ' ';
    }
    std::cout << '\n';        // 1 2 3 4 5 6 7 14 15 16
    Print(s);                 // 16 15 14 7 6 5 4 3 2 1

    bit::map<std::string, std::string> dict;
    dict.insert({"sort", "排序"});
    dict.insert({"left", "左边"});
    dict["insert"] = "插入";
    dict["string"];           // 插入 {"string", ""}

    for (const auto& e : dict)
    {
        std::cout << e.first << ':' << e.second << '\n';
    }
    return 0;
}
Print 从 end() 开始往回走,正好检验 -- 的实现;输出方向与 begin 相反,说明 -- 和 ++ 用的不是同一个分支,--end() 里那句从根往右走到底也确实生效了。dict["string"]; 一行同时检验 [] 的插入语义和空串的默认构造。到这里,set 和 map 不再是两个容器,而是同一棵树的两件外套:T 决定结点存什么,KeyOfT 决定从里面抠哪个字段,const 的位置决定谁能改,Insert 的返回值决定上层能不能实现 []。
还没有评论 — 第一条由你来留。