第一周的十八道题可以按“模型”分成八堆:数位模拟、哈希、栈、窗口与最近位置、堆与配额、线性 DP、网格搜索、高精度。每堆的代码都不长,真正决定能否通过的是三样东西——题面给的值域、循环的退出条件、状态变量在多次调用之间是否干净。
把这一周的题目先列清楚:
| 题目 | 模型 | 时间复杂度 |
|---|---|---|
| 数字统计 | 逐位取模 | O((r−l+1) log r) |
| 两个数组的交集 | 布尔哈希 | O(n+m) |
| 点击消除 | 栈 | O(n) |
| 牛牛的快递 | 分支 + 上取整 | O(1) |
| 最小花费爬楼梯 | 线性 DP | O(n) |
| 数组中两个字符串的最小距离 | 记录最近下标 | O(n·L) |
| 简写单词 | 分词读入 | O(总字符数) |
| dd 爱框框 | 同向双指针 | O(n) |
| 除 2! | 大根堆贪心 | O(n log n) |
| Fibonacci 数列 | 递推 + 夹逼 | O(log n) |
| 单词搜索 | 网格 DFS | O(mn·4^L) |
| 杨辉三角 | 二维递推 | O(n²) |
| 游游的 you | 公式 | O(1)/询问 |
| 腐烂的苹果 | 多源 BFS | O(mn) |
| 孩子们的游戏 | 约瑟夫递推 | O(n) |
| 大数加法 | 竖式模拟 | O(n) |
| 链表相加(二) | 链表逆序 + 竖式 | O(n) |
| 大数乘法 | 不进位相乘再进位 | O(mn) |
数位、取整与读词:三道模拟题的三个动作
数字统计。区间 [l, r] 内每个数都要数一遍数字 2 的个数。单个数的处理是固定动作:i % 10 取末位,i /= 10 去掉末位,循环到 0 为止。0 本身不需要处理,因为区间从 1 开始。
#include <iostream>
using namespace std;

int main()
{
    int l, r;
    cin >> l >> r;
    int cnt = 0;
    for (int i = l; i <= r; i++)
    {
        int t = i;
        while (t)
        {
            if (t % 10 == 2) cnt++;
            t /= 10;
        }
    }
    cout << cnt << endl;
    return 0;
}
常见错误是把 i 直接拿去取模,内层循环结束后外层 i 已经变成 0,for 的自增把它推成 1,区间只跑了一遍。另一个错误是用 while (t) 之外还判断了 t == 0,把 0 当成含 2 的数。复制一份 t 是这类题的标准动作。
牛牛的快递。首重 1 公斤 20 元,超过 1 公斤的部分每公斤加 1 元,不足 1 公斤按 1 公斤算;加急再加 5 元。重量用 double 读,费用只有两种形态:
#include <iostream>
#include <cmath>
using namespace std;

int main()
{
    double w;
    char urgent;
    cin >> w >> urgent;
    int fee = 20;
    if (w > 1) fee += (int)ceil(w - 1);
    if (urgent == 'y') fee += 5;
    cout << fee << endl;
    return 0;
}
ceil 返回 double,赋给 int 会截断,但 ceil 的结果本身就是整数值的浮点数,截断无损;写成 fee += ceil(w - 1) 也能通过,只是隐式转换更隐蔽。边界是 w 恰好等于 1:必须走 w <= 1 那一支,不能无条件 ceil(w - 1),否则 ceil(0) 为 0 看起来也没事,但 w = 1.0001 会多收 1 元,这正好是“不足 1 公斤按 1 公斤”的语义。
简写单词。输入是一行用空格分隔的单词,要求输出每个单词首字母的大写形式,单词数不定。读入方式决定这题是否 0 分:getline 只能拿到一整行,还得自己切分;cin >> s 会自动跳过空白,while (cin >> s) 一直读到 EOF。
#include <iostream>
#include <string>
using namespace std;

int main()
{
    string s;
    while (cin >> s)
    {
        char c = s[0];
        if (c >= 'a' && c <= 'z') c = c - 'a' + 'A';
        cout << c;
    }
    cout << endl;
    return 0;
}
c - 32 也能得到大写,但 32 是 ASCII 的硬编码差值;写 'a' - 'A' 或 c - 'a' + 'A',读的人不用背表。题面只保证小写字母,判断区间仍然要写,否则输入里出现大写时会把它减成别的字符。
一次扫描:哈希去重与栈消除
两个数组的交集。把一个数组的值标成“出现过”,再扫另一个数组,遇到标记就收进答案并把标记熄灭。熄灭这一步是去重的全部:同一个值第二次遇到时 hash[x] 已经是 false,不会重复加入。
#include <vector>
using namespace std;

class Solution
{
public:
    vector<int> intersection(vector<int>& nums1, vector<int>& nums2)
    {
        bool hash[1010] = {false};
        for (int x : nums1) hash[x] = true;

        vector<int> ret;
        for (int x : nums2)
        {
            if (hash[x])
            {
                ret.push_back(x);
                hash[x] = false;
            }
        }
        return ret;
    }
};
课件把 hash 写成类的成员变量,函数里没有清空。评测机如果只调用一次,结果正确;如果在同一个 Solution 对象上连续调用两次,第二次读到的就是上一轮留下的 true,答案会凭空多出几个元素。把数组放进函数体,每次调用都重新初始化,这个隐患直接消失。值域超过 1009 时,定长数组会越界写,换成 unordered_set<int> 或 unordered_map。
点击消除。规则是相邻且相同才能消,消完露出的新相邻还能继续消。反复扫描“找到一对就删、删完从头再来”在 abbc 上正确,但字符串长度上限是 300000,最坏要重扫 O(n) 次,总量到 10^11 次比较。
栈的写法把“已处理前缀的最简形态”维护住:
#include <iostream>
#include <string>
using namespace std;

int main()
{
    string s;
    cin >> s;
    string st;
    st.reserve(s.size());
    for (char ch : s)
    {
        if (!st.empty() && st.back() == ch) st.pop_back();
        else st.push_back(ch);
    }
    cout << (st.empty() ? "0" : st) << endl;
    return 0;
}
扫描到第 i 个字符时,栈里是前 i 个字符消完后的结果。新字符若与栈顶相同,这两个字符在原文里必然相邻,可以立即消掉;消掉后露出的新栈顶继续参与下一轮,正好对应题面“消完再消”。若不同,它和更早的字符中间隔着栈顶,这一轮轮不到它,只能入栈。std::string 的 back、pop_back、push_back 就够当栈用,不需要额外的 stack<char>。
边界是消空:题面要求输出字符 0,不是空行。st.empty() 的判断比 st.size() == 0 更直接。
最近一次出现的位置
数组中两个字符串的最小距离。要的是两个指定字符串在序列中相距最近的下标差。不需要对每一对出现位置做比较,只维护两个“最近一次出现”的下标:
#include <iostream>
#include <string>
#include <climits>
#include <algorithm>
using namespace std;

int main()
{
    int n;
    string s1, s2, s;
    cin >> n >> s1 >> s2;

    int p1 = -1, p2 = -1;
    int ans = INT_MAX;
    for (int i = 0; i < n; i++)
    {
        cin >> s;
        if (s == s1)
        {
            if (p2 != -1) ans = min(ans, i - p2);
            p1 = i;
        }
        else if (s == s2)
        {
            if (p1 != -1) ans = min(ans, i - p1);
            p2 = i;
        }
    }
    cout << (ans == INT_MAX ? -1 : ans) << endl;
    return 0;
}
正确性来自一个单调性:当前元素若是 s1,能和它配对的最优 s2 一定是它左边最近的那个 s2,更远的只会让差更大。两边都按这个规则更新,所有候选对都被覆盖,且每个下标只被更新一次。
else if 隐含了 s1 与 s2 不同这个前提。题面通常如此;如果两者相同,第二个分支永远不会执行,p2 一直是 -1,答案会错。真遇到这种情况,应先判断“同一个串”再单独处理连续两次出现。
Java 版课件用 readLine() 逐个读取字符串,这要求每个字符串独占一行。C++ 的 cin >> s 按空白切分,输入把所有字符串挤在一行也能读对。同一份算法,两种读入方式对格式的容忍度完全不同,换语言时要重新核对输入格式。
窗口、堆与配额
dd 爱框框。在长度 1e7 的数组里找一段和至少为 x 的最短区间,长度相同取左端点更小的。元素都是正数,所以“右端扩张、左端收缩”的窗口是单调的。
#include <iostream>
using namespace std;

const int N = 10000010;
int a[N];

int main()
{
    int n, x;
    cin >> n >> x;
    for (int i = 1; i <= n; i++) cin >> a[i];

    int left = 1, right = 1, sum = 0;
    int bestL = -1, bestR = -1, bestLen = n + 1;

    while (right <= n)
    {
        sum += a[right];
        while (sum >= x)
        {
            if (right - left + 1 < bestLen)
            {
                bestLen = right - left + 1;
                bestL = left;
                bestR = right;
            }
            sum -= a[left++];
        }
        right++;
    }
    cout << bestL << " " << bestR << endl;
    return 0;
}
三个细节:
- 数组按 1 下标读入,
left和right也必须从 1 开始。课件 C++ 版写成left = right = 0,于是a[0]这个恒为 0 的空位被当成真实元素,窗口会多出一个长度为“真实长度 + 1”的伪区间。它竞争不过收缩一步后的真区间,最终答案不变,但同一份课件的 Java 版写的是left = right = 1,两个版本对不上。 - 更新答案用严格小于,长度相等时不覆盖,天然满足“取左端点更小”。
- 只收缩到
sum < x就停,不能写成if。一次右移可能让窗口超出很多,必须连续弹出左端。
a 是 1e7 个 int,静态数组占 40 MB 左右。若内存限制更紧,可以边读边处理:窗口只会向左弹出,把当前窗口内的值放在一个队列里即可,峰值内存是窗口长度。
除 2!。每次操作选一个偶数减半,最多 k 次,问总和最小。每次的收益正好是“这个数的一半”,所以每步选当前最大的偶数,收益最大;操作之间互不影响,局部最优就是全局最优。
#include <iostream>
#include <queue>
using namespace std;

int main()
{
    long long n, k;
    cin >> n >> k;

    priority_queue<long long> heap;
    long long sum = 0, x;
    while (n--)
    {
        cin >> x;
        sum += x;
        if (x % 2 == 0) heap.push(x);
    }

    while (!heap.empty() && k > 0)
    {
        k--;
        long long t = heap.top();
        heap.pop();
        sum -= t / 2;
        t /= 2;
        if (t % 2 == 0) heap.push(t);
    }
    cout << sum << endl;
    return 0;
}
数据范围是 n ≤ 1e5、a_i ≤ 1e9,总和最大 1e14,sum 必须是 long long。k 能到 1e9,不能写 for (i = 0; i < k; i++) 真跑十亿次;但每个数最多减半三十来次,堆里的元素一旦变成奇数就永久退出,循环次数被“偶数个数 × 位宽”卡住,实际是 O(n log A) 次弹出。
Java 版用 PriorityQueue<Integer>((a, b) -> b - a) 做降序。这个比较器在本数据范围内不会溢出,但它是“返回负值表示 a 排在 b 前面”的约定,值域一变大(比如到 2^31 附近)减法就会溢出成错误的符号,稳妥写法是 Integer.compare(b, a)。另外 Java 的 int 装得下 1e9,但 sum 仍然要用 long。
游游的 you。有 a 个 y、b 个 o、c 个 u,拼出 you 得 2 分,拼出相邻的 oo 得 1 分,求最大得分。两个模式共享字母 o,但 you 每次用掉 3 个字母拿 2 分,oo 用 2 个 o 拿 1 分;而且 y、u 不参与 oo,优先拼 you 不会更差。
#include <iostream>
#include <algorithm>
using namespace std;

int main()
{
    int q;
    cin >> q;
    while (q--)
    {
        long long a, b, c;
        cin >> a >> b >> c;
        long long x = min(a, min(b, c));
        cout << 2 * x + max(b - x - 1, 0LL) << endl;
    }
    return 0;
}
拼完 x 个 you 后,剩下的 o 有 b - x 个。把它们排成连续的一段,长度为 L 的串里有 L−1 对相邻 o,所以得分是 max(b - x - 1, 0)。样例 1 5 2 就是这个算式:2 + (5−1−1) = 5。
为什么不继续把 y、u 插进 o 串里多造几对?插进去只会切断相邻关系,不会增加 oo 的个数;而 you 已经按“每个 o 收益 2 分”优先用掉了。这个贪心可以用交换论证:若某个 o 被用在 oo 里而存在一个未使用的 you 组合,把这个 o 换去拼 you,得分至少不变。
线性 DP:初值、状态与输出
最小花费爬楼梯。走到第 i 级的最小花费,只可能从 i−1 或 i−2 上来;从哪一级上来,就付哪一级的代价。
#include <iostream>
#include <algorithm>
using namespace std;

const int N = 100010;
int cost[N], dp[N];

int main()
{
    int n;
    cin >> n;
    for (int i = 0; i < n; i++) cin >> cost[i];

    for (int i = 2; i <= n; i++)
        dp[i] = min(dp[i - 1] + cost[i - 1], dp[i - 2] + cost[i - 2]);

    cout << dp[n] << endl;
    return 0;
}
dp[0] 和 dp[1] 都是 0,因为可以从地面直接站到第 0 级或第 1 级,不付钱。dp[i] 表示“站在第 i 级”的花费,而 cost[n] 不存在,所以答案是 dp[n](站在楼梯顶),正好对应“越过第 n−1 级”的语义。把状态写成“跨过第 i 级”会多一层偏移,容易差一。
Fibonacci 数列。给 n,找离它最近的斐波那契数,输出距离。递推向前跑,直到 c >= n,此时 b < n <= c(n 本身是斐波那契数时 c == n)。
#include <iostream>
#include <algorithm>
using namespace std;

int main()
{
    int n;
    cin >> n;
    int a = 0, b = 1, c = 1;
    while (c < n)
    {
        a = b;
        b = c;
        c = a + b;
    }
    cout << min(c - n, n - b) << endl;
    return 0;
}
n = 1 时不进循环,b 和 c 都是 1,输出 0,正确。n 如果是 0,c - n = 1、n - b = -1,会输出 -1;题面保证正整数,所以这个分支不出现,但把 n 的类型和题面范围对一下是必要的。c 在 n ≤ 1e9 时最大到 1.13e9,仍在 int 内。
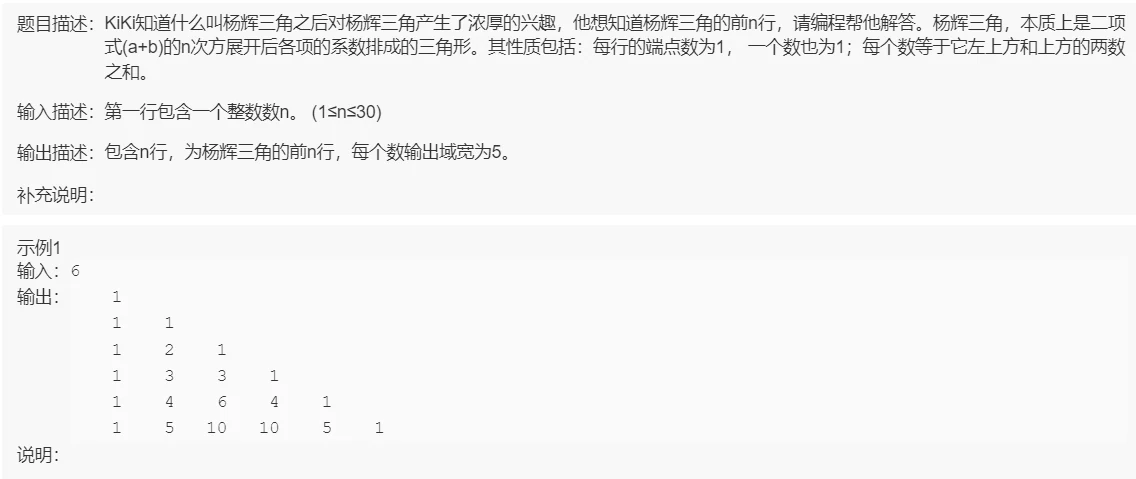
杨辉三角。第 i 行第 j 个数等于上一行同列与左上角之和,边界用全局零初始化处理。
#include <iostream>
#include <cstdio>
using namespace std;

int dp[31][31];

int main()
{
    int n;
    cin >> n;
    dp[1][1] = 1;
    for (int i = 2; i <= n; i++)
        for (int j = 1; j <= i; j++)
            dp[i][j] = dp[i - 1][j] + dp[i - 1][j - 1];

    for (int i = 1; i <= n; i++)
    {
        for (int j = 1; j <= i; j++) printf("%5d", dp[i][j]);
        printf("\n");
    }
    return 0;
}
dp[i-1][i] 不存在,但它是 0,所以右端点的 1 自动成立;dp[i-1][0] 同理。n ≤ 30,C(30,15) = 155117520,int 装得下。输出要求每个数占 5 列、右对齐,%5d 就是题面要的格式。
网格上的搜索
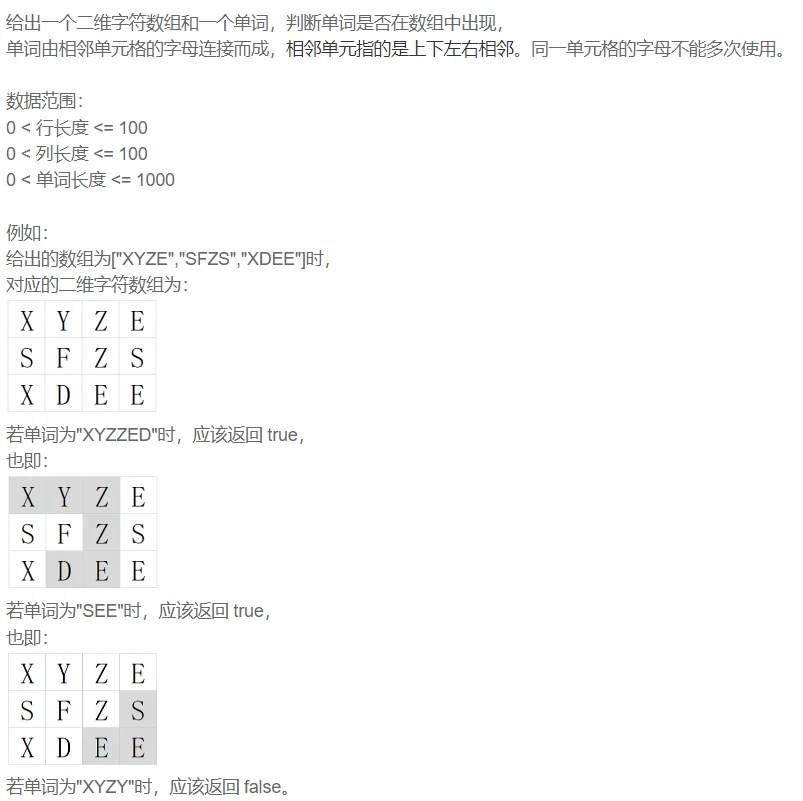
单词搜索。从每个与首字母相同的格子出发做 DFS,四个方向、不能重复走同一格。
#include <vector>
#include <string>
#include <cstring>
using namespace std;

class Solution
{
    int m, n;
    int dx[4] = {0, 0, 1, -1};
    int dy[4] = {1, -1, 0, 0};
    bool vis[101][101];

    bool dfs(vector<string>& board, int i, int j, const string& word, int pos)
    {
        if (pos == (int)word.size() - 1) return true;

        vis[i][j] = true;
        for (int k = 0; k < 4; k++)
        {
            int x = i + dx[k], y = j + dy[k];
            if (x >= 0 && x < m && y >= 0 && y < n && !vis[x][y] &&
                board[x][y] == word[pos + 1])
            {
                if (dfs(board, x, y, word, pos + 1))
                {
                    vis[i][j] = false;
                    return true;
                }
            }
        }
        vis[i][j] = false;
        return false;
    }

public:
    bool exist(vector<string>& board, string word)
    {
        m = board.size();
        n = board[0].size();
        memset(vis, 0, sizeof vis);

        for (int i = 0; i < m; i++)
            for (int j = 0; j < n; j++)
                if (board[i][j] == word[0] && dfs(board, i, j, word, 0))
                    return true;
        return false;
    }
};
两个课件里存在的隐患:
vis如果是成员变量,找到答案的那条return true会把当前层的vis[i][j] = false跳过,栈上所有层的标记都留成true。评测机在同一个Solution对象上第二次调用exist时,上一轮的标记还在,没走过的格子被当成走过。入口memset是最便宜的补法;把vis做成vector<vector<bool>>的局部变量也能解决。pos == word.size() - 1里size()返回无符号类型,空串时size() - 1会回绕成极大值,pos被提升成无符号后条件不成立,下一句word[pos + 1]越界。写成(int)word.size() - 1并把空串单独返回false,这个坑就不存在。
复杂度是最坏 O(mn·4^L),L 是单词长度;vis 让每条路径不重复走格,实际搜索量远小于上界。
腐烂的苹果。每分钟,所有腐烂苹果同时把上下左右的新鲜苹果变烂,问多少分钟全烂,烂不完输出 -1。多源 BFS:初始队列装所有烂苹果,按层推进。
#include <vector>
#include <queue>
using namespace std;

class Solution
{
    int dx[4] = {0, 0, 1, -1};
    int dy[4] = {1, -1, 0, 0};

public:
    int rotApple(vector<vector<int>>& grid)
    {
        int m = grid.size(), n = grid[0].size();
        queue<pair<int, int>> q;
        int fresh = 0;

        for (int i = 0; i < m; i++)
            for (int j = 0; j < n; j++)
            {
                if (grid[i][j] == 2) q.push({i, j});
                else if (grid[i][j] == 1) fresh++;
            }

        if (fresh == 0) return 0;

        int minutes = 0;
        while (!q.empty())
        {
            int sz = q.size();
            bool spread = false;
            while (sz--)
            {
                auto [a, b] = q.front();
                q.pop();
                for (int k = 0; k < 4; k++)
                {
                    int x = a + dx[k], y = b + dy[k];
                    if (x >= 0 && x < m && y >= 0 && y < n && grid[x][y] == 1)
                    {
                        grid[x][y] = 2;
                        q.push({x, y});
                        fresh--;
                        spread = true;
                    }
                }
            }
            if (spread) minutes++;
        }
        return fresh == 0 ? minutes : -1;
    }
};
课件版本在 BFS 结束后扫一遍网格统计剩余的 1,再统一 return ret - 1。ret 统计的是“层数”,源头那一层不花时间,所以减 1 在“至少有一个烂苹果”时是对的。但如果整张表里一个烂苹果都没有、同时也没有新鲜苹果(全是空格),队列一次都不进,ret 停在 0,返回值就是 -1;而题面问的是“还要几分钟全烂”,本来就没有好苹果,答案应该是 0。加一个 fresh == 0 的提前返回,这个用例就正确了。用 fresh 计数还省掉了 BFS 后的整表扫描。
grid[x][y] = 2 直接把访问标记和腐烂状态合并,不需要额外的 vis;前提是允许修改入参。Java 版用 vis 保留了 grid,两者都对,但副作用不同。
约瑟夫环的一行递推
孩子们的游戏。n 个人围成一圈,从 0 开始报数,报到 m - 1 的人出列,剩下的人继续,问最后留下谁。模拟用数组或链表都能做,但每次删除都要移动或遍历,n 大时会超时。
设 f(i) 为 i 个人时幸存者的编号。i 个人删掉一个人后,剩下 i−1 个人重新从 0 编号,新旧编号的对应关系是 old = (new + m) % i。于是
int LastRemaining_Solution(int n, int m)
{
    int f = 0;
    for (int i = 2; i <= n; i++) f = (f + m) % i;
    return f;
}
f(1) = 0 是唯一的初值;每一步只做一次加法和一次取模,时间 O(n)、空间 O(1)。m 不需要先对 i 取模,(f + m) % i 会处理;m 很大时 f + m 可能超过 int,把参数类型换成 long long 更稳。
高精度:竖式、链表与不进位乘法
大数加法。两个十进制字符串相加,从低位往高位走,写本位、留进位。
#include <string>
#include <algorithm>
using namespace std;

string add(string s, string t)
{
    string ret;
    int carry = 0;
    int i = (int)s.size() - 1, j = (int)t.size() - 1;

    while (i >= 0 || j >= 0 || carry)
    {
        if (i >= 0) carry += s[i--] - '0';
        if (j >= 0) carry += t[j--] - '0';
        ret.push_back(char('0' + carry % 10));
        carry /= 10;
    }
    reverse(ret.begin(), ret.end());
    return ret;
}
carry 同时装“上一位的进位”和“这一位的和”,最大 19,int 足够。循环条件里的 || carry 是 999 + 1 这类用例的命门:两个指针都走完时,进位还可能剩一个 1,少写这一项就会得到 000。
int i = (int)s.size() - 1 先转成有符号再减,空串时得到 -1;写成 int i = s.size() - 1 会让无符号的 0 减 1 回绕,再转成 int 是实现定义的行为。
链表相加(二)。链表头是最高位,竖式加法要从低位开始,所以先逆序,再加,最后再逆序回来。
struct ListNode
{
    int val;
    ListNode* next;
    ListNode(int x) : val(x), next(nullptr) {}
};

ListNode* reverse(ListNode* head)
{
    ListNode* newHead = new ListNode(0);
    ListNode* cur = head;
    while (cur)
    {
        ListNode* nxt = cur->next;
        cur->next = newHead->next;
        newHead->next = cur;
        cur = nxt;
    }
    ListNode* ret = newHead->next;
    delete newHead;
    return ret;
}

ListNode* addInList(ListNode* head1, ListNode* head2)
{
    head1 = reverse(head1);
    head2 = reverse(head2);

    ListNode dummy(0);
    ListNode* prev = &dummy;
    int t = 0;
    ListNode* c1 = head1;
    ListNode* c2 = head2;

    while (c1 || c2 || t)
    {
        if (c1) { t += c1->val; c1 = c1->next; }
        if (c2) { t += c2->val; c2 = c2->next; }
        prev = prev->next = new ListNode(t % 10);
        t /= 10;
    }
    return reverse(dummy.next);
}
课件用 new ListNode(0) 做哨兵并在最后 delete。用栈上对象做哨兵更省事,函数返回前它不会析构链表节点。while (c1 || c2 || t) 同样处理了最高位剩下的进位,例如 99 + 1。
大数乘法。直接套竖式,每一层乘法都拖着进位,写起来容易乱。把两件事拆开:先把所有 s[i] * t[j] 无进位地累加到 tmp[i + j],再统一处理进位。
#include <string>
#include <vector>
#include <algorithm>
using namespace std;

string multiply(string s, string t)
{
    reverse(s.begin(), s.end());
    reverse(t.begin(), t.end());
    int m = s.size(), n = t.size();

    vector<int> tmp(m + n, 0);
    for (int i = 0; i < m; i++)
        for (int j = 0; j < n; j++)
            tmp[i + j] += (s[i] - '0') * (t[j] - '0');

    string ret;
    int carry = 0;
    for (int x : tmp)
    {
        carry += x;
        ret.push_back(char('0' + carry % 10));
        carry /= 10;
    }
    while (carry)
    {
        ret.push_back(char('0' + carry % 10));
        carry /= 10;
    }

    while (ret.size() > 1 && ret.back() == '0') ret.pop_back();
    reverse(ret.begin(), ret.end());
    return ret;
}
反转之后第 i 位的权重是 10^i,第 j 位是 10^j,乘积落在 10^(i+j),所以下标是 i + j。每个格子的累加上限是 min(m, n) * 81,常见位数下 int 足够;位数到十万级时 81 * 1e5 = 8.1e6 仍然安全。最后必须处理前导零:结果是 0 时 ret 会被填成一串 0,while (ret.size() > 1 && ret.back() == '0') 里的 size() > 1 保证至少留下一个 0。
复杂度 O(mn),空间 O(m+n)。Java 版用 StringBuffer 或 StringBuilder 存低位,最后 reverse(),逻辑一致。
还没有评论 — 第一条由你来留。