用文件存一张学生表,程序里要自己补四件事:多个进程同时改同一行时谁赢、按条件查一万行怎么不扫全表、谁能读谁能写、断电后写了一半的文件怎么恢复。数据库把这四件事收进了一个长期运行的服务进程,SQL 只是它对外的一层接口。
课件把文件的短板列成四条:安全性没有保障、不利于查询和管理、不利于存海量数据、在程序里控制不方便。再加一句存储介质,磁盘和内存都算。这四条正好对应数据库补上的四块能力:权限体系、索引与查询语言、分页与批量 I/O、事务与崩溃恢复。
主流 DBMS 各自守着哪块地
| 产品 | 常见场景 | 特点 |
|---|---|---|
| SQL Server | .NET 项目、中大型企业系统 | 与 Windows、AD 集成紧,T-SQL 方言 |
| Oracle | 金融、电信的核心系统 | 复杂业务与大并发,授权费用高 |
| MySQL | Web、电商、论坛、SaaS | 部署轻,简单查询快,生态广 |
| PostgreSQL | 复杂类型、强一致、地理数据 | 标准 SQL 支持好,扩展机制强,免费 |
| SQLite | 手机、桌面、嵌入式 | 一个 C 库加一个文件,没有独立服务进程 |
| H2 | Java 单元测试、嵌入式应用 | 纯 Java,类库形态,可跑内存模式 |
课件把 MySQL 概括成“并发性好,不适合做复杂的业务”,前半句要限定条件:并发能力取决于存储引擎、隔离级别和索引设计,一张没索引的大表放在哪个库上都会排队。后半句在今天已经偏旧,MySQL 8.0 有 CTE、窗口函数、JSON 和直方图统计,复杂查询的表达能力比 5.7 强出一截。它的主战场仍然是读多写多、业务相对直接的 Web 场景,但这不等于写不了复杂 SQL。另外课件的产品名把 SQL Server 拼成了 SQL Sever。
装的是 DBMS,连的是一个进程
中文里“数据库”三个字覆盖了两个对象:数据库(database)是存表的容器,数据库管理系统(DBMS)是管这个容器的软件。装 MySQL 装的是 DBMS,create database helloworld 建的才是数据库。这个区分在排错时很省事:连不上是管家没起来,表找不到是容器选错了,数据不对才轮到内容本身。
MySQL 是客户端—服务器结构,服务端是 mysqld 进程。在 Windows 上它注册成系统服务,services.msc 里能看到状态和启动类型:
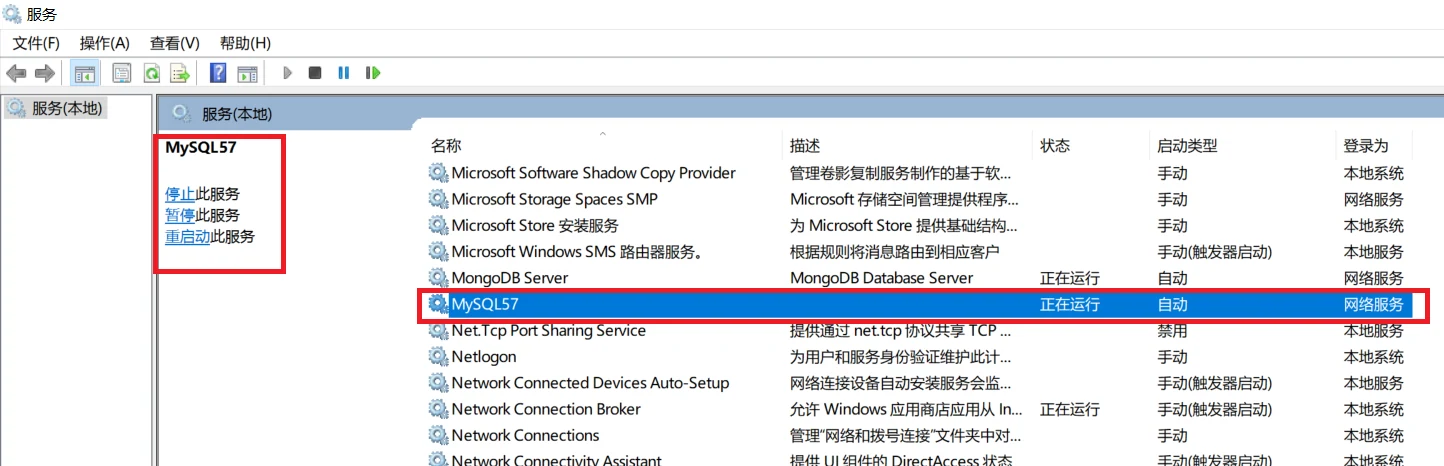
Linux 上用 systemctl status mysqld 看同一件事。客户端则是你敲命令的 mysql 程序。
连接命令的每个参数都有默认值:
mysql -h 127.0.0.1 -P 3306 -u root -p-h 不写默认连本机;-P 不写默认 3306,注意是大写 P,小写 -p 表示提示输入密码,后面不能跟空格;-u 不写默认用当前系统用户名。登录后那行 Commands end with ; or \g. 说明分号或 \g 才算一条语句结束。忘了分号按回车,提示符会变成 ->,它在等你把话说完;输错了想放弃,敲 \c 清空当前输入。
Linux 上写 localhost 通常走 Unix socket,写 127.0.0.1 才走 TCP。所以改过 bind-address 之后,本机照样连得上,远程依旧连不上,报 Can't connect to local MySQL server through socket(2002)或者 Can't connect to MySQL server(2003)。这两条错误的排查方向完全不同。
服务器、库、表是三层容器
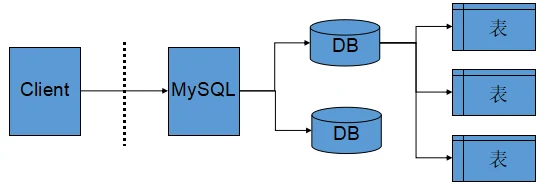
一台服务器可以管多个库,一个库里放多张表,表里才是行和列。开发时的约定是“一个应用一个库”:备份、迁移、授权、删库都按应用边界走,比把所有表堆在一个库里清楚。
最小闭环五步:
CREATE DATABASE helloworld;
USE helloworld;

CREATE TABLE student (
    id     int,
    name   varchar(32),
    gender varchar(2)
);

INSERT INTO student (id, name, gender) VALUES (1, '张三', '男');
INSERT INTO student (id, name, gender) VALUES (2, '李四', '女');
INSERT INTO student (id, name, gender) VALUES (3, '王五', '男');

SELECT * FROM student;
create database 建容器,use 决定后续语句落在哪个容器里,create table 定列,insert 填行,select 读回来。
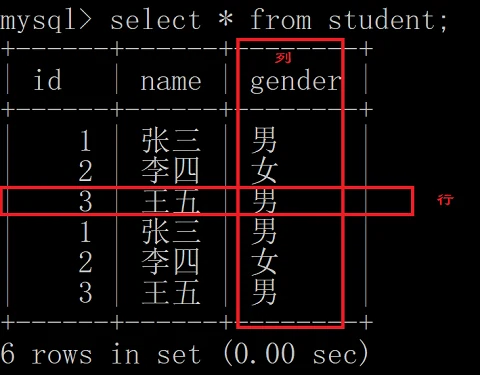
截图里的重复行暴露了一个建表细节:student 没有主键,insert 跑两遍不会被拦,重复记录照单全收。给 id 加 primary key,第二次插入同样的 id 就会报 1062。另外 varchar(32) 的 32 是字符数,不是字节数,能放 32 个汉字,实际占多少字节由字符集决定。
一条 SQL 进服务器,要过三层
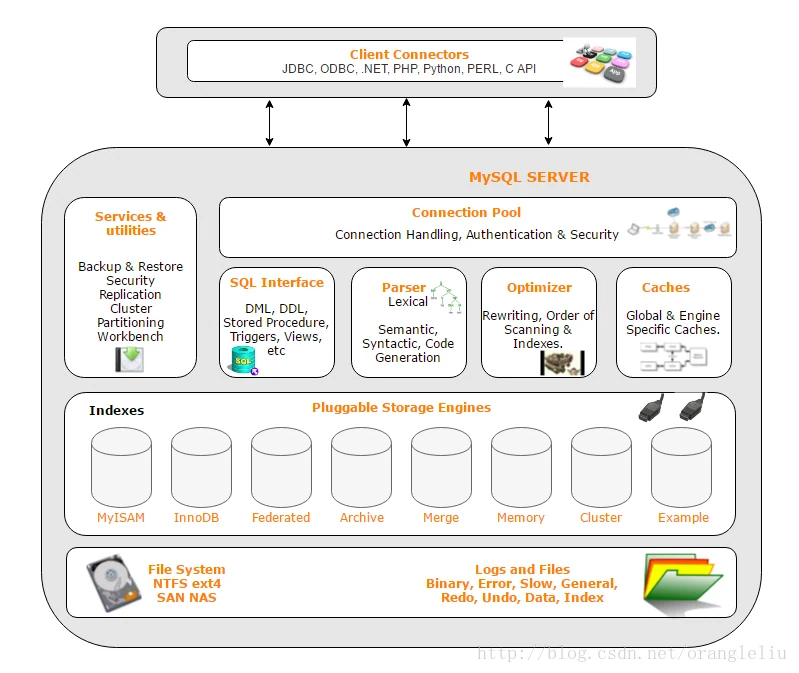
MySQL 能在 Unix/Linux、Windows、macOS、Solaris 上跑,平台差异主要压在文件系统那一层,上面这套逻辑结构保持一致,所以同一套库表设计能跨平台迁移。这张图适合拿来定位错误,而不是背层次。
连接层的主体是 Connection Pool,负责握手、认证、分配线程,密码错了在这一层就拒,报 1045;连接数打满也在这里拒,报 Too many connections。左侧竖着的 Services & utilities 不属于连接流程,它列的是备份恢复、复制、集群、分区和 Workbench 这类工具入口,同样挂在服务器进程上。
SQL 层由四个组件串起来。SQL Interface 把 DML、DDL、存储过程、视图、触发器分发给后面;Parser 做词法和语法分析,少括号、写错关键字报 1064,它只说明语法不通,不会告诉你表不存在;Optimizer 决定用哪个索引、先连哪张表、条件下不下推,EXPLAIN 看到的就是它的结论;Caches 在 5.7 里包含查询缓存,但默认关闭,8.0 直接把它删了,剩下的主要是引擎自己的缓冲池。
存储引擎层是可插拔的。引擎负责数据怎么落盘、索引怎么组织、锁怎么加。再往下的 File System 与 Logs and Files 出问题,表现就是磁盘满、权限错、文件损坏,这时再怎么改 SQL 也没用。
SQL 按“动了什么”分四类
- DDL(Data Definition Language):维护结构,
create、drop、alter。 - DML(Data Manipulation Language):操作数据,
insert、delete、update。 - DQL(Data Query Language):查询,
select,从 DML 里单独拎出来的一类。 - DCL(Data Control Language):权限,
grant、revoke。
课件把 commit 也划进 DCL,写成“权限管理和事务”,这个归类不准确。GRANT、REVOKE 在账号管理那一组,COMMIT、ROLLBACK、SAVEPOINT 属于事务控制,通常单独叫 TCL(Transaction Control Language)。术语之争不影响敲 SQL,但影响对行为的判断:MySQL 里大多数 DDL 会隐式提交当前事务,你在事务中间执行 alter table,前面没提交的 DML 会跟着落盘。
默认引擎看 Support 列,不看名字
SHOW ENGINES;输出里 Support 列写着 DEFAULT 的那个就是当前默认引擎。MySQL 8.0 手册写明 InnoDB 是默认存储引擎;5.5 之前默认是 MyISAM,之后一直默认 InnoDB,除非配置里改过 default-storage-engine。
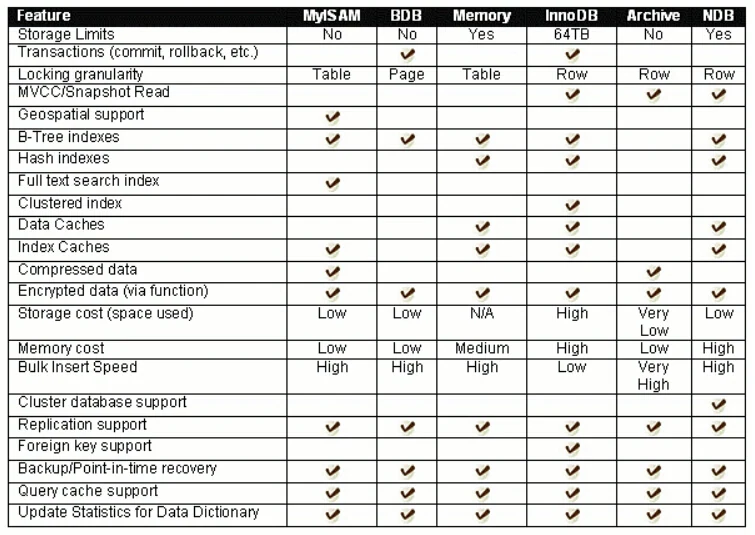
这张表覆盖的引擎比今天的范围大。BDB 在 MySQL 5.1 就从发行版里去掉了,NDB 属于单独的 MySQL Cluster 产品,普通社区版 SHOW ENGINES 里看不到它们,这两行可以跳过。真正要记住的对比是下面这几项:
| 对比项 | InnoDB | MyISAM |
|---|---|---|
| 事务 | 支持 ACID | 不支持 |
| 锁粒度 | 行级 | 表级 |
| 外键 | 支持 | 不支持 |
| 索引组织 | 聚簇索引,叶子放整行 | 非聚簇,叶子放行号 |
| 崩溃恢复 | redo/undo,可恢复 | 无日志,可能丢数据 |
| 典型文件 | .ibd(8.0 结构进数据字典) | .MYD、.MYI,5.7 另有 .frm,8.0 换成 .sdi |
聚簇索引值得单独说一句:InnoDB 的表本身就是一棵按主键组织的 B+ 树,叶子节点存整行数据,按主键查是一次树查找;二级索引的叶子存主键值,查完还要回表一次。MyISAM 的索引和数据是两套文件,索引叶子里存行号,查完按行号去 .MYD 里取。
选引擎的结论不复杂:默认用 InnoDB,除非非常确定为什么要换。MyISAM 不支持事务、只有表锁、崩溃后可能丢数据,它的优势只在只读归档这类场景。Memory 引擎适合临时表,重启即失,而且不支持 BLOB、TEXT。同一句 select 落在不同引擎上,隔离级别和锁的行为都不一样,这一点在写 SQL 时就该有意识。
还没有评论 — 第一条由你来留。