一次按主键查一行,和一次没有索引的全表扫描,差别不在 CPU 算得快不快,而在要读多少个 16KB 的页。索引(index)是额外维护的一份有序结构,把“在整张表里找满足条件的行”改成“在一个有序结构里定位到少量行”。它不改变磁盘的机械速度,改变的是访问路径的长度。
代价写在另一面:每个索引都占空间,插一行、删一行、改一行,聚簇索引和每个二级索引都要维护,写操作因此多出若干次 IO。索引适合读多写少、数据量大、条件集中的查询。
| 类型 | 关键字 | 约束 |
|---|---|---|
| 主键索引 | primary key | 唯一且非空,一张表最多一个 |
| 唯一索引 | unique | 值唯一,可以有多行 NULL |
| 普通索引 | index | 不约束值,只加速查找 |
| 全文索引 | fulltext | 按词检索大段文本,不做等值或范围比较 |
先确认被查的列真的没有索引
课件造了一张 800 万行的 EMP,用 select * from EMP where empno = 998877 量到 4.93 秒,再执行 alter table EMP add index(empno)。课件没有贴 EMP 的建表语句;如果这张表沿用了 scott 示例库的结构,empno 就是主键,查询走的是聚簇索引,4.93 秒和“没有索引”对不上,后面那条 add index(empno) 也只会多维护一棵指向同一行的二级索引。复现之前先确认 empno 上确实没有索引;下面用一张不建主键的表。
create table if not exists emp_big (
    empno    int not null,
    ename    varchar(20) not null,
    job      varchar(10) not null,
    mgr      int,
    hiredate date,
    sal      decimal(7,2),
    comm     decimal(7,2),
    deptno   int
) engine=InnoDB;

drop procedure if exists fill_emp;

delimiter $$
create procedure fill_emp(in total int)
begin
    declare i int default 0;
    set autocommit = 0;
    while i < total do
        insert into emp_big values (
            100001 + i,
            concat(char(97 + floor(rand() * 26)),
                   char(97 + floor(rand() * 26)),
                   char(97 + floor(rand() * 26))),
            'SALESMAN', 1, curdate(), 2000, 400,
            10 + floor(rand() * 490));
        set i = i + 1;
    end while;
    commit;
end $$
delimiter ;

call fill_emp(200000);
set autocommit = 1;
课件灌的是 800 万行,把参数改大即可,耗时会长很多。先看没有索引的计划:
explain select * from emp_big where empno = 150000;
-- type: ALL, possible_keys: NULL, key: NULL, rows: 约 20 万
type 是 ALL、key 是 NULL,意思是优化器准备从头扫到尾。加索引后再看:
alter table emp_big add index idx_empno(empno);

explain select * from emp_big where empno = 150000;
-- type: ref, key: idx_empno, rows: 个位数
rows 是优化器估算的“需要检查多少行”,不是最终返回的行数;filtered 才是估算经过 where 过滤后剩下的比例。全表扫描时它接近表的总行数,走索引后它接近命中的行数。看数量级。
磁盘按扇区寻址,操作系统读块,InnoDB 读页
数据最终落在盘片上。一个盘片有正反两面,每面一个磁头;盘面划成同心圆的磁道,磁道再切成扇区,同半径的磁道叠起来叫柱面。传统定位给柱面号、磁头号、扇区号,也就是 CHS;系统软件更常用把所有扇区线性编号的 LBA,由磁盘控制器翻译回 CHS。扇区长期是 512 字节,较新的盘用 4096 字节。
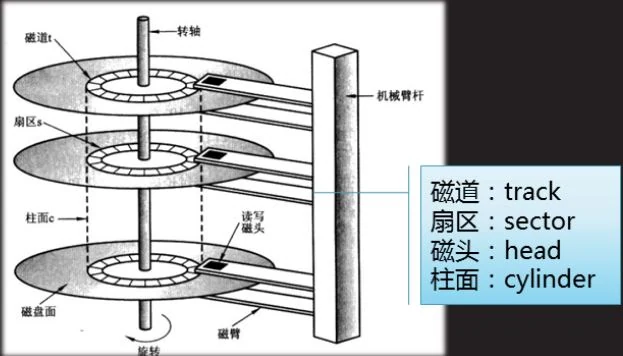
操作系统不直接按扇区做 IO。扇区太小,读同样一段数据要发很多次请求,而且 IO 代码会和具体硬件绑死。文件系统按块读写,常见块大小是 4KB;块是操作系统这一层的单位,扇区是磁盘这一层的单位。
课件在这里有一句话写反了:“磁盘是通过机械运动进行寻址的,随机访问不需要过多的定位,故效率比较高”。随机访问恰恰需要定位:磁头要移到目标磁道,这一步叫寻道;盘片要转到目标扇区,这一步叫旋转延迟;两者都是毫秒级的机械动作。连续访问时磁头几乎不动,顺着读下去,开销小得多。数据库里把随机 IO 改成顺序 IO 的设计——redo log 顺序追加、B+ 树把同一范围的行放进相邻叶子页——都是在省这两步。
InnoDB 又把单位放大了一次:
show global status like 'innodb_page_size';
-- Innodb_page_size | 16384
16384 字节,也就是 16KB。InnoDB 和磁盘交互的基本单位是 page,这个 page 和操作系统的 page 不是同一个概念。页大小在初始化实例时确定,常见取值有 4KB、8KB、16KB、32KB、64KB,默认 16KB,建库之后不能单独改某张表。
为什么不用多少加载多少?5 条记录如果各占一页,查第 5 条要 5 次 IO;5 条都在一页里,只需 1 次,剩下四次都在内存里完成。这个赌注靠局部性原理成立:读到一行,附近的行大概率很快也会被读。InnoDB 在内存里开了一块 Buffer Pool 缓存这些页,热数据的根页、中间页常年驻留,真正读盘的往往只剩目标叶子页。IO 的主要成本是次数,不是单次搬了多少字节。
主键让数据有序,页目录让有序变得可查
create table user (
    id   int primary key,
    age  int not null,
    name varchar(16) not null
);

insert into user values
    (3, 18, '杨过'), (4, 16, '小龙女'), (2, 26, '黄蓉'),
    (5, 36, '郭靖'), (1, 56, '欧阳锋');

select * from user;
-- 1 欧阳锋, 2 黄蓉, 3 杨过, 4 小龙女, 5 郭靖
插入顺序是乱的,查出来却按 id 递增。排序发生在插入时,由聚簇索引维护,不是 select 时临时排的。排序的目的只有一个:让页内和页间都能建目录。
页内的记录是一条单向链表,从头走到尾是线性查找。于是在页尾维护一组槽(slot),每若干条记录一个槽,槽里存组内一条记录的偏移。查找时先在槽上二分,定位到某一组,再在组内走几步。
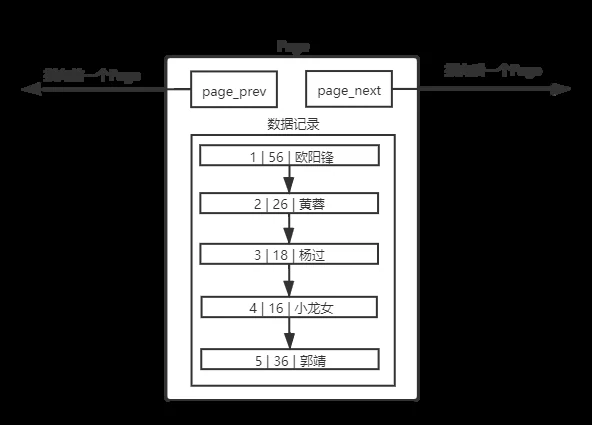
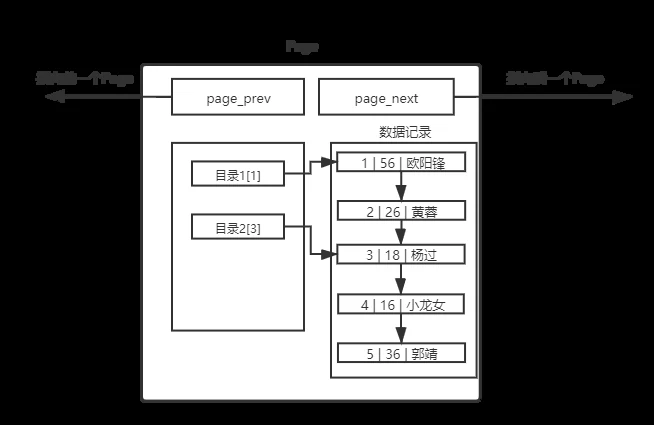
一页 16KB 装不下时,InnoDB 开新页,页与页用 page_prev、page_next 连成双向链表,页内有序,页间也有序。找一行得先确定它在哪一页;沿链表一页页找,又退化成线性扫描,而且每跳一页可能是一次磁盘 IO。解法还是加目录:目录页里每一项是“下级页的最小键值 + 页号”,按最小键有序,比较一次就能排除整页。
目录页也是页,只是存的是页号而不是用户记录。目录页多了再加一层,最终根页在上、叶子页在下,内部页只存键和指针,叶子页存行并且首尾相连,这就是 B+ 树。
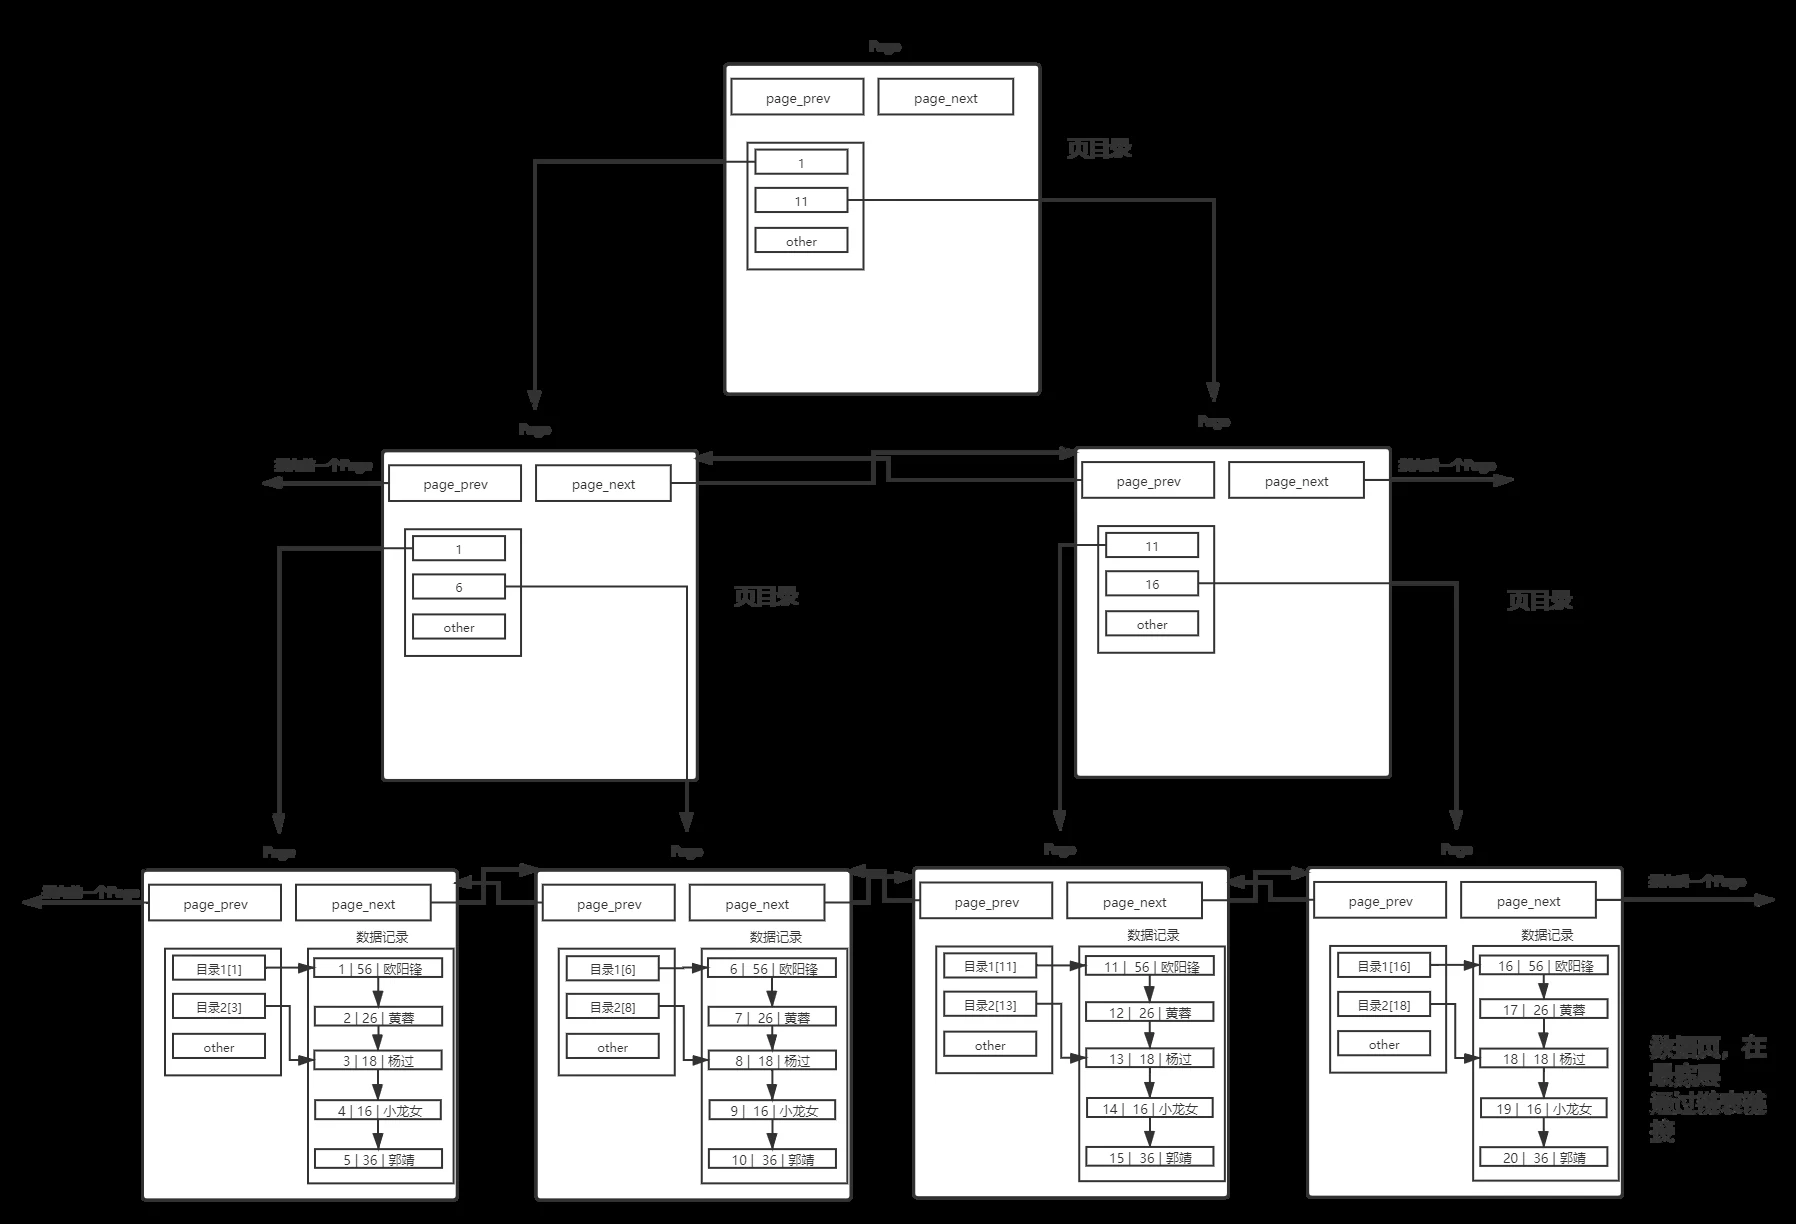
树高决定 IO 次数。根页和中间页通常常驻 Buffer Pool:命中缓存时,一次点查真正读盘的只有目标叶子页;缓存全冷时,三层各读一次。范围查询先定位到第一个叶子页,再沿 page_next 顺序读,不必每行都回到根页。
粗算一下层数:一页扣掉页头和页尾约 15KB,内部页每个目录项是键加 4 字节页号,十几字节以内,一页能放上千项;叶子页按一行 100 字节算,能放一百多行。两层是十几万到几十万行,三层到上亿行。
不用链表、二叉搜索树和哈希的原因
链表只能线性遍历,目录再快也救不了页间扫描。二叉搜索树在有序插入时退化成链表,随机插入也可能长歪。AVL 树和红黑树虽然平衡,但每个节点只有两个叉,同样数据量下树高是 B+ 树的好几倍;每下一层就多一次 IO,平衡换来的比较次数优势抵不过磁盘开销。
哈希查单个键是 O(1),但它没有顺序:范围查询、排序、前缀匹配都用不上。InnoDB 不能建用户可见的 HASH 索引,内部有自适应哈希索引,那是另一套机制;MEMORY 和 NDB 引擎才允许显式 HASH 索引。
B 树和 B+ 树的差别,对索引来说就两条:
- B 树的节点既存键也存数据,扇出小,同样数据量下树更高;B+ 树的内部页只存键和页号,数据全在叶子页,扇出大,树更矮。
- B+ 树的叶子页首尾相连,范围查询定位一次就能顺着扫;B 树的叶子不连,范围查询要反复回到上层。
这也是插入代价的来源:往装满的页里插新记录,InnoDB 会把一部分记录挪到新页,再在父页里加目录项,这叫页分裂。用 UUID 这类随机值做主键,插入点散落在树中间,页分裂频繁,顺序写变成随机写;自增整数的新键总在右边,页分裂少得多。
聚簇索引、二级索引和回表
建两张结构相同的表,只换引擎,去数据目录看一眼:
create database myisam_test;
use myisam_test;
create table mtest (
    id   int primary key,
    name varchar(11) not null
) engine=MyISAM;

create database innodb_test;
use innodb_test;
create table itest (
    id   int primary key,
    name varchar(11) not null
) engine=InnoDB;
MyISAM 的表目录里会出现 mtest.frm、mtest.MYD、mtest.MYI:.frm 是表结构,.MYD 是行数据,.MYI 是索引。InnoDB 的 itest.ibd 把索引和行数据放在同一个表空间里。前者叫非聚簇索引,后者叫聚簇索引。课件用的是 5.7,目录里还有 .frm;8.0 把表结构收进数据字典,.frm 不再出现。
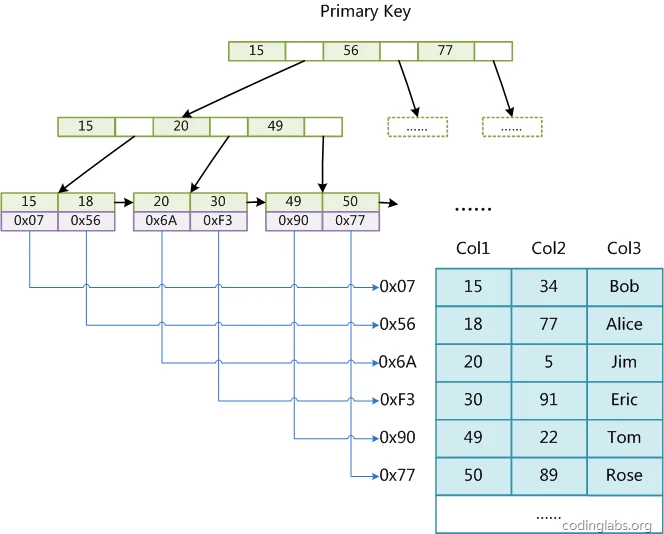
差别在二级索引上才真正显出来。MyISAM 的普通索引和主键索引结构一样,叶子还是行地址,只是键换成了索引列的值。InnoDB 的二级索引叶子存的是索引列加主键值,不存整行。查到主键值之后,还要拿它去聚簇索引再查一次,这一步叫回表。
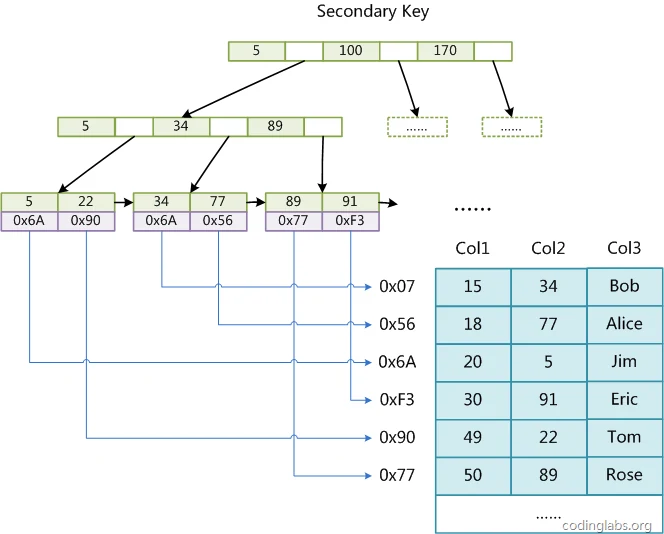
课件说 InnoDB 不给二级索引叶子附上整行,原因是“太浪费空间”。还有一个原因是行地址会变:页分裂会把记录搬到新页,更新变长也可能换位置。主键值不会因为搬家而变,二级索引只要存主键就能一直有效,代价就是多一次回表。
想省掉回表,让查询要的列全落在索引里:
create index idx_name_age on user(name, age);

select name, age from user where name = '黄蓉';   -- Extra: Using index
select * from user where name = '黄蓉';           -- 要整行,仍要回表
Using index 是覆盖索引生效的标志。InnoDB 的二级索引天然带主键,所以 select id, name from user where name = '黄蓉' 也能被 idx_name_age 覆盖。Using index condition 是索引条件下推:过滤在索引层做了一部分,但查询还要的列不在索引里,该回的表还是要回。
主键长度会连坐所有二级索引。主键从 4 字节的 int 换成 36 字符的 UUID,每个二级索引的每一行都要多存几十字节,几个索引、几千万行,多出来的空间是成倍的。主键短,是整张表所有索引都受益的事。
长列建完整索引太占地方,可以用前缀索引:
alter table user8 add index idx_email(email(10));前缀索引只索引前 10 个字符,省空间,但不能用于覆盖索引,也不能保证前缀之外的排序。长度上限按字节算:DYNAMIC 或 COMPRESSED 行格式是 3072 字节,COMPACT 或 REDUNDANT 是 767 字节;utf8mb4 一个字符最多 4 字节,email(800) 会直接建不出来。取多长不该拍脑袋,先用 count(distinct left(email, n)) / count(*) 看区分度,接近 1 就够用。
四类索引的建法
主键索引有三种写法:
create table user1 (id int primary key, name varchar(30));
create table user2 (id int, name varchar(30), primary key(id));
create table user3 (id int, name varchar(30));
alter table user3 add primary key(id);
一个表最多一个主键,主键列不能为 NULL、不能重复,多用 int。主键可以是复合的,primary key(a, b) 把两列一起作为聚簇索引的键。
唯一索引同样有三种写法:
create table user4 (id int primary key, name varchar(30) unique);
create table user5 (id int primary key, name varchar(30), unique(name));
create table user6 (id int primary key, name varchar(30));
alter table user6 add unique(name);
一张表可以有多个唯一索引,索引列的值不能重复。唯一索引加上 not null,在约束上接近主键;如果表没有显式主键,InnoDB 会选第一个所有列都 not null 的唯一索引做聚簇索引,但一张表仍然可以有多个唯一索引。
普通索引:
create table user8 (
    id int primary key,
    name varchar(20),
    email varchar(30),
    index(name)
);
create table user9 (id int primary key, name varchar(20), email varchar(30));
alter table user9 add index(name);
create table user10 (id int primary key, name varchar(20), email varchar(30));
create index idx_name on user10(name);普通索引可以有多个,开发里用得最多;列里有重复值就该用它。alter table user9 add index(name) 不写索引名时,MySQL 用列名 name 作为索引名,create index idx_name on user10(name) 才能显式起名。
全文索引:
create table articles (
    id int unsigned auto_increment primary key,
    title varchar(200),
    body text,
    fulltext (title, body) with parser ngram
) engine=InnoDB;

insert into articles (title, body) values
    ('MySQL Tutorial', 'DBMS stands for DataBase Management System'),
    ('How To Use MySQL Well', 'After you read this guide you can write better SQL'),
    ('Optimizing MySQL', 'In this tutorial we show how to read an execution plan'),
    ('MySQL Security', 'When configured properly MySQL limits what each account can do'),
    ('MySQL 索引', '数据库通过 B+ 树把查找定位到少量页');

select * from articles where body like '%database%';
select * from articles where match(title, body) against ('database');
select * from articles where match(title, body) against ('数据库');
like '%database%' 会返回包含这个子串的行,但前置通配符让索引失效,explain 里 type 是 ALL、key 是 NULL。match(title, body) against ('database') 才走全文索引,type 变成 fulltext,key 指向全文索引。
课件写“全文索引要求存储引擎必须是 MyISAM,默认只支持英文,不支持中文”。这条在 5.6 之后已经过期:InnoDB 从 5.6 起支持 FULLTEXT;5.7.6 引入 ngram 分词器,中文可以加 with parser ngram 建索引。上面这张表就是 InnoDB 加 ngram 的写法。
查看和删除:
show keys from user10;
show index from user10;
desc user10;

alter table user3 drop primary key;
alter table user6 drop index name;
drop index idx_name on user10;
show keys 的输出里,Non_unique 为 0 表示唯一索引,Key_name 是索引名,Seq_in_index 是列在复合索引里的位置,Column_name 是索引列。Index_type 显示 BTREE,表示索引使用 B-tree 访问方法,InnoDB 实际实现的是 B+ 树;课件把它注释成“以二叉树形式的索引”,二叉树和 B+ 树不是一回事。
建索引的原则,课件给了四条,和上面的结构能对上:
- 频繁作为查询条件的字段建索引。
- 唯一性太差的字段不适合单独建,比如性别只有两个值,走索引后还要回表大半张表。
- 更新非常频繁的字段不适合建,每次更新都要维护这棵树。
- 不出现在 where 子句里的字段不建。
复合索引、最左前缀和 explain
联合索引 (a, b, c) 的键是把三列拼起来排序的:先比 a,a 相同再比 b,再比 c。所以它能被“从最左边开始的一段连续前缀”用上:
create table t (
    a int,
    b int,
    c int,
    name varchar(20),
    code varchar(20),
    create_time datetime
);

create index idx_abc on t(a, b, c);
create index idx_name on t(name);
create index idx_code on t(code);
create index idx_time on t(create_time);
create index idx_a on t(a);
a = 1 用到 a
a = 1 and b = 2 用到 a、b
a = 1 and b = 2 and c = 3 用到 a、b、c
b = 2 用不上,跳过了最左列
a = 1 and b > 2 and c = 3 a、b 能定位,c 只能在 b 的范围里过滤a = 1 and b > 2 and c = 3 这一行最容易误判:范围条件会截断后面的列,c 在索引里虽然有序,但只在“每个 b 值内部”有序,没法整体二分。设计复合索引时,等值条件放前面,范围条件放后面,需要排序的列放在等值条件之后;同时存在 (a) 和 (a, b) 时,前者是后者的冗余前缀,可以删掉。
explain 的输出按列读:
| 列 | 含义 |
|---|---|
id | 查询块编号,通常编号越大越先执行 |
select_type | SIMPLE、PRIMARY、SUBQUERY、DERIVED、UNION |
table | 这一步访问的表 |
type | 访问方式,从好到差:system、const、eq_ref、ref、range、index、ALL |
possible_keys | 理论上可用的索引 |
key | 实际选中的索引,NULL 表示没走索引 |
key_len | 用到的索引字节数,复合索引可据此判断用了几列 |
ref | 与索引列比较的对象:常量、列或函数结果 |
rows | 估算需要检查的行数,不是返回行数 |
filtered | 估算经过 where 后剩余行的百分比 |
Extra | Using index、Using where、Using index condition、Using temporary、Using filesort 等 |
key 是 NULL 而 possible_keys 有值,通常是优化器算过代价后主动放弃索引;type 是 ALL 是全表扫描;type 是 index 是扫整棵索引,比 ALL 好一点,但仍然是全量扫描。rows 很大不一定是坏事,要结合 filtered 和实际返回行数看。
几种常见的索引白建现场:
select * from t where name like '%黄%';        -- 前置通配符破坏有序性
select * from t where year(create_time) = 2025; -- 在索引列上做函数
select * from t where code = 123;               -- code 是 varchar,列被转成数字
select * from t where a = 1 or b = 2;           -- b 没有索引
or 不是必然失效:两边都有索引时,优化器可能用 index merge 合并两个结果;只有一边有索引,另一边只能全表扫,整体就退化成全表扫。范围大到几乎覆盖整张表时,走索引要回表几百万次,不如顺着全表扫,possible_keys 有值而 key 为 NULL 多半是这种情况。
索引也不是越多越好。每个二级索引都是一棵独立的 B+ 树,插入一行,聚簇索引写一次,每个二级索引各写一次,还要记 undo 和 redo。空间、写入和优化器的选择成本都在涨。单表控制在几个真正被查询用到的索引,长期零命中的索引用慢查询日志或 performance_schema 确认后删掉。
还没有评论 — 第一条由你来留。