#include <stdio.h>

int main(void)
{
    int n = 9;
    float *pFloat = (float *)&n;

    printf("n 的值:%d\n", n);              /* 9 */
    printf("*pFloat 的值:%f\n", *pFloat);  /* 0.000000 */

    *pFloat = 9.0;
    printf("n 的值:%d\n", n);              /* 1091567616 */
    printf("*pFloat 的值:%f\n", *pFloat);  /* 9.000000 */

    return 0;
}
变量 n 的地址和那四个字节的位置一直没变,四行输出却差得离谱。变的只是谁在读、按哪套规则读:按 int 的补码规则,还是按 float 的 IEEE 754 规则。这段代码用 float * 指向 int 对象再解引用,严格按标准属于类型别名规则的边角,主流编译器通常照做。
补码:让加法器兼做减法
有符号整数有三种二进制写法,最高位是符号位,0 表示正,1 表示负。
- 原码:符号位加上绝对值的二进制。
- 反码:符号位不变,其余位按位取反。
- 补码:反码加一。
正数的三种写法完全相同,负数才不同:
| 值(8 位) | 原码 | 反码 | 补码 |
|---|---|---|---|
| 5 | 0000 0101 | 0000 0101 | 0000 0101 |
| -5 | 1000 0101 | 1111 1010 | 1111 1011 |
| -1 | 1000 0001 | 1111 1110 | 1111 1111 |
计算机里存的是补码。理由在加法器上:CPU 只有加法器,没有减法器。算 5 - 5,在补码下就是 5 + (-5):
  0000 0101     5
+ 1111 1011     -5 的补码
------------
1 0000 0000     最高位进位丢掉
  0000 0000     0
减法被消掉了。符号位和数值位一起参与运算,不用单独判断正负;对负数来说,补码转原码和原码转补码都是“取反加一”,硬件不用为两个方向各做一套电路。
补码还让 0 只有一种写法。原码里 +0 是 0000 0000,-0 是 1000 0000,判等要特殊处理;补码把 1000 0000 让给了 -128,8 位有符号数的范围变成 -128 到 127,比原码和反码多出一个数。代价是 -128 没有对应的原码。
顺带分清两种溢出。无符号数的溢出是定义明确的,按 2 的位宽次方取模回绕;有符号数溢出是未定义行为,编译器可以假设它不发生,并据此删掉后面的分支。INT_MIN 取负就落在这个坑里:想要 +2147483648,而它不在 int 的表示范围内。
0x11223344 在小端机器上是 44 33 22 11
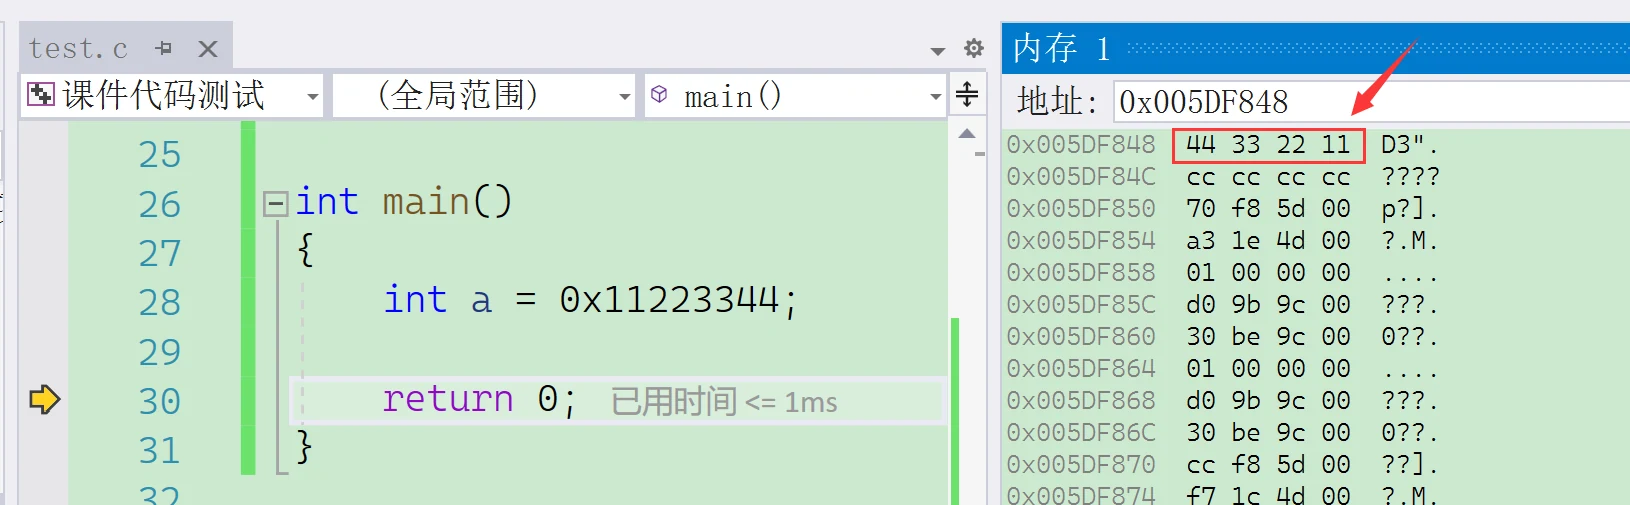
一个超过一字节的数据写进内存,就要决定多字节的先后顺序:
| 模式 | 低地址 | 高地址 |
|---|---|---|
| 大端 | 高位字节 | 低位字节 |
| 小端 | 低位字节 | 高位字节 |
上面的窗口是典型的小端:0x11223344 的最低字节 0x44 落在最低地址。用一个 16 位的 short 看得更清楚:值 0x1122 放在地址 0x0010,大端把高字节 0x11 放 0x0010、低字节 0x22 放 0x0011,小端相反。
为什么会有两种?内存按字节编址,一个地址一个字节,而寄存器比一个字节宽。数据从寄存器写出去时,必须先写某一头再写另一头,早期厂商各选各的,后来固化成平台约定。x86 是小端,KEIL C51 是大端,很多 ARM、DSP 是小端,部分 ARM 还能由硬件选择。
判断本机字节序,最直接的办法是写一个多字节整数,再按单字节读第一个字节:
#include <stddef.h>
#include <stdio.h>

int check_sys(void)
{
    unsigned int i = 1;

    return *(unsigned char *)&i;   /* 小端读到 1,大端读到 0 */
}

int main(void)
{
    int a = 0x11223344;

    printf("%s\n", check_sys() ? "小端" : "大端");
    for (size_t i = 0; i < sizeof(a); i++)
        printf("%02X ", (unsigned)((unsigned char *)&a)[i]);
    printf("\n");
    return 0;
}
用 unsigned char * 访问任意对象的字节表示,标准明确允许,也不受有符号 char 的干扰。
联合体也能做同一件事,写法更短:
int check_sys_union(void)
{
    union
    {
        unsigned int i;
        unsigned char c;
    } un;

    un.i = 1;
    return un.c;   /* 1 小端,0 大端 */
}
严格按标准,读一个与最后写入成员不同的联合体成员,结果由实现定义;主流编译器都支持这种读法,但它不属于标准保证的语义。
字节序真正咬人的地方是跨机器交换数据。网络协议统一用大端,主机上的小端数据发出去前要 htonl、htons,收回来再 ntohl、ntohs。文件格式也一样,PNG、JPEG 的规范都写明多字节整数用大端,读文件不能直接把缓冲区当成结构体。
课件在这一节提到 long 是 32 位,并注明了“要看具体的编译器”。更准确的说法是:宽度由数据模型决定,Windows 用 LLP64,int 和 long 都是 32 位;64 位 Linux 和 macOS 用 LP64,long 是 64 位。跨平台时按标准保证的最小宽度记,不要按位数记。
同一个 1111 1111,char 有符号时是 -1
#include <stdio.h>

int main(void)
{
    char a = -1;
    signed char b = -1;
    unsigned char c = -1;

    printf("a=%d b=%d c=%d\n", a, b, c);   /* a=-1 b=-1 c=255 */
    return 0;
}
三个变量存的位一模一样,都是 1111 1111。差别在传进 printf 之前的整型提升:printf 是可变参数函数,char、short 先提升成 int。
| 声明 | 存储的字节 | 提升到 int 时补什么 | %d 打印 |
|---|---|---|---|
char a = -1(有符号 char) | FF | 补 1,得 FFFFFFFF | -1 |
signed char b = -1 | FF | 补 1,得 FFFFFFFF | -1 |
unsigned char c = -1 | FF | 补 0,得 000000FF | 255 |
char 到底按有符号还是无符号,标准没有规定,由实现选择。cppreference 的整数类型页面写得很清楚:char、signed char、unsigned char 是三个不同的类型,char 与后两者之一具有相同的表示。MSVC 和 x86 上的 GCC 默认有符号,不少 ARM 配置默认无符号。同一段代码在 PC 上打 -1,烧到板子上打 255,原因就在这里。
课件接着把 -128 和 128 分别赋给 char,再用 %u 打印。在主流实现上两者都得到 4294967168:-128 提升成 int 后是 0xFFFFFF80,按无符号读就是 4294967168;128 超出 char 的表示范围,转换结果由实现定义,按补码截断后同样是 -128。
#include <stdio.h>

int main(void)
{
    char a = -128;
    char b = 128;

    printf("%u %u\n", (unsigned)a, (unsigned)b);
    return 0;
}
课件原文写的是 printf("%u\n", a);。a 提升之后类型是 int,%u 要的是 unsigned int,转换说明和实参类型不匹配,标准归到未定义行为,只是主流编译器按位读。加一次显式转换,行为才落在标准之内。
截断与回绕:从 -1-i 到两个死循环
#include <stdio.h>
#include <string.h>

int main(void)
{
    char a[1000];

    for (int i = 0; i < 1000; i++)
        a[i] = (char)(-1 - i);

    printf("%zu\n", strlen(a));   /* 255 */
    return 0;
}
-1 - i 是 int 运算,赋给 char 时超出范围,主流实现按补码截断,只保留低 8 位。i = 0 写进 0xFF,i = 254 写进 0x01,i = 255 写进 0x00。strlen 数到第一个 0 字节停下,前面正好 255 个非零字节,答案是 255。把 char 换成 unsigned char,写进去的字节一样,结果还是 255,决定答案的是那个 0 字节。
课件这段代码有两处要补:用了 strlen 却没有包含 string.h,C99 起隐式声明被取消,会直接编不过或告警;printf("%d", strlen(a)) 的格式也不对,strlen 返回 size_t,该用 %zu。
两个死循环是另一类问题,条件在类型层面就不可能变假:
void loop_uc(void)
{
    unsigned char i;

    for (i = 0; i <= 255; i++)      /* 恒真:255 加 1 回绕成 0 */
    {
    }
}

void loop_ui(void)
{
    unsigned int i;

    for (i = 9; i >= 0; i--)        /* 恒真:无符号数没有负数 */
    {
    }
}
GCC 对第一种会给 -Wtype-limits:comparison is always true due to limited range of data type。第二种同理,0 减 1 回绕成 UINT_MAX。倒序遍历就用有符号的 int,或者把条件改成 i > 0 并在循环体里用 i - 1。
指针加 1 走多远:&a + 1 与 (int)a + 1
#include <stdio.h>

int main(void)
{
    int a[4] = {1, 2, 3, 4};
    int *ptr1 = (int *)(&a + 1);
    int *ptr2 = (int *)((char *)a + 1);

    printf("%x,%x\n", (unsigned)ptr1[-1], (unsigned)*ptr2);   /* 4,2000000 */
    return 0;
}
&a 的类型是“指向 4 个 int 的数组的指针”,&a + 1 一次跨过整个数组,得到的地址正好在 a[3] 后面,ptr1[-1] 就是 a[3],值是 4。
(char *)a + 1 只移动一个字节,从 a[0] 的第二个字节开始按 int 读。小端下 a[0] = 1 的四个字节是 01 00 00 00,从偏移 1 开始读到的是 00 00 00 02,也就是 0x02000000。换到大端,同样的代码读到 0x00000100。
课件写的是 (int *)((int)a + 1)。先把指针转成 int,在 64 位平台上会把高 32 位截掉,再转回指针就是一个非法地址。要按字节偏移必须先转 char *。改对之后还有一层:从偏移 1 处按 int 解引用,地址不满足 4 字节对齐,x86 允许但会慢,部分 ARM 会直接触发总线错误;符合标准的写法是用 memcpy 把那四个字节搬进一个 int 再打印。
IEEE 754:符号位、阶码、尾数各占几位
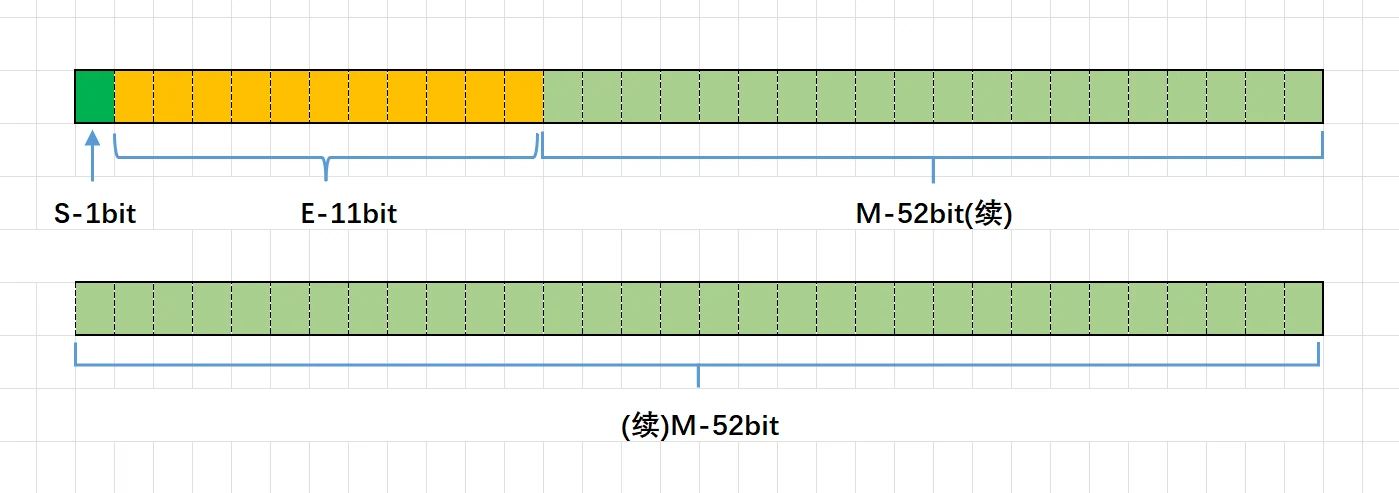
任意一个二进制浮点数写成一个统一的形式:
V = (-1)^S × M × 2^ES 是符号位,0 为正,1 为负;M 是有效数字,规格化后满足 1 <= M < 2;E 是真实指数。
| 类型 | 符号 S | 阶码 E | 尾数 M | 阶码偏移 |
|---|---|---|---|---|
float | 1 位 | 8 位 | 23 位 | 127 |
double | 1 位 | 11 位 | 52 位 | 1023 |
M 的整数部分永远是一个 1,所以存的时候把它省掉,只留小数点后的部分,读的时候再补回来。float 的 23 位尾数加上这个隐含的 1,相当于 24 位有效数字。
阶码字段本身是无符号的,但真实指数可以是负数。IEEE 754 规定存入时加上一个偏移:float 加 127,double 加 1023。比如 2^10 的真实指数是 10,存进 float 时字段里是 10 + 127 = 137,即 10001001。
5.0 的二进制是 101.0,规格化成 1.01 × 2^2,于是 S = 0、M = 1.01、E = 2。-5.0 只是 S 变成 1。
0.5 的二进制是 0.1,小数点右移一位得 1.0 × 2^-1,阶码字段是 -1 + 127 = 126,即 01111110,尾数去掉整数部分后全是 0:
0 01111110 00000000000000000000000取出来时按阶码字段分情况:
| 阶码 E | 尾数 M | 含义 |
|---|---|---|
| 不全为 0,也不全为 1 | 任意 | 规格化数:真实指数 = E - 127,M 前补 1 |
| 全 0 | 非 0 | 次正规数:指数按 1 - 127 算,M 前补 0 |
| 全 0 | 全 0 | ±0 |
| 全 1 | 全 0 | ±无穷 |
| 全 1 | 非 0 | NaN |
表里最后一行课件没有展开,但它是 IEEE 754 的一部分:0.0 / 0.0、sqrt(-1)、INF - INF 都产出 NaN。NaN 和任何值比较都不相等,包括它自己,所以判断要用 isnan(x) 或者利用 x != x,不要写 x == NAN。
9 和 9.0 的四条输出
9 按 int 存在内存里,32 位是:
0000 0000 0000 0000 0000 0000 0000 1001按 float 拆:S = 0,阶码字段 8 位全 0,尾数 00000000000000000001001。阶码全 0、尾数非 0,这是次正规数,真实指数按 1 - 127 = -126 算,尾数前补 0:
V = 0.00000000000000000001001 × 2^-126 = 1.001 × 2^-146这是个极接近 0 的正数,%f 默认只打印六位小数,于是显示 0.000000。不是读成了 0,是它小到打印不出来。
9.0 的二进制是 1001.0,规格化成 1.001 × 2^3。S = 0,阶码 3 + 127 = 130,即 10000010,尾数去掉整数部分后是 001 再补 20 个 0:
0 10000010 00100000000000000000000拼成十六进制是 0x41100000,按 int 读就是 1091567616。
课件最后一句写的是“这个 32 位的二进制数,被当做整数来解析的时候,就是整数在内存中的补码,原码正是 1091567616”。前半句说的是“按 int 解释这个位模式”,后半句给出的 1091567616 就是这个解释的结果;它是个正数,原码、反码、补码三者相同。一句话里先叫补码、再叫原码,把两种互斥的说法叠在了一起,读的时候容易误以为 1091567616 是补码的值、还要再转一次。
精度问题由同一套布局决定。0.1 的二进制是无限循环小数,float 只留 24 位有效位,存进去的已经是近似值,两个近似值相加误差继续累积,所以 0.1 + 0.2 不等于 0.3。C 标准保证 float 能表示至少 6 位十进制有效数字,double 至少 15 位,需要更多就得自己权衡。金额计算不用浮点直接累加,原因就在这里。
回到开头四行输出:9 按浮点读是次正规的极小值,打印成 0.000000;把 9.0 写进去,位模式换成 0x41100000,按整数读就是 1091567616。地址和字节的位置没变,变的只是解释它们的那套规则。
还没有评论 — 第一条由你来留。