struct S1 { char c1; int i; char c2; };
struct S2 { char c1; char c2; int i; };
struct S3 { double d; char c; int i; };
struct S4 { char c1; struct S3 s3; double d; };
在 x86-64 上,这四个结构体的大小是 12、8、16、32。S1 和 S2 的成员完全相同,只是换了顺序,差了 4 字节。多出来的部分不是数据,是编译器插进去的填充。
声明一个类型,和定义一个变量
结构体是一些值的集合,每个成员可以有不同的类型。
struct tag
{
    member-list;
} variable-list;
tag 是结构体标签,花括号里是成员列表,右花括号后面的分号不能丢。variable-list 可以省略,只声明类型;也可以顺手定义几个变量。
#include <stdio.h>

struct Stu
{
    char name[20];
    int age;
    char sex[5];
    char id[20];
};

int main(void)
{
    struct Stu s = {"张三", 20, "男", "20230818001"};
    struct Stu s2 = {.age = 18, .name = "lisi", .sex = "女", .id = "20230818002"};

    printf("%s %d %s %s\n", s.name, s.age, s.sex, s.id);
    printf("%s %d %s %s\n", s2.name, s2.age, s2.sex, s2.id);
    return 0;
}
第一种按成员顺序初始化,第二种用 C99 的指定初始化器,顺序随意。成员访问用 .;拿到指针就用 ->,p->age 等价于 (*p).age。
结构体可以不带标签,直接声明:
struct
{
    int a;
    char b;
    float c;
} x;

struct
{
    int a;
    char b;
    float c;
} a[20], *p;这两个声明长得一样,却是两个完全不同的类型。p = &x; 不合法,编译器不会因为成员列表相同就把它们当成同一个类型。匿名结构体没有标签可引用,除非用 typedef 起个名字,否则基本上只能用一次。
自引用只能存指针
结构体里放一个同类型的成员,是一种常见的错误写法:
struct Node
{
    int data;
    struct Node next;   /* 不允许 */
};如果允许,sizeof(struct Node) 就要满足“自身大小 = 自身大小 + 4”,没有解。编译器在定义成员时也算不出偏移量,所以这种写法直接报错。
正确写法是存指针:
struct Node
{
    int data;
    struct Node *next;
};
指针的大小和所指类型无关,结构体的大小立刻可以算出来。
配合 typedef 时还有个顺序问题:
typedef struct
{
    int data;
    Node *next;   /* Node 这个名字还没生效 */
} Node;
Node 是这条 typedef 声明结束后才引入的别名,匿名结构体内部提前用它定义成员,找不到这个名字。解决办法是给结构体一个标签,内部用 struct Node * 自引用:
typedef struct Node
{
    int data;
    struct Node *next;
} Node;
之后外面写 Node *,内部写 struct Node *,两边都成立。
对齐规则:每个成员放到自己的对齐数上
- 第一个成员放在结构体起始位置,偏移为 0。
- 后面的成员放在“自己的对齐数”的整数倍偏移上。对齐数取成员自身要求的对齐数与编译器默认对齐数的较小值。
- 结构体总大小补到所有成员对齐数中最大那个的整数倍。
- 嵌套结构体整体按它内部的最大对齐数对齐,总大小再取一次最大值。
默认对齐数依编译器而定:VS 是 8,GCC 由目标平台的 ABI 决定。
把四个结构体按规则摆一遍:
| 结构体 | 放置过程 | 大小 |
|---|---|---|
S1 | c1@0,空 1i@4c2@8,补到 12 | 12 |
S2 | c1@0,c2@1,空 2i@4 | 8 |
S3 | d@0c@8,空 9i@12~15 | 16 |
S4 | c1@0,空 1s3@8d@24~31 | 32 |
S1 的有效数据只有 6 字节,为了把 int 放到 4 的倍数上,中间空了 3 个字节,末尾又补了 3 个。S2 把两个 char 挤在一起,只浪费 2 个字节。
与其手算,不如让 offsetof 报数:
#include <stddef.h>
#include <stdio.h>

struct S1
{
    char c1;
    int i;
    char c2;
};

int main(void)
{
    printf("size=%zu c1=%zu i=%zu c2=%zu\n",
           sizeof(struct S1),
           offsetof(struct S1, c1),
           offsetof(struct S1, i),
           offsetof(struct S1, c2));
    return 0;
}
输出是 size=12 c1=0 i=4 c2=8。offsetof 展开成一个 size_t 类型的常量表达式,编译器在编译期就能算出来,不会真的访问对象;它包含中间的填充,所以 i 的偏移是 4 而不是 1。对位段成员用 offsetof 是未定义行为,位段没有字节地址。
课件把对齐数写成“默认对齐数与成员变量大小的较小值”。对普通标量成立,对数组和嵌套结构体不成立:int arr[3] 的大小是 12,对齐数却是 4;一个内部最大对齐为 4、总大小 12 的结构体,作为成员时对齐数也是 4,不是 min(8, 12) = 8。准确的说法是取成员自身要求的对齐数——数组取元素的对齐数,嵌套结构体取内部成员的最大对齐数——再与默认值取小。
课件还说“Linux 中 gcc 没有默认对齐数,对齐数就是成员自身的大小”。这句话在 32 位 x86 上就不对:i386 ABI 里 double 大小是 8,对齐却是 4。GCC 的对齐由目标 ABI 决定,“大小等于对齐”不是通则。拿不准就用 _Alignof 打印出来。
拿空间换时间:对齐为什么存在,怎么少浪费
两条理由。平台方面,不是所有硬件都能访问任意地址上的任意数据,某些平台在非对齐地址上取特定类型会抛异常。性能方面,处理器按字长成块读取内存,一个 double 如果压在两块之间,就要读两次再拼起来;对齐之后一次读完。
所以对齐是拿空间换时间。想让浪费少一点,把占用小的成员集中放:
struct Bad  { char a; int b; char c; int d; char e; };  /* 20 */
struct Good { int b; int d; char a; char c; char e; };  /* 12 */
成员一个没少,顺序变了,少了 8 个字节。前提是这个结构体的字节布局不参与任何外部约定。如果要按字节序列化、映射寄存器,或者打算用 memcmp 比较,顺序就是协议的一部分,不能为了省空间乱动。
#pragma pack 直接改默认对齐数:
#include <stdio.h>

#pragma pack(1)
struct S
{
    char c1;
    int i;
    char c2;
};
#pragma pack()

int main(void)
{
    printf("%zu\n", sizeof(struct S));   /* 6 */
    return 0;
}
填充全部取消,大小从 12 变成 6。它是编译器扩展,不是 C 标准的一部分;GCC 还有 __attribute__((packed))。代价有三条:压缩后的 int 可能落在奇数地址,x86 上只是慢一点,很多 ARM 上会触发总线错误;pack 的状态会影响后面所有结构体,跨编译单元时容易一边压了、一边没压;它只改布局,不处理字节序和版本兼容。
真要把结构体写进文件,还得面对填充字节本身:它们的内容没有定义,可能残留栈上的旧数据。可靠的做法是一个字段一个字段地写,宽度和顺序都写死在代码里,不把 sizeof(struct) 当成文件格式。
传值拷贝整块,传地址只拷贝一个指针
#include <stdio.h>

struct S
{
    int data[1000];
    int num;
};

void print1(struct S s)
{
    printf("%d\n", s.num);
}

void print2(const struct S *ps)
{
    printf("%d\n", ps->num);
}

int main(void)
{
    struct S s = {{1, 2, 3, 4}, 1000};

    print1(s);
    print2(&s);
    return 0;
}
按值传参要复制整个结构体,这里是一千个 int 加一个 int,四千多字节压进栈;传地址只复制一个指针。加 const 还能告诉调用者“函数不会改它”。结构体一变大,这个差距就是数量级的,所以默认选传地址。
这句话也不能推成“结构体一律传指针”。现代 ABI 会把几个标量组成的小结构体直接放进寄存器,按值传不一定慢,还避开了别名问题,编译器优化起来更自由。判据是大小和用途:含大数组、大缓冲区的传 const 指针,两三个字段的小结构体按值传反而清爽。返回值同理,编译器常常在调用者预留的空间里直接构造,不必因为“怕复制”就全部改成输出参数。
位段:按位分配,按编译器解释
位段的声明和结构体类似,成员名后面多一个冒号和一个位宽:
struct A
{
    int _a : 2;
    int _b : 5;
    int _c : 10;
    int _d : 30;
};
课件写“位段的成员必须是 int、unsigned int 或 signed int,C99 中也可以选择其他类型”。标准只保证 int、signed int、unsigned int 和 _Bool,其他类型是否允许由实现决定。char 位段在 GCC 和 MSVC 上能编,但不属于标准强制,换编译器前别当成可移植写法。
这个例子的大小,常见编译器给出 8:
#include <stdio.h>

struct A
{
    int _a : 2;
    int _b : 5;
    int _c : 10;
    int _d : 30;
};

int main(void)
{
    printf("%zu\n", sizeof(struct A));   /* 8 */
    return 0;
}_a、_b、_c 共 17 位,进第一个 4 字节单元;_d 要 30 位,只剩 15 位,装不下。MSVC 和 GCC 在这里都不会让位段跨单元,于是新开一个单元,总大小 8。位宽总和只有 47 位,按 6 字节算是不对的,因为“能不能跨单元”本身就由实现决定。
用 char 位段能看清分配方向:
#include <stdio.h>

struct S
{
    char a : 3;
    char b : 4;
    char c : 5;
    char d : 4;
};

int main(void)
{
    struct S s = {0};

    s.a = 10;
    s.b = 12;
    s.c = 3;
    s.d = 4;

    printf("%zu\n", sizeof(struct S));   /* 3 */
    return 0;
}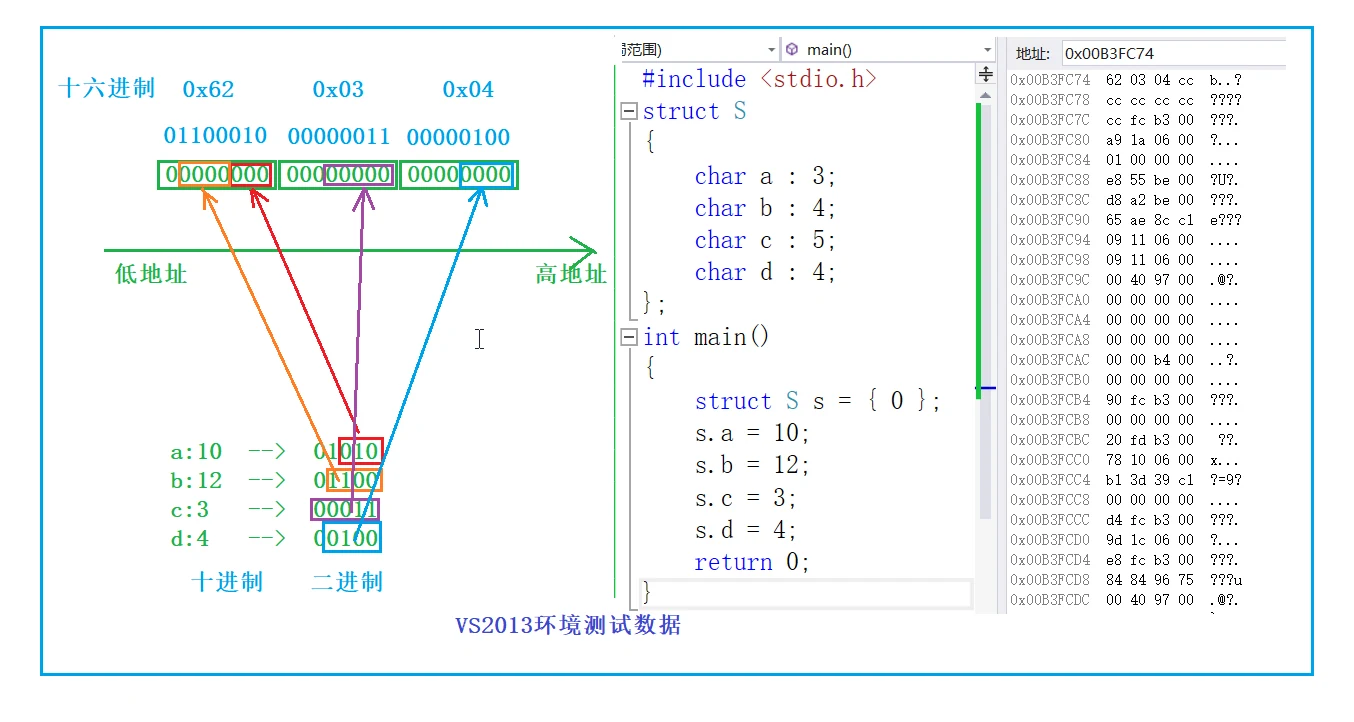
在 VS 这套分配方式下,a 占 3 位,10 的 1010 截成 010;b 占 4 位,12 是 1100,接在 a 上面,整个字节成了 0110 0010,即 0x62。c 要 5 位,第一个字节只剩 1 位,换第二个字节,得到 0x03;d 要 4 位,第二个字节只剩 3 位,再换一个字节,得到 0x04。赋进去的值超出位宽会被截断。
位段不可移植,标准留了四处不确定:
int位段当成有符号还是无符号,由实现决定。- 位段的最大宽度不确定,和机器的字长有关。
- 成员从低位往高位分配,还是反过来,标准没有定义。
- 前一个单元剩余的位,下一个位段装不下时是舍弃还是继续用,也没有定义。
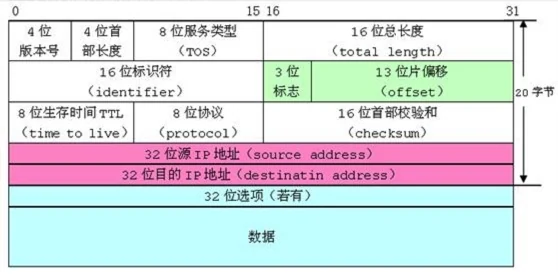
网络协议里字段按位排列,位段看起来正合适。但报文位置是协议钉死的,而位段的分配方向由编译器决定,所以真实代码大多还是读字节、移位、掩码,不直接用位段解析首部。
位段还有一个硬限制:不能取地址。几个成员共用同一个字节,成员可能从字节中间开始,而地址的最小单位是字节,所以 &s.a 编译不过,scanf("%d", &sa._b) 也不行。正确做法是先读进一个普通变量再赋值:
#include <stdio.h>

struct A
{
    int _a : 2;
    int _b : 5;
    int _c : 10;
    int _d : 30;
};

int main(void)
{
    struct A sa = {0};
    int b = 0;

    scanf("%d", &b);
    sa._b = b;

    return 0;
}
柔性数组:结构体最后那段没写长度的空间
结构体的最后一个成员可以只写类型、不写长度:
struct Flex
{
    int n;
    int data[];
};
这叫柔性数组(flexible array member),C99 引入。data 不占 sizeof(struct Flex) 的空间,使用时按需要多分配:
#include <stddef.h>
#include <stdio.h>
#include <stdlib.h>

struct Flex
{
    int n;
    int data[];
};

int main(void)
{
    struct Flex *p = malloc(sizeof(struct Flex) + 10 * sizeof(int));

    if (p == NULL)
        return 1;

    p->n = 10;
    for (int i = 0; i < p->n; i++)
        p->data[i] = i;

    printf("%zu %d\n", sizeof(struct Flex), p->data[9]);   /* 4 9 */
    free(p);
    return 0;
}
sizeof(struct Flex) 只算到 n,用 offsetof(struct Flex, data) 拿到的偏移一般就等于这个值。一次 malloc 把头部和数据放在连续内存里,释放一次就够。
对比另一种写法:成员写成 int *data,结构体里多出一个指针,数据要另外分配、另外释放,两块内存还不一定挨着。柔性数组省掉指针本身,也让数据和头部在同一块分配里,遍历时缓存命中更好。代价是长度必须自己记住(这里存在 n 里),分配时长度算错就是越界。
int data[0] 也能在一些编译器上通过,那是 GCC 的扩展写法,不是标准里的柔性数组;按标准写 int data[];。柔性数组必须是最后一个成员,它前面至少要有一个具名成员,只放一个柔性数组的结构体不合法。
还没有评论 — 第一条由你来留。