十二类操作符,各自干什么
C 的操作符按用途分成十二类,按操作数个数则只有单目、双目、三目三种:
| 类别 | 操作符 | 要点 |
|---|---|---|
| 算术 | + - * / % | % 两侧必须是整数;C99 起除法向零截断,余数符号与被除数一致 |
| 移位 | << >> | 操作数必须是整数 |
| 位 | & | ^ ~ | ~ 是单目,其余三个是双目 |
| 赋值 | = += -= *= /= %= <<= >>= &= |= ^= | 右结合,a = b = c 等价于 a = (b = c) |
| 单目 | ! ++ -- & * + - ~ sizeof (类型) | 只有一个操作数 |
| 关系 | > >= < <= == != | 结果为 0 或 1 |
| 逻辑 | && || | 短路求值 |
| 条件 | ? : | 三目,只求值其中一个分支 |
| 逗号 | , | 从左到右依次求值,结果取最后一个 |
| 下标 | [] | 两个操作数:数组名和下标 |
| 函数调用 | () | 第一个操作数是函数名,其余是实参 |
| 结构成员 | . -> | 点操作符用于结构体变量,箭头用于指针 |
/ 和 % 有几个容易踩的点:5 / 2 得 2,-5 / 2 得 -2(向零截断,不是向负无穷);-5 % 2 得 -1,余数的符号跟被除数走;除数为 0 是未定义行为,编译器不会替你检查。
进制只是同一个数的不同写法
15 这个值可以写成 1111(二)、17(八)、15(十)、F(十六)。C 里 0 开头的数字是八进制,0x 开头的是十六进制,015 是十三,0xF 才是十五。
十进制的每一位有固定权重,二进制的每一位权重是 2 的幂:
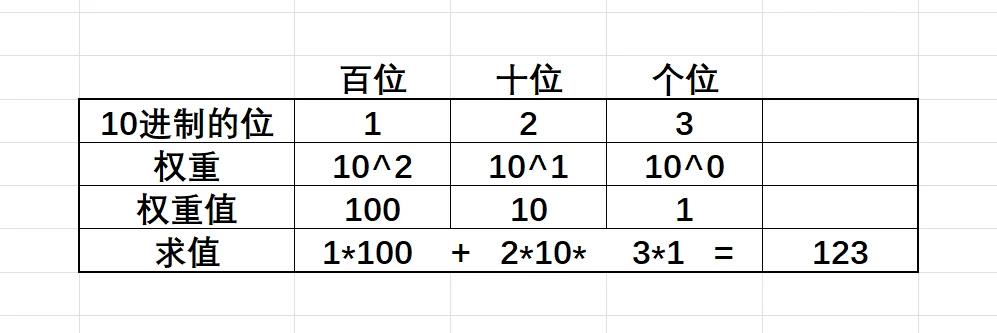
1101 按同样规则拆开:1×8 + 1×4 + 0×2 + 1×1 = 13。
十进制转二进制用短除法:反复除以 2,记下余数,最后从下往上读:
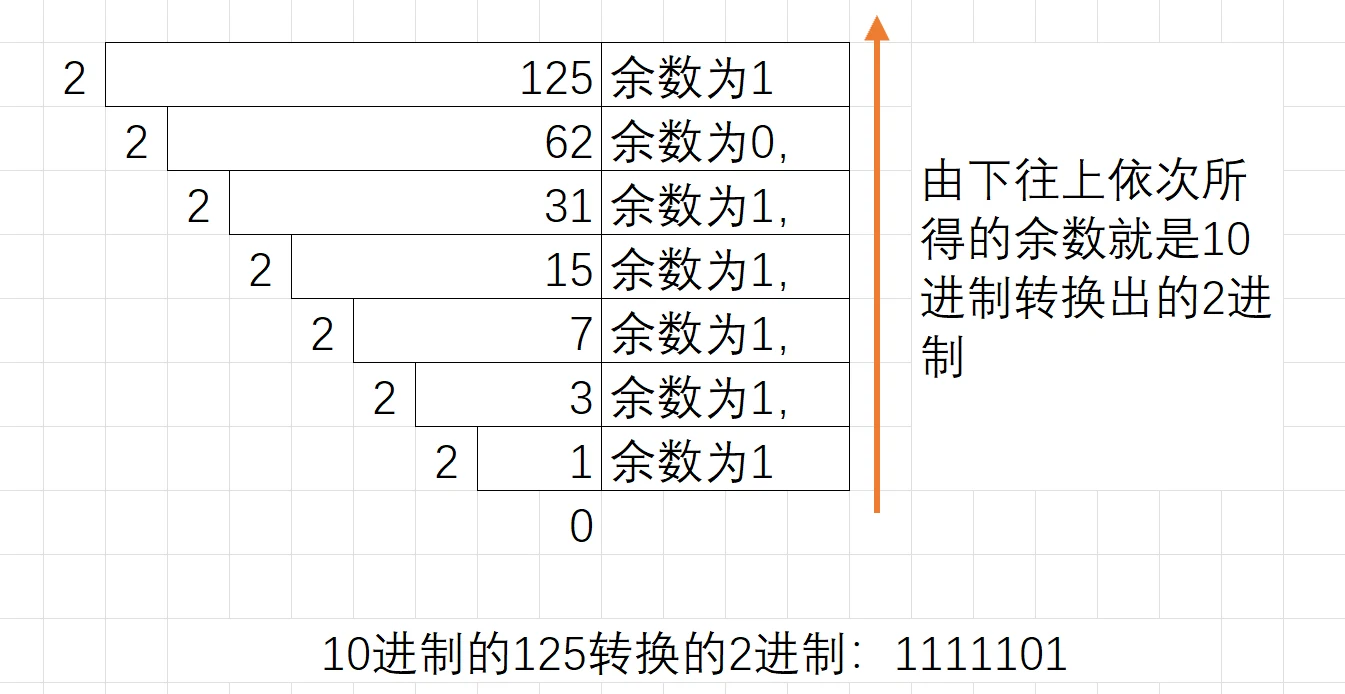
二进制转八进制,从右往左每三位一组,因为 0 到 7 最多用三位就够:01101011 分成 001 101 011,得到 0153。转十六进制每四位一组,因为 0 到 f 最多四位:0110 1011 得到 0x6B。
原码、反码、补码:让减法消失
有符号整数的二进制表示有三种。最高位是符号位,0 表示正,1 表示负,其余是数值位。
- 正数的原码、反码、补码都相同。
- 负数的原码:符号位取 1,数值部分写绝对值。
- 负数的反码:符号位不变,其余位按位取反。
- 负数的补码:反码加 1;从补码回原码,同样是按位取反再加 1。
内存里存的是补码,动机在于让 CPU 只造一套加法器:
  0000 0101   5
+ 1111 1101   -3 的补码
-----------
1 0000 0010 丢掉最高位进位,剩 2如果换成原码,00000101 + 10000011 = 10001000,读出来是 -8。补码让符号位和数值位一起参与加法,进位丢掉之后结果自然正确,减法就不用单独造电路。
由此有两个推论。~x == -x - 1 对任何整数成立,所以 ~5 是 -6,~5 + 1 才是 -5。范围不对称:8 位补码是 -128 到 127,10000000 规定为 -128,没有对应的正数;32 位同理,-INT_MIN 仍然是 INT_MIN,而且是有符号溢出,标准上属于未定义行为。
移位:左移补 0,右移看符号
<< 的规则是左边丢弃、右边补 0:
#include <stdio.h>

int main(void)
{
    int num = 10;
    int n = num << 1;

    printf("n = %d, num = %d\n", n, num);   /* 20 10 */
    return 0;
}
num 本身没变,移位不写回。左移一位在数值上等于乘 2,前提是没有溢出。
>> 分两种填法。逻辑右移左边补 0,算术右移左边补符号位。同一个 -1 右移一位,两种填法的结果完全不同:
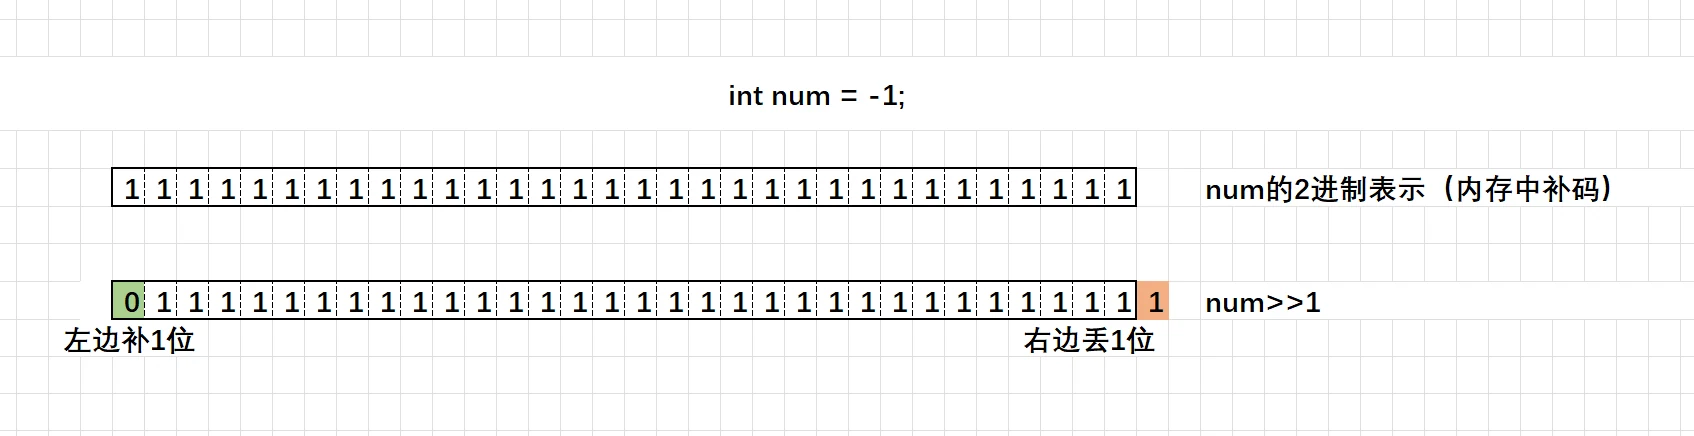
同一个位模式,填 0 得到 0x7FFFFFFF,也就是 2147483647;填 1 保持全 1,还是 -1,两个结果差了 2^31。
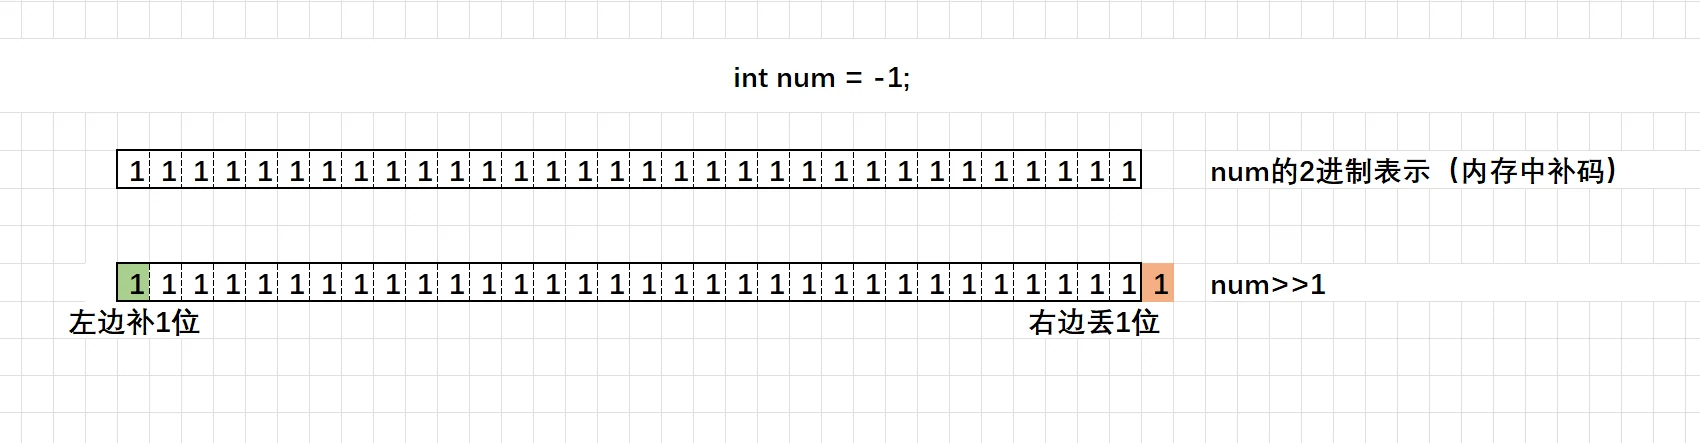
对负数右移,C 标准把选择权交给实现,MSVC、GCC、Clang 在主流平台上都选算术右移。于是同一对表达式会给出不同答案:
#include <stdio.h>

int main(void)
{
    printf("%d\n", -3 >> 1);   /* -2,算术右移,向负无穷取整 */
    printf("%d\n", -3 / 2);    /* -1,除法,向零截断 */
    return 0;
}
“右移等于除以 2”只对非负数成立。拿它替换有符号数的除法,结果会悄悄差一。
课件只提醒了“不要移动负数位”,实际要避开的未定义行为有三条:
- 移位位数是负数,
num >> -1; - 移位位数大于或等于提升后左操作数的位宽,
1 << 32; - 有符号数左移后结果超出可表示范围,
1 << 31。
第二条最阴。x86 的移位指令只取移位量的低 5 位,1 << 32 实际变成移 0 位,看起来“没移”,于是让人以为它可靠;编译器在常量折叠时又可能给出另一个结果。
int main(void)
{
    int x = 1;
    int y = x << 31;             /* 有符号溢出,未定义行为 */
    unsigned int z = 1u << 31;   /* 0x80000000,定义良好 */

    return 0;
}
写掩码一律从 1u 开始,目的是不碰符号位。
位运算:掩码、交换、数 1
& | ^ 逐位运算,~ 逐位取反,操作数都必须是整数。用 -3 和 5 过一遍:
| 表达式 | 结果 | 原因 |
|---|---|---|
-3 & 5 | 5 | -3 的补码以 1101 结尾,与 0101 按位与只剩 0101 |
-3 | 5 | -3 | 负数的补码高位全 1,按位或之后仍是 -3 |
-3 ^ 5 | -8 | 低位 1101 ^ 0101 = 1000,高位保持全 1,结果是 -8 |
~0 | -1 | 全 0 取反成全 1,即 -1 |
异或有一个经典用法,不用第三个变量交换两个整数:
int main(void)
{
    int a = 10;
    int b = 20;

    a = a ^ b;
    b = a ^ b;
    a = a ^ b;

    return 0;
}
第一步把两数的差异存进 a,第二步用差异和 b 还原出原来的 a,第三步还原出原来的 b。它只对“两个不同的对象”成立:如果 a、b 是同一个变量的两个名字(比如两个指针指向同一块内存),三步之后这个值会被清零。工程里更推荐临时变量,现代编译器生成的代码一样快,可读性还更好。
数一个整数二进制里 1 的个数,课件给了三种写法,正好可以按踩坑顺序看。
第一种用 %2 和 /2:
int count_ones(int num)
{
    int count = 0;

    while (num)
    {
        if (num % 2 == 1)
        {
            count++;
        }
        num = num / 2;
    }
    return count;
}正数没问题,负数全错:-1 % 2 在 C 里是 -1,不是 1,if 永远不成立;-1 / 2 向零截断得 0,循环只跑一轮,count_ones(-1) 返回 0,正确答案是 32。把 num 先转成 unsigned int 再进循环,这条路径才成立。
第二种逐位扫描:
int count_ones(int num)
{
    int count = 0;
    int i = 0;

    for (i = 0; i < 32; i++)
    {
        if (num & (1u << i))
        {
            count++;
        }
    }
    return count;
}
思路正确,课件代码里写的是 1 << i。当 i == 31 时,1 << 31 正是前面说的有符号左移溢出,属于未定义行为;换成 1u 就没这个问题。而且它固定循环 32 次,1 的个数再少也要走满。
第三种用 x & (x - 1):
int count_ones(int num)
{
    unsigned int x = (unsigned int)num;
    int count = 0;

    while (x)
    {
        count++;
        x = x & (x - 1);
    }
    return count;
}
以 12(1100)为例:减 1 得 11(1011),最低位的 1 变成 0,它右边原本的 0 全部变 1;两者按位与,那一位和它右边全部清零,高位保持原样。每算一次少一个 1,循环次数等于 1 的个数,num = -1 时也只需 32 次。
这个性质还能判断 2 的幂:x != 0 && (x & (x - 1)) == 0。GCC 和 Clang 的 __builtin_popcount 会直接映射到 CPU 的 POPCNT 指令,更快,但不可移植。
置位、清位、翻转、读位是四个固定动作,拿 13 的第 5 位(从右数,下标 4,掩码 1u << 4)演示:
int main(void)
{
    unsigned int a = 13;

    a = a | (1u << 4);     /* 置 1:29 */
    a = a & ~(1u << 4);    /* 清 0:13 */
    a = a ^ (1u << 4);     /* 翻转:29 */
    (a >> 4) & 1u;         /* 读这一位 */

    return 0;
}
“第几位”必须说明是从 1 数还是从 0 数:从右数第 5 位,下标是 4,移 4 位;下标 5 对应的是第 6 位。
逗号、下标、函数调用、点与箭头
逗号表达式的规则是:从左到右依次执行,整个表达式的值是最后一个子表达式的值。
int main(void)
{
    int a = 1;
    int b = 2;
    int c = (a > b, a = b + 10, a, b = a + 1);

    return 0;
}三步走:a > b 为假,结果 0 被丢弃;a = b + 10 把 a 改成 12;a 求值仍为 12;b = a + 1 把 b 改成 13,整个表达式的值是 13,所以 c 是 13。
同样的写法能塞进 if:if (a = b + 1, c = a / 2, d > 0) 的条件值是 d > 0,前两个子表达式只负责副作用。
逗号也常用来把循环里必须成组发生的动作挤进条件:
while (a = get_val(), count_val(a), a > 0)
{
    /* 业务处理 */
}
它等价于在循环体末尾重复那两句,只是写在了判断条件里。可读性是否更好要酌情,调试时这种写法断点不好下。
[] 有两个操作数:数组名和下标。arr[9] = 10; 里,操作数是 arr 和 9。按标准,arr[i] 等价于 *(arr + i),而加法满足交换律,所以 i[arr] 也合法;能写不等于该写。
() 的第一个操作数是函数名,其余操作数是实参:
void test1(void)
{
    printf("hehe\n");
}

void test2(const char *str)
{
    printf("%s\n", str);
}

int main(void)
{
    test1();
    test2("hello bit.");
    return 0;
}
test1() 的括号里没有实参,test2("hello bit.") 的括号里有一个。函数名本身在表达式中会退化成函数指针,() 就是通过这个指针发起调用。
结构体把多个不同类型的值打包成一个类型,成员可以是标量、数组、指针,甚至另一个结构体。声明形式是 struct tag { member-list; } variable-list;,最后的分号不能丢:
struct Stu
{
    char name[20];
    int age;
    char sex[5];
    char id[20];
};
定义变量和初始化有三种常见写法:声明类型时顺手定义变量,之后单独定义,或者定义时直接给出初值;初始化既能按位置对应,也能用指示器打乱顺序:
struct Point
{
    int x;
    int y;
} p1;                                   /* 声明类型的同时定义 p1 */

struct Point p2;                        /* 之后单独定义 p2 */
struct Point p3 = {10, 20};

struct Stu s1 = {"zhangsan", 20};
struct Stu s2 = {.age = 20, .name = "lisi"};   /* 指示器初始化,C99 */
结构体还能嵌套:
struct Node
{
    int data;
    struct Point p;
    struct Node *next;
} n1 = {10, {4, 5}, NULL};
访问成员用两个操作符:变量用 .,指针用 ->。
#include <stdio.h>

int main(void)
{
    struct Point
    {
        int x;
        int y;
    } p1 = {1, 2};

    struct Point *ptr = &p1;

    p1.x = 10;
    ptr->y = 20;                 /* 等价于 (*ptr).y = 20 */
    printf("%d %d\n", p1.x, p1.y);   /* 10 20 */
    return 0;
}
这个等价关系解释了 -> 为什么存在:. 的优先级高于 *,写 *ptr.x 会被解析成 *(ptr.x),而 ptr 是指针,没有成员可点,编译直接报错。
结构体做函数参数是值传递,改不到原件;要改就传指针:
#include <stdio.h>
#include <string.h>

struct Stu
{
    char name[15];
    int age;
};

void print_stu(struct Stu s)
{
    printf("%s %d\n", s.name, s.age);
}

void set_stu(struct Stu *ps)
{
    strcpy(ps->name, "李四");
    ps->age = 28;
}

int main(void)
{
    struct Stu s = {"张三", 20};

    print_stu(s);    /* 张三 20 */
    set_stu(&s);
    print_stu(s);    /* 李四 28 */
    return 0;
}
print_stu 拿到的是一份拷贝,打印完就丢;set_stu 拿到地址,改的是 main 里那个 s。name 是字符数组,不能写 ps->name = "李四",数组名不是可修改的左值,必须用 strcpy 逐字节拷进去。
优先级决定谁和谁结合,不决定谁先算
3 + 4 * 5 先算乘法,因为 * 的优先级高于 +。5 * 6 / 2 里两个运算符优先级相同,按左结合从左往右算。
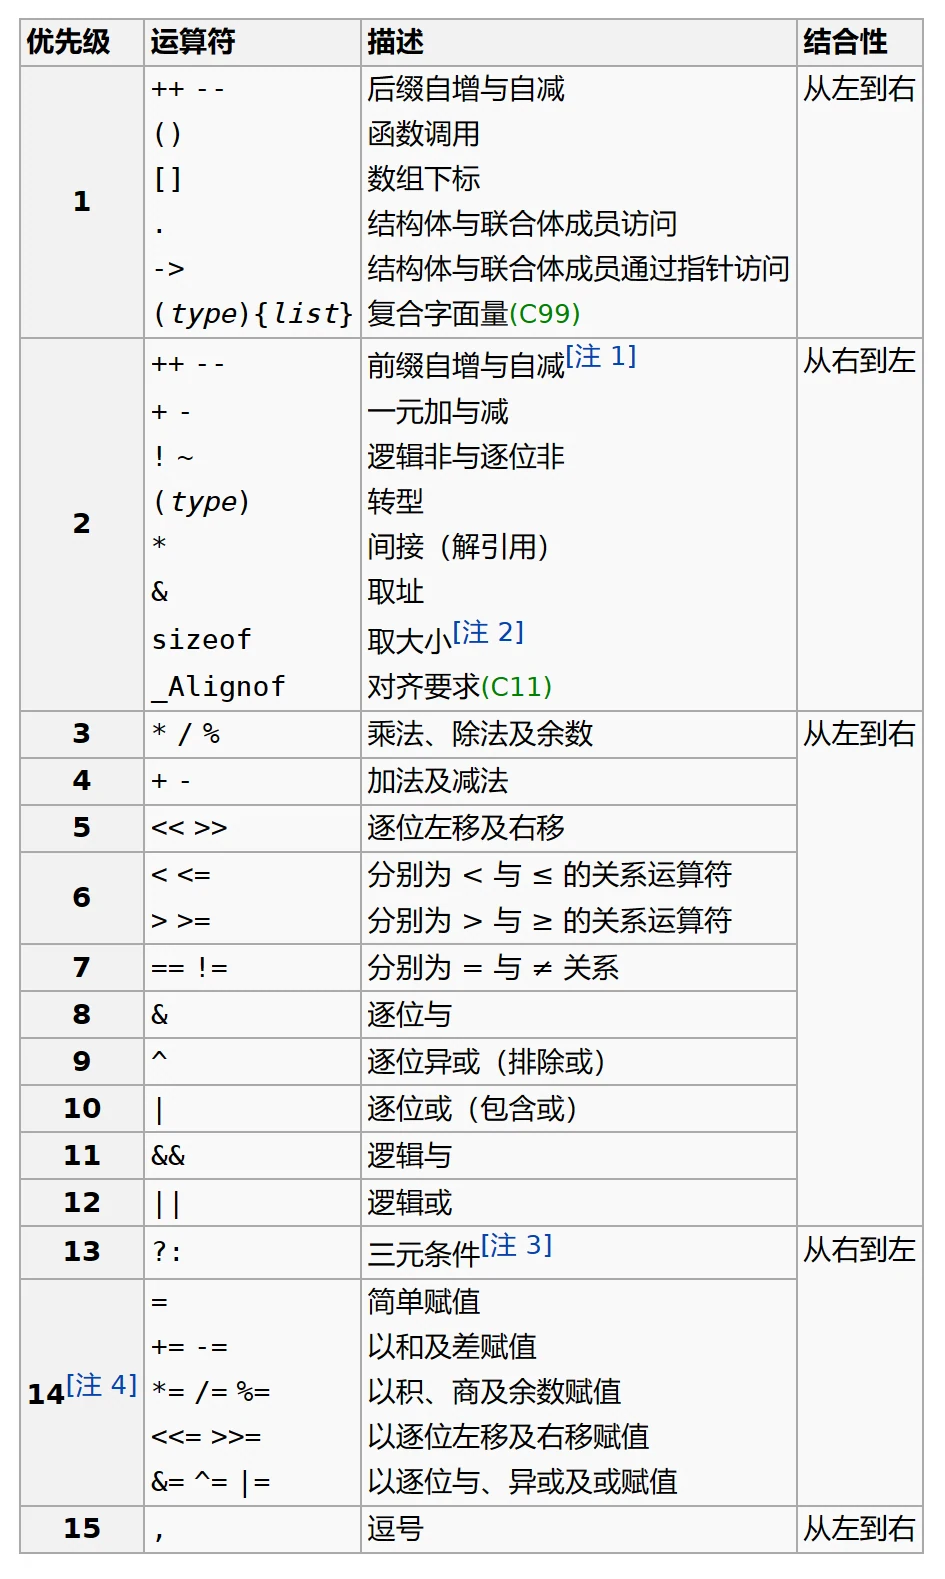
不用背完十五级,记几个反直觉的就够日常使用。圆括号优先级最高,拿不准就先加括号。
第一,位运算低于关系运算。==、!= 的优先级比 &、^、| 都高,所以
if (flags & 0x04 == 0)实际算的是 flags & (0x04 == 0),也就是 flags & 0,恒为 0。语法合法,类型正确,编译器不提醒。正确写法只有加括号:
if ((flags & 0x04) == 0)第二,. 的优先级高于解引用。*p.x 是 *(p.x);想取指针指向的结构体成员,要么写 (*p).x,要么直接用 ->。
第三,后缀 ++ 的优先级高于解引用。*p++ 是 *(p++):先取 p 指向的值,再把 p 后移;(*p)++ 才是把指向的值加一、指针不动。遍历数组时错一个括号,轻则死循环,重则改坏数据。
赋值和条件运算符是右结合:a = b = c 先算 b = c;a ? b : c ? d : e 等价于 a ? b : (c ? d : e)。
优先级只规定表达式的结合方式,不规定求值顺序。a * b + c * d + e * f 里,标准只保证每个乘法比加法先算,三个乘法和两个加法之间谁先谁后没有规定,可能的执行序列不止一种。函数调用同理:f() + g() * h() 里先乘后加是确定的,三个函数谁先被调用是未指定的。
以下这类表达式则是未定义行为,不只是“顺序不定”:
c + --c;                                    /* 读 c 和改 c 没有先后关系 */
i = i-- - --i * (i = -3) * i++ + ++i;       /* 同一表达式里多次读写 i */
C11 6.5 第 2 段规定:对同一个标量对象,如果两次访问之间有一次是修改,且两次访问没有被排序,行为就是未定义。课件说 c + --c “结果不可预测,有歧义”,说轻了——这属于未定义行为,编译器做什么都合规,并非在几个合法值里挑一个。
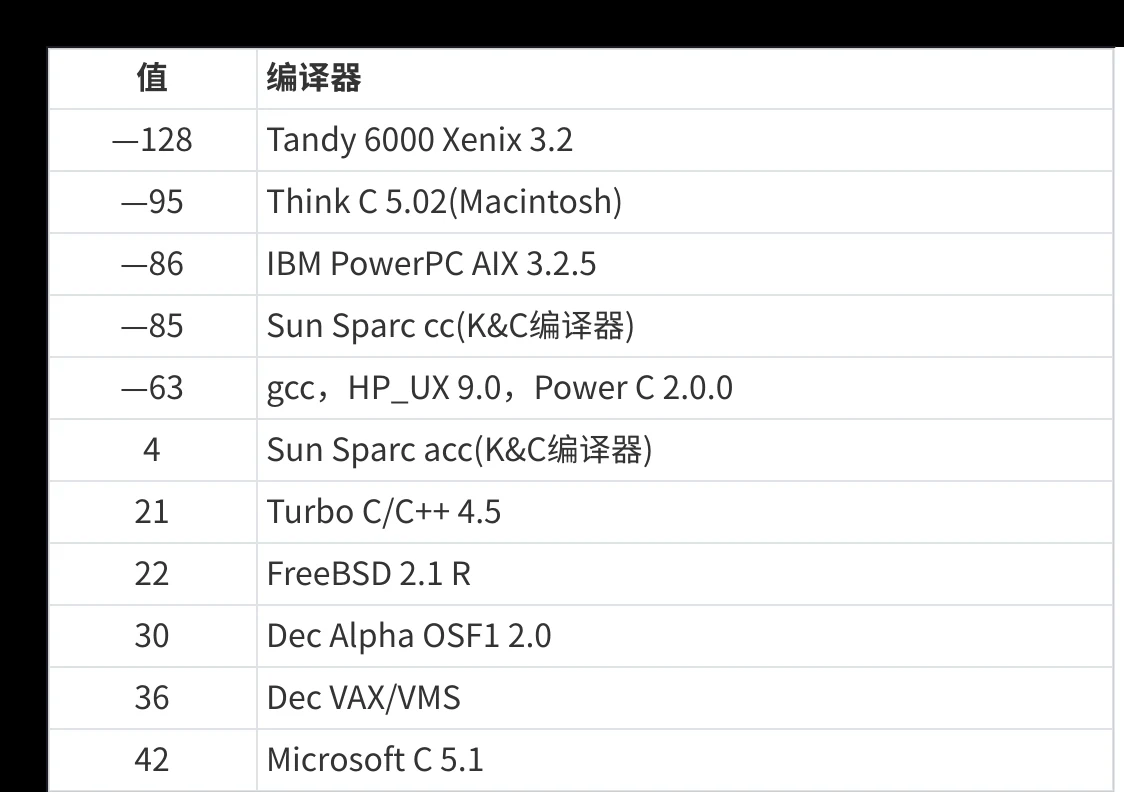
函数参数的求值顺序是另一档:fun() - fun() * fun() 里三次调用谁先谁后没有规定,结果可能不同,但每个调用内部是完整求值的,不会互相穿插。这类叫未指定行为(unspecified behavior),程序不会因此崩溃,只是别依赖某个顺序。(++i) + (++i) + (++i) 比它更严重:同一个 i 在一条表达式里被改了三次,按 6.5 第 2 段属于未定义行为,GCC 和 MSVC 给出不同结果只是它的表现形式。
避开这些不需要背序列点,一条规则就够:同一个变量在同一条表达式里出现多次,且至少有一次带副作用,就拆成多行。
整型提升、算术转换,以及 sizeof 与 ++/--
先把单目里没展开的几个收掉:! 把零变 1、非零变 0;~ 按位取反;一元 +、- 是正负号;(类型) 是强制类型转换,按目标类型重新解释这个值。sizeof 和 ++/-- 的坑下面单独说。
char、short 参与算术之前,先被提升成 int(或 unsigned int),这一步叫整型提升(integer promotion)。原因是 CPU 的整数运算器和通用寄存器都以 int 的宽度为基准,两个 8 位字节直接相加,硬件并不擅长。
提升规则两条:有符号类型按符号位扩展,无符号类型高位补 0。
char c1 = -1;        11111111 -> 11111111111111111111111111111111
char c2 = 1;         00000001 -> 00000000000000000000000000000001
unsigned char c3 = 255;  11111111 -> 00000000000000000000000011111111
同一个 11111111,有符号提升完是 -1,无符号提升完是 255,差别全在高位补的是符号位还是 0。
课件在这里写“因为 char 为有符号的 char”,把实现选择说成了标准规定。C 标准把 char 是否有符号交给实现决定:x86 上的 MSVC 和 GCC 默认有符号,部分 ARM 工具链默认无符号。需要确定符号时写 signed char 或 unsigned char,别赌平台。
两个操作数类型不同时,按“寻常算术转换”的层次向上转换:
long double
double
float
unsigned long int
long int
unsigned int
int
排名靠后的先转成排名靠前的类型再运算。这套规则有一个著名陷阱:
if (-1 < 1u)
{
    printf("成立\n");
}
-1 会被转成 unsigned int,变成 4294967295,比较结果为假,一行都不会打印。sizeof 的结果是无符号的 size_t,所以 sizeof(int) < -1 反而成立:-1 被转成无符号的最大值,4 < 18446744073709551615 为真。循环条件里混用 int 和 size_t 时尤其要小心。
sizeof 是单目操作符,不是函数。结果是 size_t,无符号,打印用 %zu;写成 %zd 是把无符号值按有符号格式输出,标准上属于未定义行为。它在编译期求值(变长数组除外),而且不求值操作数:
#include <stdio.h>

int main(void)
{
    int i = 5;

    printf("%zu\n", sizeof(i++));   /* 输出 4,i 仍然是 5 */
    return 0;
}
sizeof(数组名) 得到整个数组的字节数,但只在数组还没退化成指针的地方成立;sizeof(arr) / sizeof(arr[0]) 是求元素个数的常用写法,一旦 arr 是函数形参,这个比值就变成“指针大小除以元素大小”,没有意义。
++ 和 -- 的前后缀差别在于表达式的值:前缀先加再用新值,后缀先用旧值再加。a[i++] 取的是 a[i],然后 i 加一;*p++ 取的是 *p,然后 p 后移一个元素。这几个组合在数组遍历、字符串拷贝里高频出现,读的时候按优先级拆开就不会错。
真正要避开的是在同一表达式里多次修改同一个对象:
void f(int arr[])
{
    int i = 0;

    i = i++;          /* 未定义行为 */
    arr[i] = i++;     /* 未定义行为,下标和自增没有排序 */
}
拆成两句,顺序由分号定死,结果才有保证。
还没有评论 — 第一条由你来留。