递归函数的结构只有两句话:判断这一层能不能停,不能停就把问题缩小,交给下一层。剩下的内容都在围绕这两句展开:出口写得对不对,规模缩得对不对,代价付得起付不起。
函数调用自己,最后会撞上栈
最小的递归是把 main 自己再调一次:
#include <stdio.h>

int main(void)
{
    printf("hehe\n");
    main();
    return 0;
}
它能编译、能运行、能打印,但每一层都不会返回,栈上堆着一层又一层的调用记录。刷一会儿 hehe 之后,进程撞上栈边界:
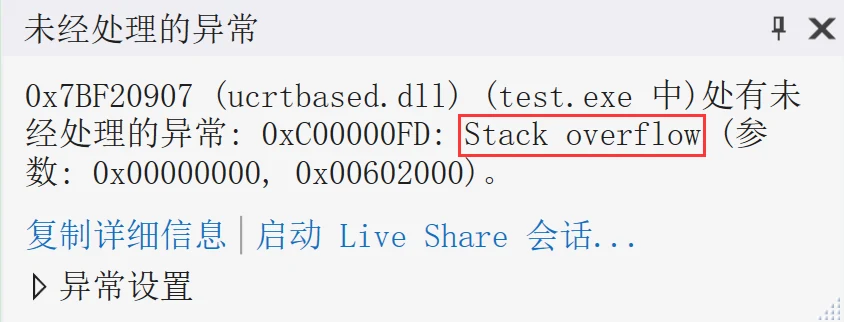
0xC00000FD 对应 Windows 的 STATUS_STACK_OVERFLOW。在 Linux 上不一定有这张弹窗,常见表现是收到 SIGSEGV,或者进程被内核直接终止。整台机器的内存并没有被用光,撞到边界的是进程里留给函数调用那一段栈:MSVC 默认栈保留 1 MB,Linux 主线程通常按 ulimit -s 给 8 MB。
递归的“递”是逐层深入,“归”是逐层返回。所有真正的计算都发生在归的路上还是递的路上,取决于语句写在递归调用之前还是之后。
两个必要条件,缺一个都停不下来
递归的思想是把大问题拆成同构的小问题,一直拆到不必再拆为止,这个“拆”就是递,“回来”就是归。
课件把条件写对了:递归必须存在限制条件,满足时不再继续;每次调用之后必须越来越接近这个条件。
只有出口、方向却反了:
int BadSum(int n)
{
    if (n == 0)
    {
        return 0;
    }
    return n + BadSum(n + 1);    /* 越走越远,永远碰不到 0 */
}
出口在,步子也在走,但跨过去了:
int BadSum2(int n)
{
    if (n == 0)
    {
        return 0;
    }
    return n + BadSum2(n - 2);   /* 5、3、1、-1、-3,没有一层等于 0 */
}
BadSum2(5) 的参数序列是 5、3、1、-1、-3,每次都在靠近 0 的方向上前进,却从没落到 0 上。出口条件写成 n <= 0,这类跨过出口的输入才兜得住;用范围判断比用等值判断稳。
数学归纳法和这两个条件是同构的:出口是奠基,最小输入直接返回正确答案;递归调用是归纳假设,假设更小规模的那次调用一定对;调用之后那几步是递推,用更小的结果拼出当前结果。三句话能证完,就不必在脑子里模拟几十层调用。
阶乘:递到 0,归时逐层乘
n! = n × (n-1)!,加上 0! = 1 的出口,递推式就完整了:
int Fact(int n)
{
    if (n == 0)
    {
        return 1;
    }
    return n * Fact(n - 1);
}
Fact(5) 先一路递到 Fact(0),拿到第一个确定的值 1,然后在归的路上逐层乘回去:1、1、2、6、24、120。
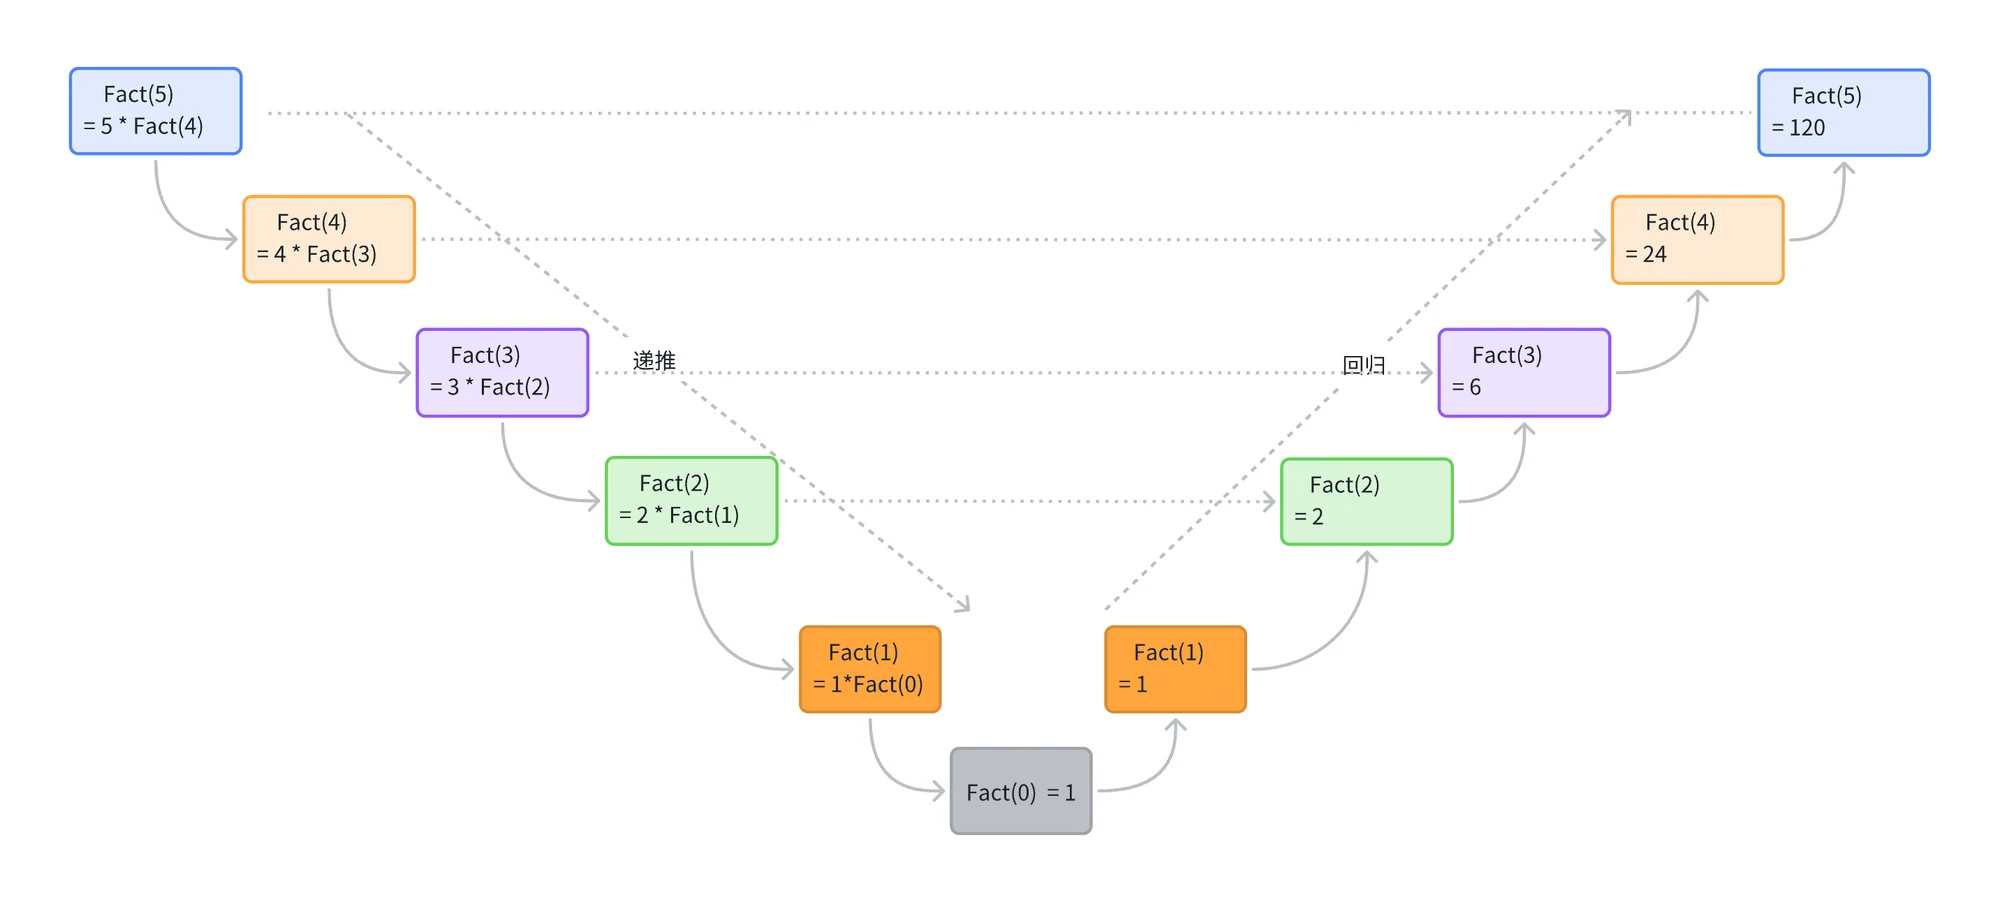
课件解释这一步时写“n 的阶乘和 n-1 的阶乘是相似的问题,但是规模要少了 n”。规模只少 1,不是少 n。5! 和 4! 只差一个因子 5,问题从“求 5 的阶乘”缩到“求 4 的阶乘”。按“少了 n”去理解,会得出“算 5! 只需要算 0!”这种错误结论。
这个函数有两个边界要交代。n 为负数时,n == 0 永远不成立,它会一路往负方向递归,最后栈溢出,所以负号要在输入处就挡掉。n 到 13 时结果装不下 32 位有符号 int,13! = 6227020800,比 INT_MAX 的 2147483647 大一截,有符号溢出在标准里是未定义行为。需要大一点的阶乘,返回类型换 long long,打印用 %lld。
打印每一位:语句站在递归调用前面还是后面
把一个整数按高位到低位逐位打印,最容易想到的是 %10 取最低位、/10 去掉最低位,但这样先得到的是倒序。递归把顺序正回来:
void Print(int n)
{
    if (n > 9)
    {
        Print(n / 10);       /* 先把高位全部处理完 */
    }
    printf("%d ", n % 10);   /* 归来时才打印这一位 */
}
Print(1234) 不会一上来就打印 4。它先发现 n > 9,把 123 交给下一层;123 又把 12 交下去,12 把 1 交下去;Print(1) 不满足条件,第一次执行到 printf,打出 1。之后逐层返回,依次打出 2、3、4。
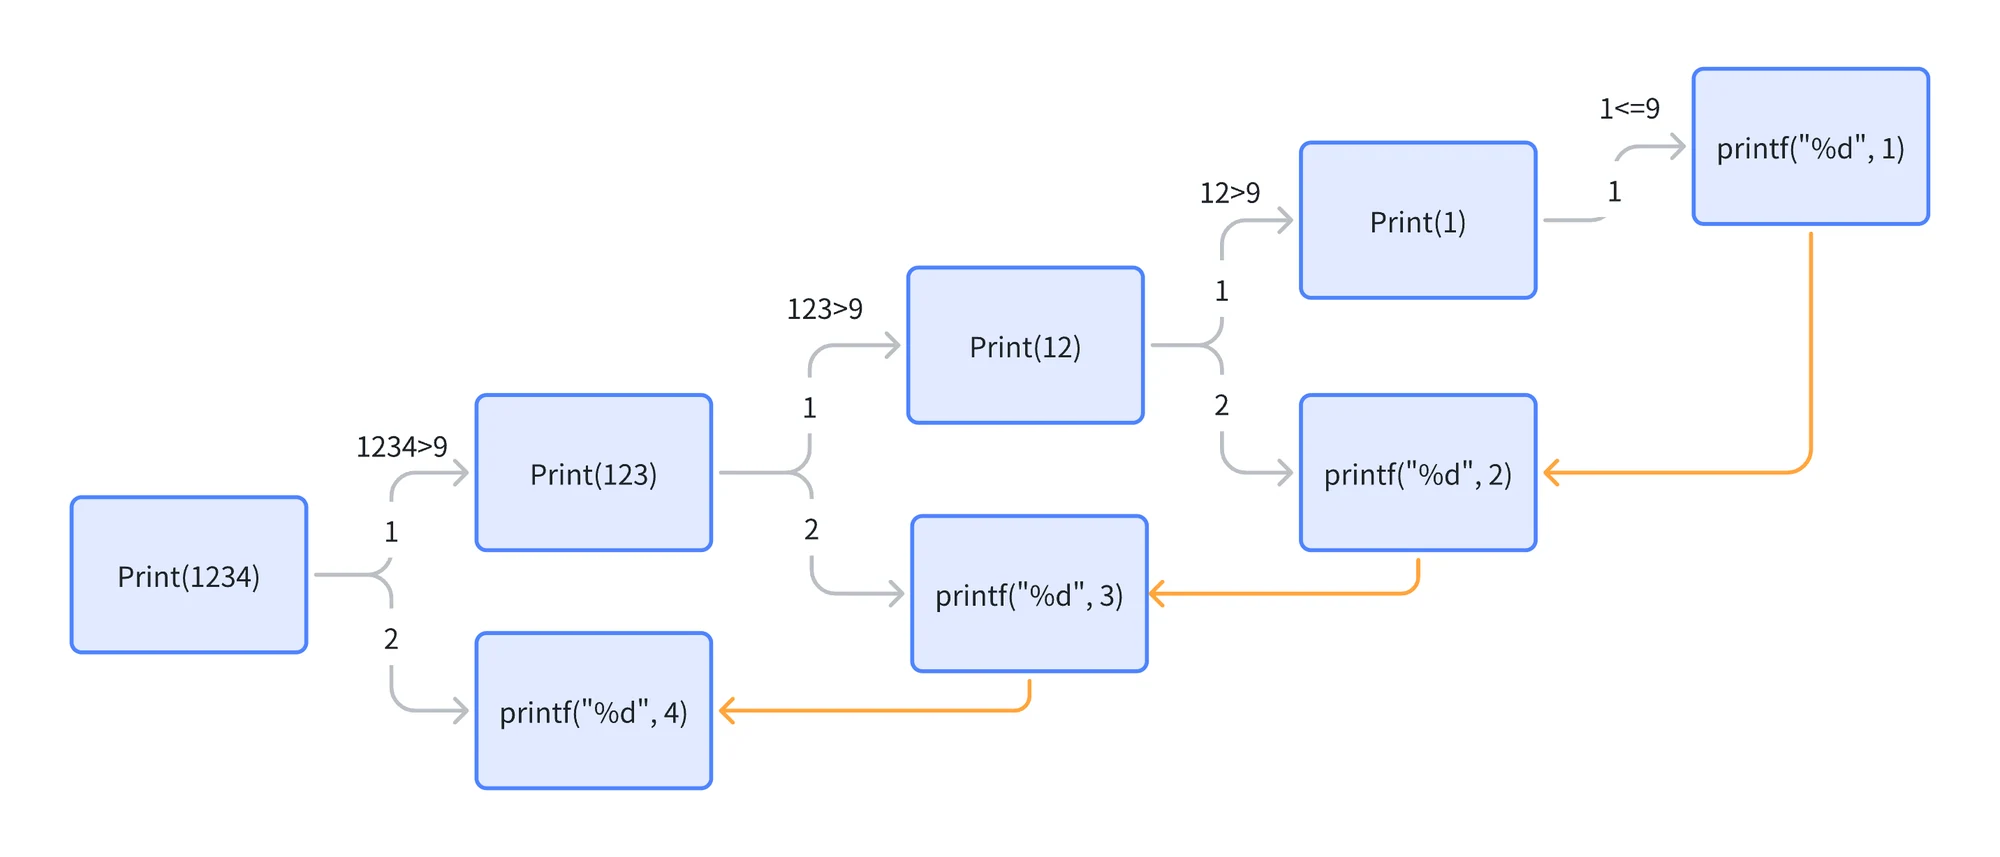
把 printf 挪到 if 前面,执行顺序立刻反过来:每层一进来就先打印自己的最低位,输出变成 4 3 2 1。同一行语句,站在递归调用前面还是后面,属于“递”还是“归”,结果完全不同。这个位置关系比背任何模板都重要。
负数要单独处理:C 的 / 向零截断,-1234 % 10 得到 -4,printf 会打出 -4。正数化之前先输出一个负号,再对绝对值递归,输出才是 -1 2 3 4。
每层调用都要占一块栈,这就是递归的账单
C 的每次函数调用都要在栈上开一块空间,放返回地址、保存的寄存器、参数和局部变量,这块空间叫栈帧(stack frame)。函数不返回,栈帧就一直占着;递归没到底之前,每一层都有自己的栈帧。
想知道一层占多少,打印地址比看教材直观:
void Probe(int n)
{
    printf("n = %d, &n = %p\n", n, (void *)&n);
    if (n > 0)
    {
        Probe(n - 1);
    }
}
在 64 位平台用 -O0 编译,Probe(3) 打出来的地址一层比一层小,相邻两层差几十字节。这个差值里不只有参数 n,还有返回地址、保存的帧指针和对齐填充;只按局部变量的大小估算递归深度,会低估得很厉害。地址的绝对值每次运行都不同,地址空间布局随机化会把它挪走,只有差值有意义。
栈溢出之后会发生什么,标准没有规定。多数情况下栈指针撞到操作系统放在栈末端的保护页,进程收到 SIGSEGV;也可能悄悄改坏了别的数据。崩溃不是最坏的结果,最坏的是它不崩。
有一种写法看起来能免掉栈开销:把递归调用放在函数最后一句,也就是尾递归(tail recursion)。GCC 的 -foptimize-sibling-calls 会把尾递归改成循环,在 -O2、-O3、-Os 下默认打开。这是编译器的优化,不是语言保证:-O0 下照样逐层压栈,换个编译器也可能不做。把正确性建立在“编译器会帮我变成循环”上,跨平台时会很难受。
斐波那契:把重复计算数出来
斐波那契的递推式直译成代码,几乎不会写错:
int Fib(int n)
{
    if (n <= 2)
    {
        return 1;
    }
    return Fib(n - 1) + Fib(n - 2);
}
Fib(10) 秒出,Fib(30) 要等一下,Fib(40) 已经需要可观的时间。问题不在慢,而在重复:同一棵子树被反复展开。加一个计数器,统计 Fib(3) 被进入的次数:
#include <stdio.h>

long long g_count = 0;

int Fib(int n)
{
    if (n == 3)
    {
        g_count++;
    }
    if (n <= 2)
    {
        return 1;
    }
    return Fib(n - 1) + Fib(n - 2);
}

int main(void)
{
    int n = 0;

    scanf("%d", &n);
    printf("%d\n", Fib(n));
    printf("count = %lld\n", g_count);
    return 0;
}
输入 40,Fib(3) 被进入 39088169 次。这个数等于 Fib(38),因为“算第 n 项时第 3 项被调用几次”本身也满足同一个递推式。调用总数接近 O(1.618^n),写成 O(2^n) 只是给上界;n 每加一,工作量大约翻倍。
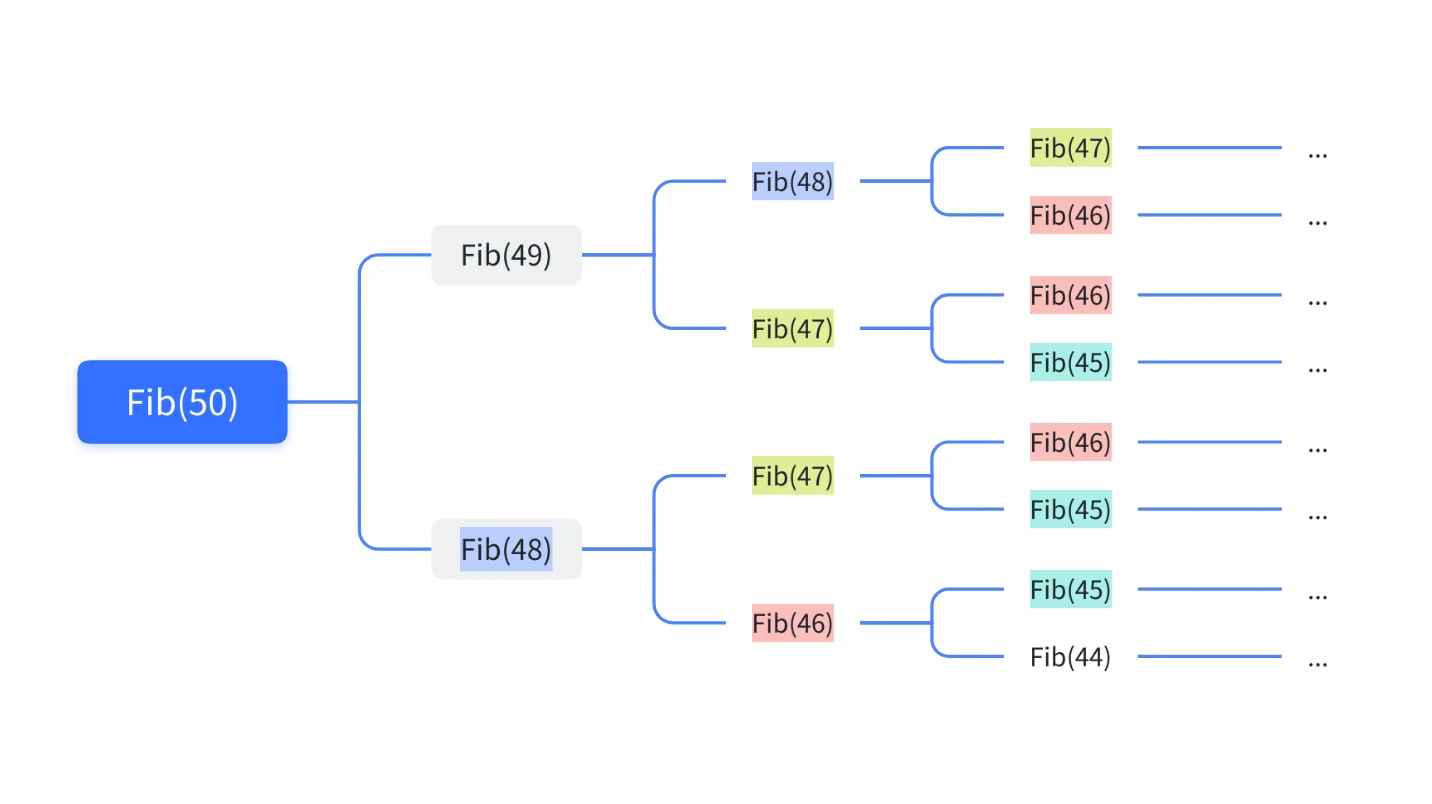
课件用 int 存结果,示例输入又写到 50。Fib(47) = 2971215073,已经超过 32 位有符号 int 的上限,Fib(50) 更不用说;要演示这个规模,返回类型至少换成 long long,打印用 %lld。
改成从前往后算,三个变量滚动就够了:
long long FibIter(int n)
{
    long long a = 1;
    long long b = 1;
    long long c = 1;
    int i = 0;

    for (i = 3; i <= n; i++)
    {
        c = a + b;
        a = b;
        b = c;
    }
    return c;
}
时间 O(n),额外空间 O(1),FibIter(50) 得到 12586269025。注意这个写法默认 n >= 1:n 为 0 或负数时直接返回 1,输入校验要放在调用方。
如果递推式不像斐波那契这么好展开,可以保留递归的形状,把算过的结果存起来:
static long long g_memo[100];

long long FibMemo(int n)
{
    if (n <= 2)
    {
        return 1;
    }
    if (g_memo[n] != 0)
    {
        return g_memo[n];
    }
    g_memo[n] = FibMemo(n - 1) + FibMemo(n - 2);
    return g_memo[n];
}
每个 n 只真正算一次,指数级的树被剪成线性的图。代价是一块和 n 同规模的内存,递归深度仍然是 n,它省时间,不省栈。数组长度 100 决定了这个版本只适合 n < 100。全局数组默认全零,正好当“还没算过”的标记;结果本身可能是 0 时,这个标记就失效了,需要另开一个数组记状态。
汉诺塔和青蛙跳台阶,递归适合什么样的题
汉诺塔的规则是每次移动一个盘、大盘不能压小盘。把 n 个盘从 from 搬到 to 的思路是:先把上面 n-1 个搬到中转柱,再把最大的一个搬过去,最后把 n-1 个从中转柱搬到目标柱。三步里两步是同样的子问题:
void Hanoi(int n, char from, char to, char via)
{
    if (n == 0)
    {
        return;
    }
    Hanoi(n - 1, from, via, to);
    printf("%c -> %c\n", from, to);
    Hanoi(n - 1, via, to, from);
}
n 个盘需要 2^n - 1 次移动,n 到 20 就是一百万次,n 到 30 是十亿次。递归把“怎么搬”描述得和规则本身一样,迭代版本则要自己维护一个显式的栈,代码会立刻变长。
青蛙跳台阶是斐波那契换了说法:跳到第 n 级,最后一步只能来自 n-1 级(跳一级)或 n-2 级(跳两级),所以方案数满足 f(n) = f(n-1) + f(n-2),f(1) = 1,f(2) = 2。从前往后算同样三个变量够用:
long long Jump(int n)
{
    long long a = 1;
    long long b = 2;
    long long c = 0;
    int i = 0;

    if (n == 1)
    {
        return 1;
    }
    if (n == 2)
    {
        return 2;
    }
    for (i = 3; i <= n; i++)
    {
        c = a + b;
        a = b;
        b = c;
    }
    return c;
}
递归适合“整体由同构的小整体组成”的问题:树由根和左右子树组成,目录由子目录组成,汉诺塔的搬法由两个更小规模的搬法组成。这类问题用递归写,代码和定义几乎同形。阶乘、斐波那契、跳台阶这类线性递推,迭代更直接:每层调用的压栈、跳转、恢复现场,在问题本身没有重叠子问题的时候,全是白付的开销。
还没有评论 — 第一条由你来留。