struct S  { char c; int i; };
union Un { char c; int i; };成员完全一样,sizeof(struct S) 是 8,sizeof(union Un) 是 4。区别只有一句:结构体的成员排队占位,联合体的成员从同一个地址开始叠放。
联合体的成员从同一个地址开始
#include <stdio.h>

union Un
{
    char c;
    int i;
};

int main(void)
{
    union Un un = {0};

    un.i = 0x11223344;
    printf("%p %p %p\n", (void *)&un, (void *)&un.i, (void *)&un.c);

    un.c = 0x55;
    printf("%x\n", (unsigned)un.i);   /* 11223355 */

    return 0;
}三个地址一模一样,sizeof(un) 是 4。联合体只给最大的成员分配空间,所有成员共用这一块。
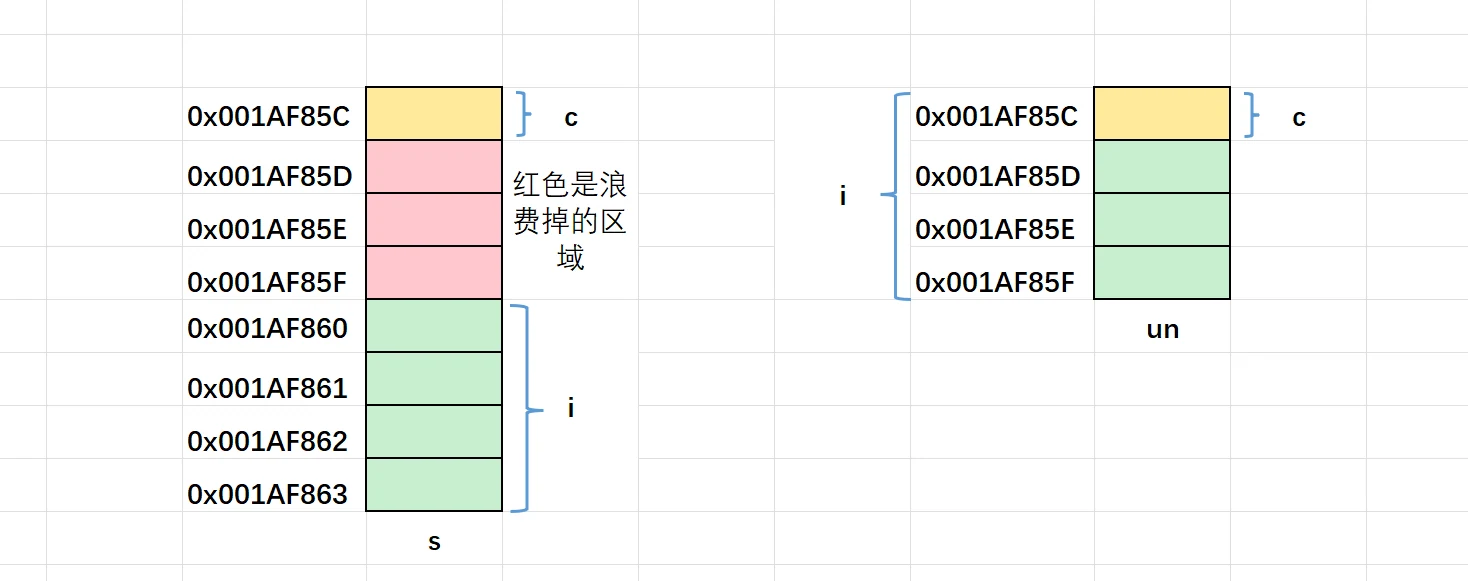
课件这里写的是“将 i 的第 4 个字节的内容修改为 55”。数法不对。c 在偏移 0,小端机器上偏移 0 恰好是 i 的最低有效字节,所以 0x11223344 变成 0x11223355;换到大端,偏移 0 是最高有效字节,同样的代码得到 0x55223344。改的是哪一段,由字节序决定,不是“第几个字节”这种从 1 开始的数法。
给一个成员写、从另一个成员读,这种操作叫类型双关(type punning)。严格按标准,读的成员不是最后写入的那个时,结果由实现定义;主流编译器都按共享字节来解释,但换平台前要确认。
结构体排队,联合体叠放
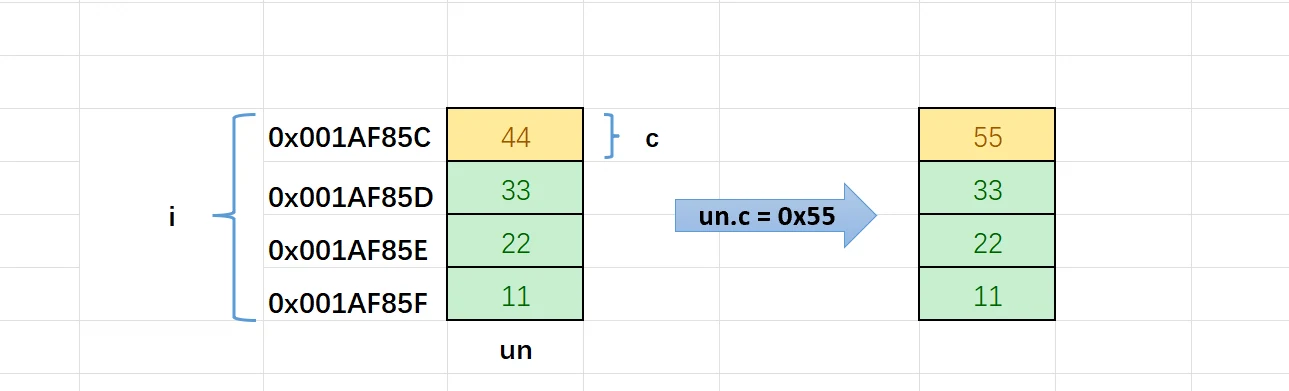
同一个 struct S,&s.c 和 &s.i 相差 4;同一个 union Un,&un.c、&un.i、&un 全是同一个地址。结构体为每个成员各留一份空间,联合体只留最大的那一份。
联合体也因此只能同时保存一个成员的值。写 i 之后 c 的值就跟着变了,因为它们本来就是同一段字节的不同读法。
联合体的大小:最大成员,再按对齐补
两条规则:
- 联合体大小至少是最大成员的大小。
- 最大成员的大小不是最大对齐数的整数倍时,补到整数倍。
#include <stdio.h>

union Un1
{
    char c[5];
    int i;
};

union Un2
{
    short c[7];
    int i;
};

int main(void)
{
    printf("%zu %zu\n", sizeof(union Un1), sizeof(union Un2));   /* 8 16 */
    return 0;
}| 联合体 | 最大成员 | 最大成员字节 | 最大对齐 | 补齐后 |
|---|---|---|---|---|
Un1 | char c[5] | 5 | 4(int) | 8 |
Un2 | short c[7] | 14 | 4(int) | 16 |
Un1 的 5 字节要补到 4 的倍数,得 8;Un2 的 14 字节补到 4 的倍数,得 16。对齐规则和结构体一样,只是没有成员之间的填充,只补尾部。
用第一个字节判大小端
写 1 进去,读最低地址的那个字节:
int check_endian(void)
{
    union
    {
        unsigned int i;
        unsigned char c[4];
    } probe;

    probe.i = 1u;
    return probe.c[0] == 1;   /* 1 小端,0 大端 */
}
小端机器上 1 的最低字节落在最低地址,c[0] 是 1;大端机器上最低地址放的是最高字节,c[0] 是 0。这里用 unsigned char c[4] 而不是课件的 char c:char 是否有符号由实现决定,用无符号类型读出来的值更干净,意图也更明确。
想完全避开类型双关,用 memcpy:
#include <stdint.h>
#include <string.h>

int check_endian_memcpy(void)
{
    uint32_t value = 1u;
    uint8_t first = 0;

    memcpy(&first, &value, sizeof(first));
    return first == 1;
}
memcpy 只搬字节,不牵扯类型别名规则,语义由标准保证。
礼品单:互斥的字段才适合叠起来
礼品兑换单里有三种商品,公共属性是库存、价格、类型,各自还有专属信息:图书有书名、作者、页数,杯子有设计图案,衬衫有图案、颜色、尺寸。直接平铺:
struct gift_list
{
    int stock_number;
    double price;
    int item_type;

    char title[20];
    char author[20];
    int num_pages;

    char design[30];
    int colors;
    int sizes;
};
图书用不上 design、colors、sizes,杯子用不上书名和页数,每张单子都为用不到的字段留了空间。把专属属性放进联合体:
struct gift_list2
{
    int stock_number;
    double price;
    int item_type;

    union
    {
        struct { char title[20]; char author[20]; int num_pages; } book;
        struct { char design[30]; } mug;
        struct { char design[30]; int colors; int sizes; } shirt;
    } item;
};
在 x86-64 上,平铺版本 104 字节,联合版本 64 字节。省下的四十个字节不算多,真正值钱的是它把“这三组属性互斥”写进了类型里。
代价是标签要自己维护:写之前先写 item_type,读的时候严格按它分支。
#include <stdio.h>

enum { ITEM_BOOK, ITEM_MUG, ITEM_SHIRT };

struct gift_list2
{
    int stock_number;
    double price;
    int item_type;

    union
    {
        struct { char title[20]; char author[20]; int num_pages; } book;
        struct { char design[30]; } mug;
        struct { char design[30]; int colors; int sizes; } shirt;
    } item;
};

void print_item(const struct gift_list2 *g)
{
    switch (g->item_type)
    {
        case ITEM_BOOK:
            printf("%s %s %d\n",
                   g->item.book.title, g->item.book.author, g->item.book.num_pages);
            break;
        case ITEM_MUG:
            printf("%s\n", g->item.mug.design);
            break;
        case ITEM_SHIRT:
            printf("%s %d %d\n",
                   g->item.shirt.design, g->item.shirt.colors, g->item.shirt.sizes);
            break;
        default:
            break;
    }
}
这就是带标签联合体。标签写错或忘了更新,读到的是另一组字段的字节,编译器不会拦。C11 还允许匿名联合体,成员可以写成 g->book 少一层点号,老编译器可能不认。
枚举:名字和整数绑在一起
枚举把一个类型可能的取值一个个列出来:
enum Day { Mon, Tues, Wed, Thur, Fri, Sat, Sun };
enum Sex { MALE, FEMALE, SECRET };
enum Color { RED, GREEN, BLUE };
{} 里的名字是枚举常量。默认从 0 开始,依次加 1;声明时也可以赋初值:
enum Color2 { RED2 = 2, GREEN2 = 4, BLUE2 = 8 };课件里 enum Sex 的右花括号后面用的是全角分号 ;。那不是 C 的标点记号,编译器会直接报错,改成半角 ;。
枚举常量是普通标识符,遵循块作用域:在函数里声明的枚举,出了函数就看不见。同一作用域里不能有两个重名常量:
enum A { OK };
enum B { OK };   /* 错误:OK 已经声明 */
枚举变量可以直接用常量赋值:
enum Color { RED, GREEN, BLUE };

void use_color(void)
{
    enum Color clr = GREEN;

    clr = 1;   /* C 允许;C++ 不允许,需要显式转换 */
}
课件自己就写了这一点:C 里可以拿整数给枚举变量赋值,C++ 的类型检查更严。所以 C 的枚举挡不住 clr = 42。
枚举类型的大小不是“就是 4 字节”。C23 之前,枚举常量的类型是 int,枚举类型本身有一个“兼容类型”,可能是 int、unsigned int 或 char,由实现选择,常见的编译器给 4 字节,但标准不保证。C23 可以显式写底层类型 enum Small : unsigned char,那时 sizeof 才是 1。
枚举和 #define 的差别
| 对比项 | #define | enum |
|---|---|---|
| 处理阶段 | 预处理阶段替换 | 编译阶段建立标识符 |
| 作用域 | 从定义处到文件末尾或 #undef | 块作用域 |
#if 能否看见 | 能 | 不能 |
| 调试信息 | 没有,只剩替换后的记号 | 有,调试器能显示名字 |
| 类型 | 没有类型 | 常量是 int,类型名可声明变量 |
一个 enum 声明能一次列出多个相关常量,一组取值集中在一处,比一行一个 #define 更容易看出它们属于同一组。
课件把“有类型检查,比 #define 更严谨”列为枚举的优点。这句话在 C 里不成立,同一份课件后面就承认 clr = 1 合法。C 的枚举真正提供的是作用域、调试符号和可读性,不是严格的类型安全;C++ 才拦这种赋值。
课件还说“预处理阶段会删除 #define 定义的符号”。方向对,说法不准:预处理做的是替换,宏名被替换成宏体,宏定义本身不进编译单元的符号表,所以调试器看不到它。说“删除”容易让人以为符号被主动清理了。
需要让预处理器做判断时,只能用宏:
#define LEVEL 2

#if LEVEL >= 2
#define LOG_ENABLED 1
#else
#define LOG_ENABLED 0
#endif
#if 的世界里没有枚举常量,也没有 const 变量。
枚举常见的另一个用法是用 2 的幂表示可以组合的开关:
enum FileFlag
{
    FLAG_READ  = 1 << 0,
    FLAG_WRITE = 1 << 1,
    FLAG_EXEC  = 1 << 2
};

unsigned int flags = FLAG_READ | FLAG_WRITE;   /* 3 */
组合结果不对应任何单个枚举常量,保存它的变量写 unsigned int,比写 enum FileFlag 语义更准确。
如果枚举的数值会被写进文件、发到网络、被另一个程序读走,就显式赋值,并且只在末尾追加。中间插一个成员,后面所有数值都会顺移,旧数据里的 1、2、3 一夜之间换了含义。这和“结构体不要直接 fwrite 到文件”是同一条纪律:内存里的编号给自己看,对外的编号必须自己定义。
联合体管一块内存,让它在不同时刻装不同的东西;枚举管一组整数,让同一个数值在不同位置有不同的名字。前者省空间,后者省脑力,两者都要求一件事:清楚这块内存或这个整数,什么时候会被谁读走。
还没有评论 — 第一条由你来留。