#include <iostream>

double Divide(int a, int b)
{
    if (b == 0)
        throw "Divide by zero condition!";
    return static_cast<double>(a) / static_cast<double>(b);
}

void Func()
{
    int* array = new int[10];
    int len = 0;
    int time = 0;
    std::cin >> len >> time;
    std::cout << Divide(len, time) << '\n';
    delete[] array;
}

int main()
{
    try
    {
        Func();
    }
    catch (const char* msg)
    {
        std::cout << msg << '\n';
    }
}
输入 10 0 之后,Divide 抛出异常,Func 里 delete[] array 那一行不会再执行。清理代码写对了,却没有被执行的机会——异常把控制流从中间截断了。
错误码和异常各管一段
C 语言用返回值报告错误。fopen 失败返回 NULL,malloc 失败返回 NULL,调用方每次都要查。资源一多,失败分支就开始重复:
#include <cstdio>
#include <cstdlib>

int ReadFile()
{
    FILE* file = std::fopen("data.txt", "rb");
    if (file == nullptr)
        return -1;

    char* buffer = static_cast<char*>(std::malloc(1024));
    if (buffer == nullptr)
    {
        std::fclose(file);
        return -2;
    }

    if (std::fread(buffer, 1, 1024, file) == 0)
    {
        std::free(buffer);
        std::fclose(file);
        return -3;
    }

    std::free(buffer);
    std::fclose(file);
    return 0;
}
两个资源已经写了三次清理,每多一个资源,之前所有失败分支都要改。错误码本身也只是编号,调用方还得再查表才知道发生了什么。
异常把两件事拆开:抛出方只负责检测并携带信息,处理方在调用链的某一层集中接住。抛出的对象可以带类型、错误码、消息、甚至上下文数据,比一个 int 表达得多。代价是清理路径不再由“下一行代码”保证,得靠栈展开和对象生命周期。
throw 之后,异常对象住在栈帧外面
throw e; 不是把栈上那个 e 直接交给 catch。运行时会在专门的异常存储区里构造一个异常对象:操作数是左值时拷贝构造一份,是纯右值临时对象时可以直接就地构造,标准允许省略这次拷贝。因此无论抛的是局部变量还是临时对象,catch 拿到的都是独立于原栈帧的一份数据。
抛出之后,当前函数立刻停止,运行时沿着调用链寻找匹配的 catch。每退出一层函数,这一层的自动对象按构造的逆序析构:局部变量、按值传递的参数、临时对象都在名单里;new 出来的堆对象不在,这就是开头那块 array 漏掉的原因。
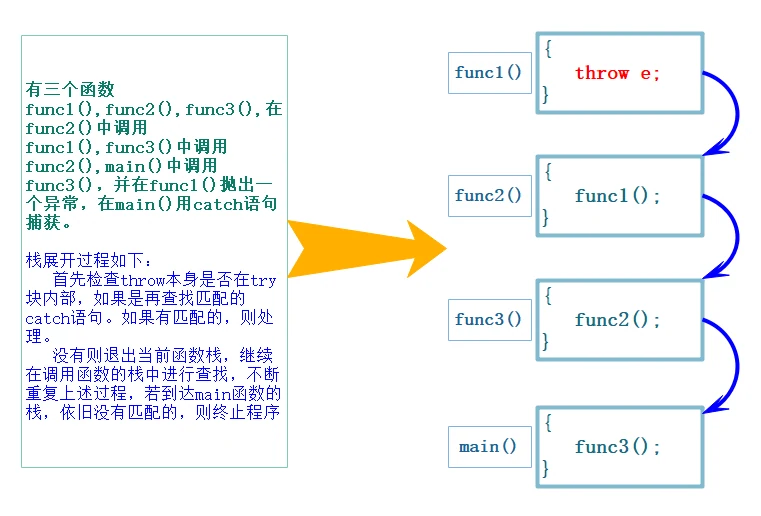
如果退到 main 仍然没有匹配的 catch,程序调用 std::terminate 终止。找到匹配的 catch 后,控制权跳到处理块,从这个块之后继续执行,不会回到抛出点。
推荐“按值抛出、按引用捕获”。抛值时运行时构造完整的异常对象;接的时候用 const T&,不再拷一次,也不会切片。抛指针是坏习惯:
throw new std::runtime_error("boom"); // 谁来 delete?接住一个裸指针就得记得 delete;如果抛的是指向局部对象的指针,栈展开后对象已经销毁,接住的是悬空指针。标准库的异常类型都能拷贝,没有理由自己管异常对象的生命周期。
catch 按书写顺序试,只做少数几种转换
处理块按出现顺序逐个尝试,第一个匹配的赢。匹配规则是:异常对象的类型与处理块类型相同,或者处理块的类型是异常对象类型的无歧义 public 基类;此外只允许从非常量到常量的限定转换、数组到指针、函数到指针、以及标准指针转换。算术转换(int 到 double)和用户自定义转换都不做。
两个直接推论:
#include <iostream>

class BaseError
{
public:
    virtual ~BaseError() = default;
    virtual const char* what() const { return "base"; }
};

class DerivedError : public BaseError
{
public:
    const char* what() const override { return "derived"; }
};

int main()
{
    try
    {
        throw DerivedError();
    }
    catch (const BaseError& e)      // 先写的基类会截胡
    {
        std::cout << "BaseError: " << e.what() << '\n';
    }
    catch (const DerivedError& e)   // 永远轮不到
    {
        std::cout << "DerivedError: " << e.what() << '\n';
    }
}第一,catch 顺序必须从具体到一般,基类写在前面,派生类的分支永远进不去。编译器不会报警,因为语法完全合法。
第二,按值捕获会切片。catch (BaseError e) 只是拿基类拷贝构造了一份,派生类多出来的数据全丢,虚函数也调不到派生类版本。几乎总是写 catch (const Base& e)。
catch (...) 捕获任意类型,但拿不到异常对象,只能知道“出了事”。它适合放在所有具体 catch 之后做兜底,不适合替代具体处理。
重新抛出有两种写法:
catch (const std::exception& e)
{
    if (retry_left == 0)
        throw;        // 重抛当前异常对象,不拷贝,类型不变
    // throw e;    // 再拷一次;e 是基类引用,派生类信息在这一刻丢掉
}
throw; 只能出现在 catch 块里,抛的是正在处理的那个异常对象。
课件开头那段 Divide 里,throw s; 抛的是 std::string,函数内写的是 catch (int errid),Func 里写的是 catch (const char* errmsg),两层都不匹配,最后由 main 的 catch (const string& errmsg) 接住。这不是笔误,是故意让前两层落空,把栈展开的过程演示出来。
自定义异常:一个基类,多个派生
大型项目一般搭一套自己的异常体系:基类带消息和错误码,各模块派生,外层只捕基类。
#include <cstdlib>
#include <iostream>
#include <string>
#include <utility>

class Exception
{
public:
    Exception(std::string msg, int id)
        : _msg(std::move(msg)), _id(id) {}

    virtual ~Exception() = default;

    virtual std::string what() const
    {
        return _msg;
    }

    int getid() const
    {
        return _id;
    }

protected:
    std::string _msg;
    int _id;
};

class SqlException : public Exception
{
public:
    SqlException(std::string msg, int id, std::string sql)
        : Exception(std::move(msg), id), _sql(std::move(sql)) {}

    std::string what() const override
    {
        return "SqlException:" + _msg + " -> " + _sql;
    }

private:
    std::string _sql;
};

class HttpException : public Exception
{
public:
    HttpException(std::string msg, int id, std::string type)
        : Exception(std::move(msg), id), _type(std::move(type)) {}

    std::string what() const override
    {
        return "HttpException:" + _type + ":" + _msg;
    }

private:
    std::string _type;
};

void SendMsg(const std::string&)
{
    if (std::rand() % 2 == 0)
        throw HttpException("网络不稳定,发送失败", 102, "put");
    throw HttpException("对方不是好友,发送失败", 103, "put");
}

void SendWithRetry(const std::string& msg)
{
    for (int i = 0; i < 4; ++i)
    {
        try
        {
            SendMsg(msg);
            return;
        }
        catch (const Exception& e)
        {
            if (e.getid() == 102)
            {
                if (i == 3)
                    throw;                 // 重试次数用完,交给外层
                std::cout << "第 " << i + 1 << " 次重试\n";
            }
            else
            {
                throw;                     // 不是网络问题,直接上交
            }
        }
    }
}

int main()
{
    std::srand(20250501);
    for (int i = 0; i < 5; ++i)
    {
        try
        {
            SendWithRetry("hello");
        }
        catch (const Exception& e)
        {
            std::cout << e.what() << '\n';
        }
        catch (...)
        {
            std::cout << "未知异常\n";
        }
    }
}
Exception 是多态基类,析构函数应该写成虚函数:一旦有人通过基类指针持有或删除派生异常对象,非虚析构只会调用基类那一层。异常对象本身由运行时按抛出类型销毁,但这个基类还可能在别的场景被当成普通多态对象管理。what() 写成虚函数,catch (const Exception&) 才能拿到派生类的描述;按值捕获会切片,虚函数也救不回来。
getid() 这种错误码用来分类处理:102 是网络问题,可以重试;103 不是,直接 throw; 交给外层。重试逻辑写在 catch 里,重抛时用不带操作数的 throw,异常对象和类型原样保留。
noexcept:声明、运算符与 terminate
noexcept 有两种用法。
第一种是异常规格:void f() noexcept; 表示这个函数不会让异常逃出去。编译器不会逐行检查函数体里有没有 throw,它只信这个声明;真抛了,运行时直接调用 std::terminate。
#include <iostream>
#include <stdexcept>

double Divide(int a, int b) noexcept
{
    if (b == 0)
        throw std::runtime_error("divide by zero");
    return static_cast<double>(a) / static_cast<double>(b);
}

int main()
{
    std::cout << noexcept(Divide(1, 2)) << '\n';   // 1
    std::cout << noexcept(Divide(1, 0)) << '\n';   // 1
    int i = 0;
    std::cout << noexcept(++i) << '\n';            // 1
    std::cout << i << '\n';                        // 0
}第二种是运算符:noexcept(表达式)。它的操作数是不求值操作数(unevaluated operand),编译器只检查这个表达式“是否被声明为不抛异常”,不执行它。所以 noexcept(Divide(1, 0)) 仍然是 true,尽管运行时真的走到 throw;noexcept(++i) 是 true,而 i 仍然是 0。课件把 noexcept(expression) 描述成“检测表达式是否会抛出异常”,容易被读成运行期检测,准确的说法是编译期查询异常规格。
Divide(1, 0) 一旦真的执行,异常逃不出 noexcept 函数,程序直接终止,catch 没有机会接住。
C++98 的写法是 throw(类型1, 类型2) 和 throw()。前者在 C++17 被移除,后者从 C++11 起就弃用,效果等同 noexcept。新代码统一写 noexcept。
noexcept 在工程上最重要的作用不是省 try/catch,而是让标准库敢用移动。std::vector 扩容时,如果元素的移动构造标了 noexcept,它搬元素;否则为了强异常保证退回拷贝。一个忘了标 noexcept 的移动构造,可能让整个容器的扩容从“搬指针”退化成“深拷贝”。
异常安全:资源、析构和三个保证
异常抛出后,函数剩下的代码不再执行。前面申请的内存、锁、文件句柄,如果释放写在后面的普通语句里,就会泄漏。第一种修法是捕获、释放、再重新抛出:
#include <iostream>
#include <stdexcept>

void Func()
{
    int* array = new int[10];
    try
    {
        int len = 0;
        int time = 0;
        std::cin >> len >> time;
        if (time == 0)
            throw std::runtime_error("divide by zero");
        std::cout << static_cast<double>(len) / time << '\n';
    }
    catch (...)
    {
        delete[] array;
        throw;
    }
    delete[] array;
}
如果同时 new 了两个数组,第二个 new 自己也可能抛 bad_alloc,清理逻辑就得再套一层。更好的办法是把释放绑在对象生命周期上:
#include <iostream>
#include <memory>
#include <stdexcept>

double Divide(int a, int b)
{
    if (b == 0)
        throw std::runtime_error("divide by zero");
    return static_cast<double>(a) / static_cast<double>(b);
}

void Func()
{
    std::unique_ptr<int[]> array(new int[10]);
    int len = 0;
    int time = 0;
    std::cin >> len >> time;
    std::cout << Divide(len, time) << '\n';
}

int main()
{
    try
    {
        Func();
    }
    catch (const std::exception& e)
    {
        std::cout << e.what() << '\n';
    }
}
这里的 Divide 没有 noexcept。标了 noexcept 的版本一旦抛异常,程序直接终止,根本轮不到栈展开,unique_ptr 的析构也不会执行。
栈展开会析构 array,delete[] 由 unique_ptr 的析构函数执行。锁、文件、连接都该这么包,这就是 RAII(Resource Acquisition Is Initialization)。
析构函数里抛异常要特别小心。C++11 起,隐式声明的析构函数默认是 noexcept,除非某个基类或成员的析构是 noexcept(false)。更严重的是:如果在栈展开期间析构函数抛出异常,运行时直接 std::terminate。课件说析构函数抛异常会导致“后面的资源没释放”,方向对,但后果被低估了:不是少释放几个,是整个进程结束。
~FileHolder()
{
    try
    {
        Close();          // Close 可能抛
    }
    catch (...)
    {
        // 记录日志,绝不让异常逃出析构函数
    }
}
异常安全通常分三级:
| 等级 | 保证 | 典型做法 |
|---|---|---|
| 不抛 | 函数绝不抛出 | noexcept、swap、析构函数 |
| 强保证 | 失败后对象状态不变 | 先构造副本,再交换 |
| 基本保证 | 不泄漏、不破坏不变量 | RAII,先分配后修改 |
赋值运算符想做到强保证,最省心的是“拷贝并交换”:
#include <vector>

class Stack
{
public:
    Stack& operator=(const Stack& other)
    {
        if (this != &other)
        {
            Stack tmp(other);
            Swap(tmp);
        }
        return *this;
    }

    void Swap(Stack& other) noexcept
    {
        _data.swap(other._data);
    }

private:
    std::vector<int> _data;
};
副本构造失败时抛 bad_alloc,*this 根本没被碰过;Swap 只交换指针和整数,标 noexcept 不会失败。反过来,“先 delete 旧数据再 new 新数据”,一旦 new 失败,对象就半死不活。
异常不是零成本,但也不是处处昂贵。主流实现下,不抛异常的路径几乎没有额外指令,抛出路径才要构造对象、查表、展开栈。把异常当普通控制流用,比如用 throw 跳出循环,成本会很明显。嵌入式或禁用异常的环境常用 -fno-exceptions,这时标准库的异常接口行为由实现决定。
异常不能穿过 C 调用栈,也不能穿过线程边界。给 C 接口导出的函数,边界上必须 catch (...) 再转成错误码。
标准库的异常体系
C++ 标准库有一套异常继承体系,基类是 std::exception:
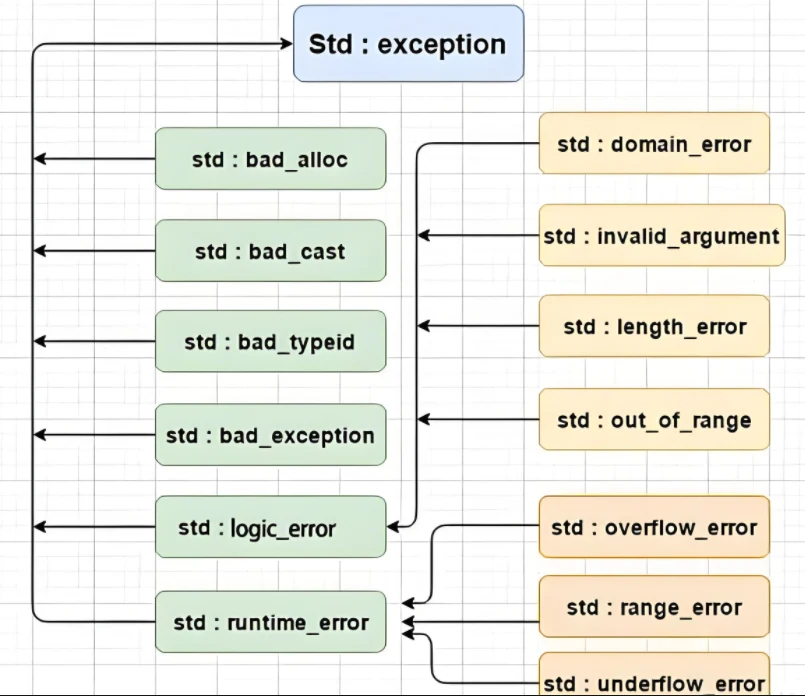
what() 是虚函数,派生类可以重写,返回一段描述性字符串;它的声明带 noexcept,重写时也要保持这个规格。日常程序在 main 里 catch (const std::exception& e) 再打印 e.what(),就覆盖了大部分标准库抛出的错误。
下标访问的差异也在这个体系里:v[10] 不做边界检查,越界是未定义行为,不抛异常;v.at(10) 抛 std::out_of_range。异常只能保护愿意报告错误的接口,operator[] 的契约要求调用方保证下标合法。
取舍在于错误是否属于预期内的事件。异常适合“不该发生”的错误:内存耗尽、不变量被破坏、库内部出错。用户输入格式不对、文件不存在这类预期内的失败,返回错误码、std::optional 或者 std::expected 更直接,调用方也不用猜哪一层会抛。边界写清楚,异常才帮忙;写不清楚,它就是团队里最难查的那类问题。
还没有评论 — 第一条由你来留。