C++11 在 2011 年 8 月由 ISO 采纳,距离 C++98 隔了 8 年,是版本间隔最长的一次。此后标准改成每三年一版:C++14、C++17、C++20、C++23。这些特性横跨语言核心和标准库,但都在回答同一个问题:对象在什么时候被构造、被拷贝、被搬走。
{} 统一了初始化,也抢走了 () 的重载
C++98 的花括号只能用于数组和聚合体,类对象不行。C++11 把它扩成列表初始化(list-initialization),内置类型和自定义类型都能用,还可以省略 =:
#include <initializer_list>
#include <iostream>
#include <map>
#include <string>
#include <vector>

struct Point
{
    int x;
    int y;
};

class Date
{
public:
    Date(int year = 1, int month = 1, int day = 1)
        : _year(year), _month(month), _day(day) {}

    Date(const Date& d)
        : _year(d._year), _month(d._month), _day(d._day)
    {
        std::cout << "Date(const Date&)\n";
    }

private:
    int _year;
    int _month;
    int _day;
};

int main()
{
    int a1[] = {1, 2, 3, 4, 5};
    Point p = {1, 2};

    int x1 = {10};
    int x2{20};

    Date d1 = {2025, 1, 1};
    const Date& d2 = {2024, 7, 25};
    Date d3 = 2025;
    Date d4{2024, 7, 25};

    std::vector<Date> v;
    v.push_back({2025, 1, 1});

    std::map<std::string, std::string> dict = {
        {"sort", "排序"},
        {"string", "字符串"}
    };

    std::initializer_list<int> il = {10, 20, 30};
    std::vector<int> v1({1, 2, 3, 4});
    std::vector<int> v2 = {1, 2, 3, 4};
    v2 = {10, 20, 30};
}
Date d1 = {2025, 1, 1}; 的花括号参数直接拿去匹配构造函数,中间那个 Date 临时对象通常不会真的出现。标准允许编译器省略这次拷贝,C++17 起更进一步,纯右值的物化被取消,拷贝构造不再参与。const Date& d2 = {2024, 7, 25}; 绑定的临时对象生命周期被延长到 d2 的作用域;Date d3 = 2025; 走的是单参数隐式转换,构造函数加了 explicit 就编不过。
花括号和圆括号不等价。Date d4(); 会被解析成函数声明,Date d4{}; 才是定义对象。更实用的一条是窄化(narrowing):int x{1.1} 直接编译错误,int x = 1.1 只给警告。想抓“悄悄丢精度”的 bug,花括号比等号严格。
std::vector<int> a(10);   // 十个 0
std::vector<int> b{10};   // 一个元素,值是 10
b 只有一个元素,因为 vector 有一个接收 std::initializer_list 的构造函数,列表初始化的重载决议优先选它。所有 STL 容器都增加了这个构造函数,operator= 也有对应版本,所以 v2 = {10, 20, 30} 能直接改内容。
std::initializer_list 是一个轻量视图,内部通常只有指向数组头和尾的两个指针,元素是 const 的,底层数组的生命周期跟着所在的完整表达式走。不要返回它:
std::initializer_list<int> Bad()
{
    return {1, 2, 3};   // 返回后底层数组已销毁,使用就是悬空
}
元素是 const 还有一个后果:std::vector<std::unique_ptr<int>> v = {std::unique_ptr<int>(new int(1))}; 编不过,因为 unique_ptr 不能拷贝,而列表里的元素只能读、不能移。先建空容器再 emplace_back 逐个构造,是更稳的写法。
课件把 vector<int> v2 = {1,2,3,4,5} 注释成“构造临时对象 + 临时对象拷贝 v2 + 优化为直接构造”。v2 的初始化里没有 vector 临时对象:重载决议选中的就是 initializer_list 构造函数,花括号直接喂给它。前半句描述的是 Date d1 = {2025, 1, 1} 那类“先用花括号构造对象、再拷贝”的路径,两条路径混在一起了。
有名字的右值引用,表达式仍然是左值
左值是表示数据的表达式,有持久状态、存在内存里、可以取地址:变量名、*p、s[0]、前置 ++i。右值是字面量、临时对象、求值过程中产生的结果:10、x + y、fmin(x, y)、string("111")、i++。核心区别是能不能取地址。
C++11 把右值又分成纯右值(prvalue)和将亡值(xvalue):
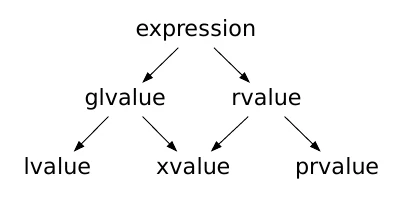
字面量、a + b、i++ 是纯右值;std::move(x) 和 static_cast<T&&>(x) 是将亡值,表示“这个对象还活着,但资源可以被搬走”。泛左值(glvalue)包含左值和将亡值,右值包含纯右值和将亡值。
引用绑定规则:
int b = 1;
int& r1 = b;                 // 左值引用绑左值
// int& r2 = 10;             // 错误:左值引用不能直接绑右值
const int& r3 = 10;          // const 左值引用可以绑右值

int&& rr1 = 10;              // 右值引用绑右值
// int&& rr2 = b;            // 错误:右值引用不能直接绑左值
int&& rr3 = std::move(b);    // move 之后可以绑
const 左值引用和右值引用都能延长临时对象的生命周期:
std::string s1 = "Test";
const std::string& r2 = s1 + s1;   // 临时 string 活到 r2 离开作用域
std::string&& r3 = s1 + s1;        // 同样延长,而且可以修改
std::string&& bad = s1;            // 错误:s1 是左值
变量表达式永远是左值,哪怕它的类型是右值引用。这条规则决定重载决议:
#include <iostream>

void f(int& x)       { std::cout << "左值引用\n"; }
void f(const int& x) { std::cout << "const 左值引用\n"; }
void f(int&& x)      { std::cout << "右值引用\n"; }

int main()
{
    int i = 1;
    const int ci = 2;
    f(i);                 // f(int&)
    f(ci);                // f(const int&)
    f(3);                 // f(int&&)
    f(std::move(i));      // f(int&&)

    int&& rr = 10;
    f(rr);                // 仍然调用 f(int&)
    f(std::move(rr));     // 调用 f(int&&)
}
rr 的类型是 int&&,但 rr 这个表达式是左值,所以匹配 f(int&)。这个设计让“用一次就被搬空”不会悄悄发生:要搬,必须显式写 std::move。
需要说明,std::move 不搬任何东西。它只是一个函数模板,内部做强制类型转换:
template<class T>
typename std::remove_reference<T>::type&& move(T&& t) noexcept
{
    return static_cast<typename std::remove_reference<T>::type&&>(t);
}
返回的是 T 去掉引用后的右值引用。真正的搬运发生在目标类型的移动构造或移动赋值里。课件用 remove_reference_t 写这段实现,那个别名模板是 C++14 才加入的,按 -std=c++11 编译会找不到;写成 typename std::remove_reference<T>::type 才是 C++11 的写法。
移动构造偷的是指针,不是字节
移动构造函数和移动赋值运算符是重载:第一个参数是本类类型的右值引用,移动赋值返回 *this。深拷贝的类才有意义,它们把源对象的资源接过来,再把源对象置空。
#include <cstddef>
#include <cstring>
#include <iostream>
#include <utility>

class Buffer
{
public:
    explicit Buffer(const char* s = "")
        : _size(std::strlen(s)), _data(new char[_size + 1])
    {
        std::memcpy(_data, s, _size + 1);
        std::cout << "Buffer(const char*)\n";
    }

    Buffer(const Buffer& other)
        : _size(other._size), _data(new char[_size + 1])
    {
        std::memcpy(_data, other._data, _size + 1);
        std::cout << "Buffer(const Buffer&)\n";
    }

    Buffer(Buffer&& other) noexcept
        : _size(other._size), _data(other._data)
    {
        other._size = 0;
        other._data = nullptr;
        std::cout << "Buffer(Buffer&&)\n";
    }

    Buffer& operator=(const Buffer& other)
    {
        if (this != &other)
        {
            Buffer tmp(other);
            Swap(tmp);
        }
        std::cout << "operator=(const Buffer&)\n";
        return *this;
    }

    Buffer& operator=(Buffer&& other) noexcept
    {
        if (this != &other)
            Swap(other);
        std::cout << "operator=(Buffer&&)\n";
        return *this;
    }

    ~Buffer() { delete[] _data; }

    void Swap(Buffer& other) noexcept
    {
        std::swap(_size, other._size);
        std::swap(_data, other._data);
    }

    const char* c_str() const { return _data != nullptr ? _data : ""; }

private:
    std::size_t _size;
    char* _data;
};

Buffer MakeBuffer()
{
    Buffer local("local");
    return local;
}

int main()
{
    Buffer b1 = MakeBuffer();
    Buffer b2 = std::move(b1);
    b2 = MakeBuffer();
    std::cout << b2.c_str() << '\n';
}
移动构造只复制两个成员,然后把源对象的指针置空;移动赋值用 Swap,让临时对象替 this 保管旧资源,临时对象析构时释放。拷贝赋值用“拷贝并交换”:先构造一份副本,交换成功后才改 *this,中途抛 bad_alloc 时原对象保持不变。
把 MakeBuffer 的返回值按构造方式拆开,有四种组合;下面三张图覆盖返回值的拷贝、返回值的移动和赋值时的移动,剩下一种赋值场景只是把移动换成拷贝。
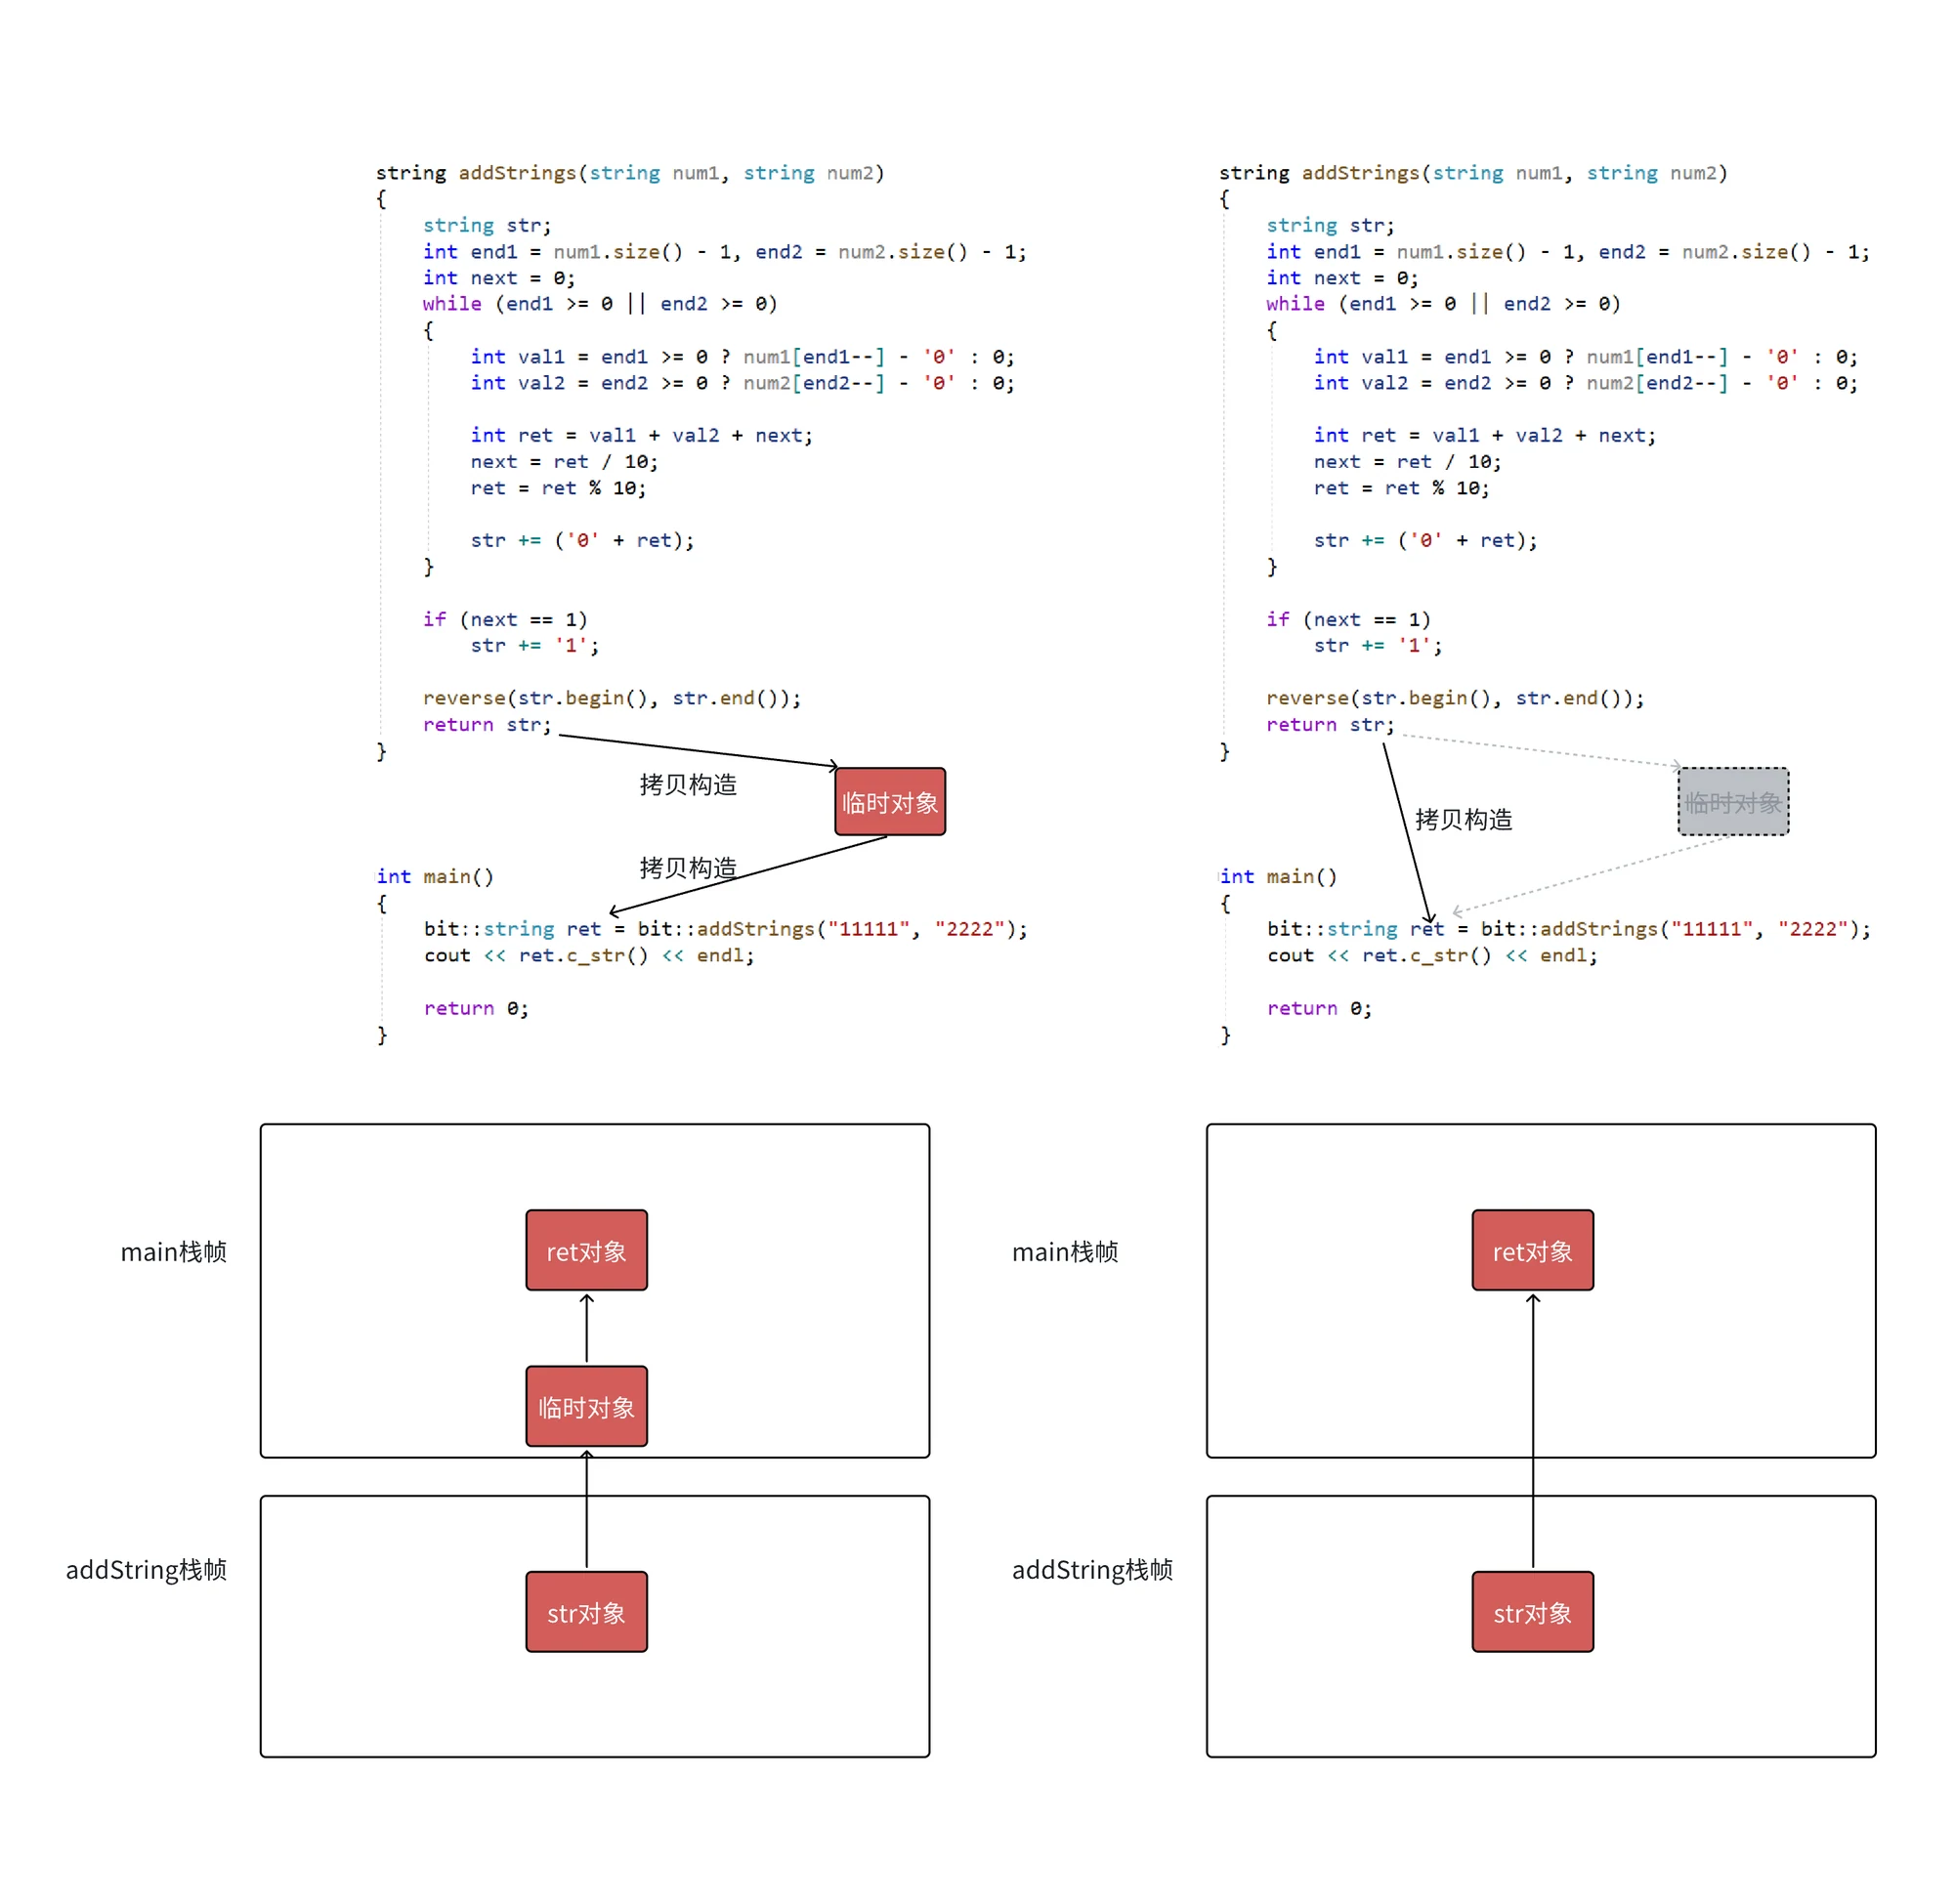
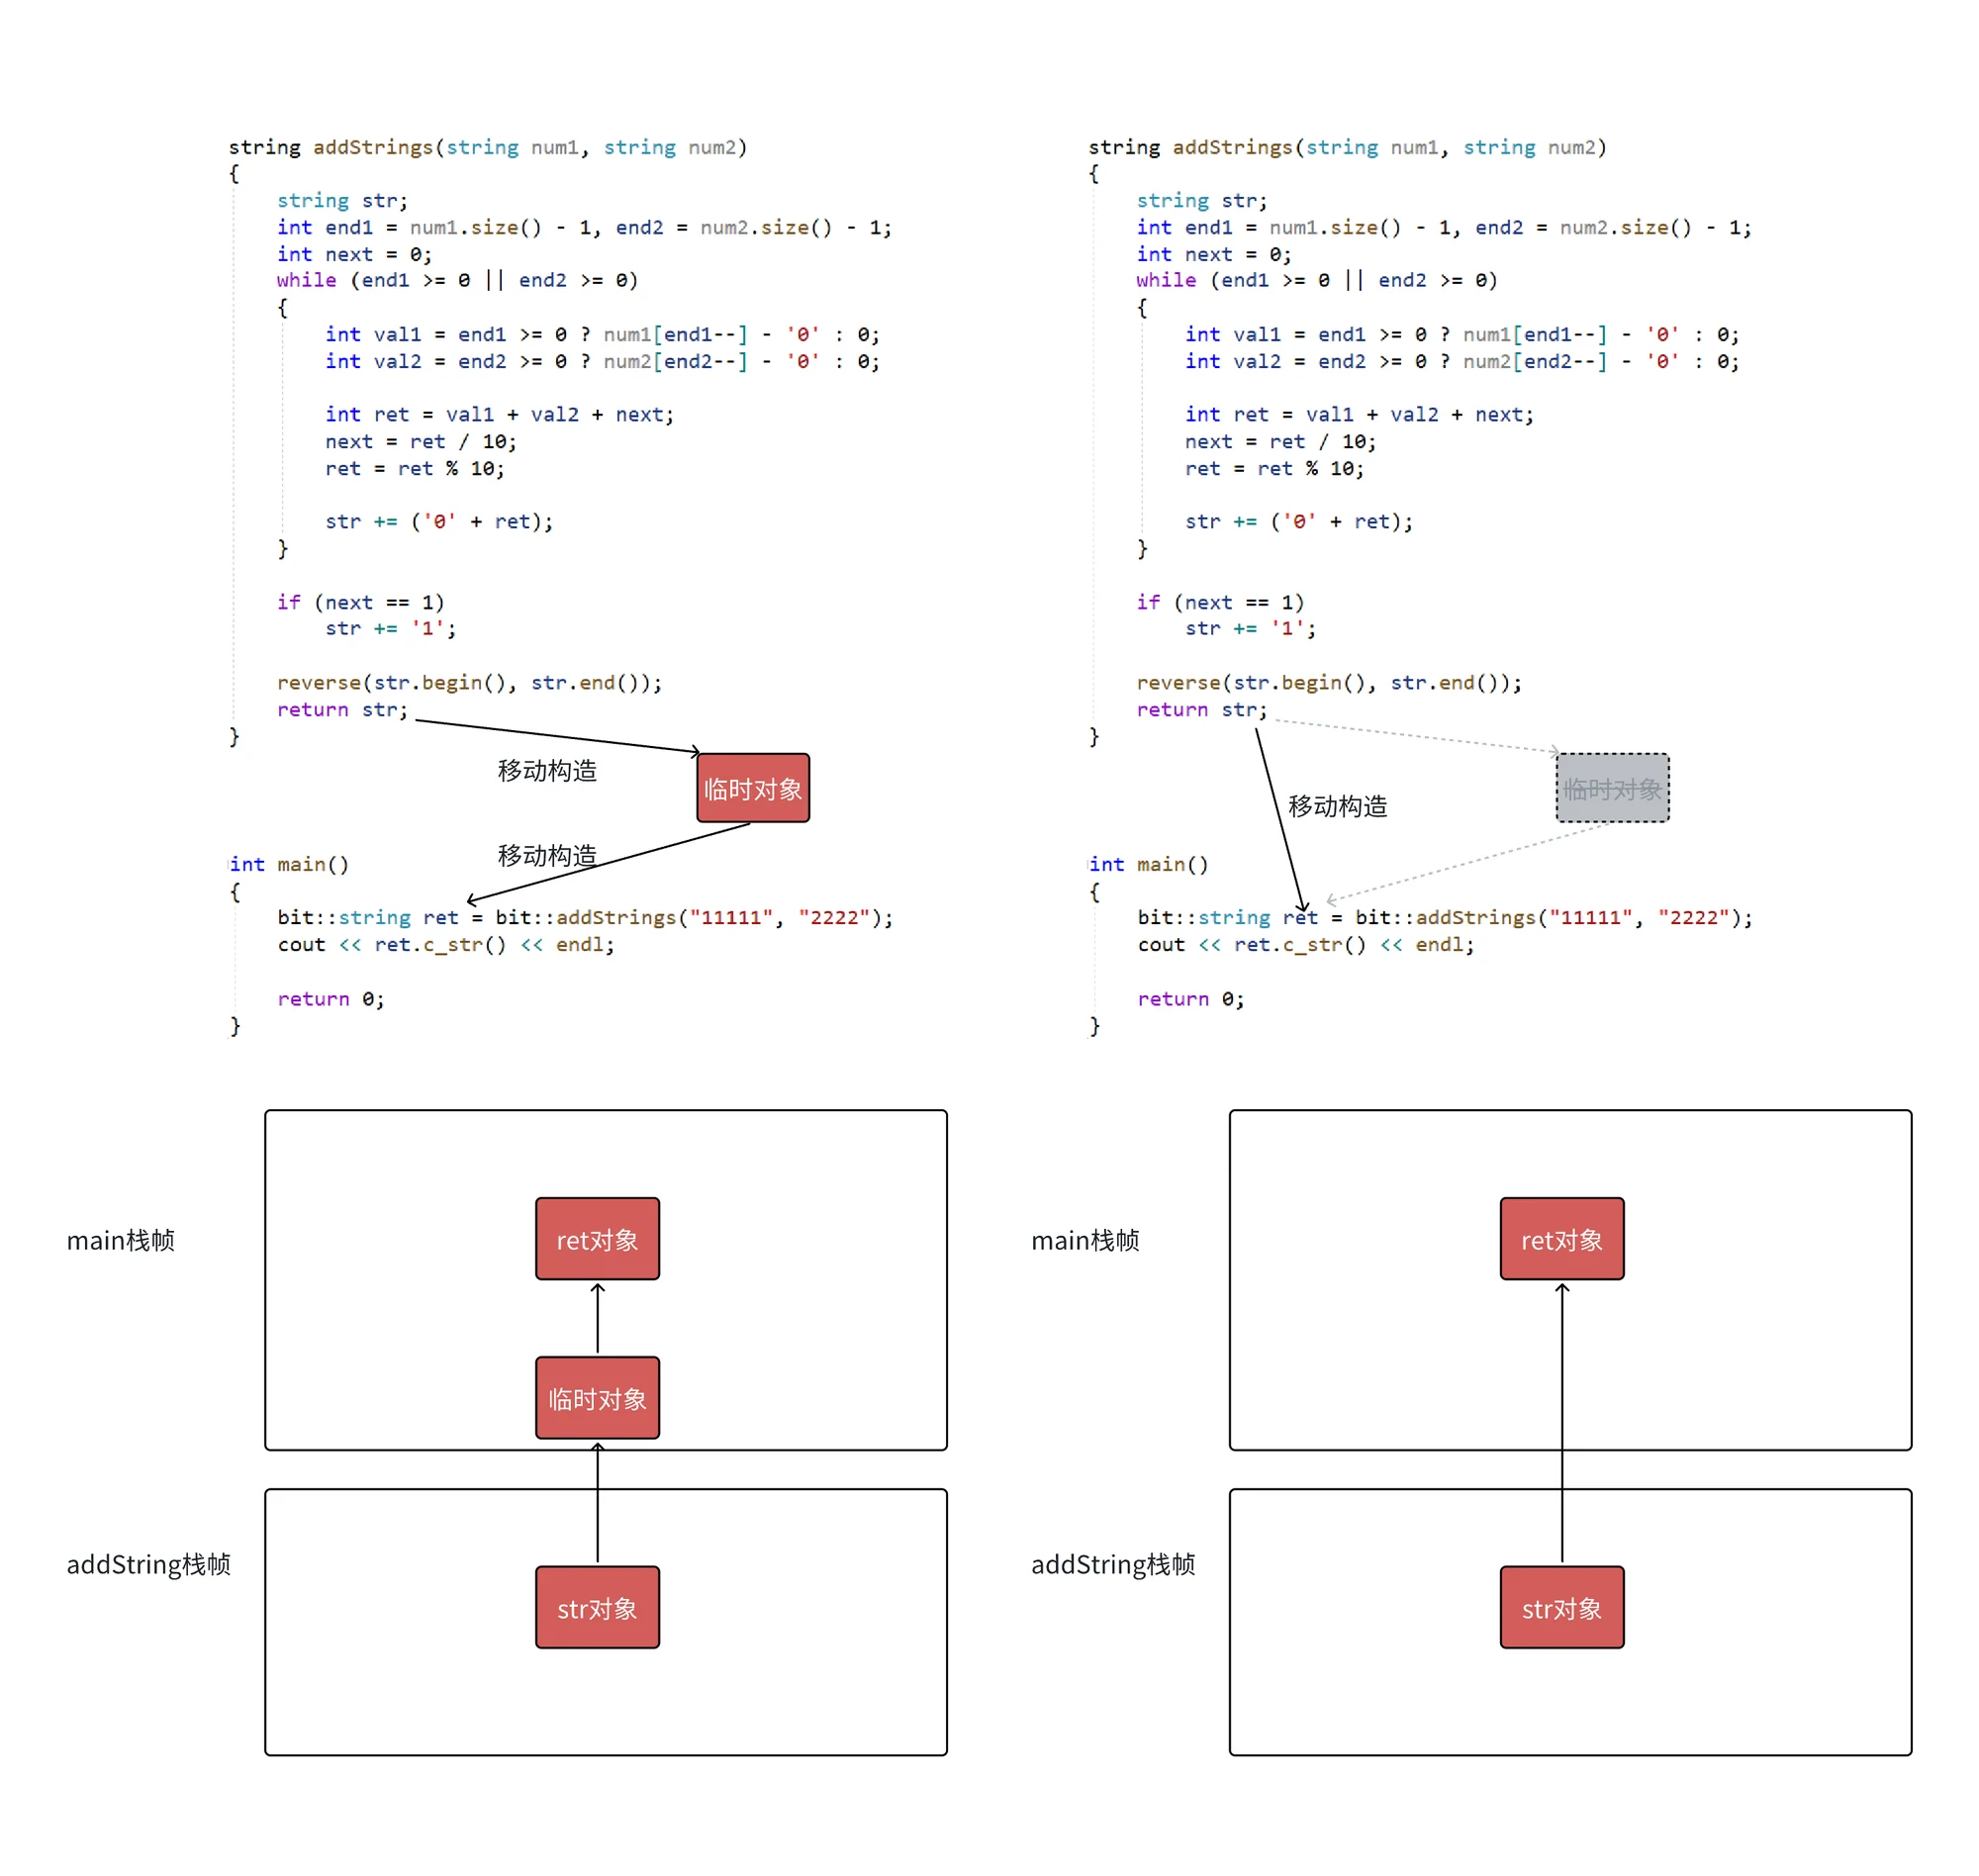
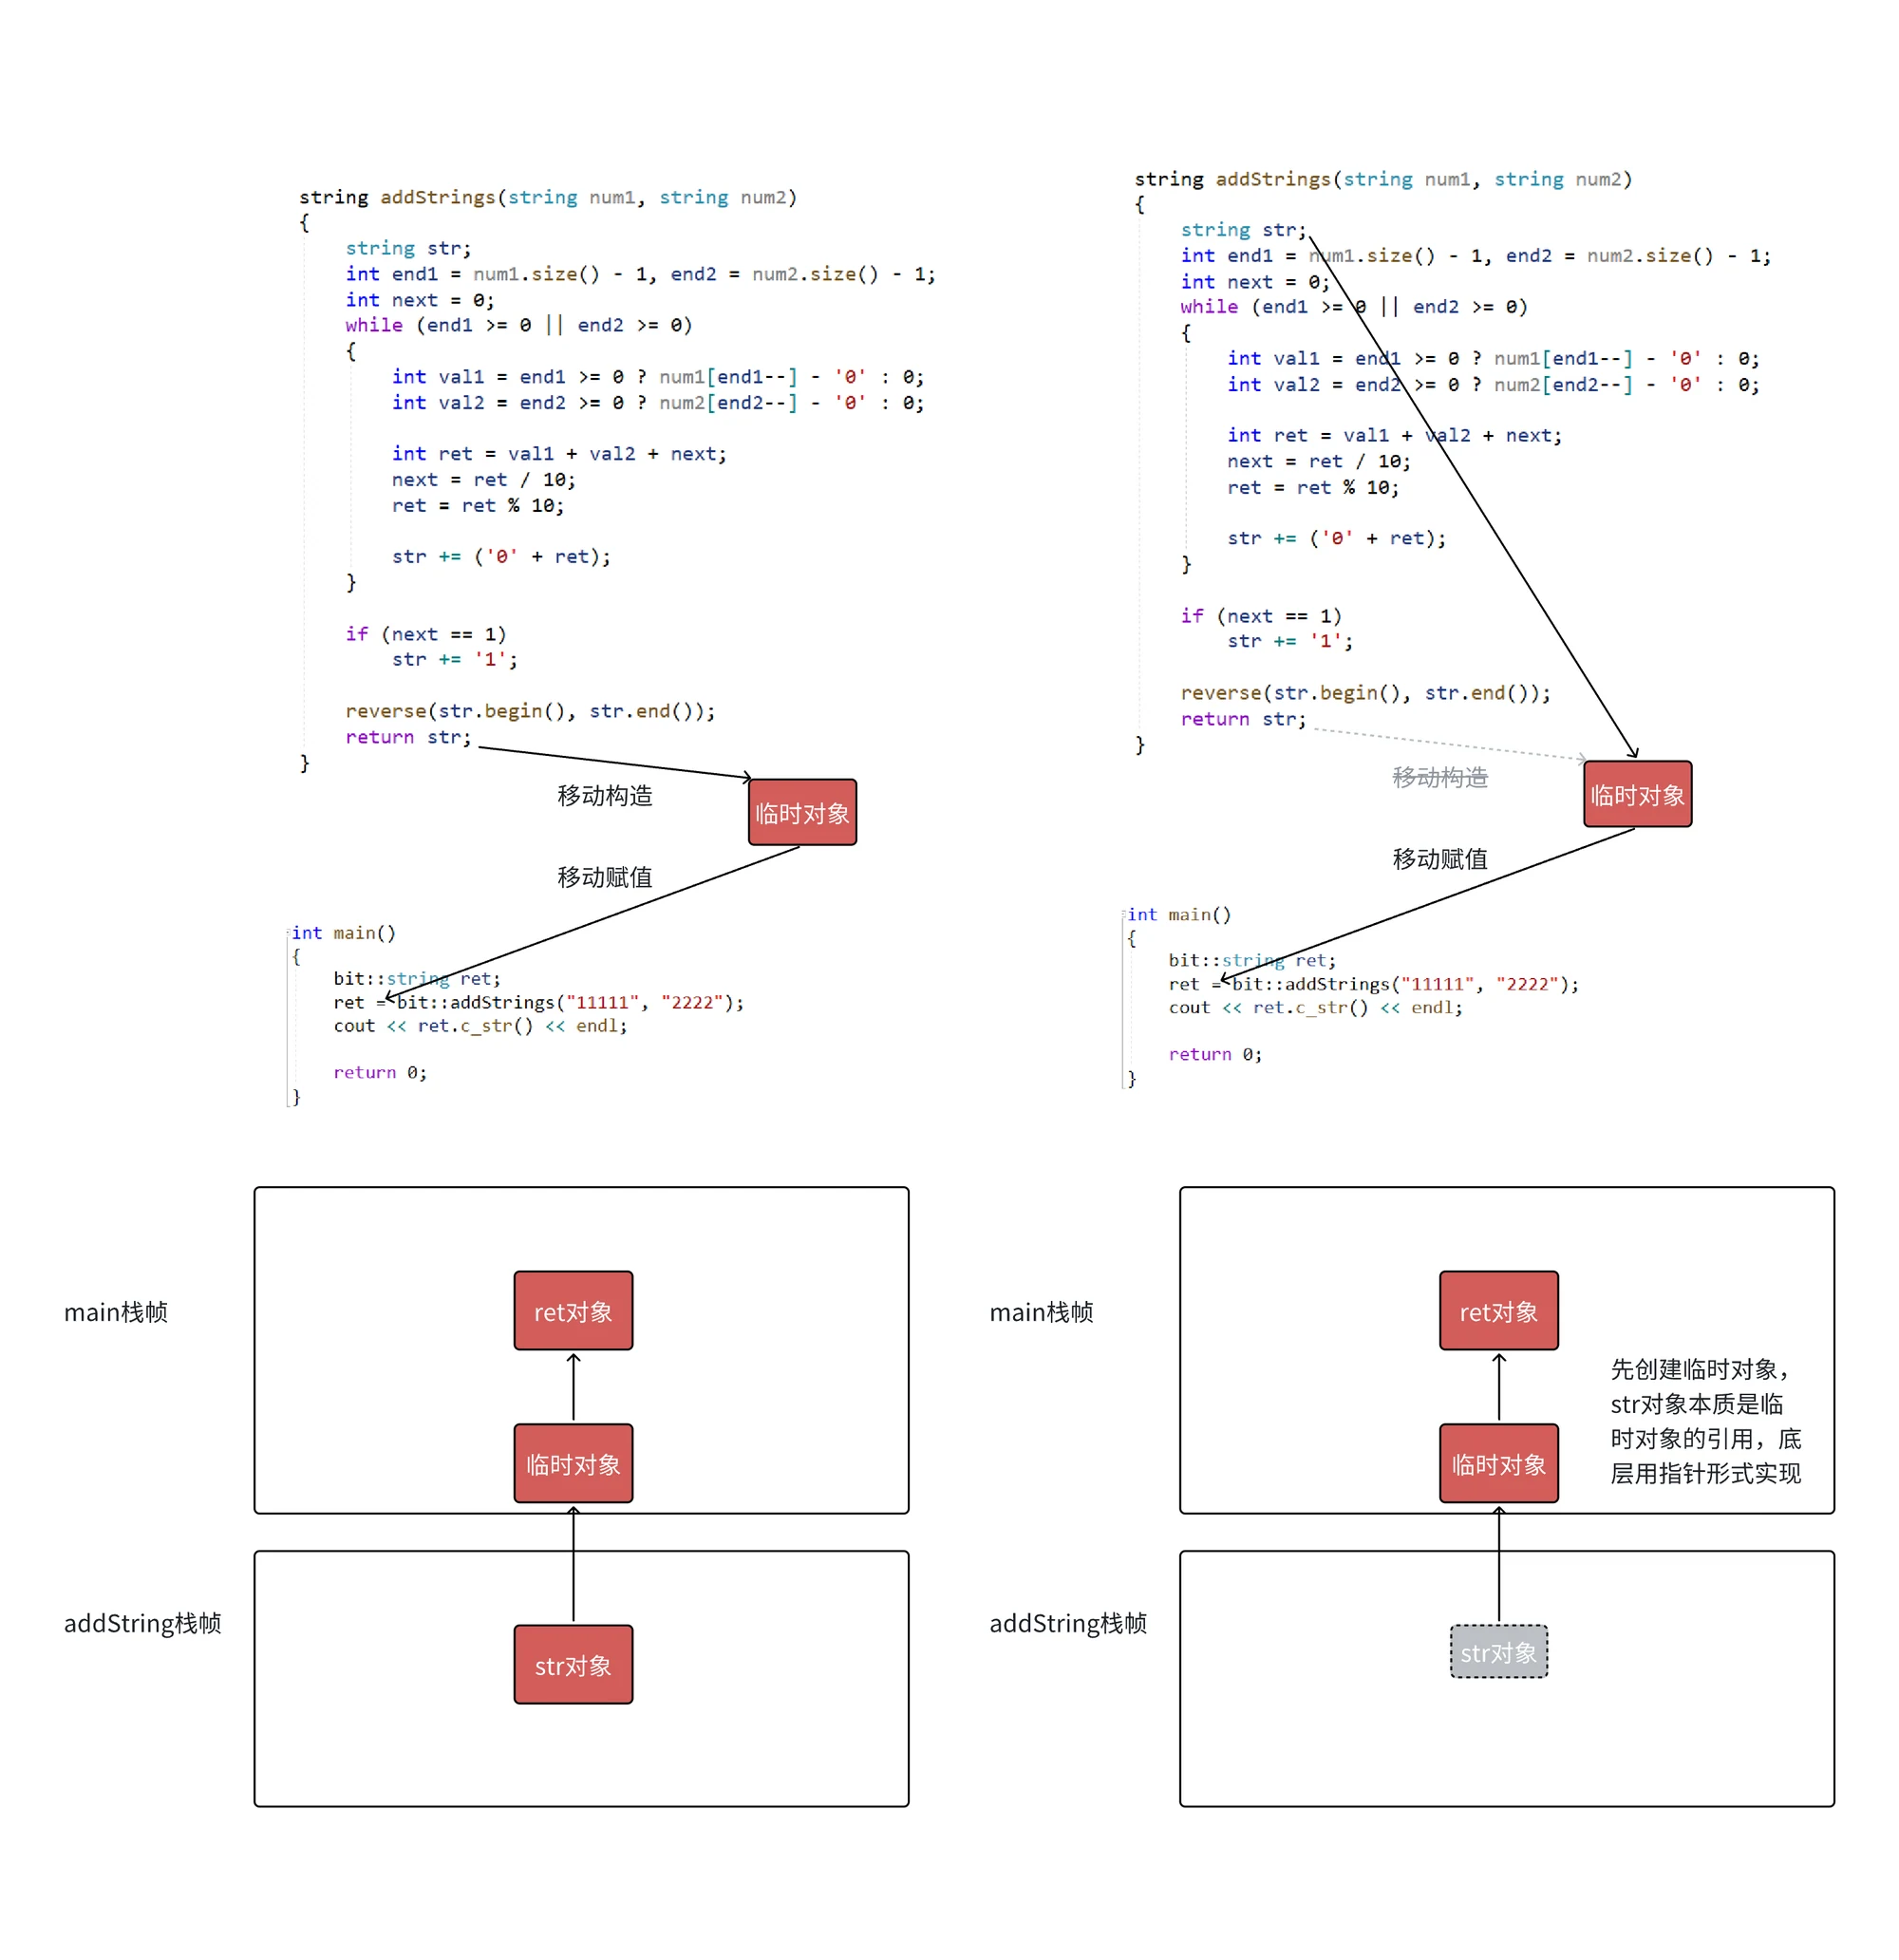
这些条数取决于编译器的省略策略。Linux 下用 g++ test.cpp -fno-elide-constructors 关闭构造省略,能看到左边那串调用;加上优化就变成右边。这里要分清两件事:
- 返回局部变量时的拷贝省略叫 NRVO(named return value optimization),标准只说“允许省略”,编译器可以不做;
- C++17 强制取消的是纯右值的物化,比如
Buffer b = Buffer("x")直接就地构造,这一步标准不再称为 copy elision。
所以“打印出来几次构造”是某次编译的结果,不是语言语义。研究调用序列时,关掉优化并写清楚用的哪个标准。
return std::move(local); 是个负优化。return local; 本身就会按右值匹配移动构造,编译器还允许直接省略;多写一个 std::move,把左值显式变成右值,NRVO 更难做。
四条使用纪律:
- 移动后的源对象只保证“有效但未指定”,标准库对象通常是空的,别把“还能读原值”当规则;
- 别对
const对象std::move。std::move(constObj)的类型是const T&&,移动构造要T&&,匹配不上,最后还是拷贝; - 自移动要防。
obj = std::move(obj)没有this != &other判断时,会先释放自己的资源,再从已释放的指针取值; - 移动构造、移动赋值尽量标
noexcept。std::vector扩容时只有在元素的移动构造声明为不抛异常时才敢移动,否则为了强异常保证退回拷贝。
STL 容器的 push_back、insert 在 C++11 都加了右值引用版本:
void push_back(const value_type& val);
void push_back(value_type&& val);
iterator insert(const_iterator pos, const value_type& val);
iterator insert(const_iterator pos, value_type&& val);实参是左值时走拷贝,是右值时走移动。容器的结点构造函数如果没有右值版本,push_back 传右值时也会退化成拷贝。
T&&、引用折叠与完美转发:参数包和 emplace 的底座
模板里的 T&& 叫转发引用(forwarding reference,旧称万能引用)。模板推导可以产生“引用的引用”,C++11 用引用折叠(reference collapsing)化简:
| 组合 | 折叠结果 |
|---|---|
T& & | T& |
T& && | T& |
T&& & | T& |
T&& && | T&& |
只有“右值引用的右值引用”还是右值引用,其余全折成左值引用。写 template<class T> void f2(T&& x) 时:
- 实参是
int右值,推出T = int,形参是int&&; - 实参是
int左值,推出T = int&,折叠后形参是int&; - 实参是
const int左值,推出T = const int&,形参是const int&。
进了函数体,形参 t 又变成左值。要把原来的值类别传给下一层,必须用 std::forward:
#include <iostream>
#include <utility>

void Target(int&)       { std::cout << "lvalue\n"; }
void Target(const int&) { std::cout << "const lvalue\n"; }
void Target(int&&)      { std::cout << "rvalue\n"; }

template<class T>
void Wrapper(T&& t)
{
    Target(t);                    // 一律按左值传
    Target(std::forward<T>(t));   // 保持原值类别
}

int main()
{
    int i = 1;
    const int ci = 2;
    Wrapper(i);
    Wrapper(ci);
    Wrapper(3);
    Wrapper(std::move(i));
}
std::forward<T>(t) 的本质也是引用折叠加 static_cast。T = int 时转成 int&&,T = int& 时折叠成 int&。不转发,右值属性在函数体里就丢了。
转发引用的另一处用途,是把整个参数包原样传给下一层。可变参数模板支持任意数量的参数,Args... 叫参数包(parameter pack):
template<class... Args> void Func(Args... args) {}
template<class... Args> void Func(Args&... args) {}
template<class... Args> void Func(Args&&... args) {}
sizeof...(args) 在编译期得到包中参数个数。包不能运行时遍历,只能展开:在模式右边放 ...,把包拆成逗号分隔的元素列表。递归展开是最常见的写法:
#include <iostream>
#include <string>

void ShowList()
{
    std::cout << '\n';
}

template<class T, class... Args>
void ShowList(T x, Args... args)
{
    std::cout << x << ' ';
    ShowList(args...);
}

template<class... Args>
void Print(Args... args)
{
    ShowList(args...);
}

int main()
{
    Print();
    Print(1);
    Print(1, std::string("xxxxx"));
    Print(1, std::string("xxxxx"), 2.2);
}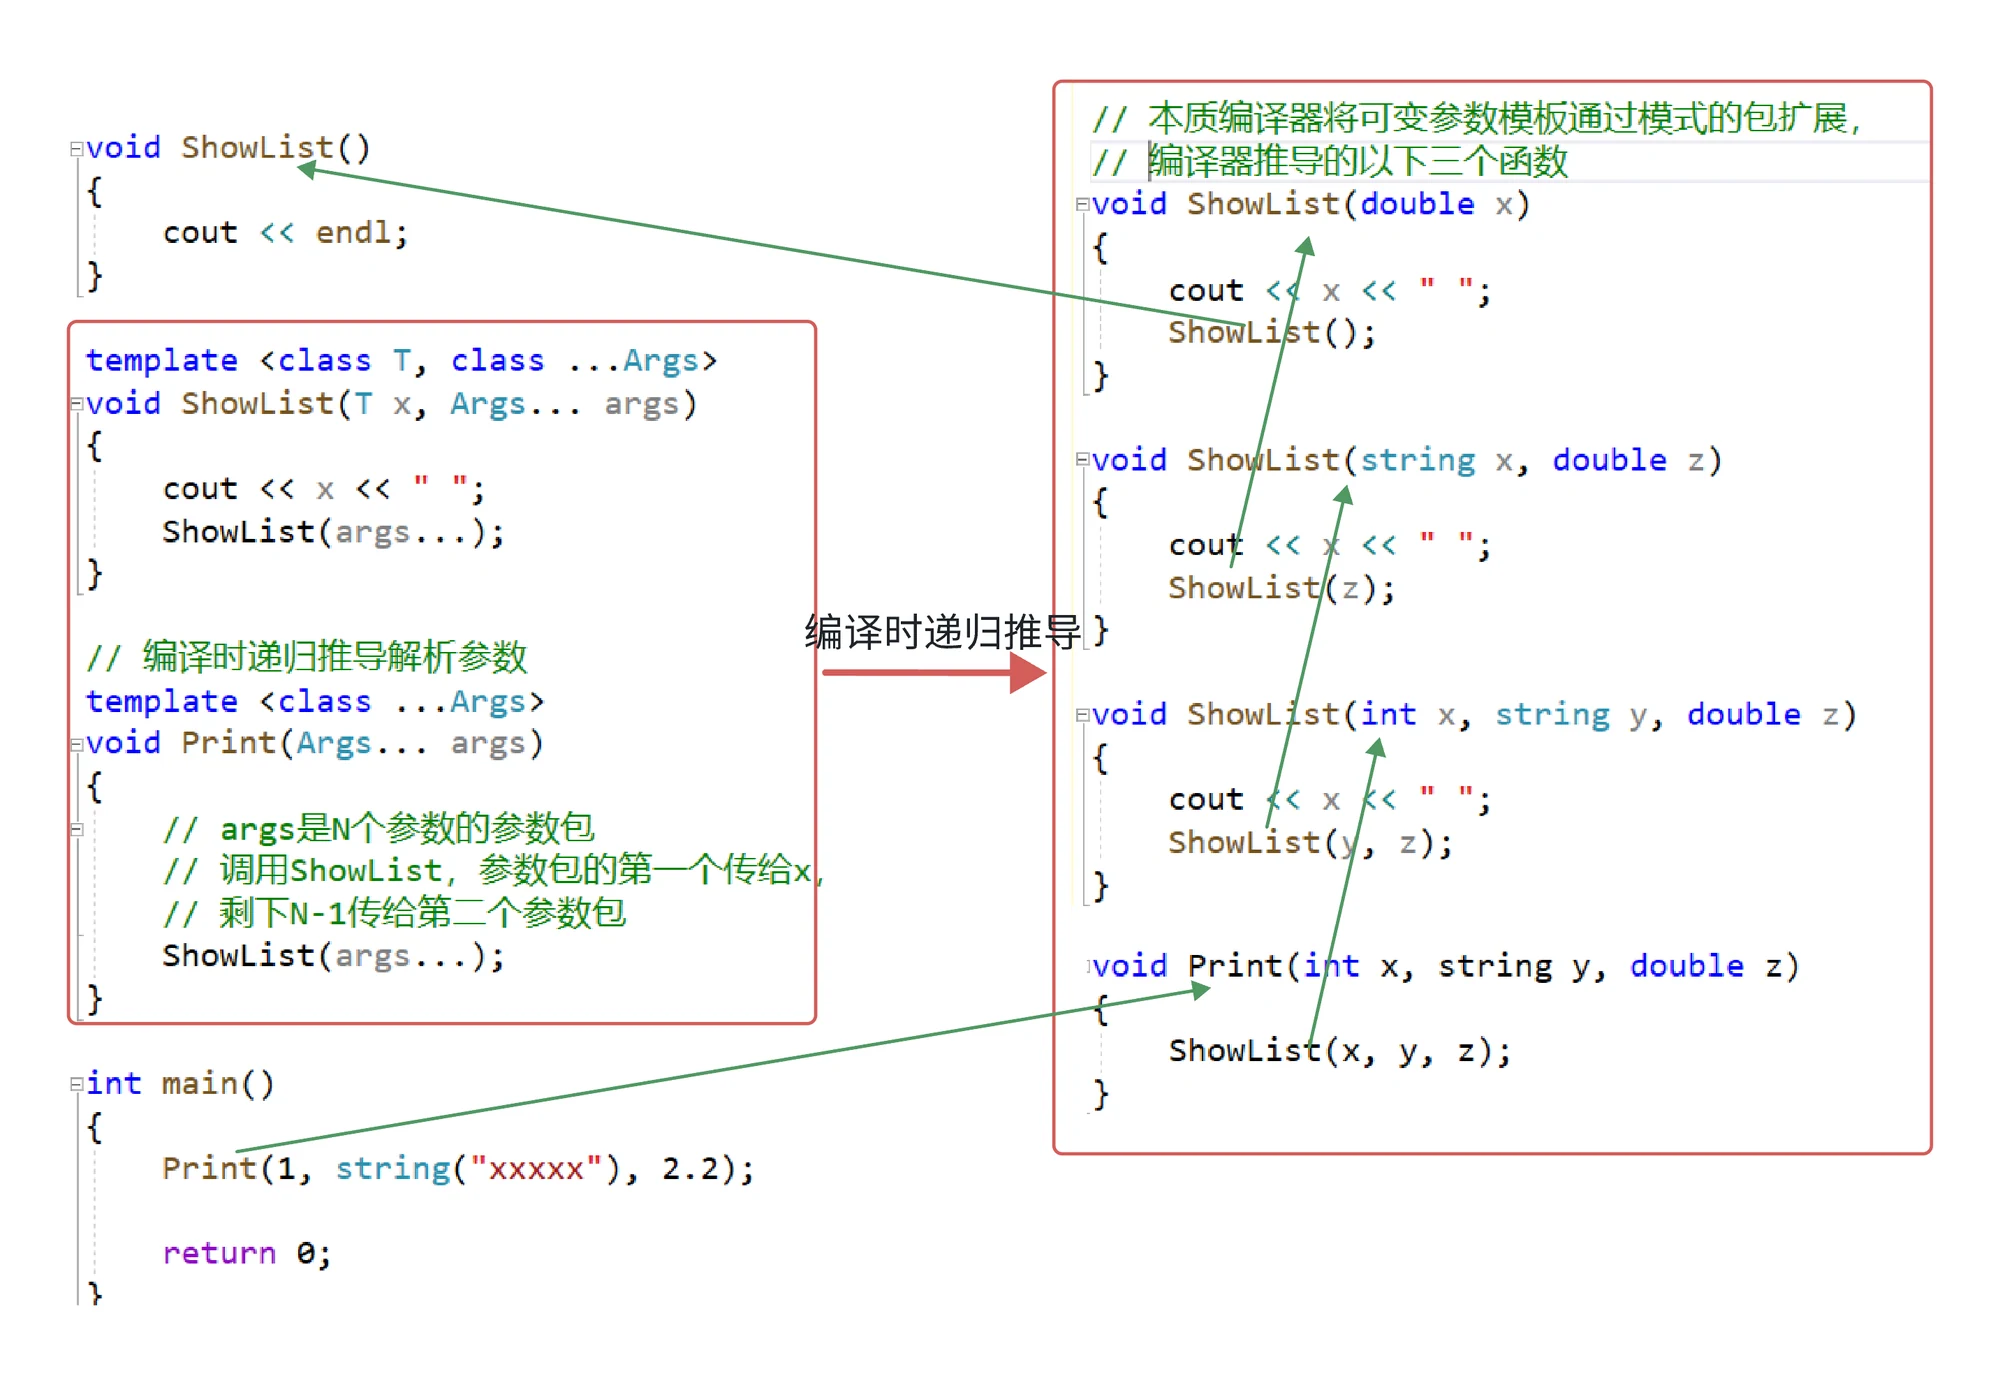
每层实例化都遵守引用折叠。包为空时,非模板的 ShowList() 成为唯一可行重载,递归停下。
包也可以整体展开成另一个函数的实参列表:
template<class T>
const T& GetArg(const T& x)
{
    std::cout << x << ' ';
    return x;
}

template<class... Args>
void Arguments(Args...)
{}

template<class... Args>
void PrintAll(Args... args)
{
    Arguments(GetArg(args)...);
}
GetArg 必须按引用返回,否则返回的临时对象活不到 Arguments 被调用。PrintAll(1, std::string("x"), 2.2) 被展开成 Arguments(GetArg(1), GetArg(str), GetArg(2.2))。C++17 之后折叠表达式 (args + ...) 可以把包直接归约成一个值,但展开成实参列表的写法仍然常用。
emplace 系列就建立在这套机制上:
template<class... Args> void emplace_back(Args&&... args);
template<class... Args> iterator emplace(const_iterator pos, Args&&... args);
push_back 要求先有一个 T 对象,容器再拷或移进结点;emplace_back 把构造参数一路转发到结点内部,直接在容器的内存上构造 T。
#include <iostream>
#include <string>
#include <utility>

namespace bit
{
template<class T>
class MiniList
{
    struct Node
    {
        T _data;
        Node* _next;

        template<class... Args>
        Node(Args&&... args)
            : _data(std::forward<Args>(args)...), _next(nullptr) {}
    };

public:
    MiniList() : _head(nullptr), _tail(nullptr) {}

    ~MiniList()
    {
        Clear();
    }

    MiniList(const MiniList&) = delete;
    MiniList& operator=(const MiniList&) = delete;

    void push_back(const T& value)
    {
        Append(new Node(value));
    }

    void push_back(T&& value)
    {
        Append(new Node(std::move(value)));
    }

    template<class... Args>
    void emplace_back(Args&&... args)
    {
        Append(new Node(std::forward<Args>(args)...));
    }

    void Print() const
    {
        for (Node* cur = _head; cur != nullptr; cur = cur->_next)
            std::cout << cur->_data << ' ';
        std::cout << '\n';
    }

private:
    void Append(Node* node)
    {
        if (_tail == nullptr)
        {
            _head = _tail = node;
        }
        else
        {
            _tail->_next = node;
            _tail = node;
        }
    }

    void Clear() noexcept
    {
        while (_head != nullptr)
        {
            Node* next = _head->_next;
            delete _head;
            _head = next;
        }
        _tail = nullptr;
    }

    Node* _head;
    Node* _tail;
};
}

int main()
{
    bit::MiniList<std::string> lst;
    std::string s = "hello";

    lst.push_back(s);              // 拷贝构造
    lst.push_back(std::move(s));   // 移动构造
    lst.emplace_back("world");     // 直接构造 string
    lst.emplace_back(3, 'x');      // string(3, 'x')
    lst.Print();
}
emplace_back("world") 把 const char* 直接传给 std::string 的构造函数,省掉“先构造 string 再移动”这一步。传递 Args&&... args 时必须写 std::forward<Args>(args)...,否则展开后每个元素以左值传下去,右值属性丢失。
emplace 不是无条件的性能升级。实参已经是 T 左值时,它和 push_back 一样拷贝;是右值时一样移动。它还会绕过 explicit:emplace_back(2025) 能在容器里直接构造只接收 int 的类型,哪怕构造函数原本禁止隐式转换。参数包在容器内部构造,出错时的诊断也比 push_back 难读。
编译器替你生成的函数,多了两个也少了两个
C++98 的六个默认成员函数是构造、析构、拷贝构造、拷贝赋值、取地址重载、const 取地址重载。C++11 增加了移动构造和移动赋值。
默认移动构造的生成条件是:没有自己写移动构造、移动赋值、析构、拷贝构造、拷贝赋值中的任意一个。默认版本对内置类型成员逐成员拷贝,对自定义类型成员,成员有移动构造就调用移动,没有就调用拷贝。默认移动赋值同理。
如果提供了移动构造或移动赋值,拷贝构造和拷贝赋值会被定义为删除(defined as deleted),任何拷贝尝试都编译失败。课件说“不会自动提供”,实际效果比“没有”更硬:重载决议看得见它们,选中后报 deleted。
#include <string>

class Person
{
public:
    Person(const char* name = "", int age = 0)
        : _name(name), _age(age) {}

    Person(const Person&) = default;
    Person& operator=(const Person&) = default;
    Person(Person&&) = default;
    Person& operator=(Person&&) = default;

private:
    std::string _name;
    int _age;
};

class NoCopy
{
public:
    NoCopy() = default;
    NoCopy(const NoCopy&) = delete;
    NoCopy& operator=(const NoCopy&) = delete;
};
= default 让编译器生成默认版本,用在“提供了拷贝构造,移动构造就不会隐式生成”的场景;= delete 让编译器不生成,C++98 的老办法是把函数设成 private 且只声明不定义,C++11 直接写 = delete 更清楚。
成员变量声明处的缺省值是给初始化列表用的:构造函数没有显式初始化该成员时,用这个值。final 修饰虚函数,阻止后续重写;修饰类,阻止继续派生。override 要求函数确实重写了基类的虚函数,签名不一致会直接报错,比“以为重写了、其实隐藏了”安全。
struct Base
{
    virtual void f() {}
    virtual void g() final {}
    virtual ~Base() = default;
};

struct Derived : Base
{
    void f() override {}
};
auto 按初始化表达式推导类型,规则接近模板实参推导,会丢掉顶层 const 和引用;声明时必须初始化。decltype(expr) 给出表达式的声明类型,不求值;表达式加括号会改变结果,decltype(x) 和 decltype((x)) 对左值 x 分别是 T 和 T&。
int i = 0;
const int ci = 1;

auto a = ci;           // int,顶层 const 被丢弃
auto& b = ci;          // const int&
decltype(ci) c = 2;    // const int
decltype((ci)) d = i;  // const int&
范围 for 是迭代器循环的语法糖,for (decl : range) 展开成 begin / end 加 ++ 和 !=。数组、initializer_list、任何提供 begin/end 的类型都能用。想改元素就写 auto&,只读写 const auto&,按值写 auto 会复制一份。遍历过程中不要插入或删除元素,迭代器可能失效。
STL 这一版新增了几个容器:
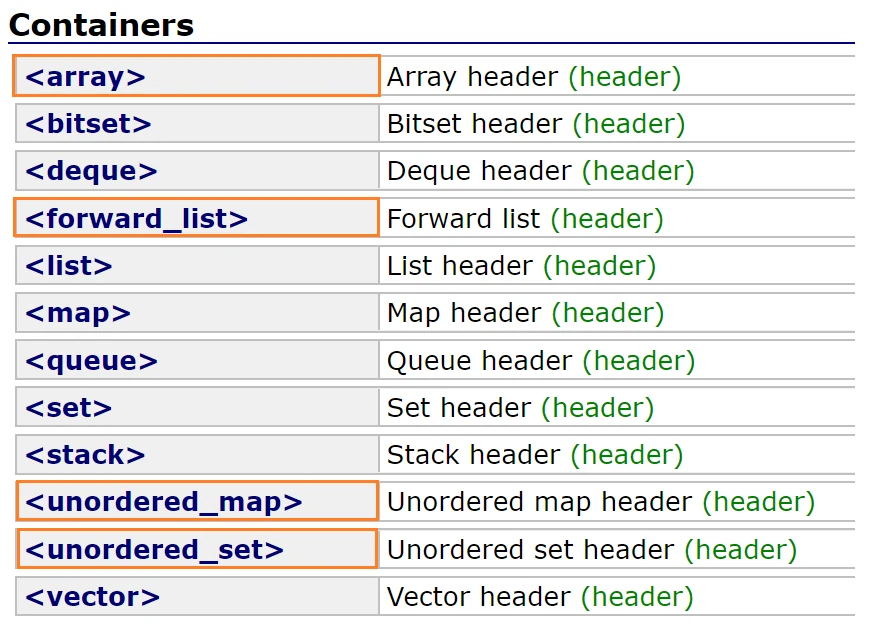
array 是固定大小的数组封装,forward_list 是单向链表,unordered_map 和 unordered_set 是哈希容器。新接口还包括 cbegin/cend、右值引用版本的 push/insert、emplace 系列、initializer_list 构造函数。范围 for 和这些接口组合起来,容器代码比 C++98 短很多。
lambda 是一个匿名的仿函数类
lambda 表达式可以定义在函数内部,语法是:
[capture-list] (parameters) -> return type { function body }捕捉列表不能省,即使为空;参数列表为空可以连同 () 一起省;返回类型可以省,编译器从 return 语句推导;函数体不能省。lambda 没有可写的类型名,用 auto 或模板参数接收。
#include <algorithm>
#include <iostream>
#include <string>
#include <vector>

struct Goods
{
    std::string _name;
    double _price;
    int _evaluate;
};

int main()
{
    std::vector<Goods> v = {
        {"苹果", 2.1, 5},
        {"香蕉", 3.0, 4},
        {"橙子", 2.2, 3},
        {"菠萝", 1.5, 4}
    };

    std::sort(v.begin(), v.end(),
              [](const Goods& a, const Goods& b) { return a._price < b._price; });

    auto add = [](int x, int y) -> int { return x + y; };
    std::cout << add(1, 2) << '\n';

    int a = 0;
    int b = 1;
    auto swap = [](int& x, int& y)
    {
        int t = x;
        x = y;
        y = t;
    };
    swap(a, b);

    double rate = 0.49;
    auto interest = [rate](double money, int year)
    {
        return money * rate * year;
    };
    std::cout << interest(10000, 2) << '\n';
}
捕捉列表有三种写法:
- 显式捕捉:
[x, y, &z],x、y按值,z按引用; - 隐式捕捉:
[=]按值捕捉用到的变量,[&]按引用捕捉用到的变量; - 混合捕捉:
[=, &x]其余按值、x按引用;[&, x, y]其余按引用、x和y按值。第一个元素必须是=或&,而且方向相反的那个只能出现在后面。
lambda 能捕捉定义位置之前、同一作用域内的局部变量;静态局部变量和全局变量不需要捕捉,也不能捕捉,直接使用。定义在全局位置的 lambda,捕捉列表必须为空。
按值捕捉的变量在 lambda 内部默认是 const 的,不能修改。mutable 加在参数列表后面取消这个限制,但改的是 lambda 自己保存的那份拷贝,不影响外面的原变量。加了 mutable 之后参数列表不能省,即使为空也要写 ()。
int a = 0;
auto counter = [=]() mutable
{
    return ++a;
};
原理上,编译器为每个 lambda 生成一个闭包类:类名按规则生成,保证不同 lambda 不冲突;operator() 的参数、返回类型、函数体就是 lambda 的对应部分;捕捉列表变成类的成员变量,按值捕捉是拷贝,按引用捕捉是引用。汇编里看不到 lambda,只看到对一个类调用 operator()。
std::function 把各种可调用对象统一成一种类型:
#include <functional>
#include <iostream>

int add(int a, int b) { return a + b; }

struct Functor
{
    int operator()(int a, int b) const { return a + b; }
};

class Plus
{
public:
    static int plusi(int a, int b) { return a + b; }
    double plusd(double a, double b) { return (a + b) * _n; }

private:
    int _n = 10;
};

int main()
{
    std::function<int(int, int)> f1 = add;
    std::function<int(int, int)> f2 = Functor();
    std::function<int(int, int)> f3 = [](int a, int b) { return a + b; };
    std::function<int(int, int)> f4 = &Plus::plusi;

    Plus p;
    std::function<double(Plus*, double, double)> f5 = &Plus::plusd;
    std::function<double(Plus, double, double)> f6 = &Plus::plusd;
    std::cout << f5(&p, 1.1, 1.1) << ' ' << f6(p, 1.1, 1.1) << '\n';

    std::function<int(int, int)> empty;
    try
    {
        empty(1, 2);
    }
    catch (const std::bad_function_call&)
    {
        std::cout << "empty function\n";
    }
}
包装普通成员函数时,函数的第一个参数是隐含的 this,所以 function<double(Plus*, double, double)> 要显式传对象指针;写 Plus 就传对象,写 Plus&& 就传右值。调用空的 std::function 抛 std::bad_function_call。
std::function 当 map 的值,可以把“字符串到操作”的映射写成表:
#include <functional>
#include <map>
#include <stack>
#include <string>
#include <vector>

int evalRPN(const std::vector<std::string>& tokens)
{
    static const std::map<std::string, std::function<int(int, int)>> ops = {
        {"+", [](int a, int b) { return a + b; }},
        {"-", [](int a, int b) { return a - b; }},
        {"*", [](int a, int b) { return a * b; }},
        {"/", [](int a, int b) { return a / b; }}
    };

    std::stack<int> st;
    for (const std::string& s : tokens)
    {
        auto it = ops.find(s);
        if (it != ops.end())
        {
            int right = st.top();
            st.pop();
            int left = st.top();
            st.pop();
            st.push(it->second(left, right));
        }
        else
        {
            st.push(std::stoi(s));
        }
    }
    return st.top();
}
增加一种运算只需要在 ops 里加一行,不用改 switch。代价是每次调用都经过一次 std::function 的间接调用,热路径上不如 switch。
std::bind 是另一种包装器,用来调整参数个数和顺序:
#include <functional>
#include <iostream>

using std::placeholders::_1;
using std::placeholders::_2;

int Sub(int a, int b) { return (a - b) * 10; }

class Plus
{
public:
    double plusd(double a, double b) { return a + b; }
};

int main()
{
    auto f1 = std::bind(Sub, _1, _2);
    auto f2 = std::bind(Sub, _2, _1);
    auto f3 = std::bind(Sub, 100, _1);

    std::cout << f1(10, 5) << ' ' << f2(10, 5) << ' ' << f3(5) << '\n';

    Plus p;
    auto f4 = std::bind(&Plus::plusd, p, _1, _2);
    std::cout << f4(1.1, 1.1) << '\n';
}
占位符 _1、_2 表示新可调用对象的第几个实参;bind 把它按位置塞回原函数。f2 交换了参数顺序,f3 绑死第一个参数 100。成员函数可以把对象一起绑死,f4 只剩两个参数要传。bind 返回的也是一个仿函数对象,类型由实现定义,用 auto 接。
lambda 和 bind 都能替代手写仿函数。lambda 更适合就地定义小逻辑,bind 更适合把已有函数改造成新签名;两者都别在性能敏感的循环里滥用,间接调用的成本不会因为语法短就消失。
还没有评论 — 第一条由你来留。