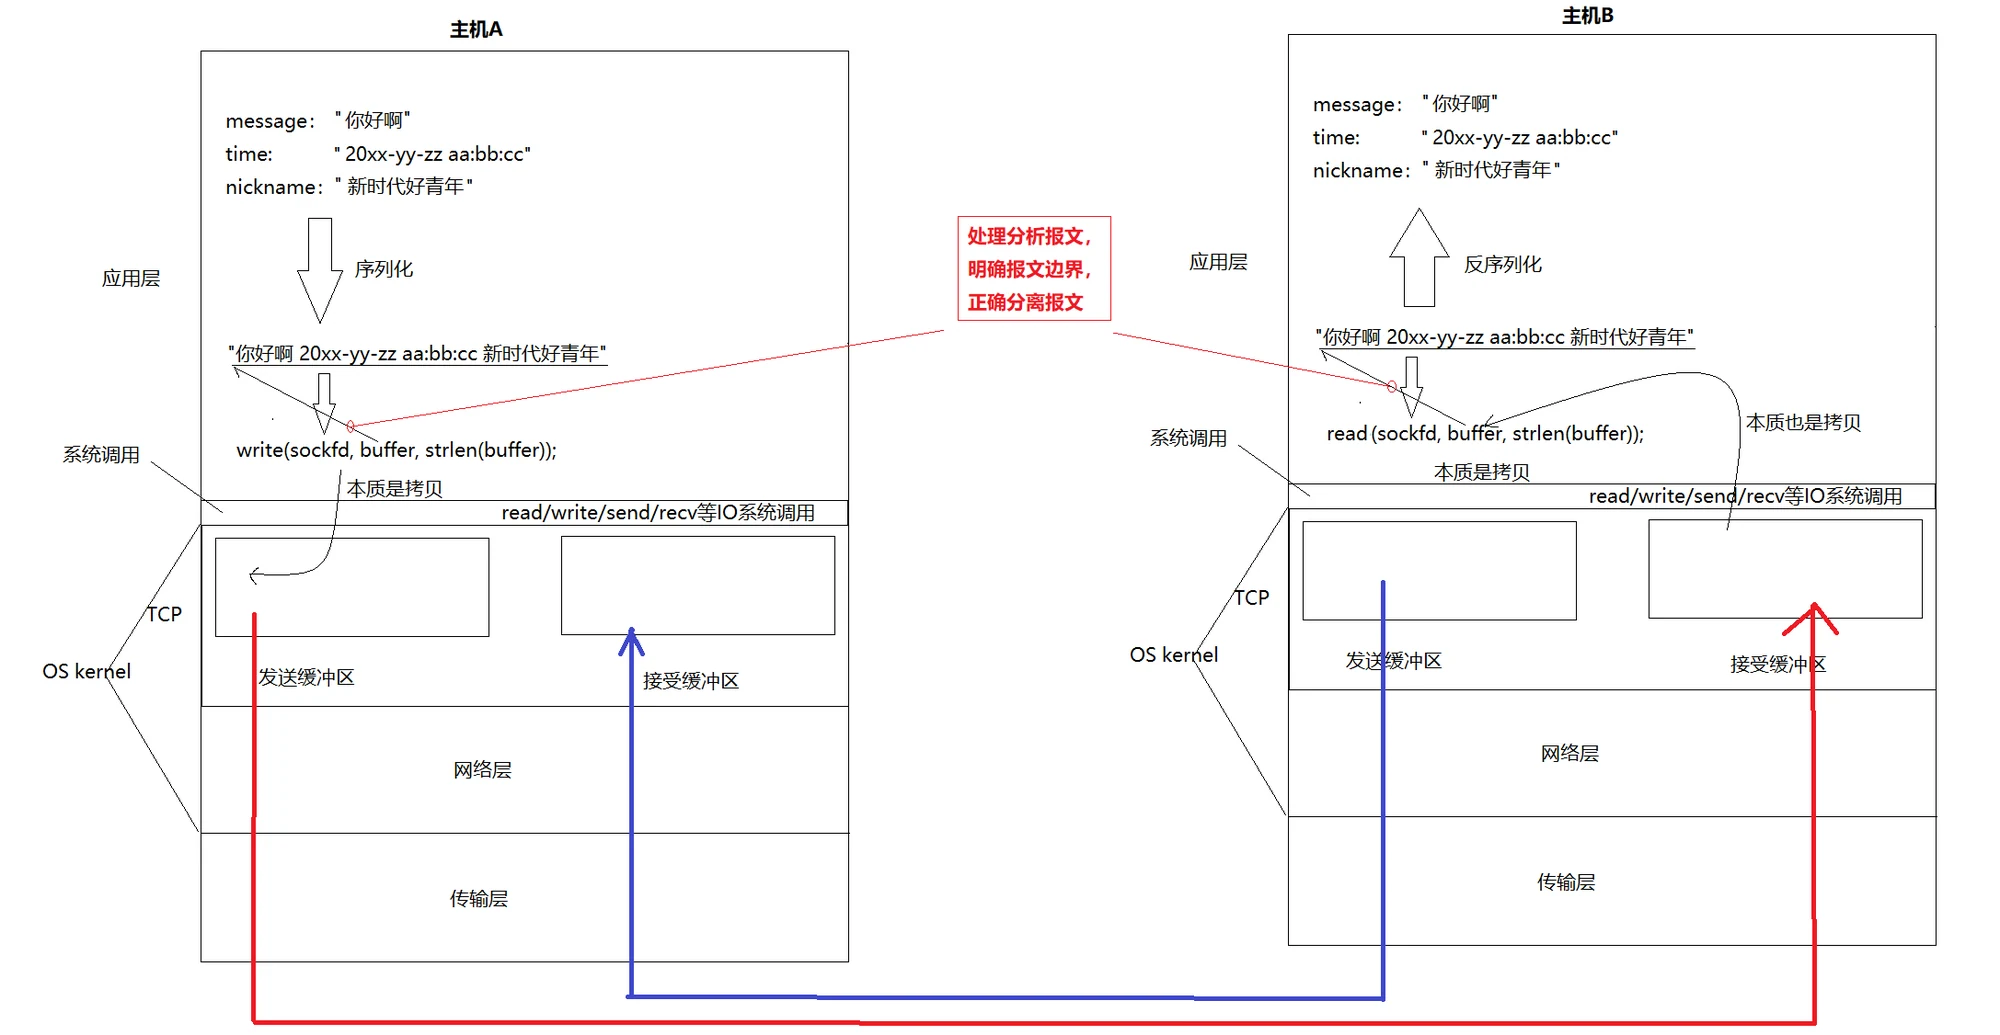
一份报文在网络里被搬了三次,每次都没有"消息"这个概念。应用层把它拼成字符串交给 write,内核拷进发送缓冲区再切成段发出去;另一端的内核按到达顺序拼回字节,read 再把一段内存交给应用。分段、重传、合并全由 TCP 决定,所以对面拿到的是"一段字节",不是"一条消息"。
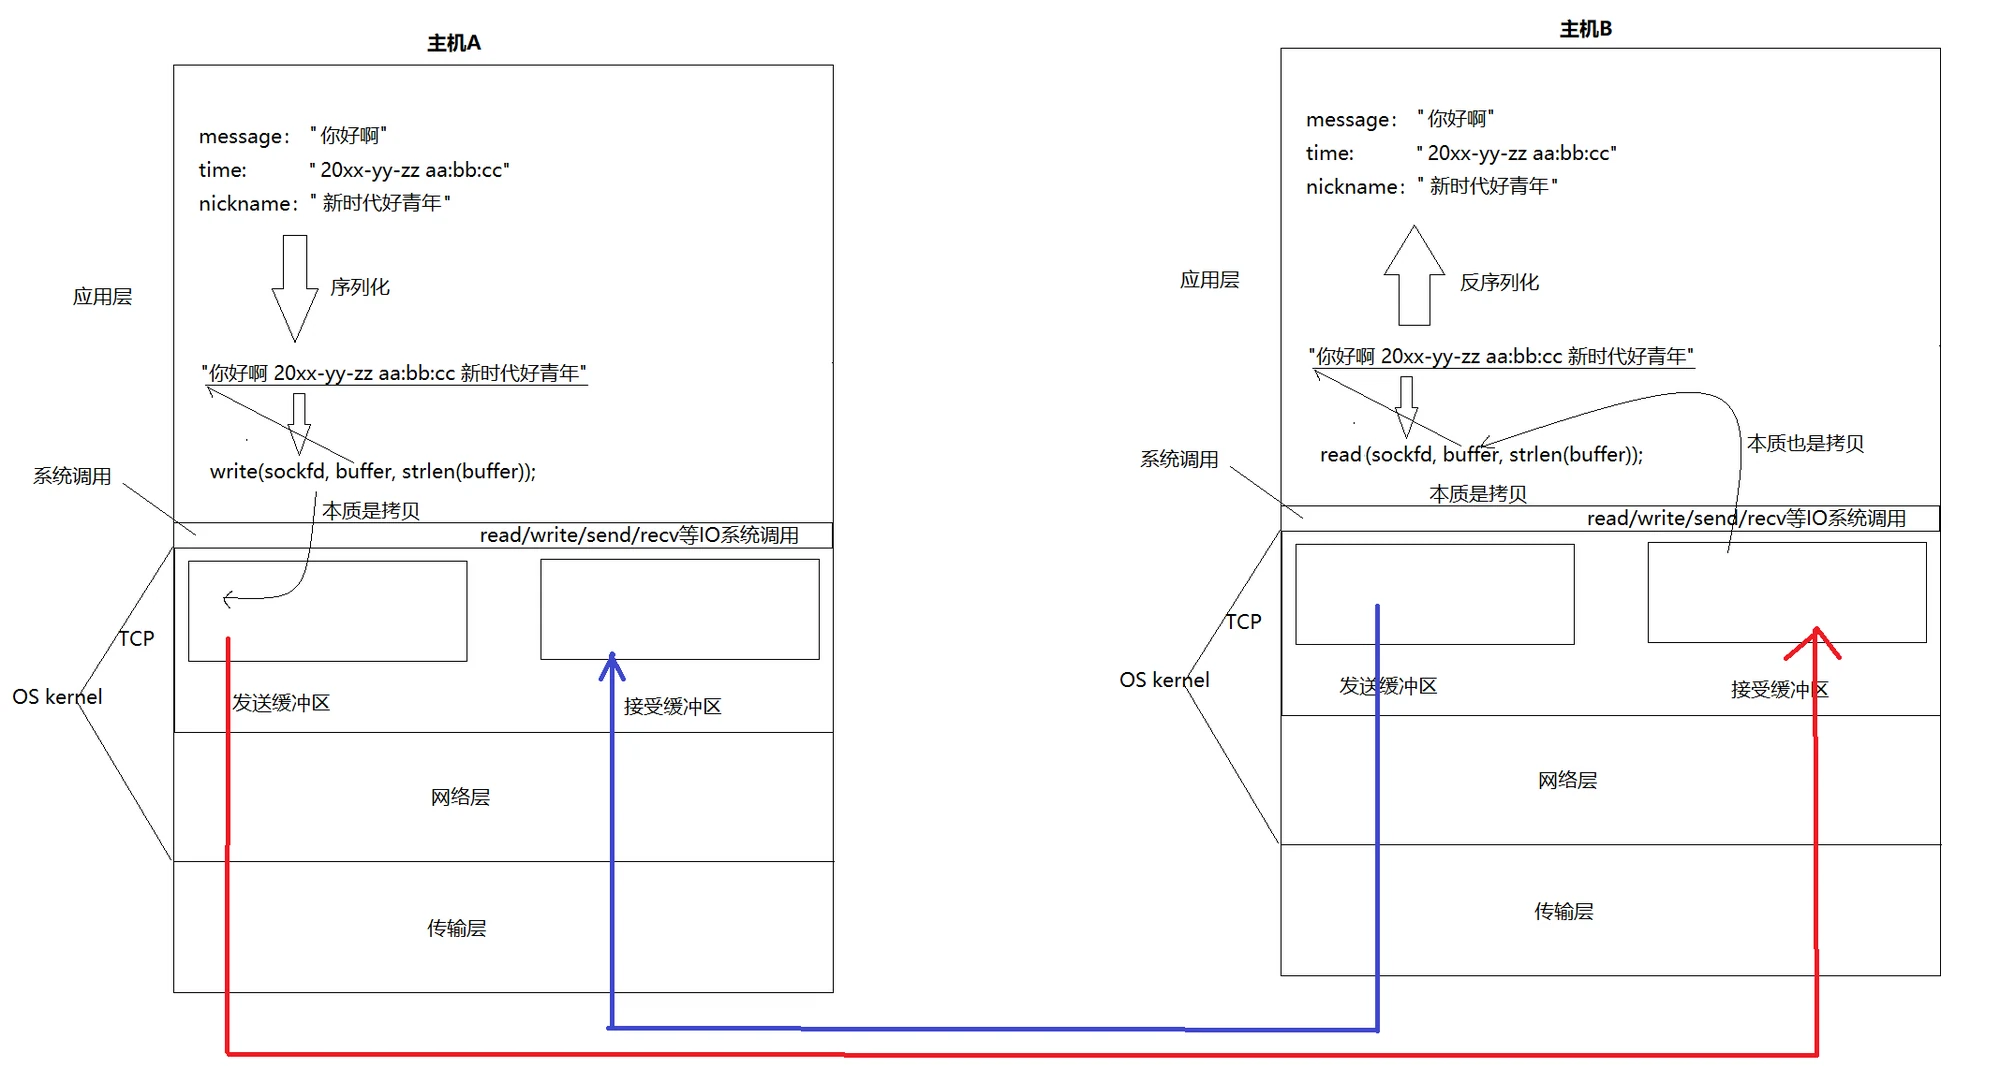
协议就是双方约定好的结构化字段
socket 的读写接口在字节层面只认字符串。想传一份结构化的东西——比如一条聊天消息里的正文、时间、昵称——就得先约定这些字段叫什么、怎么排、怎么分隔。课件把这层约定直接说成"双方约定好的结构化数据",同一份数据在发送端被压平,在接收端被立起来,压平和立起来的规则就是协议。
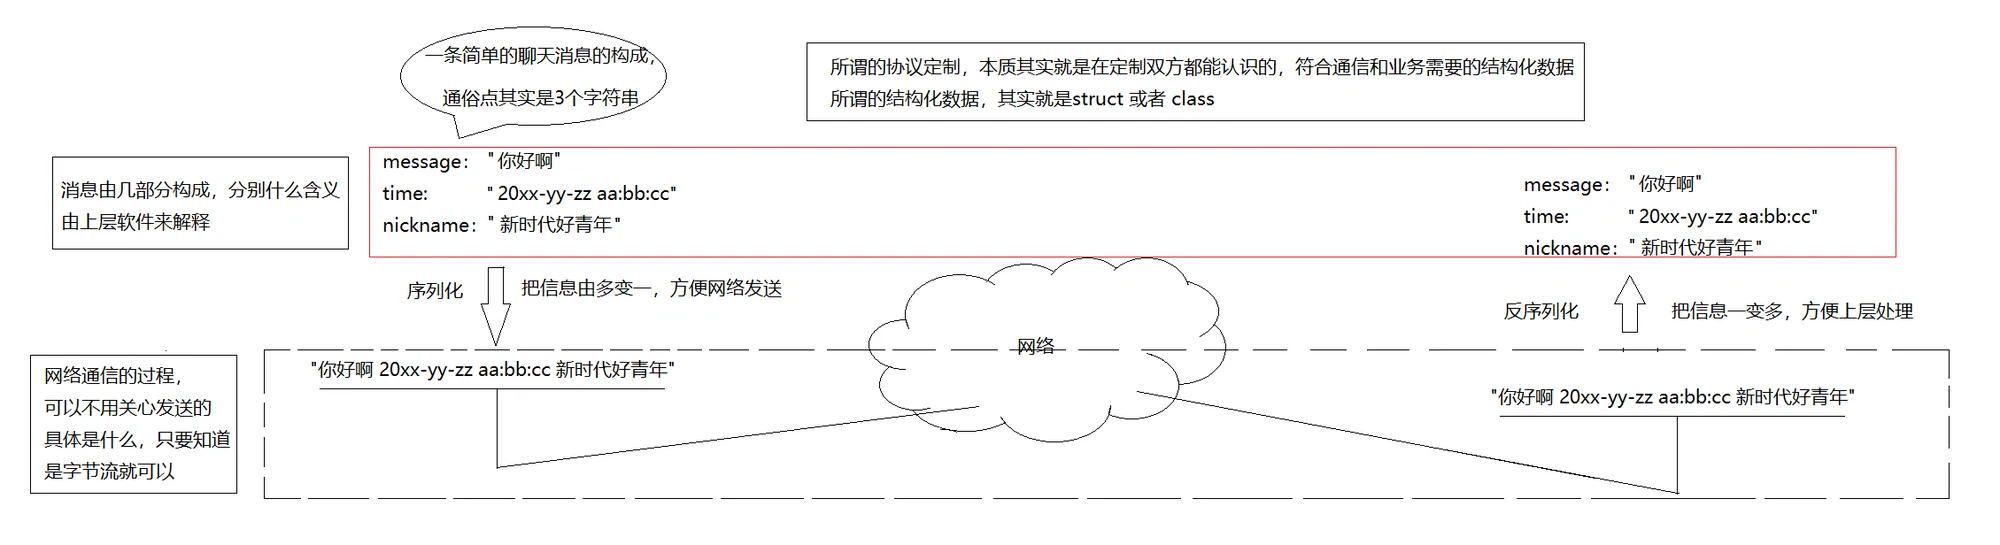
用计算器举例更具体。客户端要把两个操作数和一个运算符送到服务端,有两种约定:一是直接发 "1+2" 这样的字符串,规定只有两个整数、中间一个 +、不许有空格;二是定义结构体,发送时按规则转成字符串,接收时按同一套规则转回来,这两步叫序列化(serialization)与反序列化(deserialization)。两种方案都能跑,只要一端构造的数据另一端能解析,它就是一份合法的应用层协议。差别在于扩展性:字符串方案每加一个字段都要重新约定位置,结构体方案加字段只影响编解码函数。
先划边界:长度前缀加两个 CRLF
课件选的格式是"长度 + 分隔符 + 正文 + 分隔符"。长度用十进制文本写在最前面,后面跟 \r\n,正文原样跟上,再补一个 \r\n。接收端先找第一个 \r\n,把前面那截转成整数,然后数够这么多字节的正文,最后核对结尾的分隔符。
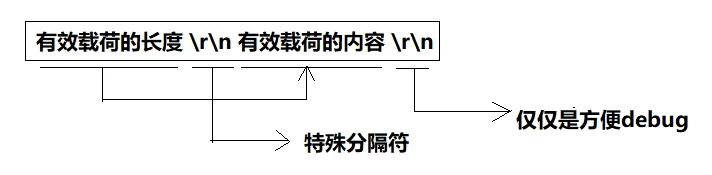
课件把接收过程中的中间状态一条条列了出来:"l"、"len"、"len\r\n"、"len\r\nx"、"len\r\nx op"、"len\r\nx op y",直到 "len\r\nx op y\r\n" 才算完整。这份清单说的就是拆包:缓冲区里随时可能只有半个长度字段,或只有半条正文。反过来的情况是粘包——两次 send 的内容被合并成一段到达,一次 recv 带回来两条完整报文。判断"够不够"的唯一依据是字节数,不能靠分隔符出现的次数猜。
/* protocol.h —— 文本长度前缀;长度按字节数算 */
#ifndef PROTOCOL_H
#define PROTOCOL_H

#include <stddef.h>
#include <stdio.h>
#include <string.h>

enum decode_result { DECODE_NEED_MORE, DECODE_OK, DECODE_BAD };

/* 成功返回写入 out 的字节数,容量不足返回 0 */
static inline size_t encode_package(const char *payload, size_t len, char *out, size_t cap)
{
    char head[24];
    int n = snprintf(head, sizeof(head), "%zu\r\n", len);
    if (n < 0 || (size_t)n + len + 2 > cap) return 0;

    memcpy(out, head, (size_t)n);
    memcpy(out + n, payload, len);
    out[n + len] = '\r';
    out[n + len + 1] = '\n';
    return (size_t)n + len + 2;
}

/* 从缓冲区头部剥一条;成功后 consumed 是这条报文的总字节数 */
static inline enum decode_result decode_package(const char *buffer, size_t size,
                                                size_t *payload_off, size_t *payload_len,
                                                size_t *consumed)
{
    size_t i;
    for (i = 0; i + 1 < size; ++i)
        if (buffer[i] == '\r' && buffer[i + 1] == '\n') break;
    if (i + 1 >= size) return DECODE_NEED_MORE;     /* 长度字段还没收全 */
    if (i == 0 || i > 10) return DECODE_BAD;        /* 空长度,或数字太长 */

    size_t len = 0;
    for (size_t k = 0; k < i; ++k) {
        if (buffer[k] < '0' || buffer[k] > '9') return DECODE_BAD;
        len = len * 10 + (size_t)(buffer[k] - '0');
        if (len > 1024 * 1024) return DECODE_BAD;   /* 单条上限,防止吊死连接 */
    }

    size_t head = i + 2;
    if (size < head + len + 2) return DECODE_NEED_MORE;
    if (buffer[head + len] != '\r' || buffer[head + len + 1] != '\n')
        return DECODE_BAD;                          /* 长度和实际内容对不上 */

    *payload_off = head;
    *payload_len = len;
    *consumed = head + len + 2;
    return DECODE_OK;
}

#endif /* PROTOCOL_H */
三个返回值是必须的。课件的 Decode 只返回 bool,于是"数据还不够"和"这条报文永久非法"混在一起:前者该等,后者该断开,调用方却无法区分。真遇上非法长度时把它当半包继续等,连接就被永久占住,缓冲区只增不减。
长度字段用文本而不是 4 字节二进制,课件选它是为了 tcpdump -A 能直接看明白。工业实现更常见二进制长度,省掉分隔符和字符串转整数;两者解决的是同一件事——先读长度,再读正文。
协议头里还该有哪些字段
len\r\n body\r\n 能跑,但它只回答了"到哪里结束"。一条连接上同时跑请求、响应、心跳时,接收端还得知道"这是什么"。一份成熟的报文头通常由五部分组成:
| 字段 | 宽度 | 解决什么 |
|---|---|---|
| magic(魔数) | 4 字节 | 固定常量,错位的字节流会被立刻拒绝,而不是被当成合法长度 |
| version | 1 字节 | 服务端升级后,旧客户端发来的报文能被识别,而不是被新解析器静默算错 |
| type | 1 字节 | 同一连接里区分请求、响应、心跳、推送 |
| flags/预留 | 2 字节 | 压缩、加密标记;显式写 0,别留未初始化字节 |
| length | 4 字节 | 正文的字节数,同时给出上限 |
魔数的价值在排查时最明显:收到的头四个字节不是 "CALC",说明前一条报文被多读或少读了几个字节,此时断开比继续解析安全。版本号的价值在灰度时最明显:一半客户端还没升级,服务端至少能回一条"版本不支持",而不是算出错误结果。
这五个字段加起来正好 12 字节,看起来可以直接定义一个结构体再 send(fd, &hdr, sizeof(hdr))。不要这样做。编译器会在字段之间插入填充字节(padding),sizeof 得到的不是 4+1+1+2+4,而且填充区里可能是栈上的旧数据。协议字段必须逐个写进缓冲区,宽度用 uint32_t,字节序统一为大端。
正文用文本还是二进制
课件在正文上给了两个实现,用 #ifdef SelfDefine 切换:一种是 x op y 空格分隔的纯文本,另一种交给 jsoncpp 打成 JSON。文本格式的好处是能直接看、能手工构造请求;坏处是每个字段都要自带解析规则,字段里出现分隔符就得转义。JSON 把这两件事都包了,代价是体积和解析开销。
jsoncpp 的安装和常用接口:
# Ubuntu / Debian
sudo apt-get install libjsoncpp-dev
# CentOS / RHEL
sudo yum install jsoncpp-devel| 序列化方式 | 输出形态 | 适用 |
|---|---|---|
Json::Value::toStyledString() | 带缩进和换行 | 调试、写日志 |
Json::FastWriter | 单行、无多余空格 | 网络传输 |
Json::StyledWriter | 带缩进 | 需要人读的输出,比 FastWriter 慢 |
Json::StreamWriterBuilder | 缩进、换行可配 | 需要定制格式 |
反序列化用 Json::Reader::parse(const std::string&, Json::Value&),失败时用 reader.getFormattedErrorMessages() 拿到带位置信息的错误;Json::CharReader 的派生类是更底层的旧接口,日常用 parse 就够了。选它的理由课件列了四条:接口直观、性能经过优化、覆盖 JSON 的全部类型、解析失败时有可用的错误信息。
Json::Value 的操作可以按四类记:取元素用 operator[] 和 at,operator[] 在键不存在时会创建一个 null 值,at 则抛异常;类型检查有 isNull/isBool/isInt/isInt64/isUInt/isUInt64/isIntegral/isDouble/isNumeric/isString/isArray/isObject;转换有 asBool/asInt/asInt64/asUInt/asUInt64/asDouble/asString;容器操作有 size/empty/resize/clear/append。协议解析必须先 isMember 再取值,别指望"取不到就会报错"。
课件里 root["oper"] = _oper; 这行的类型是个坑。_oper 是 char,而 JSON 只有字符串、数字、布尔、null 四种基本类型,赋值时 char 被整型提升,最终存进去的是 ASCII 码:
{"datax":1,"datay":2,"oper":43}43 就是 +。反序列化写 _oper = root["oper"].asInt(); 恰好能转回来,所以往返测试是绿的;但客户端一旦改发 "oper":"+",asInt() 拿不到数字返回 0,运算符就变成了一个不可打印字符。要么把运算符按字符串存,要么存数字但在解析时校验它落在 + - * / % 里。
请求和回包都按这个套路定义:请求是 _data_x、_data_y、_oper 三个字段,回包是 _result(运算结果)和 _code(运算状态码)两个字段。课件另外写了一个 Factory,把"空请求、带参请求、空回包、带结果回包"四种构造收在一处,统一返回 std::shared_ptr,调用方不用关心释放。
Socket 封装:把调用顺序固定下来
课件的工程拆成 Socket.hpp、Protocol.hpp、TcpServer.hpp、Daemon.hpp、Calculate.hpp 和两个 Main.cc,协议与网络层分开,计算逻辑单独一个文件。Socket 基类把十来个动作拆成纯虚函数(CreateSocketOrDie、BindSocketOrDie、ListenSocketOrDie、AcceptConnection、ConnectServer、Recv、Send 等),再用三个非虚函数把顺序钉死:
void BuildListenSocketMethod(uint16_t port, int backlog)
{
    CreateSocketOrDie();
    BindSocketOrDie(port);
    ListenSocketOrDie(backlog);
}
这是模板方法(template method):步骤和顺序在基类里定,每一步怎么做交给子类。好处是不会有人把 listen 写在 bind 前面。
几个实现细节会直接影响正确性:
Recv里char inbuffer[size];是变长数组,C++ 标准里没有这个语法,GCC 把它当扩展接受;换成std::string或固定大小的缓冲区更稳。Recv把n == 0和n < 0都返回false。调用方因此分不清"对方正常关闭"和"读出错",而这两种情况的处理完全不同:前者该结束会话,后者该记日志并检查errno。*buffer += inbuffer;是在缓冲区上追加,这层语义是对的:半条报文要留着。但它也意味着调用方拿到的永远是"到目前为止的全部字节",必须自己负责切分,不能把一次Recv的返回当成一条消息。Send忽略了send的返回值。send可能只写进去一部分(缓冲区满),大报文必须循环写直到写完。AcceptConnection用inet_ntoa取对端地址,它返回的是函数内部的静态缓冲区,多线程下两次调用会互相覆盖;改用inet_ntop并由调用方提供缓冲区。绑定本地地址时写INADDR_ANY表示所有网卡,只监听某一个网卡就填它的 IP。
一次完整的收发长什么样
把上面的东西串起来,服务端的循环只有四步:收字节、切报文、处理、回包。
#include "protocol.h"          /* 上面的 encode_package / decode_package */

#include <stdio.h>
#include <string.h>
#include <errno.h>
#include <unistd.h>
#include <sys/socket.h>

/* 业务处理:这里只回一条固定应答;真实实现是反序列化、计算、再序列化 */
static size_t handle_request(const char *payload, size_t len, char *out, size_t cap)
{
    (void)payload;
    (void)len;
    return encode_package("OK", 2, out, cap);
}

/* 服务端单连接循环:缓冲区跨多次 recv 存活,一次 recv 里切完所有完整报文 */
static int ServeOne(int cfd)
{
    char buffer[8192];
    size_t used = 0;

    for (;;) {
        if (used == sizeof(buffer)) return -1;     /* 满了还没有完整报文,长度字段不可信 */
        ssize_t n = recv(cfd, buffer + used, sizeof(buffer) - used, 0);
        if (n == 0) return 0;                      /* 对方关闭 */
        if (n < 0) {
            if (errno == EINTR) continue;
            return -1;                              /* 真错误,含 ECONNRESET */
        }
        used += (size_t)n;

        for (;;) {
            size_t off, len, consumed;
            enum decode_result r = decode_package(buffer, used, &off, &len, &consumed);
            if (r == DECODE_NEED_MORE) break;       /* 半包,等下一次 recv */
            if (r == DECODE_BAD) return -1;         /* 缓冲已不可信,断开 */

            char reply[4096];
            size_t reply_len = handle_request(buffer + off, len, reply, sizeof(reply));
            if (reply_len == 0) return -1;

            size_t sent = 0;
            while (sent < reply_len) {              /* send 可能只写一部分 */
                ssize_t w = send(cfd, reply + sent, reply_len - sent, MSG_NOSIGNAL);
                if (w <= 0) return -1;
                sent += (size_t)w;
            }

            memmove(buffer, buffer + consumed, used - consumed);
            used -= consumed;
        }
    }
}
used 减到 0 不代表这一轮结束,循环会继续等下一次 recv。缓冲区满而里面又没有一条完整报文,说明对方声明了一个永远凑不齐的长度,此时应该断开——这正是长度上限存在的理由。
课件的注释里还有一句值得保留:同一套代码里可以同时存在多组协议。新增一种报文时,在头部加一个 type 值,老代码走老分支,新代码走新分支;这比给每种报文各开一个端口要省事得多。
还没有评论 — 第一条由你来留。