首部就四个字段,一共 8 字节
UDP 报文头(RFC 768)只有两行:
 0                   15 16                  31
+---------------------+---------------------+
|    16位源端口号      |   16位目的端口号     |
+---------------------+---------------------+
|    16位UDP长度       |   16位UDP校验和      |
+---------------------+---------------------+
|                 数据(如果有)              |
+-------------------------------------------+
四个字段各 16 位,固定 8 字节。源端口和目的端口标明数据从哪个进程来、到哪个进程去;长度字段表示整个用户数据报的字节数,首部和数据都算在内,所以最小值是 8;校验和覆盖伪首部、UDP 首部和数据。
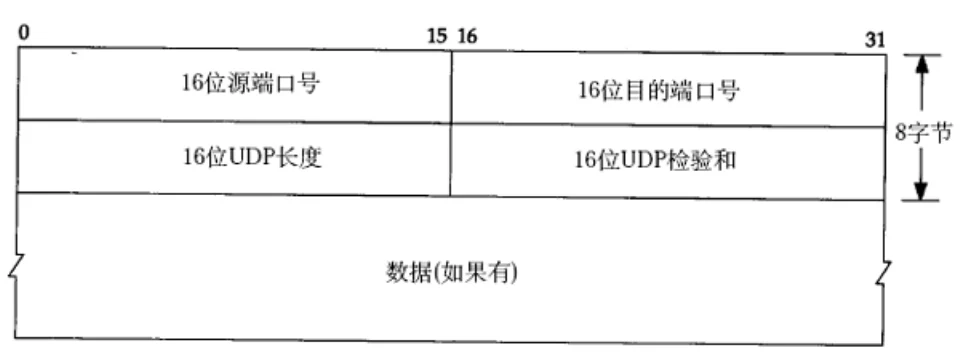
长度字段 16 位,最大 65535。课件说“最大长度是 64K”,64K 是 65536,比字段能表达的最大值多 1,准确说法是 65535 字节。再往下压一层:IPv4 首部里的总长度也是 16 位,一个 IPv4 包最多 65535 字节,减去 20 字节 IP 首部和 8 字节 UDP 首部,UDP 数据最多 65507 字节。IPv6 的载荷长度字段不把 40 字节固定首部算进去,UDP 数据最多 65527 字节。
超过这个上限,sendto 在协议栈里就返回失败,errno 是 EMSGSIZE,报错文案 Message too long。它发生在本地,网卡上一个包都不会出现。
校验和算的是“伪首部 + 首部 + 数据”
校验和不是 CRC。RFC 768 的算法是反码求和:把伪首部、UDP 首部和数据按 16 位分组相加,进位回卷加回低位,最后取反码。接收端用同样的方式算一遍,结果应为全 1,否则丢弃。
伪首部不是真实传输的字节,它是计算时临时拼出来的,包含源 IP、目的 IP、协议号和 UDP 长度。作用是让接收端能发现“包送到了错误的地址或协议”——UDP 首部里只有端口,没有 IP,光看首部无法判断地址对不对。
IPv4 和 IPv6 在这里有个关键差别:
- IPv4 中 UDP 校验和是可选的。发送端算出结果为 0 时填
0xFFFF;填全 0 表示“没有计算校验和”,接收端看到 0 就直接放行。 - IPv6 中没有 IP 首部校验和,UDP 校验和是强制的。RFC 8200 规定,IPv6 节点收到校验和为 0 的 UDP 报文必须丢弃。
所以这句话必须带协议版本。抓包工具把校验和标红、接收端却正常收下,多半是 IPv4 下的“未计算”。
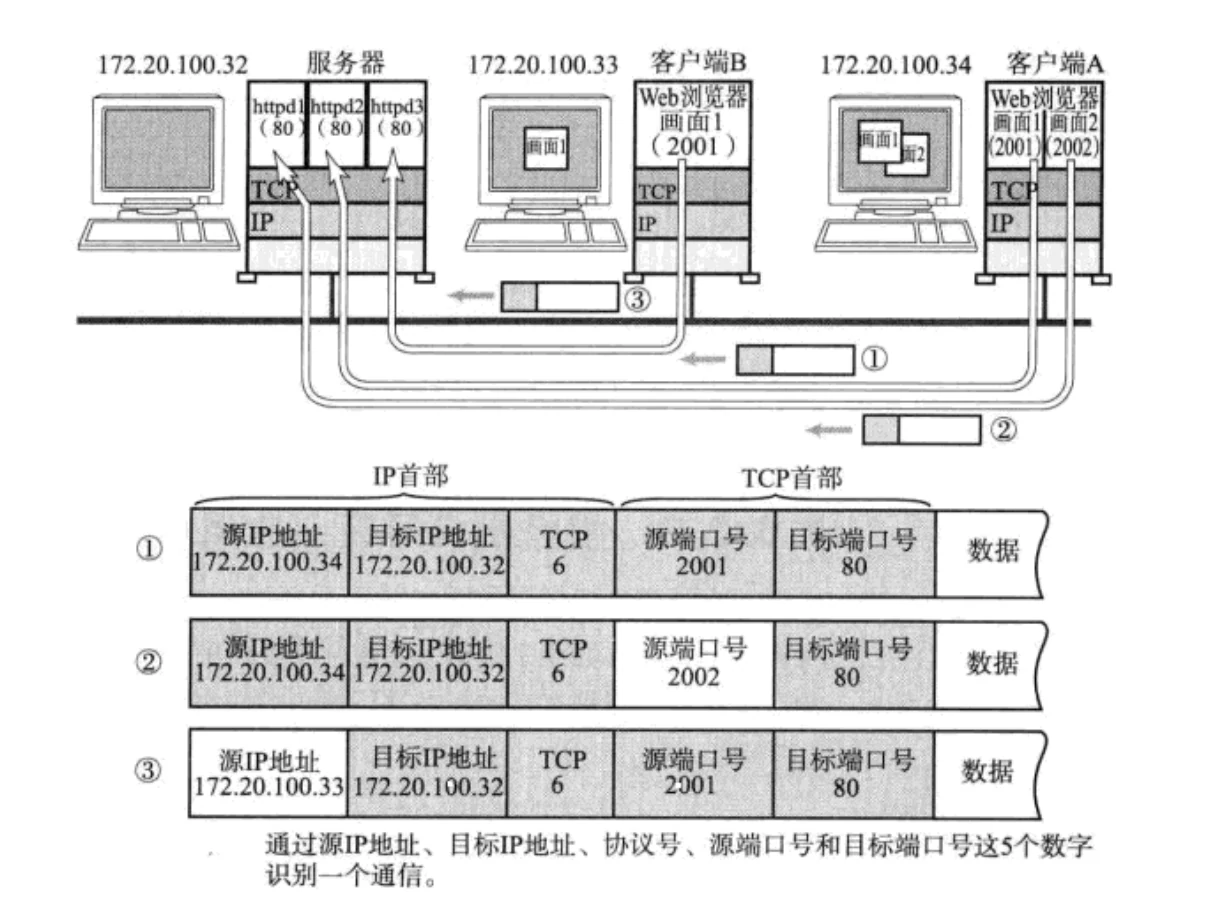
一条通信靠五元组区分
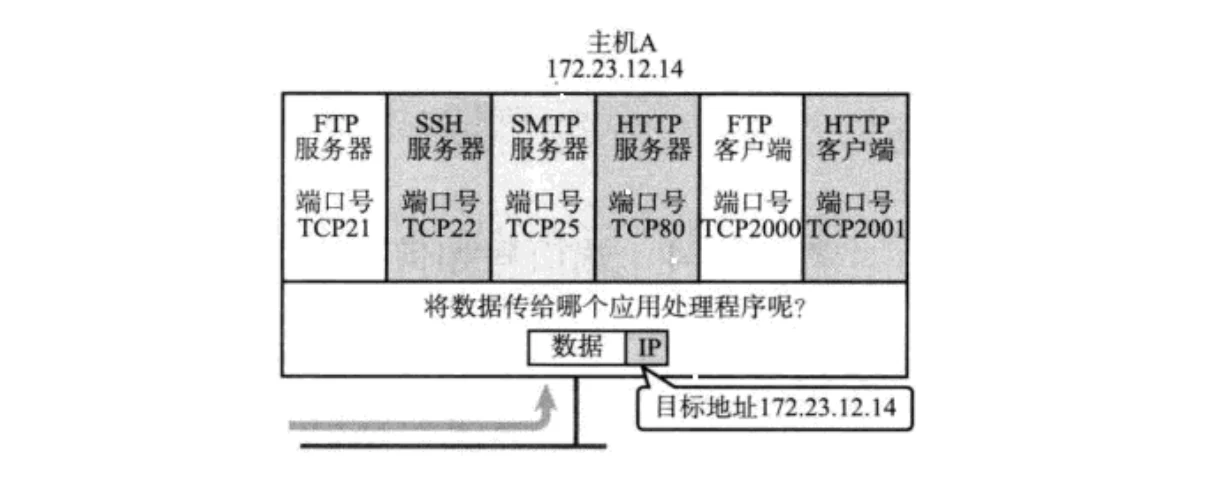
传输层负责把数据交到正确的进程。同一台主机上的服务靠端口分流。
一条通信由五元组标识:源 IP、源端口、目的 IP、目的端口、协议号。三个报文的目的地址和端口相同,靠源 IP 和源端口区分成三条通信。
端口范围的划分按 IANA 的三段来:
| 范围 | 名称 | 用途 |
|---|---|---|
| 0–1023 | 系统端口(well-known) | HTTP 80、HTTPS 443、SSH 22、FTP 21、Telnet 23 等固定分配 |
| 1024–49151 | 用户/注册端口 | 3306、6379 这类长期占用的服务端口 |
| 49152–65535 | 动态/私有端口 | 临时分配 |
课件把 1024–65535 整段说成“操作系统动态分配”,把 MySQL 的 3306、Redis 的 6379 也划进了临时端口。RFC 6335 和 IANA 注册表都是上面这种三段划分。Linux 内核真正临时分配的那一段另由 net.ipv4.ip_local_port_range 决定,默认 32768–60999,和 IANA 的“动态端口”并不完全重合。
cat /etc/services 能看到这份约定。自己绑端口要避开系统端口。
课件留了两个问题,答案都不复杂:
- 一个进程可以 bind 多个端口。开多个 socket,分别绑不同端口即可。
- 一个端口默认只能被一个进程 bind,第二个会拿到
EADDRINUSE。打开SO_REUSEPORT后允许多个 socket 绑同一端口,内核把新到的报文分给其中一个;Linux 3.9 起支持,要求绑定者使用同一个有效 UID。SO_REUSEADDR解决的是另一件事——让处于TIME_WAIT的端口能被重新绑定,不负责多进程分流。
无连接、不可靠、面向数据报
UDP 传数据像寄信:写上地址扔进邮筒,不先打电话确认对方在不在,也不等回执。
- 无连接:知道对端 IP 和端口就直接发,没有握手,没有连接状态。
- 不可靠:没有确认,没有重传。报文在网络上丢了,UDP 协议层不会给应用层返回任何错误,发送端根本不知道。
- 面向数据报:应用层给多长的报文,UDP 原样发,既不拆也不合。
第三条决定读写次数。发送端调用一次 sendto 发 100 字节,接收端必须用一次 recvfrom 收 100 字节;循环调用 10 次、每次收 10 字节,剩下的 90 字节不会留在缓冲区等你,直接丢弃。UDP 保留报文边界,代价是应用层必须一次读够。
发送没有队列,接收有缓冲区
UDP 没有真正意义上的发送缓冲区。sendto 把数据交给内核,内核往下传给网络层,函数就返回了。
接收端有缓冲区,但它是按报文排队,不是一根可以任意切分的字节流。缓冲区满之后新到的报文被丢弃;缓冲区里的报文也不保证和发送顺序一致,乱序到达就乱序交付。
UDP 的 socket 是全双工。recvfrom 返回 0 表示收到一个长度为 0 的数据报,不是对端关闭。
65535 是协议上限,1472 才是常见的安全线
65507 不是随便就能发。数据报超过路径 MTU(以太网通常 1500)时,IP 层会把它切成多片,每片单独走网络。中间丢任何一片,接收端都凑不齐整个数据报,协议栈把整条丢掉,不会只给缺的那一块。所以“小包正常、大包全丢”经常和 MTU、防火墙一起出现。
不会触发 IP 分片的单包上限是 1500 − 20 − 8 = 1472。防火墙常丢非首片,压到 1472 以下能绕开一类“假丢包”。
超过上限就在应用层自己切:每条分片带消息号、偏移和总长,收端攒齐再交,超时没齐就丢弃。
它适合什么,以及 NAT 打洞为什么靠它
基于 UDP 的应用层协议有 NFS、TFTP、DHCP、BOOTP、DNS,以及自己定义的协议。
选择 UDP 通常因为要快、能容忍丢,或者需要一问多答:
- DNS 一次查询一个包、一个响应一个包,重发由应用层自己做,比建立连接便宜。
- 音视频和游戏宁可丢几帧,也不要为了重传卡住整个流;延迟比完整性重要。
- 广播和多播只有 UDP 能做,TCP 是点对点的。
NAT 靠出站报文建立映射:内网主机往公网发一个 UDP 包,路由器记下内网 IP:端口到公网 IP:端口的对应,之后这个五元组的回包才能进来。没有出站包,外部无法主动连进来。
UDP 打洞利用的就是这条规则。两个都在 NAT 后面的主机 A、B 想直连:
- A 和 B 各自向公网服务器发一个 UDP 包,先让各自的 NAT 建立映射。
- 服务器从报文的源地址看到 A、B 的公网 IP 和端口,把它们分别告诉对方。
- A 用 B 的公网地址发 UDP,B 用 A 的公网地址发 UDP。第一包可能被各自的 NAT 丢掉,但出站动作已经在 NAT 上开了口子,后续包就能穿过。
这套方法对“锥形 NAT”有效,对“对称 NAT”经常失败:对称 NAT 给每个目的地址分配不同的公网端口,服务器看到的端口和 A 实际打洞用的端口对不上。失败时只能走中继(TURN),或者让服务器转发。
UDP 把复杂度留给了应用层。选它之前先确认一件事:丢包的后果由谁承担。
还没有评论 — 第一条由你来留。