TCP 的全部机制可以压成两个目标:让字节按序、完整地到达;同时尽量别把网络压垮。首部里的每个字段、状态机里的每个状态,都是为这两个目标服务的。
首部 20 字节,每格负责一件事
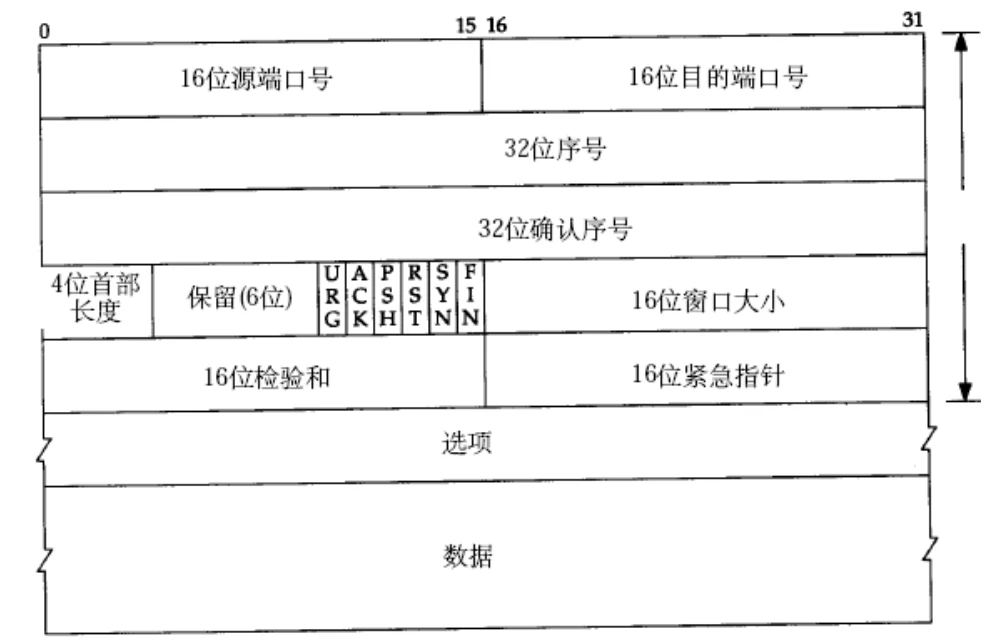
- 源端口、目的端口各 16 位,标明数据从哪个进程来、到哪个进程去。
- 32 位序号:本报文第一个数据字节的编号。
- 32 位确认号:这个编号之前的字节都收到了,下次从这里发。
- 4 位首部长度(doff):首部有多少个 32 位字,单位是 4 字节。最小值 5(20 字节),最大值 15(60 字节),所以选项最多 40 字节。
- 6 位标志位:URG 表示紧急指针有效;ACK 表示确认号有效;PSH 提示接收端立刻把缓冲区里的数据交给应用;RST 复位连接;SYN 请求建立连接;FIN 通知对方本端要关闭。
- 16 位窗口:接收端还能接收的字节数。
- 16 位校验和:覆盖首部和数据。
- 16 位紧急指针:指向紧急数据的位置。
- 40 字节选项:MSS、窗口扩大因子、SACK、时间戳等。
课件的首部图是 RFC 793 的经典布局:6 位保留加 6 个标志。RFC 3168 把保留位中的两位改成了 ECE 和 CWR,用于显式拥塞通知(ECN),所以内核的 struct tcphdr 里有 8 个标志位。内核用位域描述这一行:doff:4、res1:4,接着 fin/syn/rst/psh/ack/urg/ece/cwr 各 1 位。doff 是首部长度,不是标志位。
课件把校验和写成“CRC 校验”。RFC 9293 的定义是反码求和:伪首部、TCP 首部和数据按 16 位分组相加,进位回卷,再取反码。CRC 是链路层帧尾用的多项式校验,两者不是一回事。这个字段能抓比特翻转,抓不到顺序错误,排序和去重靠的还是序号。
RST 也不是课件说的“对方要求重新建立连接”。它表示当前连接作废、立刻拆掉:端口没有监听、半开连接收到数据、协议栈认为状态不一致,都会回 RST。收到之后要不要重连,是应用层自己的决定。
每个字节都有编号,ACK 说的是“下一个要哪个”
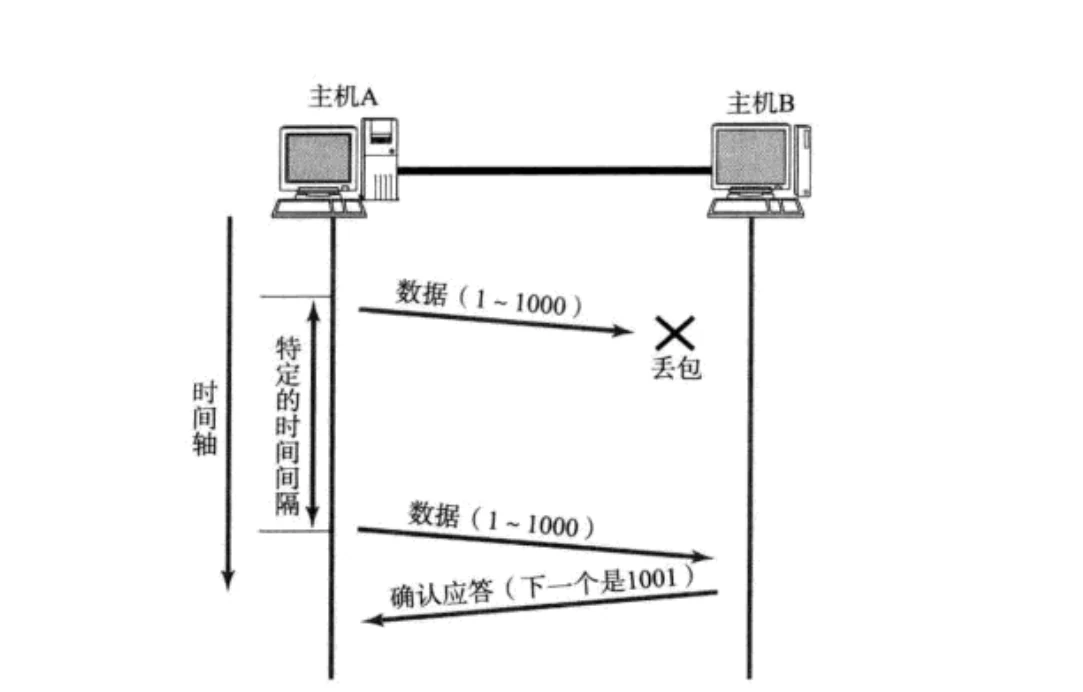
TCP 把应用层交下来的字节按顺序编号。发送第一个段时序号是 ISN,段里 1000 字节就占 1000 个编号。接收端回 ACK 时,确认号填“连续收到的位置的下一个字节”,意思是前面的都齐了,从这里开始发。
这个设计顺便解决了重复问题。ACK 丢失导致发送端重传,接收端会收到重复段,但序号一样,直接丢掉即可。
超时时间不是固定的。课件说“以 500ms 为单位,每次都是 500ms 的整数倍”,这是很老的实现描述。现在的 RTO(Retransmission Timeout)由 RTT 采样算出来:平滑往返时间 SRTT 加上四倍偏差 RTTVAR。Linux 的初始 RTO 约 1 秒,下限 200 毫秒,上限 120 秒。超时后确实翻倍,指数退避保留了下来,但基数不是固定的 500 毫秒。累计到一定次数仍无应答,协议栈认为对端或网络异常,强制关闭连接。
三次握手:SYN 占一格,纯 ACK 不占新格
客户端调用 connect,发 SYN,进入 SYN_SENT;服务器收到 SYN,回 SYN+ACK,进入 SYN_RCVD;客户端回 ACK,双方进入 ESTABLISHED。
为什么不是两次?两次只能证明单向可达:客户端发 SYN、服务器回 SYN+ACK,只能说明服务器收到了客户端的请求,不能说明客户端收到了服务器的回应。客户端再发一个 ACK,服务器才确认双方都能收能发。这一次还顺便挡掉了网络里迟到的旧 SYN——如果旧 SYN 被当成新请求,服务器会建立一个没人要的连接。
序号上有个容易记错的细节。SYN 本身占一个序号,所以服务器回的 ack 是客户端 ISN 加一;SYN+ACK 里的 SYN 也占一个序号,客户端回的 ack 是服务器 ISN 加一。第三个报文是纯 ACK,不携带数据,也不新增可消耗的序号。说“第三次握手不占序号”要补全成“纯 ACK 不再占新的格”,否则会被误解成 SYN 不占序号。
四次挥手:两个方向各关一次
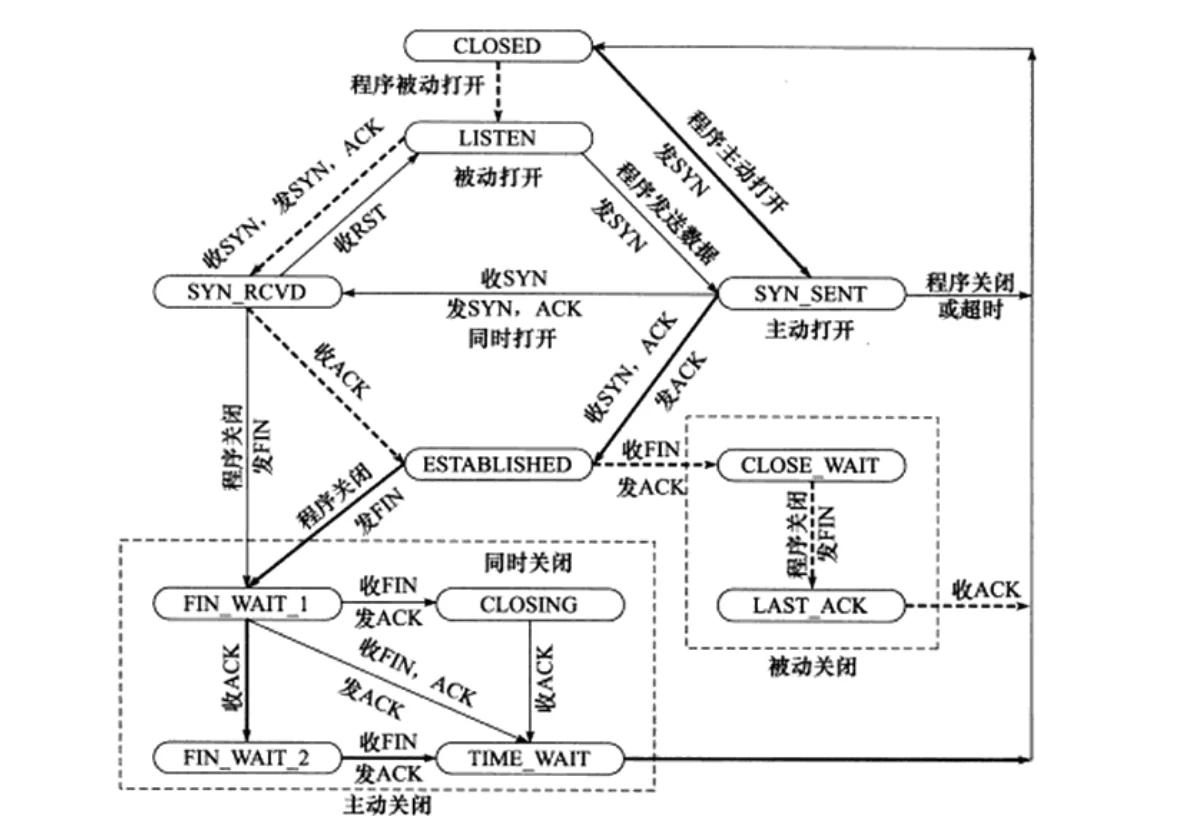
客户端主动关闭:调 close 发 FIN,进入 FIN_WAIT_1;服务器回 ACK,进入 CLOSE_WAIT,客户端进入 FIN_WAIT_2;服务器把剩余数据发完,调 close 发 FIN,进入 LAST_ACK;客户端回 ACK,进入 TIME_WAIT;服务器收到 ACK 后回到 CLOSED。
课件在客户端状态迁移里写“收到服务器 FIN 后进入 TIME_WAIT,并发出 LAST_ACK”,这里把两个角色的报文弄混了。LAST_ACK 是服务端的状态,客户端在 TIME_WAIT 里发出的是普通 ACK。准确顺序是:客户端收到 FIN → 回 ACK → 进入 TIME_WAIT。
如果双方几乎同时关闭,客户端在 FIN_WAIT_1 收到对方的 FIN(而不是 ACK),会进入 CLOSING,等自己的 FIN 被确认后再进 TIME_WAIT。这条路径课件留作课后调研,它存在的意义是:双方都发了 FIN,都还没收到对方的 ACK。
shutdown(SHUT_WR) 只关写方向,连接还能继续收,这叫半关闭;close 是把 fd 的引用放掉,引用计数归零才真正拆连接。
TIME_WAIT 不是浪费,是收尾
主动关闭方要在 TIME_WAIT 待 2MSL(Maximum Segment Lifetime,报文最大生存时间)。目的有两个:
- 让两个方向上迟到的旧报文自然消失。否则服务器立刻重启,可能收到上一个连接残留在网络里的数据,把它当成新连接的数据。
- 保证最后一个 ACK 能送到。如果这个 ACK 丢了,服务器会重发 FIN;客户端还在
TIME_WAIT,能再回一次 ACK。要是客户端立刻进CLOSED,服务器就只能收到 RST。
课件让你 cat /proc/sys/net/ipv4/tcp_fin_timeout 看 MSL,这个文件不是 MSL。man 7 tcp 写的是“等对方最终那个 FIN 多少秒后强制关闭 socket”,默认 60,管的是 FIN_WAIT_2 的超时,防止有人永远停在那里。TIME_WAIT 的时长在核心里是另一个常量,没有对应的 sysctl 可调。MSL 在 RFC 1122 里建议 2 分钟,实际实现常见 30 秒,所以 2MSL 约 60 秒。
“TIME_WAIT 太多必须避免”也是个误解。它是协议正确关闭的一部分。真正会出问题的是数量:每条 TIME_WAIT 占一个五元组,服务器的 IP、端口、协议固定,如果服务器主动关闭大量短连接,这些五元组会堆在 TIME_WAIT 里,新连接的源 IP、源端口如果撞上,就会被拒绝;客户端侧则会先耗尽本地临时端口,报 Cannot assign requested address。缓解办法是让客户端主动关闭、用连接池复用连接,或在确有必要时打开 SO_REUSEADDR。
课件对 SO_REUSEADDR 的解释是“允许创建端口号相同但 IP 地址不同的多个 socket”,这不是它的主要用途。它真正解决的是:旧连接还在 TIME_WAIT 时,新 socket 仍能 bind 同一个端口。服务端重启时绑定失败,靠的就是这个选项。
CLOSE_WAIT 堆起来,通常是少了一个 close
课件把服务器代码里的 new_sock.Close() 注释掉,再让客户端断开,netstat 里服务器就停在 CLOSE_WAIT,客户端停在 FIN_WAIT2。
CLOSE_WAIT 是被动关闭方的状态:收到对方的 FIN,内核回 ACK,然后把“对方要关了”这件事交给应用层,等应用层调 close。应用层一直不关,连接就一直停在这里。它不占 CPU,只占内存和 fd,可以从早躺到晚。
服务器上出现大量 CLOSE_WAIT,原因基本是代码没有在所有分支上关闭 socket:错误分支里 return 提前退出,后面的 close 没走到。修复不是调内核参数,而是在每条退出路径上补 close,或者用 RAII 让析构函数负责关闭。
FIN_WAIT_2 则是主动关闭方在等对方的 FIN。如果对方一直不关,内核靠 tcp_fin_timeout 兜底。
窗口:一次发多少,不用等 ACK
一发一收的停等协议性能很差,尤其在往返时延大的链路上。滑动窗口允许发送端连续发多个段,不必等每个段的 ACK。
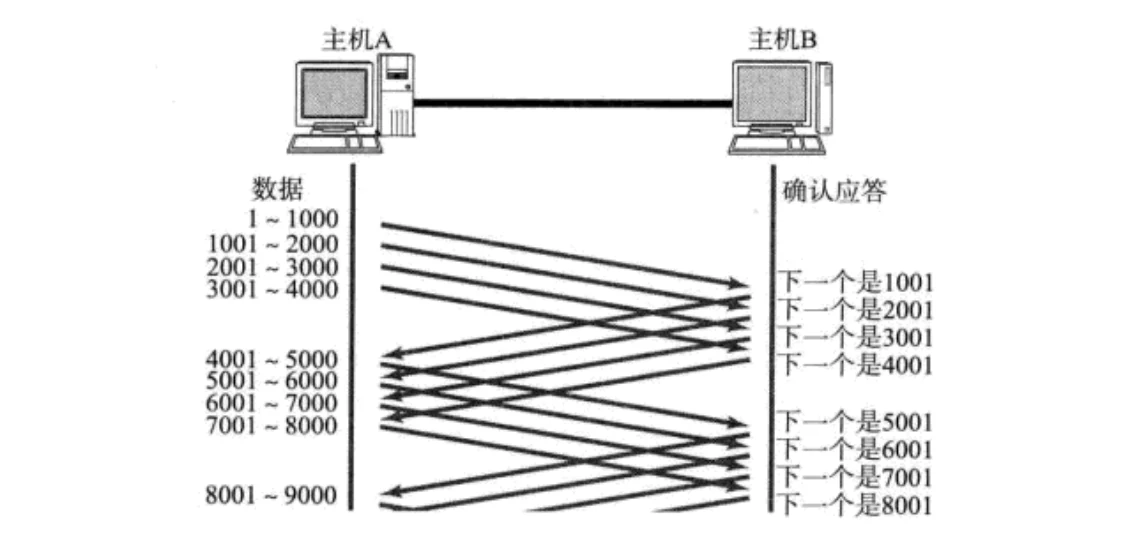
窗口大小指“无需等待确认就能继续发送的最大字节数”。发送前四个段不用等 ACK;收到第一个 ACK 后窗口右移,继续发第五个段。内核为每个连接维护发送缓冲区,记录哪些数据还没被确认,确认过的才能从缓冲区删掉。
窗口字段 16 位,最大 65535 字节。长肥管道上这点窗口不够用,首部选项里带一个窗口扩大因子,实际窗口是字段值左移若干位。这个因子只在握手时报一次,之后不能改。
接收端处理得慢,就把窗口调小;缓冲区满,窗口置 0,发送端停手,但会定期发窗口探测报文问“现在能收了吗”。这套机制叫流量控制,它只解决接收端来不及处理的问题,不解决网络中间堵不堵。
丢包分两种,快重传和快恢复处理后面那种
情况一:数据到了,ACK 丢了。后面的 ACK 会覆盖前面的确认,不必重传。
情况二:数据本身丢了。接收端对后续每个到达的段都回同一个确认号,比如一直回 1001,意思是“下一个要 1001”。发送端连续收到三个重复 ACK,就不再等定时器,立刻重发 10012000。补上之后,接收端回的 ACK 直接跳到 7001,因为 20017000 早就收进缓冲区了。
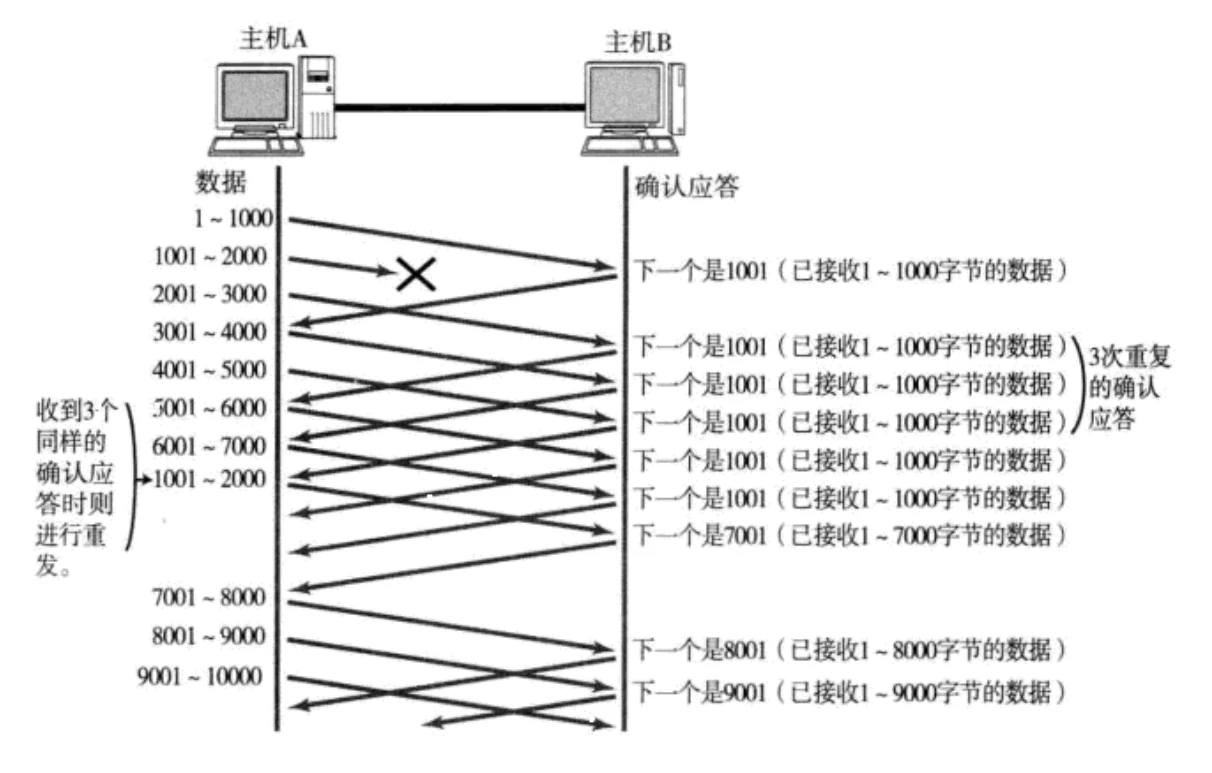
这套动作叫快重传(fast retransmit)。重传之后还有快恢复(fast recovery):把慢启动阈值设为当前拥塞窗口的一半,拥塞窗口降到阈值附近,然后直接进入拥塞避免,而不是回到 1。这样不必因为一个丢包把速度打回原点。
拥塞控制:先试探,再线性增长,丢包就退
接收端窗口表示“还能收多少”,拥塞窗口表示“网络大概能塞多少”。发送时取两者较小值。
慢启动阶段,每收到一个 ACK 就把拥塞窗口加一,一个 RTT 翻一倍。涨到慢启动阈值后改为线性增长,每个 RTT 加一个 MSS,这叫拥塞避免。阈值初始通常设得很大,相当于先不限速;出现超时,阈值砍半,拥塞窗口回到 1,重新试探。
课件说“发送开始时拥塞窗口为 1”,这是早期实现的模型。RFC 6928 把初始窗口提高到 min(10*MSS, max(2*MSS, 14600)),Linux 早已按这个实现。从 1 起步的曲线适合讲原理,不适合当现状。
少量丢包只触发重传;大量丢包才被当成网络拥塞。拥塞控制的本质是在“尽快传完”和“别把网络压垮”之间找折中。
延迟应答与捎带应答
接收端不必每收到一个段就立刻回 ACK。等一小会儿,把多个 ACK 攒在一起发,顺便把更新后的窗口报出去,这叫延迟应答。数量上通常每收到两个段回一次,时间上不能超过约 200 毫秒,具体值随操作系统不同。等太久,发送端会误以为丢包。
如果这时正好有数据要回,ACK 就搭在数据报文上一起走,叫捎带应答。
面向字节流:读写次数不重要,边界要自己找
TCP socket 在内核里有一对缓冲区。write 先把数据写进发送缓冲区;字节太长会被拆成多个段,太短会等缓冲区攒够或其他合适时机再发。接收端的数据从网卡进接收缓冲区,read 从里面取。
因为缓冲区存在,读写不需要一一对应:写 100 字节可以一次 write,也可以 100 次每次写 1 字节;读的时候同样可以一次读 100 字节,或分 100 次每次读 1 字节。一个连接既能读也能写,叫全双工。
代价是应用层看不到“包的边界”。TCP 首部没有 UDP 那样的长度字段,它只保证字节按序到达。两个应用层消息在缓冲区里连在一起,就是常说的粘包——不是 TCP 把包粘住了,而是它压根没打算保留包的形状。
要找回边界,只有三种常见做法:
- 定长消息:每次按固定大小读。
- 长度字段:包头里写总长度,先读头再读正文。
- 分隔符:包与包之间用不会和正文冲突的字符分隔。
UDP 没有粘包问题:它保留报文边界,应用层要么收到完整报文,要么什么都收不到,不会收到“半个”。
Nagle 算法会在发送端合并小数据:如果还有已发送但未确认的数据,新的小段先等着,直到 ACK 回来或攒够一个 MSS。它能减少小包数量,但和延迟应答叠加会带来几十毫秒的额外延迟。对延迟敏感的程序可以设 TCP_NODELAY 关掉它。
连接异常时,TCP 自己能发现一部分
进程终止会释放 fd,内核仍然发 FIN,和正常关闭没区别。机器重启也一样。
机器掉电或网线断开时,对端以为什么都没发生。如果对端继续写,发现连接已经不存在,会回 RST;如果一直不写,TCP 内置的保活定时器会定期探测,确认对方不在了再释放连接。默认的 keepalive 周期很长(通常两小时起步),指望它快速发现故障不现实。应用层协议通常自己加心跳:HTTP 长连接定期检测,即时通信客户端断线后定时重连。
可靠性和性能分别由谁负责
课件的两张清单可以直接背:
可靠性靠校验和、序列号(按序到达)、确认应答、超时重发、连接管理、流量控制、拥塞控制。
性能靠滑动窗口、快重传、延迟应答、捎带应答。
另外还有一组定时器:超时重传定时器、保活定时器、TIME_WAIT 定时器。
基于 TCP 的应用层协议有 HTTP、HTTPS、SSH、Telnet、FTP、SMTP,以及自己定义的协议。TCP 不天然优于 UDP。文件传输、状态更新要完整,选 TCP;音视频、游戏、广播要低延迟,选 UDP。要在 UDP 上做可靠传输,就在应用层把 TCP 那套搬过去:序号保证顺序,ACK 确认收到,超时重传补丢包,窗口控制节奏。这也是很多面试题的标准答案,区别只在于这些逻辑从内核挪到了应用层,可控性更强,成本也更高。
还没有评论 — 第一条由你来留。