同一个字符串,两个函数给出不同的数:
select length('张三'), char_length('张三'); -- 6, 2这不是谁算错了,是两把尺子。length() 量字节,char_length() 量字符。utf8mb4 下,ASCII 字符占 1 字节,汉字占 3 字节,emoji 占 4 字节。问“名字有几个字”用 char_length,问“这一列会不会撑爆索引”用 length。
varchar(10) 里的 10 是字符数上限,不是字节数。utf8mb4 下 varchar(768) 的理论最大字节数是 3072,正好压在 InnoDB 索引键的字节上限上,这也是“字段长度没超、索引却建不上”的常见原因。
create database if not exists func_demo default character set utf8mb4;
use func_demo;

create table msg (
    id       int primary key auto_increment,
    content  varchar(30) not null,
    sendtime datetime
);

insert into msg (content, sendtime) values
('hello1', '2024-03-01 09:58:00'),
('hello2', '2024-03-01 10:00:30');

create table score (
    name    varchar(20) not null,
    chinese int,
    math    int,
    english int
);

insert into score (name, chinese, math, english) values
('唐三藏', 67,   98, 56),
('猪悟能', 88,   98, 90),
('刘玄德', 55,   85, 45),
('孙悟空', null, 78, 77);拼接:concat 遇到 NULL 整条作废,concat_ws 会跳过
select concat(name, '的语文是', chinese, '分,数学是', math, '分')
from score;
只要有一个参数是 NULL,整条结果就是 NULL。孙悟空缺考语文,那一行整条变成 NULL,不是“的语文是分”。空字符串 '' 是有值的空串,和 NULL 不是一回事。
想让 NULL 显示成 0,用 ifnull(chinese, 0) 包一层;想让它直接不出现,用 concat_ws:
select concat_ws('-', 'a', null, 'b', 'c');   -- a-b-c
select concat_ws(null, 'a', 'b');              -- NULL
concat_ws 会跳过后面的 NULL,但分隔符本身是 NULL 时,整体还是 NULL。
group_concat 管的是组内拼接,把多行的值合成一行:
select group_concat(name order by math desc separator '/')
from score;
它默认用逗号分隔,可以带 order by 和 separator。结果长度受 group_concat_max_len 限制,默认 1024 字节,超了会截断并给一条 warning;组内值很多时要先调大这个变量,否则拿到的是一段不完整的结果。
截取、替换、大小写、定位、去空格
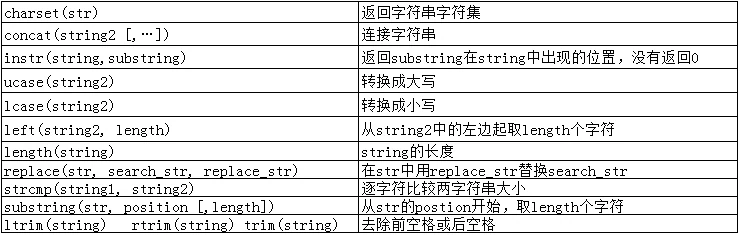
replace(str, from, to) 替换所有出现的子串,不是只换第一个:
select replace('SHELL', 'S', '上海'); -- 上海HELLsubstring(str, pos, len) 从 1 开始数,pos 为负数时从右往左数,只给两个参数表示取到末尾:
select substring('abcdef', 2, 3);   -- bcd
select substring('abcdef', -2);     -- ef
select left('abcdef', 2), right('abcdef', 2);   -- ab, ef
lcase / ucase 是整串大小写转换,没有现成的“只转首字母”。课件那道题用两个函数拼出来:
select concat(lcase(substring(name, 1, 1)), substring(name, 2)) from score;定位函数是一对参数顺序相反的:
select locate('bc', 'abcdef');   -- 2,参数是(要找的, 在哪儿找)
select instr('abcdef', 'bc');    -- 2,参数是(在哪儿找, 要找的)
两个都从 1 开始编号,找不到返回 0,不是 NULL。strcmp(a, b) 比较两个字符串,相等返回 0,不等返回负数或正数。trim / ltrim / rtrim 去掉两端或单端的空格,从 Excel、CSV 导进来的姓名经常带着看不见的空格,where name = '张三' 查不到,concat('[', name, ']') 一看就露馅。
charset(str) 返回字符串的字符集,collation(str) 返回排序规则。排查乱码时两个都看:前者决定一个字符占几个字节,后者决定字符串怎么比较、怎么排序。
统计一个字符串里某个字符出现几次,可以用“原长度减去删掉该字符后的长度”:
select length('10,A,B') - length(replace('10,A,B', ',', '')); -- 2这个写法只适合单字节字符。要数中文或 emoji,得把 length 换成 char_length,否则减出来的是字节差,不是出现次数。
日期:三个“现在”,加减、差值、格式化
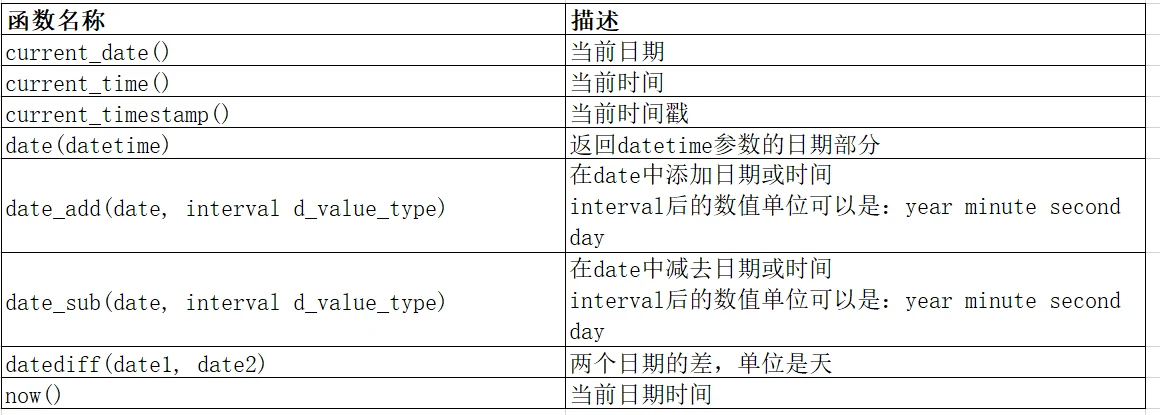
三个“现在”要分清:
select current_date();       -- 2024-03-01
select current_time();       -- 10:00:30
select current_timestamp();  -- 2024-03-01 10:00:30
select now();                -- 同上
current_timestamp() 返回的是 datetime 文本,不是 Unix 秒数。课件表里把它描述成“当前时间戳”,这个说法容易带偏人;真正的秒级时间戳是 unix_timestamp(),反过来用 from_unixtime() 还原。
加减日期的语法是 date_add(日期, interval 数值 单位),date_sub 方向相反:
select date_add('2024-01-31', interval 1 month);   -- 2024-02-29
select date_sub('2024-03-01', interval 2 day);      -- 2024-02-28
select datediff('2017-10-10', '2016-09-01');        -- 404
单位不只表里列的 year、minute、second、day,还有 microsecond、hour、week、month、quarter。
加月有一条裁剪规则:算出来的日期在目标月份不存在时,调整到该月最后一天。2024-01-31 加一个月得到 2024-02-29,不是 3 月 1 日,也不报错。对“每月同一天续费”的业务,这条规则必须知道:1 月 31 日开通的月卡,2 月只能到 28 日或 29 日;一旦被裁到 28 日,下次再加一个月就回不到 31 日,想固定锚定某一天,得单独存“锚定日”或用 last_day() 重算。
datediff(d1, d2) 算的是 d1 - d2,单位是整天,时分秒被忽略,顺序写反就是一屏负数。更细的差用 timestampdiff(单位, 开始, 结束),符号同样取决于参数顺序。date(datetime) 只是把已有的时间截成日期,和 current_date() 不是一回事。
格式化和解析共用一套格式符:
select date_format(sendtime, '%Y-%m-%d %H:%i:%s') from msg;
select str_to_date('2024-03-01 10:00:30', '%Y-%m-%d %H:%i:%s');
%Y 四位年,%m 月,%d 日,%H 24 小时,%i 分钟,%s 秒。最容易混的是 %i(分钟)和 %m(月份),%H(24 小时)和 %h(12 小时)。str_to_date 解析失败不抛异常,返回 NULL,只在 show warnings 里留一条警告,批量导入后要抽查 select count(*) from t where dt is null;。
课件里两个例子正好说明日期函数怎么用:
-- 只显示日期部分
select content, date(sendtime) from msg;

-- 发布时间在 2 分钟内的留言
select * from msg
where date_add(sendtime, interval 2 minute) > '2024-03-01 10:02:00';
第二条返回 hello2:09:58 加两分钟是 10:00,不大于 10:02;10:00:30 加两分钟是 10:02:30,大于 10:02。语义没问题,但函数包在列上,sendtime 上的索引用不上,每一行都要算一次。把函数挪到常量那一侧,结果一样,执行路径不同:
select * from msg
where sendtime > date_sub('2024-03-01 10:02:00', interval 2 minute);按天统计也一样:where date(sendtime) = '2024-03-01' 会逐行算,改成半开区间 sendtime >= '2024-03-01 00:00:00' and sendtime < '2024-03-02 00:00:00',列保持裸的,优化器才能走索引。
数学:取整看方向,format 返回的是字符串
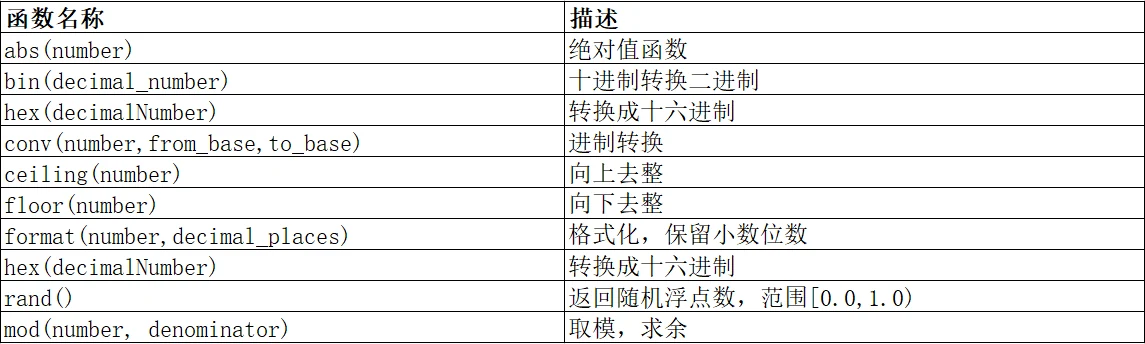
select abs(-100.2);        -- 100.2
select ceiling(23.04);     -- 24,朝正无穷
select floor(23.7);        -- 23,朝负无穷
select ceiling(-23.04);    -- -23
select floor(-23.7); -- -24取整看方向,不看绝对值。ceiling 朝正无穷,floor 朝负无穷,所以负数上取整的结果比原值大,下取整的结果比原值小。
“保留两位小数”有四个脾气不同的函数:
| 函数 | 是否四舍五入 | 返回类型 | 千分位 | 12345.678 |
|---|---|---|---|---|
format(x, 2) | 是 | 字符串 | 有 | '12,345.68' |
round(x, 2) | 是 | 数值 | 无 | 12345.68 |
truncate(x, 2) | 否 | 数值 | 无 | 12345.67 |
cast(x as decimal(10,2)) | 是 | 数值 | 无 | 12345.68 |
课件把 format 描述成“保留 2 位小数(四舍五入)”,漏了后面两条关键信息:它返回字符串,还会插入千分位(默认逗号每三位一组)。把 '12,345.68' 拿去乘一个系数,轻则得到 NULL 或报错,重则被隐式转换成一个错误的数。要参与后续计算用 round,只给人看才用 format;只舍不入的手续费规则用 truncate。
rand() 返回 [0, 1) 之间的小数,floor(rand() * 100) + 1 才是 1 到 100 的整数;rand(n) 给了种子,同一个种子得到同一串可复现的随机数。order by rand() 会为每一行生成随机数再整体排序,大表上很贵,不适合当抽奖方案。
mod(n, m) 取余,符号跟被除数走,mod(-17, 5) 是 -2。bin(10) 是 1010,hex(255) 是 FF,conv('ff', 16, 10) 是 255。表里 hex 重复列了两遍,是排版笔误,不影响使用。
流程控制:if、case,以及 ifnull / coalesce / nullif
if(条件, 真值, 假值) 是最短的条件表达式:
select name, if(math >= 90, '优秀', '普通') from score;条件为真返回第二个参数,否则返回第三个。它只能处理两个分支,分支多了用 case:
select name,
       case
           when math >= 90 then '优秀'
           when math >= 60 then '及格'
           else '不及格'
       end as 等级
from score;
case 还有“简单形式”,拿一个表达式和多个值比:
select name,
       case left(name, 1)
           when '唐' then '师父'
           when '孙' then '徒弟'
           else '路人'
       end as 身份
from score;
两种形式不能混着写:简单形式的 when 后面跟的是值,不能写成 when math >= 60 这种布尔表达式;要写条件,就用 case when 条件 then。
ifnull(a, b) 只在 a 为 NULL 时返回 b;ifnull(0, 'x') 返回 0,ifnull('', 'x') 返回空串,因为 0 和空串都不是 NULL。它是 coalesce 的两参数特例,后者能接任意多个参数,返回第一个非 NULL 的值:
select coalesce(chinese, math, 0) from score;nullif(a, b) 相反,两个值相等时返回 NULL,常用来避免除零:
select 1 / nullif(0, 0); -- NULL类型转换:cast 与 convert
显式转换有两个入口,语义相同,写法不同:
select cast('123' as signed);              -- 123
select cast('12.345' as decimal(6, 2));    -- 12.35
select cast('2024-03-01' as date);         -- 2024-03-01
select cast(now() as char);                -- 2024-03-01 10:00:30
select convert('123', signed);             -- 123
目标类型常用 signed、unsigned、char、date、datetime、decimal(m, n)、binary。cast 是标准 SQL 写法,convert 是 MySQL 自己的函数,两个都认。
不写转换时 MySQL 会隐式转换,方向由上下文决定。'10' + 1 得到 11,因为算术把字符串按数字解析;解析不出数字的字符串按 0 处理,并给一条 warning。比较运算的规则又不一样,把字符串和数字混着比,很容易得到一段“看起来能跑、结果却不对”的查询。要比较或计算,先把类型统一,别依赖隐式转换。
用户、库名、摘要,以及已经消失的 password()
select user();       -- 连接时用的账号
select current_user(); -- 当前语句实际使用的权限账号
select database();   -- 当前库,排查 1146 时好用
select md5('admin'); -- 21232f297a57a5a743894a0e4a801fc3
user() 和 current_user() 在 SQL SECURITY DEFINER 的视图或存储过程里可能不同:前者是你连进来时的账号,后者是对象定义者。
md5 是摘要,不是加密。同一个明文永远得到同一个 32 位十六进制串,没有密钥也就没有“解密”。纯 MD5 存口令在今天不合格,彩虹表能直接反查常见口令;真正的口令存储要用 bcrypt、scrypt、Argon2 这类慢哈希,在应用层做。
课件在“其它函数”那一节还写了 password(),示例是 select password('root');。这个函数在 MySQL 5.7 手册里已经标注废弃并注明 8.0 移除,在 8.0 上执行得到:
ERROR 1305 (42000): FUNCTION password does not exist管理密码的正确入口是语句,不是函数:
create user 'demo'@'localhost' identified by 'Str0ng#Pass';
alter user 'demo'@'localhost' identified by 'N3w#Pass';
还没有评论 — 第一条由你来留。