select * from EMP, DEPT 在 scott 数据上返回 56 行:14 个员工 × 4 个部门。每一行员工都和四个部门各配了一次,大部分配对在业务上毫无意义。复合查询要做的第一件事,就是把这个乘积收回到该有的行数。
先把 scott 三张表建出来
create database if not exists scott default character set utf8mb4;
use scott;

create table EMP (
    empno    int primary key,
    ename    varchar(20) not null,
    job      varchar(20),
    mgr      int,
    hiredate date,
    sal      decimal(7,2),
    comm     decimal(7,2),
    deptno   int
);

insert into EMP values
(7369, 'SMITH',  'CLERK',     7902, '1980-12-17',  800.00, null, 20),
(7499, 'ALLEN',  'SALESMAN',  7698, '1981-02-20', 1600.00, 300.00, 30),
(7521, 'WARD',   'SALESMAN',  7698, '1981-02-22', 1250.00, 500.00, 30),
(7566, 'JONES',  'MANAGER',   7839, '1981-04-02', 2975.00, null, 20),
(7654, 'MARTIN', 'SALESMAN',  7698, '1981-09-28', 1250.00, 1400.00, 30),
(7698, 'BLAKE',  'MANAGER',   7839, '1981-05-01', 2850.00, null, 30),
(7782, 'CLARK',  'MANAGER',   7839, '1981-06-09', 2450.00, null, 10),
(7788, 'SCOTT',  'ANALYST',   7566, '1987-04-19', 3000.00, null, 20),
(7839, 'KING',   'PRESIDENT', null, '1981-11-17', 5000.00, null, 10),
(7844, 'TURNER', 'SALESMAN',  7698, '1981-09-08', 1500.00, 0.00, 30),
(7876, 'ADAMS',  'CLERK',     7788, '1987-05-23', 1100.00, null, 20),
(7900, 'JAMES',  'CLERK',     7698, '1981-12-03',  950.00, null, 30),
(7902, 'FORD',   'ANALYST',   7566, '1981-12-03', 3000.00, null, 20),
(7934, 'MILLER', 'CLERK',     7782, '1982-01-23', 1300.00, null, 10);

create table DEPT (
    deptno int primary key,
    dname  varchar(20) not null,
    loc    varchar(20)
);

insert into DEPT values
(10, 'ACCOUNTING', 'NEW YORK'),
(20, 'RESEARCH',   'DALLAS'),
(30, 'SALES',      'CHICAGO'),
(40, 'OPERATIONS', 'BOSTON');

create table SALGRADE (
    grade int primary key,
    losal decimal(7,2),
    hisal decimal(7,2)
);

insert into SALGRADE values
(1,  700.00, 1200.00),
(2, 1201.00, 1400.00),
(3, 1401.00, 2000.00),
(4, 2001.00, 3000.00),
(5, 3001.00, 9999.00);
单表查询先过一遍
-- 工资高于 500 或岗位是 MANAGER,且姓名首字母为 J
select * from EMP
where (sal > 500 or job = 'MANAGER') and ename like 'J%';

-- 部门号升序,同一部门内工资降序
select * from EMP order by deptno, sal desc;

-- 年薪,comm 可能为 NULL,先兜成 0
select ename, sal * 12 + ifnull(comm, 0) as 年薪
from EMP order by 年薪 desc;

-- 工资最高的人
select ename, job from EMP where sal = (select max(sal) from EMP);

-- 工资高于平均工资的人
select ename, sal from EMP
where sal > (select avg(sal) from EMP);

-- 每个部门的平均工资和最高工资
select deptno, format(avg(sal), 2), max(sal) from EMP group by deptno;

-- 平均工资低于 2000 的部门
select deptno, avg(sal) as avg_sal from EMP
group by deptno having avg_sal < 2000;

-- 每种岗位的人数和平均工资
select job, count(*), format(avg(sal), 2) from EMP group by job;
几条结果先记住:最高工资是 KING 的 5000;全表平均工资约 2073.21,高于它的有 6 个人;部门 10、20、30 的平均工资分别是 2916.67、2175.00、1566.67,只有 30 号部门低于 2000。format(avg(sal), 2) 返回的是字符串,还会带千分位,30 号部门显示成 '1,566.67'。
where 里不能直接用聚合结果,select ename from EMP where sal > avg(sal) 会报 1111。聚合要等到分组之后才存在,where 执行时还没有组;这里必须写成标量子查询。
多表与自连接:先写清谁和谁配
课件那张图画的是笛卡尔积的来历:从 EMP 取第一条,和 DEPT 的四条各配一次,再取第二条,继续配;不加过滤条件,14 × 4 得 56 行。
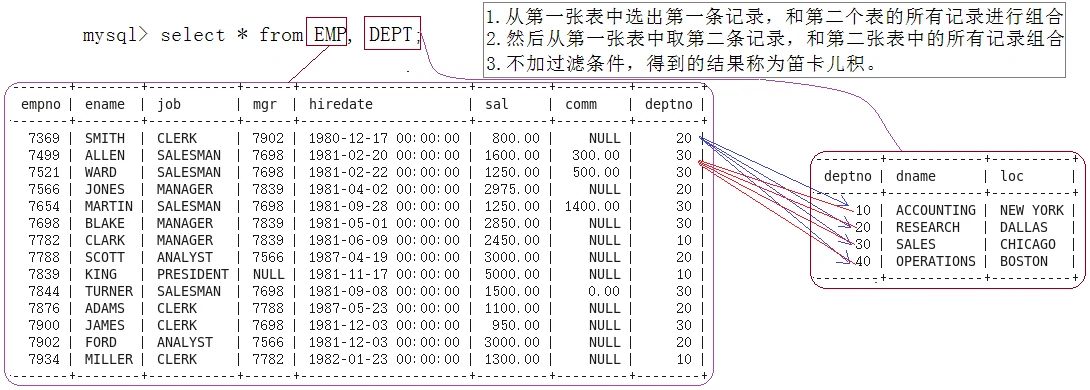
-- 隐式连接:逗号并列,where 里写配对条件
select e.ename, e.sal, d.dname
from EMP e, DEPT d
where e.deptno = d.deptno;

-- 只留 10 号部门
select e.ename, e.sal, d.dname
from EMP e, DEPT d
where e.deptno = d.deptno and d.deptno = 10;

-- 工资落在哪个级别
select e.ename, e.sal, s.grade
from EMP e, SALGRADE s
where e.sal between s.losal and s.hisal;
第一种写法是 SQL-92 之前的隐式连接,配对规则和过滤条件都挤在 where 里。显式写法把配对挪到 on:
select e.ename, e.sal, d.dname
from EMP e
join DEPT d on e.deptno = d.deptno
where d.deptno = 10;内连接下两种写法结果相同,执行计划通常也一样。区别在位置:on 管“谁配谁”,where 管“配完留谁”;换成外连接,这两句话就不能互换。
deptno 在两张表里都有,where deptno = deptno 会报 ERROR 1052 (23000): Column 'deptno' in field list is ambiguous。凡是有可能重名的列,都带上表别名。
区间连接有一个隐含前提:SALGRADE 的五段区间互不重叠。哪天插进一段重叠范围,工资落在重叠区的员工会匹配出两行,行数悄悄变大,而且不报错。等值连接没有这个麻烦,区间连接有,建这种表时得把“不重叠”当成硬规则守住。
自连接是同一张物理表出现两次,必须给两个别名:
-- 子查询写法
select empno, ename from EMP
where empno = (select mgr from EMP where ename = 'FORD');

-- 自连接写法
select leader.empno, leader.ename
from EMP leader, EMP worker
where leader.empno = worker.mgr and worker.ename = 'FORD';
mgr 存的是上级的 empno。worker 是福特,leader 是福特的上级,结果一行 JONES。省掉别名写成 from EMP, EMP,MySQL 会报 Not unique table/alias,它认不出哪一份是领导。
子查询看形状:标量、多行、多列
决定子查询能怎么用的,不是它写在 where 还是 from,而是它返回什么形状。
标量子查询返回一行一列,可以直接当值:
select ename, job from EMP where sal = (select max(sal) from EMP);内层算出 5000,外层就变成 where sal = 5000。两条边界:内层一行都没查到,值就是 NULL,外层 sal = NULL 恒为未知,结果空表,不报错;内层返回多行,MySQL 直接拒绝,报 ERROR 1242 (21000): Subquery returns more than 1 row。
多行一列配 in、any、all:
-- 和 10 号部门岗位相同,但不在 10 号部门
select ename, job, sal, deptno
from EMP
where job in (select distinct job from EMP where deptno = 10)
  and deptno <> 10;

-- 比 30 号部门所有人都高
select ename, sal, deptno from EMP
where sal > all (select sal from EMP where deptno = 30);

-- 比 30 号部门任意一个人高
select ename, sal, deptno from EMP
where sal > any (select sal from EMP where deptno = 30);
> all (子查询) 等价于 > 子查询里的最大值,> any (子查询) 等价于 > 子查询里的最小值。30 号部门的工资是 1600、1250、1250、2850、1500、950,> all 只剩 KING、SCOTT、FORD、JONES 四个;> any 只要高于最低的 950 就算,SMITH 的 800 和 JAMES 的 950 都不满足严格大于,其余 12 行在。
NULL 会改变这两个运算符的结果。子查询里混进一个 NULL,> all 对每一行都得不到真(NULL 比较是 UNKNOWN),整条查询可能一行不出;> any 只要有一个比较为真就返回真,但全为未知时仍是空集。动手前先确认那一列没有 NULL。
exists 和 not exists 只问“能不能查到行”,不关心查到什么:
-- 当过领导的人
select e.empno, e.ename from EMP e
where exists (select 1 from EMP m where m.mgr = e.empno);

-- 从来没当过领导的人
select e.empno, e.ename from EMP e
where not exists (select 1 from EMP m where m.mgr = e.empno);
第二种就是反连接。换成 not in 会踩 NULL:
select empno from EMP where empno not in (select mgr from EMP);mgr 里有一条 NULL(KING 是总裁,上面没人),x not in (7902, NULL) 展开后末项恒为未知,整张表被筛空。先用 not exists,或者把子查询改成 where mgr is not null。
多列子查询用行构造器,让几列作为一个整体比较:
select ename from EMP
where (deptno, job) = (select deptno, job from EMP where ename = 'SMITH')
  and ename <> 'SMITH';
SMITH 是 20 号部门的 CLERK,同部门同岗位的只剩 ADAMS。
课件在这里写“单行子查询是指子查询只返回单列,单行数据”,这句话不准确。单行限制的是行数,不管列数;(select deptno, job from EMP where ename = 'SMITH') 返回的是一行两列,按原文定义它两头不靠。行数、列数是两个独立的坐标,先看行再看列,分类就不会打架。
把聚合结果放进 from
where 里不能出现聚合,但 from 可以接一张“已经算好的临时表”:
select e.ename, e.deptno, e.sal, round(t.asal, 2) as 部门平均
from EMP e
join (
    select deptno, avg(sal) as asal from EMP group by deptno
) t on t.deptno = e.deptno
where e.sal > t.asal;派生表把聚合提前做完,外层只做普通的行过滤。两条硬规矩:from 后面接派生表时必须给别名,否则报 Every derived table must have its own alias;里面 select 的非聚合列也必须出现在自己的 group by 里,only_full_group_by 开着时照样管它。
同一个形状可以求“每个部门工资最高的人”:
select e.ename, e.deptno, e.sal, t.ms
from EMP e
join (
    select deptno, max(sal) as ms from EMP group by deptno
) t on t.deptno = e.deptno and e.sal = t.ms
order by e.deptno, e.ename;
出来 4 行:10 号 KING,20 号 FORD 和 SCOTT 并列 3000,30 号 BLAKE。最高工资可能不止一个人,别默认“每组一行”。需求是每组只留一个,才轮到 row_number() 那类窗口函数。
“每个部门的信息和人员数量”有两种写法。课件方法一是 EMP join DEPT 后 group by DEPT.deptno, dname, loc;方法二是把 select count(*), deptno from EMP group by deptno 当临时表再和 DEPT 连。两种写法都以 EMP 为起点,40 号部门没有员工,都不会出现。要四个部门都在,得让 DEPT 当驱动表:
select d.deptno, d.dname, d.loc, count(e.empno) as 人数
from DEPT d
left join EMP e on e.deptno = d.deptno
group by d.deptno, d.dname, d.loc;
count(e.empno) 而不是 count(*):40 号部门那一行是“部门 + 全 NULL 员工”,count(*) 会数成 1,count(e.empno) 才是 0。
union 默认帮你去重
select ename, sal, job from EMP where sal > 2500
union
select ename, sal, job from EMP where job = 'MANAGER';
左边 5 人(JONES、BLAKE、SCOTT、KING、FORD),右边 3 人(JONES、BLAKE、CLARK)。union 去掉重复行,结果 6 行;union all 不去重,结果 8 行,JONES 和 BLAKE 各出现两次。
课件在 union all 那一节的案例文字写的是“工资大于 25000”,下面贴的 SQL 和输出却是 2500。按 25000 跑,scott 数据里一个人都不满足,结果会是空集;这里按 2500 理解才对。
几条规定:
- 两段的列数必须相同,否则报
ERROR 1222 (21000): The used SELECT statements have a different number of columns。 - 列名取第一个
select的,第二段只按位置对齐;列顺序写反不会报错,数据会串位。 - 类型要能兼容,
union会按合并规则统一类型,把字符串和数字混在一起容易得到意外的比较结果。 order by属于整个union,写在最后,不能只给某一段排序。- 课件
union的输出看着有固定顺序,但语句里没有order by,那个顺序只是某次执行恰好落在临时表上的结果,不能当契约。
union 为了去重通常要做一次排序或哈希,union all 直接把两段堆起来,只在确定两边不会重复、或者重复了也无所谓时用 union all。
limit 分页,以及多列分组、聚合嵌套
分页的三种写法:
select empno, ename from EMP order by empno limit 5;
select empno, ename from EMP order by empno limit 5, 5;
select empno, ename from EMP order by empno limit 5 offset 5;
偏移量从 0 开始,第 K 页、每页 N 条,偏移量是 (K-1)*N。分页必须带 order by,否则“第一页”和“第二页”的边界没有定义;排序键有重复值时,还要加一个唯一键做决胜键,否则同分的行可能在两页之间重复或漏掉。深分页 limit 100000, 10 要先扫掉前十万行,数据量大时改用游标分页:where empno > 7900 order by empno limit 5,下一页再把 7900 换成上一页最后一条的 empno。
group by 可以按多列分组:
select deptno, job, count(*), avg(sal)
from EMP
group by deptno, job;
分组看的是 (deptno, job) 组合。select deptno, ename, avg(sal) from EMP group by deptno 在 only_full_group_by 下会报 1055,因为 ename 既不是分组列,也没被聚合包住。
聚合函数不能嵌套。select avg(max(sal)) from EMP group by deptno 会报 1111,因为内层聚合的结果是一组值,外层聚合没有对应的行集合。要“各部门最高工资的平均”,先让内层算出一张表:
select avg(ms) from (
    select max(sal) as ms from EMP group by deptno
) t;
内层给出 5000、3000、2850,外层求平均,得到 3616.67。分组只对出现过的值成立,40 号部门没有员工,group by deptno 不会凭空多出一组;要补齐空组,仍然是左连接加 count(被连接表的主键)。
还没有评论 — 第一条由你来留。