选一个类型要回答三个问题:占几个字节、能表示多大范围、超出范围时是报错还是悄悄改写。MySQL 在这三件事上并不统一,整数越界报错,浮点越界常常只留一条警告,时间类型又会自己填当前时间。把这些边界摸清楚,比记类型名有用。
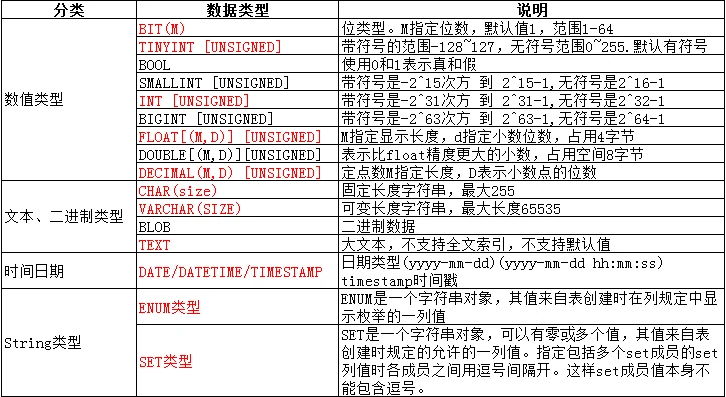
整数:范围由字节数算出来,括号里的数字不管范围
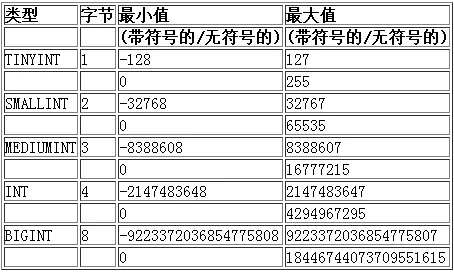
tinyint 占 1 字节,默认有符号,范围 -128 到 127:
CREATE TABLE tt1 (num tinyint);
INSERT INTO tt1 VALUES (1);
INSERT INTO tt1 VALUES (128);
-- ERROR 1264 (22003): Out of range value for column 'num' at row 1
负数的绝对值比正数多一个,是补码的必然结果。加 unsigned 后负数区间整段取消,上限从 127 抬到 255:
CREATE TABLE tt2 (num tinyint unsigned);
INSERT INTO tt2 VALUES (-1);
-- ERROR 1264 (22003): Out of range value for column 'num' at row 1
INSERT INTO tt2 VALUES (255);| 类型 | 字节 | 有符号范围 | 无符号上限 |
|---|---|---|---|
| tinyint | 1 | -128 ~ 127 | 255 |
| smallint | 2 | -32768 ~ 32767 | 65535 |
| mediumint | 3 | -8388608 ~ 8388607 | 16777215 |
| int | 4 | -2147483648 ~ 2147483647 | 4294967295 |
| bigint | 8 | -2^63 ~ 2^63-1 | 2^64-1 |
课件建议尽量不用 unsigned,宁可把 int 升成 bigint。理由在减法上:SELECT CAST(0 AS UNSIGNED) - 1; 返回 18446744073709551615,不是 -1。多花四个字节换掉这个隐患,值得。
mediumint 占 3 字节,既不是 2 的整数次幂,也不在多数语言的标准整型里,驱动和 ORM 对它的支持不如 int 稳,除非做历史数据迁移,一般跳过。
desc 输出里的 tinyint(3)、int(10),括号中的数字是显示宽度,只影响 zerofill 补零,不改变存储和范围。MySQL 8.0.17 起整数显示宽度被标为废弃,8.0.19 之后连 SHOW CREATE TABLE 都不再输出(tinyint(1) 例外)。bool 和 boolean 也不是独立类型,就是 tinyint(1) 的别名,占一字节,不是一位。
bit:M 位二进制,返回的不是 ASCII 字符
CREATE TABLE tt4 (id int, a bit(8));
INSERT INTO tt4 VALUES (10, 10);
INSERT INTO tt4 VALUES (65, 65);
SELECT * FROM tt4;
第二行显示为 A,第一行的 a 看着是空白。课件把原因写成“按 ASCII 码对应的值显示”,这个说法只在 M 不超过 8、且字节落在可打印区间时成立。真实行为是:BIT 列返回的是二进制串,客户端按原始字节打印。10 的二进制是 00001010,即 0x0A,恰好是换行符;65 是 0x41,即大写 A。M 大于 8 时按多字节存,打印出来的往往不是可打印字符。
想看清值,用函数转换:
SELECT id, BIN(a), HEX(a) FROM tt4;bit(M) 的 M 范围是 1 到 64,省略时默认 1。只存 0/1 时可以用 bit(1),插入 2 会越界:
CREATE TABLE tt5 (gender bit(1));
INSERT INTO tt5 VALUES (2);
-- ERROR 1406 (22001): Data too long for column 'gender' at row 1
注意错误码是 1406(数据超长),不是整数越界的 1264。bit(1) 确实省空间,但多数驱动把它当字节数组返回,业务代码还得解码一次;普通表里 tinyint(1) 更省心。
float 给近似值,decimal 给十进制位
CREATE TABLE tt6 (id int, salary float(4,2));
INSERT INTO tt6 VALUES (100, -99.99);
INSERT INTO tt6 VALUES (101, -99.991);   -- 多出的一位被舍掉
float(m,d) 里 m 是总位数、d 是小数位。float(4,2) 表示两位整数加两位小数,有符号范围 -99.99 到 99.99;float(6,3) 则是 -999.999 到 999.999。float 占 4 字节,double 占 8 字节。
加上 unsigned 后范围变成 0 到 99.99,越过 0 的行为和整数不同:
CREATE TABLE tt7 (id int, salary float(4,2) unsigned);
INSERT INTO tt7 VALUES (100, -0.1);
-- Query OK, 1 row affected, 1 warning
SHOW WARNINGS;
-- 1264 Out of range value for column 'salary' at row 1
语句成功,值被夹到 0,只留一条警告。排查小数异常时别只看有没有报错。
精度上 float 和 decimal 的差距可以直接看到:
CREATE TABLE tt8 (id int, salary float(10,8), salary2 decimal(10,8));
INSERT INTO tt8 VALUES (100, 23.12345612, 23.12345612);
SELECT * FROM tt8;
-- salary = 23.12345695,salary2 = 23.12345612
单精度浮点用二进制科学计数法存储,折算成十进制大约 7 位有效数字,23.12345612 有 10 位,多出来的部分只能落到最近的邻居上。double 也是近似值,只是把误差推后。
decimal(m,d) 按十进制位存储,插什么读什么。m 最大 65,d 最大 30,d 不能大于 m;decimal 不带参数时默认是 (10,0)。decimal(5,2) 的范围是 -999.99 到 999.99,加 unsigned 则是 0 到 999.99。它比浮点占空间,但金额、费率、税额这类要拿去算钱的列只有它靠得住。
MySQL 8.0.17 起 float(m,d)、double(m,d) 的指定位数写法也被标为废弃,新表直接写 float 或 double,需要精确小数就交给 decimal。
char 和 varchar:L 都是字符数,65535 是字节数
CREATE TABLE tt9 (id int, name char(2));
INSERT INTO tt9 VALUES (100, 'ab');
INSERT INTO tt9 VALUES (101, '中国');
char(2) 能存两个字符,字母或汉字都算一个,上限 255。前提是列的字符集能存中文,utf8mb4 或 gbk 都行;默认 latin1 的库会直接报 Incorrect string value。
CREATE TABLE tt10 (id int, name char(256));
-- ERROR 1074 (42000): Column length too big for column 'name' (max = 255); use BLOB or TEXT instead
varchar(L) 的 L 同样是字符数,但整行受“一行 65535 字节”的总量限制。课件写“最大长度 65535 个字节”,容易被读成 L 的上限,实际 L 的上限要按字符集的单字符字节数折算:
CREATE TABLE v1 (name varchar(21845)) CHARSET=utf8;
-- ERROR 1118 (42000): Row size too large. The maximum row size for the used table type,
-- not counting BLOBs, is 65535. You have to change some columns to TEXT or BLOBs

CREATE TABLE v2 (name varchar(21844)) CHARSET=utf8;
-- 成功
utf8mb3 一个字符最多 3 字节,3 × 21844 = 65532,再加上长度前缀和可空标记,刚好卡在 65535。换成 utf8mb4,一个字符最多 4 字节,上限降到 16383。老教程里 varchar(20000) 在 8.0 上建不出来,原因就在默认字符集变成了 utf8mb4。
课件说“有 1 到 3 个字节用于记录数据大小”,多算了一截。VARCHAR 的长度前缀只有 1 或 2 字节,按列的最大存储长度决定;列可空时整行另加 1 字节的 NULL 标记。65532 = 65535 - 2 - 1,这个结论碰巧是对的,过程不对。
两种类型还有一处行为差异:CHAR 存储时右侧补空格,取出时默认把尾部空格去掉(除非开启 PAD_CHAR_TO_FULL_LENGTH,这个模式在 8.0.13 起也已废弃);VARCHAR 存什么取什么。用 char 存用户输入,末尾的空格会悄悄消失。空间分配上,CHAR 按声明的 L 个字符固定预留,VARCHAR 按实际内容占用,再额外存一份长度前缀。
选型:长度天生固定的用 char(身份证、手机号、md5、国家代码),长度会变的用 varchar(姓名、地址、标题),并保证最长的值也塞得进去。课件说“定长效率高、变长效率低”,在 InnoDB 的 DYNAMIC 行格式下差距没有想象中大,别为了这句话把地址塞进 char。
日期时间:三个类型,三种存储和时区行为
CREATE TABLE birthday (t1 date, t2 datetime, t3 timestamp);
INSERT INTO birthday (t1, t2) VALUES ('1997-7-1', '2008-8-8 12:1:1');
SELECT * FROM birthday;| 类型 | 占用 | 范围 | 时区 |
|---|---|---|---|
| date | 3 字节 | 1000-01-01 ~ 9999-12-31 | 无关 |
| datetime | 5 字节 | 1000-01-01 00:00:00 ~ 9999-12-31 23:59:59 | 原样存原样取 |
| timestamp | 4 字节 | 1970-01-01 00:00:01 UTC ~ 2038-01-19 03:14:07 UTC | 存 UTC,按会话时区显示 |
date 的显示格式是 YYYY-MM-DD,datetime 与 timestamp 是 YYYY-MM-DD HH:MM:SS。输入时不必补零,'1997-7-1' 会被规整成 1997-07-01。
课件写 DATETIME “占用八字节”,那是 5.6.4 之前的旧数据。从 5.6.4 起 DATETIME 是 5 字节,需要小数秒时另加 0 到 3 字节,写成 datetime(3);TIMESTAMP 仍是 4 字节,加小数秒同理。课件说 TIMESTAMP “从 1970 年开始”,漏掉了上界,它只能表示到 2038 年初,这是 32 位秒数计数的硬限制。
上面那段插入只给了 t1、t2,t3 却自动填了当前时间;随后 update 改 t1,t3 又跳成新的当前时间。这不是类型自带的魔法:MySQL 5.7 默认 explicit_defaults_for_timestamp=OFF,表里第一个 TIMESTAMP 列会自动获得 DEFAULT CURRENT_TIMESTAMP ON UPDATE CURRENT_TIMESTAMP。8.0 把这个开关默认打开,自动行为消失,要自动填、自动更新就得写出来:
CREATE TABLE log_t (
    id         int PRIMARY KEY AUTO_INCREMENT,
    content    varchar(100),
    created_at timestamp DEFAULT CURRENT_TIMESTAMP,
    updated_at timestamp DEFAULT CURRENT_TIMESTAMP ON UPDATE CURRENT_TIMESTAMP
);
时区差异值得亲手看一次:
CREATE TABLE tz_demo (d datetime, t timestamp);
INSERT INTO tz_demo VALUES ('2024-01-01 08:00:00', '2024-01-01 08:00:00');

SET time_zone = '+00:00';
SELECT * FROM tz_demo;
-- d 仍是 2024-01-01 08:00:00;t 变成 2024-01-01 00:00:00
存生日、合同到期日、很远的未来,用 date 或 datetime;只有需要数据库自动维护、且确定落在 2038 年之前的列才用 timestamp。
enum 和 set:界面上是标签,磁盘上是数字
CREATE TABLE votes (
    username varchar(30),
    hobby    set('登山','游泳','篮球','武术'),
    gender   enum('男','女')
);
enum 是单选,成员按声明顺序对应数字 1、2、3……,最多 65535 个,存储占 1 或 2 字节;set 是多选,成员对应位图 1、2、4、8……,最多 64 个,存储占 1 到 8 字节。set 的位分配和 Linux 的权限位是同一套思路,一个成员占一个二进制位。两者都可以用数字插入,也可以按位置查询:
INSERT INTO votes VALUES ('雷锋', '登山,武术', '男');
INSERT INTO votes VALUES ('Juse', '登山,武术', 2);

SELECT * FROM votes WHERE gender = 2;   -- 查出 Juse,界面显示“女”
用数字写枚举值不利于阅读,成员顺序一调整,代码里的数字全部错位。
多选查询最容易写错:
SELECT * FROM votes WHERE hobby = '登山';             -- 只命中“唯一爱好是登山”的人
SELECT * FROM votes WHERE FIND_IN_SET('登山', hobby);  -- 三个都命中
FIND_IN_SET(sub, str_list) 按逗号切片后做整项匹配,sub 在列表里返回从 1 开始的位置,不在返回 0,任一参数为 NULL 返回 NULL。用 LIKE '%登山%' 会把“登山鞋”也捞进来,FIND_IN_SET 不会。
ORDER BY gender 排的是内部序号,不是汉字的拼音或笔画序,报表里“顺序看着怪”多半是这个原因。要做可读的排序,存一列明确的 sort_no 更稳。
比较时的隐式转换
SELECT '1' + 1;      -- 2
SELECT 'abc' = 0;    -- 1
MySQL 在一侧是数字、另一侧是字符串时,会把字符串按前导数字部分转成数字。'abc' 的前导数字是 0,所以它和 0 相等。这个规则落到查询上就是:
CREATE TABLE t (v varchar(10));
INSERT INTO t VALUES ('abc'), ('0'), ('1');

SELECT * FROM t WHERE v = 0;    -- 命中 abc 和 0
SELECT * FROM t WHERE v = '0';  -- 只命中 0
把数字存成 varchar 再拿去做数值比较,会同时踩两个坑:查询命中范围被放大,'10' < '9' 在字符串序里也成立。需要比较大小就存数值类型,需要保留前导零(订单号、邮编)才存字符串,比较时显式 CAST(v AS UNSIGNED) 或统一成字符串。
float 和 decimal 之间比较也受转换影响,近似值参与比较时结果可能和肉眼看到的不一致。金额列统一用 decimal,参与计算的临时值也用 decimal,别在半路换回 float。
还没有评论 — 第一条由你来留。