同一个库目录里,users 有 .frm、.MYD、.MYI 三个文件,person 只有 .frm 和 .ibd。差异不在表结构,而在建表时写的 engine 选项。
表的文件数取决于引擎
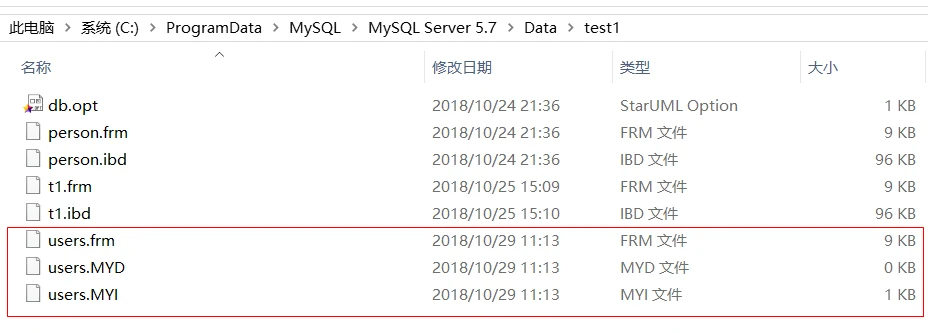
MyISAM 把一张表拆成三份:
.frm:表结构,列名、类型、字符集、索引定义都在这。.MYD:My Data,行数据。.MYI:My Index,索引。
InnoDB 在 5.7 里是 .frm 加 .ibd,结构和索引都在独立表空间 .ibd 里,前提是 innodb_file_per_table=ON(5.6.6 之后默认开启)。8.0 移除了 .frm,表结构进了 InnoDB 数据字典,information_schema 是它的对外视图;MyISAM 这类非 InnoDB 表改用 .sdi 存结构,.MYD、.MYI 照旧。
课件那句“创建一个 engine 是 innodb 的数据库,观察存储目录”要改一下:engine 是表级属性,不是库级属性。建库语句里写 ENGINE=InnoDB 是无效的,只有在 create table 的表选项里写才生效。
不看文件也能知道引擎和体积:
SHOW TABLE STATUS LIKE 'users'\GEngine 是实际引擎,Collation 是排序规则,Data_length、Index_length 是数据和索引占用的字节数,Data_free 反映碎片。InnoDB 的 Rows 是采样估算,判断“小表还是大表”够用,做精确对账不行。
建表语句在定四件事
CREATE TABLE table_name (
    field1 datatype,
    field2 datatype,
    field3 datatype
) CHARACTER SET 字符集 COLLATE 校验规则 ENGINE 存储引擎;
field 是列名,datatype 是类型,花括号外那三个选项分别定字符串怎么存、怎么比较、数据怎么组织。字符集不写就继承所在库的字符集,排序规则不写就继承所在库的排序规则,引擎不写就用 default-storage-engine。继承意味着库一改,之后新建的表就跟着漂,显式写出来更稳。
课件给的表:
CREATE TABLE users (
    id       int,
    name     varchar(20) COMMENT '用户名',
    password char(32)    COMMENT '密码是32位的md5值',
    birthday date        COMMENT '生日'
) CHARACTER SET utf8 ENGINE=MyISAM;
COMMENT 是列注释,写在类型后面,DESC 里看不到它,只有 SHOW CREATE TABLE 和 information_schema.COLUMNS 能看到。char(32) 用来放 md5 是对的,md5 固定 32 个十六进制字符;varchar(20) 的 20 是字符数,不是字节数。utf8 这里是 utf8mb3 的别名,最多 3 字节,新表应写 utf8mb4。
重复执行同一条建表语句会报:
ERROR 1050 (42S01): Table 'users' already exists加 IF NOT EXISTS 可以静默跳过。它只防“表已存在”,不防“表结构不同”,初始化脚本里常用,业务代码里别指望它自动改表。
CREATE TABLE IF NOT EXISTS demo (
    id int PRIMARY KEY,
    name varchar(20) NOT NULL DEFAULT ''
);
DESC 里出现的 int(11),括号中的 11 是显示宽度,只在 zerofill 时影响补零,不改变取值范围。MySQL 8.0.17 起整数显示宽度被标为废弃,8.0.19 之后输出里不再显示(tinyint(1) 例外,很多驱动拿它当布尔)。5.7 看得到括号,8.0 看不到,两边都正常。
DESC 的六列,和它看不到的七件事
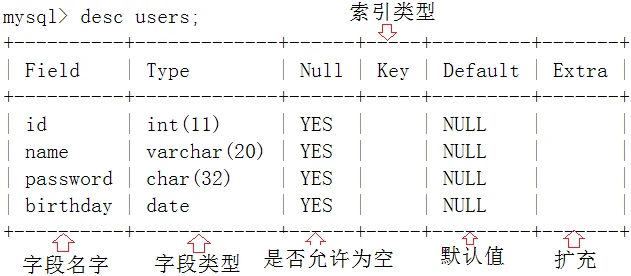
Key 列的取值有含义:PRI 是主键,UNI 是唯一索引,MUL 是普通索引或外键列,同一列可以有多个索引时优先显示 PRI。
DESC 是 DESCRIBE 的缩写,SHOW COLUMNS FROM users; 输出完全一样。它看不到字符集、排序规则、引擎、表注释、列注释、索引细节和建表时的其他选项,要看完整定义得用:
SHOW CREATE TABLE users\G\G 把结果竖排,长语句不会挤成一行。改表前后各跑一次对比,比只看 Query OK 可靠。
索引单独看:
SHOW INDEX FROM users;Key_name 是索引名,Non_unique 为 0 表示唯一,Seq_in_index 是这一列在联合索引里的位置,Cardinality 是优化器估算的不同值个数。INDEX idx_ab (a, b) 和 INDEX idx_ba (b, a) 是两棵树,能支持的查询不一样。
列级细节要查元数据:
SELECT COLUMN_NAME, COLUMN_TYPE, IS_NULLABLE,
       CHARACTER_SET_NAME, COLLATION_NAME, COLUMN_COMMENT
FROM information_schema.COLUMNS
WHERE TABLE_SCHEMA = 'test' AND TABLE_NAME = 'users';
ALTER 改列是把整列定义换掉
先往 users 插两行,再在 birthday 后面加一列:
INSERT INTO users VALUES (1,'a','b','1982-01-04'),(2,'b','c','1984-01-04');

ALTER TABLE users
    ADD assets varchar(100) COMMENT '图片路径' AFTER birthday;
ADD 只动结构,旧数据保留,新列在旧行上取 NULL 或默认值。AFTER 决定列的位置,不写就追加到末尾。如果新列是 NOT NULL 又没有默认值,严格模式下会直接拒绝,因为服务器不知道该给旧行填什么;非严格模式下可能填 0 或空串,得到一列“看着有值、其实全是占位”的数据。稳妥的做法是先带默认值加列,再 UPDATE 回填。
ALTER TABLE users MODIFY name varchar(60);执行后 DESC 显示 varchar(60),但原来那句 COMMENT '用户名' 已经没了。MODIFY 的语义是“用你给的定义替换整列”,不是“在原定义上打补丁”:旧定义里有、新定义里没写的属性,不会自动带过去。只改长度也要把属性抄全:
ALTER TABLE users MODIFY name varchar(60) COMMENT '用户名';改列名用 CHANGE,语法多一个旧列名,新定义同样必须完整:
ALTER TABLE users CHANGE name xingming varchar(60) COMMENT '用户名';课件说 change name xingming varchar(60) 里“新字段需要完整定义”,这点是对的;只写 CHANGE name xingming 会直接语法错误。
删列的语法课件写成了 ALTER TABLE tablename DROP (column);,那对括号是文档里的占位符,MySQL 不接受这种写法,照抄会得到 1064。正确写法:
ALTER TABLE users DROP COLUMN password;删列会连同这一列的数据一起消失,不能回滚。ADD、MODIFY、DROP 三个子句都不带那对括号,多个列用逗号分隔。
改约束也走 ALTER TABLE:
ALTER TABLE users ADD PRIMARY KEY (id);
ALTER TABLE users ADD UNIQUE KEY uk_name (name);
ALTER TABLE users MODIFY name varchar(60) NOT NULL DEFAULT '';把长度改小要小心。varchar(60) 改回 varchar(20) 时,表里若有超过 20 个字符的值,严格模式会报错拒绝,非严格模式可能截断。缩之前先查:
SELECT MAX(CHAR_LENGTH(name)) FROM users;大表上加索引或改列,可以显式要求在线执行。MySQL 做不到时宁可报错,也不偷偷锁表:
ALTER TABLE users ADD INDEX idx_name (name), ALGORITHM=INPLACE, LOCK=NONE;改列类型、改字符集属于重建表,ALGORITHM=INPLACE 未必支持,报错时再评估停机窗口。
DROP、TRUNCATE、RENAME 三种“删”
DROP TABLE t1;
DROP TABLE IF EXISTS t1, t2;
DROP TABLE 删掉结构、数据、索引和触发器,没有回收站。IF EXISTS 只防“表不存在”,不防“表名写错”:DROP TABLE IF EXISTS userss 多打一个字母,它会安静地什么都不做。
清空数据但保留结构:
TRUNCATE TABLE users;TRUNCATE 通常直接重建表空间,比逐行 DELETE 快,但它是 DDL,会隐式提交、不能回滚,也不触发 DELETE 触发器。它会把自增值重置回 1,DELETE 不会。
改名用 RENAME TABLE,可以一条语句改多张:
RENAME TABLE users TO users_bak,
             employee TO users;
整个过程是原子的,要么全成要么全败。常拿它做表切换:先建好 users_new 灌完数据,再一次改名把新旧两张表换过来,应用几乎无感。单张表也能用 ALTER TABLE users RENAME TO employee;,TO 可以省略。
复制表结构有两种,差别不小:
CREATE TABLE users_copy LIKE users;
CREATE TABLE users_copy AS SELECT * FROM users;
LIKE 会带上索引、字符集、引擎和注释,但不复制外键;AS SELECT 只按结果集推断列,索引和注释通常都丢。
删表前至少查一遍依赖。视图和存储过程里的表名是文本引用,删表不会报错,下次访问才失败;外键在 foreign_key_checks=1 时会直接阻止删除:
SELECT TABLE_NAME FROM information_schema.VIEWS
WHERE TABLE_SCHEMA = 'test';

SELECT CONSTRAINT_NAME, TABLE_NAME, REFERENCED_TABLE_NAME
FROM information_schema.REFERENTIAL_CONSTRAINTS
WHERE CONSTRAINT_SCHEMA = 'test';
应用代码、定时任务、监控脚本里写死的表名查不到,删之前先确认没有别的程序在读它。
临时表只活在当前会话
CREATE TEMPORARY TABLE tmp_users (
    id int,
    name varchar(20)
);

INSERT INTO tmp_users SELECT id, name FROM users;
SELECT * FROM tmp_users;

DROP TEMPORARY TABLE tmp_users;临时表只在创建它的会话里可见,会话断开就自动删除,别的连接看不到也查不到。名字和普通表重名时,当前会话访问的是临时表,普通表被遮蔽。TEMPORARY 不影响引擎,不写 ENGINE 时仍用 default-storage-engine,只有显式写 ENGINE=MEMORY 才会落到内存里。
DROP TEMPORARY TABLE 只删临时表,不会误删同名普通表,写清理脚本时用它比 DROP TABLE 安全。它的生命周期止于当前会话,别把它当跨会话的缓存用。
还没有评论 — 第一条由你来留。