int rand = 10; 和 <stdlib.h> 放进同一个源文件,MSVC 直接停下:
error C2365: “rand”: 重定义;以前的定义是“函数”rand 在 <stdlib.h> 里是函数声明,这里又想声明同名变量。C 只有一层全局域,函数和变量挤在同一张名字表里,撞上就报错。改名能躲开这一次,躲不开下一次:data、index 这类词在多人协作的项目里迟早会撞第二回。
从 1979 到 C++26:一个标准隔三年
1979 年,Bjarne Stroustrup 在贝尔实验室做模拟和操作系统方向的研究,觉得 C 在表达能力、可维护性上不够用。1983 年,他在 C 的基础上加入类、封装、继承,语言正式命名为 C++。1989 年 ANSI 与 ISO 成立联合标准化委员会;1994 年拿出第一份草案;惠普实验室的 Alexander Stepanov、Meng Lee、David Musser 做的 STL 被投票并入标准,这件事也拖慢了标准化的进度;1997 年 11 月 14 日通过最终草案,1998 年发布,编号 ISO/IEC 14882:1998。
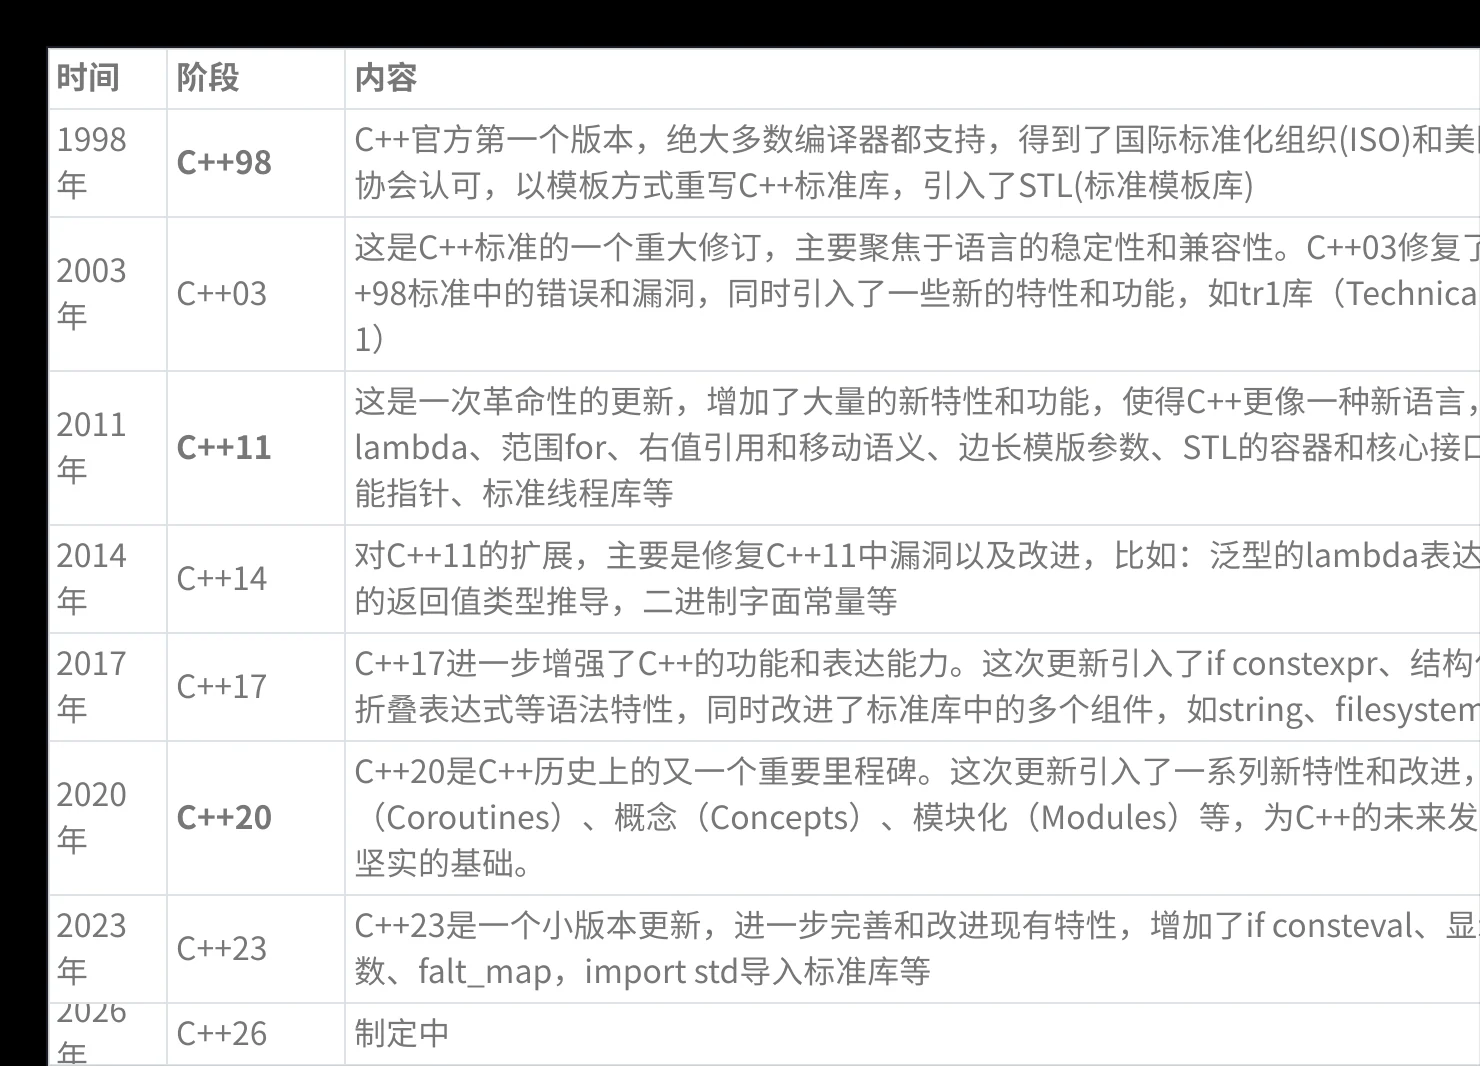
之后每三年左右一个版本,关键词可以浓缩着记:C++98 是第一个正式版本,模板和 STL 落地;C++03 修 98 的漏洞,引入 tr1 库;C++11 是一次大改,lambda、范围 for、右值引用与移动语义、变长模板、线程库全在这一版;C++14 补 11 的细节,有泛型 lambda、返回类型推导、二进制字面量;C++17 加了 if constexpr、结构化绑定、折叠表达式,标准库补上 filesystem、string_view、并行算法;C++20 带来协程、concepts、modules、ranges;C++23 是小版本,有 if consteval、deducing this、flat_map、import std;C++26 还在制定。
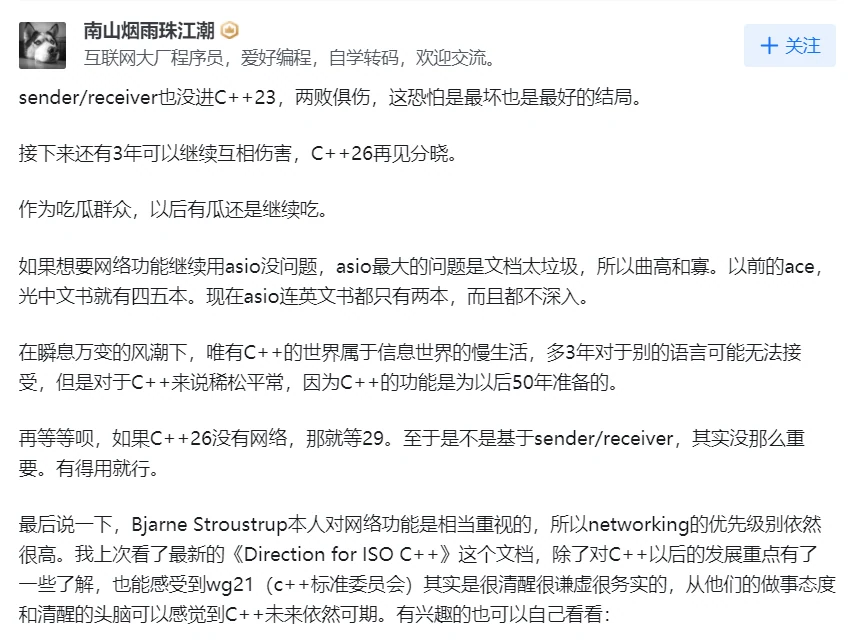
C++23 有一个被反复讨论的缺口:网络库(networking)原本排在 C++23 的计划里,最终没有进入,sender/receiver 方案也随之落空,只能等后续版本。
查语法用三份资料:legacy.cplusplus.com 按头文件组织、示例多,但只更新到 C++11;zh.cppreference.com 与 en.cppreference.com 是同一套文档的中英文版,覆盖最新标准,细节全但读得慢。
书三本:C++ Primer 当语法字典,看不懂多少算多少;STL 源码剖析(侯捷)从实现角度看容器,适合学完容器之后读;Effective C++ 的 55 条使用条款,工作一两年后重读收获更大。
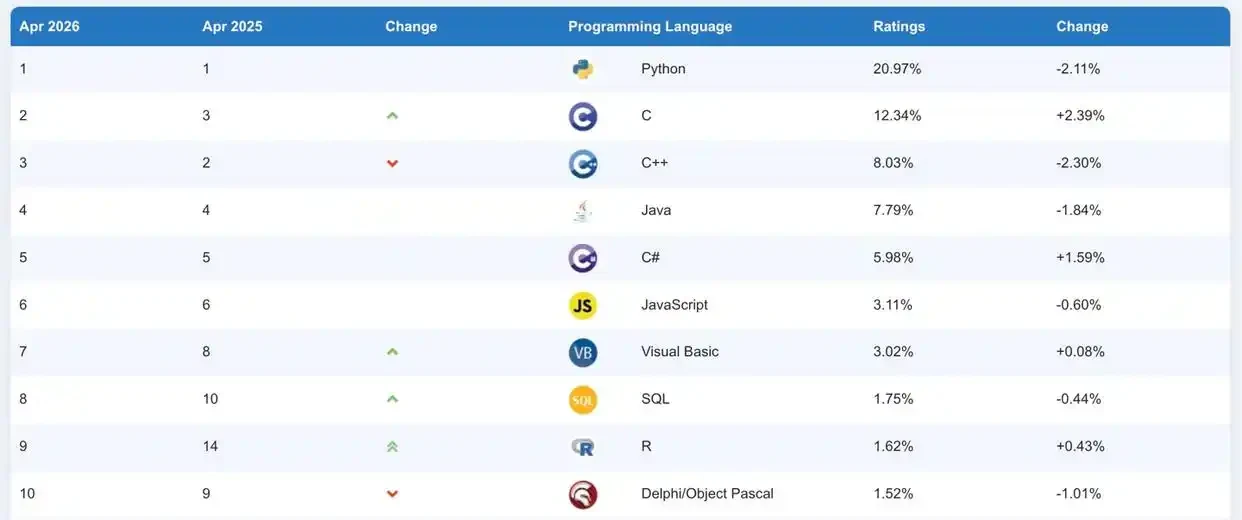
排行榜衡量热度,岗位说明用途
TIOBE 依据搜索热度、课程和厂商数量,只反映一门语言被讨论的热度,不代表语言好坏。
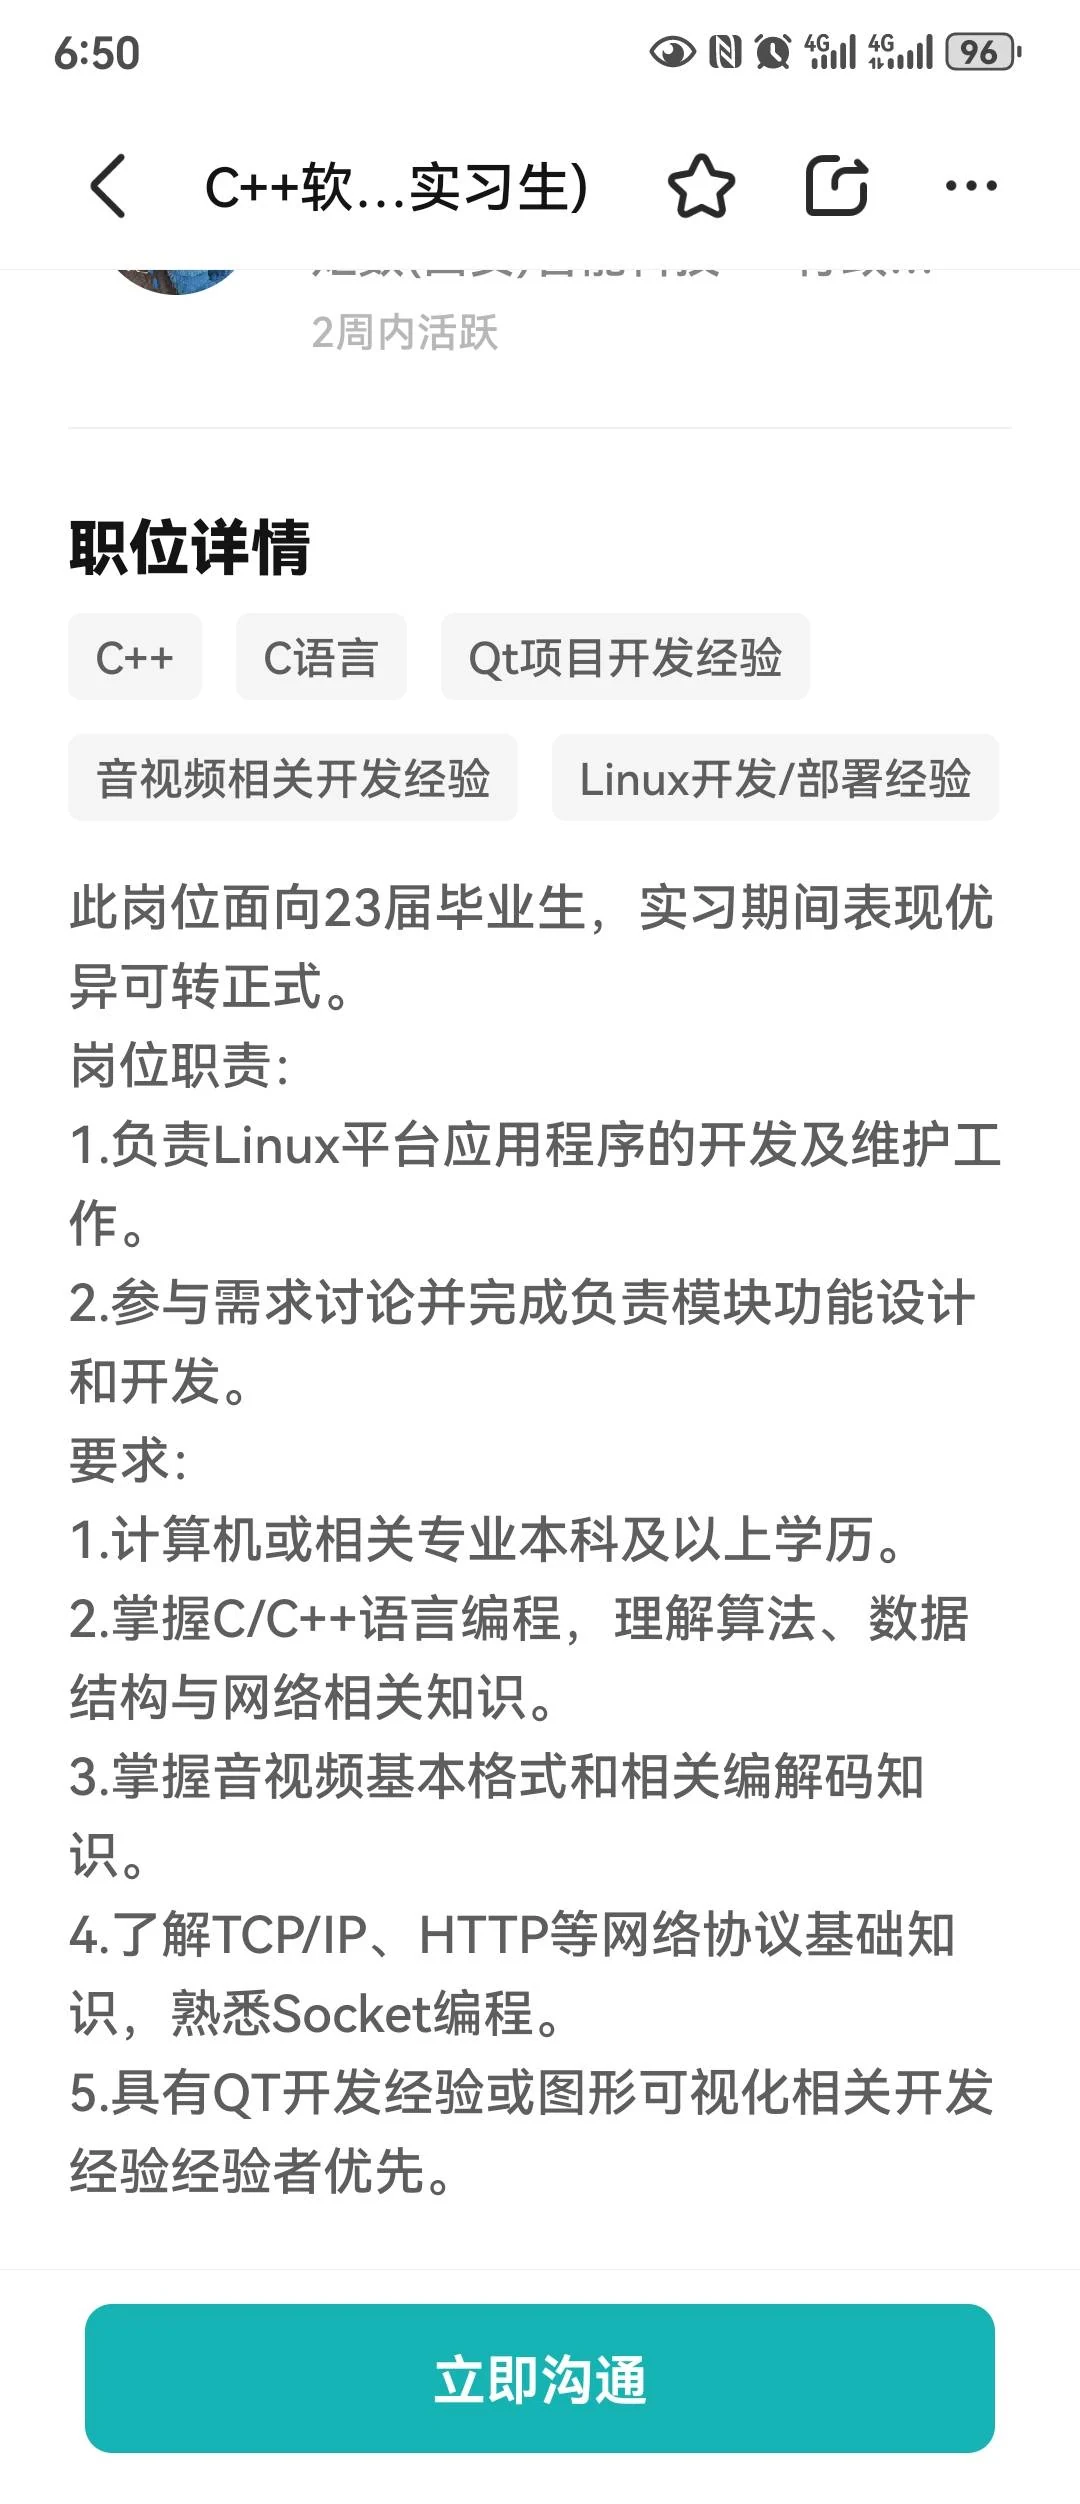
C++ 落地的方向大致是这些:
- 大型系统软件:编译器、数据库、操作系统、浏览器。
- 音视频处理:FFmpeg、WebRTC、Mediasoup、ijkplayer,这条技术栈的主体就是 C++。
- PC 客户端:Windows 桌面软件配合 Qt,Qt 是跨平台的 C++ 图形界面库。
- 服务端:高并发后台,游戏服、流媒体、量化高频交易这类对延迟敏感的场景。
- 游戏引擎:UE4、Cocos2d-x,需要图形学、引擎框架和源码阅读。
- 嵌入式:应用与驱动两个方向,智能手环、摄像头、扫地机器人、车载系统。
- 机器学习引擎:底层算子多用 C++ 实现,上层用 Python 封装;只做数据训练会 Python 就够了,做系统开发要会 C++。
- 测试开发:Selenium、JMeter 写自动化脚本和测试工具;功能测试则是按产品功能设计用例、手工执行。
样例逐个敲一遍,重点章节整理成笔记。
第一个程序,以及 namespace 划出的那层域
C++ 兼容 C 的绝大多数语法,把文件后缀改成 .cpp,VS 就会调用 C++ 编译器;Linux 下用 g++。
// test.cpp
#include <cstdio>

int main()
{
    std::printf("hello world\n");
    return 0;
}
C++ 自己的版本要用 <iostream>:
#include <iostream>

int main()
{
    std::cout << "hello world" << std::endl;
    return 0;
}cout、endl 都在 std 命名空间里,所以要写 std::;省略前缀的 using namespace std; 会在下面讲命名空间时展开。
namespace 的作用是给名字划出一块独立的域。语法是 namespace 名字 { 变量/函数/类型 },可以嵌套,只能定义在全局,多个文件里的同名命名空间会被合并成一个。
#include <cstdio>
#include <cstdlib>

namespace bit
{
    int rand = 10;

    struct Node
    {
        Node* next;      // C++ 里 Node 这个名字直接代表类型,不用再写 struct Node*
        int val;
    };

    int Add(int left, int right)
    {
        return left + right;
    }
}

int main()
{
    std::printf("%p\n", (void*)rand);    // 全局域里的库函数地址
    std::printf("%d\n", bit::rand);      // 10
    return 0;
}
C++ 里有四层域:函数局部域、全局域、命名空间域、类域。前两层除了决定名字查找,还决定变量的生命周期;命名空间域和类域只影响编译期的查找逻辑,不改变变量活多久。
嵌套与合并:
namespace bit
{
    namespace pg
    {
        int rand = 1;
        int Add(int left, int right) { return left + right; }
    }

    namespace hg
    {
        int rand = 2;
        int Add(int left, int right) { return (left + right) * 10; }
    }
}

int main()
{
    std::printf("%d %d\n", bit::pg::rand, bit::hg::rand);          // 1 2
    std::printf("%d %d\n", bit::pg::Add(1, 2), bit::hg::Add(1, 2)); // 3 30
    return 0;
}
多文件里的同名 namespace 视为同一个,声明放头文件、定义放源文件:
// Stack.h
#pragma once
#include <cstdlib>
#include <cassert>

namespace bit
{
    typedef int STDataType;
    typedef struct Stack
    {
        STDataType* a;
        int top;
        int capacity;
    } ST;

    void STInit(ST* ps, int n = 4);
    void STPush(ST* ps, STDataType x);
}

// Stack.cpp
#include "Stack.h"

namespace bit
{
    void STInit(ST* ps, int n)
    {
        assert(ps && n > 0);
        ps->a = (STDataType*)malloc(n * sizeof(STDataType));
        ps->top = 0;
        ps->capacity = n;
    }

    void STPush(ST* ps, STDataType x)
    {
        assert(ps);
        if (ps->top == ps->capacity)
        {
            int newcapacity = ps->capacity * 2;
            STDataType* tmp = (STDataType*)realloc(ps->a, newcapacity * sizeof(STDataType));
            if (tmp == nullptr)
            {
                perror("realloc fail");
                return;
            }
            ps->a = tmp;
            ps->capacity = newcapacity;
        }
        ps->a[ps->top++] = x;
    }
}

// main.cpp
#include <cstdio>
#include "Stack.h"

typedef struct Stack
{
    int a[10];
    int top;
} ST;

void STInit(ST* ps) { ps->top = 0; }
void STPush(ST* ps, int x) { ps->a[ps->top++] = x; }

int main()
{
    ST st1;
    STInit(&st1);
    STPush(&st1, 1);
    std::printf("%zu\n", sizeof st1);    // 44

    bit::ST st2;
    bit::STInit(&st2);
    bit::STPush(&st2, 2);
    std::printf("%zu\n", sizeof st2);    // 64 位下 16
    return 0;
}
课件这段 Stack.cpp 里写的是 ps->capacity = n;,但函数只有 ps 一个形参,n 没有定义,照抄编不过。另外课件用 printf("%d", sizeof(st1)),sizeof 的结果类型是 size_t,格式符应当是 %zu。
默认查找不会进命名空间,所以下面这行报 C2065(未声明的标识符):
#include <cstdio>

namespace N
{
    int a = 0;
    int b = 1;
}

int main()
{
    // std::printf("%d\n", a);     // error C2065: “a”: 未声明的标识符
    std::printf("%d\n", N::a);     // 指定命名空间
    return 0;
}
另外两种写法,沿用上面的 N 和头文件:
using N::b;                        // 只展开一个成员

int main()
{
    std::printf("%d %d\n", N::a, b);
    return 0;
}
using namespace N; // 展开全部成员
int main()
{
std::printf("%d %d\n", a, b);
return 0;
}课件里这一行写的是 using namespce N;,namespce 是拼写错误,正确关键字是 namespace,编译器只会把它当成未声明的标识符。实际项目里推荐 N:: 这种带前缀的写法;using namespace 放在头文件里等于把命名空间塞进所有包含者,冲突迟早发生。
cin 和 cout 的便利来自重载,三行提速里有一行是空操作
<iostream> 是 Input Output Stream,std::cin 是 istream 类的对象,处理窄字符输入;std::cout 是 ostream 类的对象,处理窄字符输出。<< 是流插入,>> 是流提取,C 里这两个符号用来做位移。
#include <iostream>

int main()
{
    int a = 0;
    double b = 0.1;
    char c = 'x';

    std::cout << a << ' ' << b << "  " << c << '\n';
    std::cin >> a >> b >> c;
    std::cout << a << '\n';
    return 0;
}
cout 不需要 %d、%lf 这类格式符,因为 operator<< 对每种类型都有重载,编译器按实参类型挑对应的那个。这也是 C++ 流能直接支持自定义类型的原因:给类型写一个 operator<< 重载就行,后面讲运算符重载时会用到。
std::endl 是操纵符,本质是一个函数模板:operator<< 有一个重载专门接收“吃 ostream& 再吐 ostream&”的函数,收到 endl 后就调用它。它做两件事,输出一个 '\n',再 flush 缓冲区。flush 是有代价的,循环里写 std::cout << i << std::endl; 会每次都刷一次缓冲,换成 '\n' 快得多。
课件给出的三行提速代码:
#include <iostream>

int main()
{
    std::ios_base::sync_with_stdio(false);   // 断开 C 流与 C++ 流的同步
    std::cin.tie(nullptr);                   // cin 不再在每次读之前刷新 cout
    std::cout.tie(nullptr);                  // 空操作

    int n = 0;
    std::cin >> n;
    std::cout << n << '\n';
    return 0;
}
三行的作用并不一样:
sync_with_stdio(false)让 C++ 流不再和 C 的stdio同步,省掉每次 IO 的检查;此后不要混用printf/scanf与cin/cout,缓冲顺序会乱。cin.tie(nullptr)有效:标准规定cin默认绑定到&cout,每次输入前先 flushcout,解绑后这一步省掉。cout.tie(nullptr)没有效果:cout本来没有绑定任何输出流,cout.tie()默认就返回nullptr,这行只是把nullptr再设一遍。课件把它算作提速手段是错的,真正有效的是前两行。
包含 <iostream> 之后能直接用 printf、scanf,是 VS 的实现里 <iostream> 间接包含了 C 头文件,标准并不保证。要用 C 的 IO 就显式包含 <cstdio>。
缺省参数与函数重载:都在参数列表上做文章
缺省参数是在声明或定义时给形参一个默认值,调用时没给实参就用默认值。全缺省是每个形参都有默认值,半缺省是只有右边一段有。
#include <iostream>

void Func1(int a = 10, int b = 20, int c = 30)   // 全缺省
{
    std::cout << a << ' ' << b << ' ' << c << '\n';
}

void Func2(int a, int b = 10, int c = 20)        // 半缺省
{
    std::cout << a << ' ' << b << ' ' << c << '\n';
}

// void Func3(int a = 10, int b, int c = 20);    // 错:缺省必须从右往左连续,不能跳着给

int main()
{
    Func1();
    Func1(1);
    Func1(1, 2);
    Func1(1, 2, 3);

    Func2(100);
    Func2(100, 200);
    Func2(100, 200, 300);
    return 0;
}
两条方向规则:声明时缺省值必须从右往左连续;调用时实参必须从左往右依次给,不能跳过前面的形参只给后面那个。
声明和定义分离时,缺省值只能出现一次:
// Stack.h
void STInit(ST* ps, int n = 4);

// Stack.cpp
void STInit(ST* ps, int n)     // 这里不能再写 = 4
{
    // 定义
}
精确的说法是:标准允许在同作用域的后一个声明里补齐缺省值,但不允许同一个参数重复给;类成员函数的缺省值必须写在类内声明,类外定义处写是非法的。工程上统一写在头文件,因为调用点只看得见声明——缺省值是在调用点展开的,定义里写的默认值对别的源文件没有意义。
带上缺省值,STInit(&s1) 用默认的 4 个容量,STInit(&s2, 1000) 一次开够,省掉反复扩容。
函数重载是同一作用域里放同名函数,形参不同即可,可以是类型不同、个数不同、顺序不同:
#include <iostream>

int Add(int left, int right)
{
    return left + right;
}

double Add(double left, double right)
{
    return left + right;
}

void f() {}
void f(int a) {}
void f(int a, char b) {}
void f(char b, int a) {}

// void fxx() {}
// int fxx() { return 0; }    // 错:返回值类型不参与重载,调用时也区分不出来

int main()
{
    Add(10, 20);        // int 版本
    Add(10.1, 20.2);    // double 版本

    f();
    f(10);
    f(10, 'a');
    f('a', 10);
    return 0;
}
返回值不同不能构成重载,因为调用处 fxx(); 没法靠返回值挑函数。
缺省参数和重载会打架:
void f1() {}
void f1(int a = 10) {}

int main()
{
    // f1();     // 歧义:两个都能匹配,编译器不知道调哪个
    f1(20);
    return 0;
}
两个函数确实构成重载,但无参调用时两条路径都成立,编译直接报歧义。
C 不允许同名函数,C++ 允许,差别在符号名。C 编译出的符号只有函数名,同名就是重复定义;C++ 会把参数类型编码进符号名(name mangling,名字修饰)。g++ 下 int Add(int, int) 是 _Z3Addii,double 版本是 _Z3Adddd,f(char, int) 是 _Z1fci;MSVC 下是 ?Add@@YAHHH@Z 这种格式。
g++ -c overload.cpp -o overload.o
nm overload.o
nm 输出的是修饰后的名字,加 -C 才会还原成可读形式。链接器认的是修饰名,所以重载在链接阶段不会撞车;反过来,这也解释了为什么 C 和 C++ 的函数不能直接同名互调——两边算出来的符号不一样。
引用是别名,但不是零成本
引用给已存在的变量起别名,语法是 类型& 名字 = 对象;:
#include <iostream>

int main()
{
    int a = 0;
    int& b = a;
    int& c = a;
    int& d = b;        // 给别名再取别名,d 仍然是 a 的别名

    ++d;
    std::cout << &a << ' ' << &b << ' ' << &c << ' ' << &d << '\n';   // 四个地址相同
    return 0;
}
三条特性:定义时必须初始化;一个变量可以有多个引用;引用一旦绑定某个实体,就不能再改绑到别的实体。
int a = 10;
int& b = a;
int c = 20;
b = c;      // 这是赋值:把 20 写进 a,b 仍然绑着 a
b = c 之后 &a 和 &b 还是同一个地址,&c 是另一个。
引用最常见的用途是传参和传引用返回:
void Swap(int& rx, int& ry)
{
    int tmp = rx;
    rx = ry;
    ry = tmp;
}
调用 Swap(x, y) 时形参就是实参本身,函数里改的是原件。指针版本要做同样的事得写 *rx、*ry,引用省掉了解引用。
用引用改写 C 版的 Stack 接口,所有函数少一层指针:
#include <cassert>
#include <cstdlib>
#include <iostream>

typedef int STDataType;
typedef struct Stack
{
    STDataType* a;
    int top;
    int capacity;
} ST;

void STInit(ST& rs, int n = 4)
{
    rs.a = (STDataType*)malloc(n * sizeof(STDataType));
    rs.top = 0;
    rs.capacity = n;
}

void STPush(ST& rs, STDataType x)
{
    if (rs.top == rs.capacity)
    {
        int newcapacity = rs.capacity == 0 ? 4 : rs.capacity * 2;
        STDataType* tmp = (STDataType*)realloc(rs.a, newcapacity * sizeof(STDataType));
        if (tmp == nullptr)
        {
            perror("realloc fail");
            return;
        }
        rs.a = tmp;
        rs.capacity = newcapacity;
    }
    rs.a[rs.top++] = x;
}

int& STTop(ST& rs)
{
    assert(rs.top > 0);
    return rs.a[rs.top - 1];
}

int main()
{
    ST st1;
    STInit(st1);
    STPush(st1, 1);
    STPush(st1, 2);

    STTop(st1) += 10;               // 返回的是栈顶元素的引用,可以直接改
    std::cout << STTop(st1) << '\n'; // 12
    return 0;
}
课件这一版的 STTop 写的是 return rs.a[rs.top];,下标多了一格。STPush 先把值写进 a[top] 再执行 top++,有效元素的范围是 0 到 top - 1,a[top] 是下一个空槽。按课件的写法,STTop(st1) += 10 改的是还没写入的内存,读出来的也不是栈顶。
指针变量也能取别名,这样链表插入头结点就不用二级指针:
typedef struct ListNode
{
    int val;
    struct ListNode* next;
} LTNode, *PNode;

void ListPushBack(PNode& phead, int x)
{
    PNode newnode = (PNode)malloc(sizeof(LTNode));
    newnode->val = x;
    newnode->next = nullptr;

    if (phead == nullptr)
    {
        phead = newnode;          // 改的是调用者那个指针变量本身
    }
    else
    {
        PNode cur = phead;
        while (cur->next)
            cur = cur->next;
        cur->next = newnode;
    }
}

int main()
{
    PNode plist = nullptr;
    ListPushBack(plist, 1);
    return 0;
}
PNode& phead 是指针变量的别名,函数里给 phead 赋值等于给 plist 赋值。写成 LTNode** phead 效果相同,引用版本少一层星号。
传值返回会构造一个临时对象装返回值,传引用返回直接把返回对象的别名交出去,省掉拷贝,还能被赋值:
Date& Func2()
{
    Date tmp(2024, 7, 5);
    return tmp;        // 错:tmp 随函数结束销毁,返回的是野引用
}
局部对象的引用出了函数就悬空,用 Date ret = Func2(); 接住它,读的是已经销毁的对象。传引用返回的前提是返回对象在这个函数结束后仍然活着,比如成员变量、静态变量、堆上的对象,或者调用者传进来的引用参数。
const 引用管的是读写权限,权限可以缩小,不能放大:
const int a = 10;
// int& ra = a;             // 错:普通引用会放大权限
const int& ca = a;          // 对

int b = 20;
const int& cb = b;          // 对:权限缩小,cb 改不了 b

const int& r1 = 30;         // 对:绑定字面量产生的临时对象
const int& r2 = a * 3;      // 对:表达式结果也是临时对象

double d = 12.34;
// int& rd = d;             // 错:double 转 int 要先产生临时 int
const int& rd2 = d;         // 对:绑定那个临时 int
临时对象是编译器为了暂存表达式结果创建的未命名对象,C++ 规定它有常性,所以只能用 const 引用绑。int& rd = d 想绑的其实是转换后的临时值,那就成了权限放大。
课件说“引用不占内存、和引用对象共用同一块空间”,这只在语言层面成立:引用不是对象,sizeof(int&) 得到的是被引用类型的大小,sizeof 作用在别名上量的是本体。但实现层面(ABI)引用通常就是一个地址,作为形参要传 8 个字节,作为成员要占 8 个字节:
struct S
{
    int& r;
};

std::cout << sizeof(S) << '\n';   // x86-64 上是 8
引用和指针的差别按六条对照:
| 对比项 | 引用 | 指针 |
|---|---|---|
| 语法含义 | 变量的别名,不产生新的对象 | 存地址的变量,本身是一个对象 |
| 初始化 | 定义时必须绑定 | 语法上可以不初始化,但是野指针 |
| 能否改指向 | 绑定后不能改 | 可以反复改 |
| 访问方式 | 直接用,不需要解引用 | 要 * 才能访问目标 |
sizeof | 被引用类型的大小 | 地址大小,32 位 4 字节,64 位 8 字节 |
| 空值风险 | 很少出现空引用 | 空指针、野指针都常见 |
inline 替代宏,nullptr 替代 NULL
inline 修饰的函数叫内联函数,编译器可以在调用点把函数体展开,省掉建立栈帧的开销:
#include <iostream>

inline int Add(int x, int y)
{
    int ret = x + y;
    return ret;
}

int main()
{
    int ret = Add(1, 2);
    std::cout << Add(1, 2) * 5 << '\n';
    return 0;
}
inline 对编译器只是建议,展不展开由编译器决定,标准没有强制。频繁调用的短小函数适合加,递归函数和函数体较大的函数加了也会被忽略。VS 的 Debug 配置默认关闭展开(/Ob0);看反汇编里有没有 call Add 就能判断。
内联函数是为了替代 C 的宏函数。宏在预处理阶段做文本替换,几个坑都能用括号说明:
#define ADD(a, b) ((a) + (b))- 最外层括号缺失:
#define ADD(a, b) a + b下ADD(1, 2) * 5展开成1 + 2 * 5,结果是 11。 - 参数各自的括号缺失:
#define ADD(a, b) (a + b)下ADD(x & y, x | y)展开成(x & y + x | y),+的优先级高于&和|,结果与(x & y) + (x | y)不同。 - 宏后面不加分号:宏本身不是一个语句,加了分号放进
if不带花括号的分支里会把语句切断。
宏的另一个问题是没法单步调试,展开后的代码和源码对不上,inline 函数可以正常打断点。
inline 函数不要声明和定义分到两个文件:
// F.h
#include <iostream>
inline void f(int i);

// F.cpp
#include "F.h"
void f(int i)
{
    std::cout << i << '\n';
}

// main.cpp
#include "F.h"
int main()
{
    f(10);
    return 0;
}
链接报错 无法解析的外部符号 "void __cdecl f(int)" (?f@@YAXH@Z)。规则是:内联函数的定义必须在每个使用它的翻译单元里可见。F.cpp 里这个定义继承了头文件声明中的 inline,这一版没有调用点,编译器就不生成函数实体;main.cpp 只看到声明,按普通外部函数发出调用,链接器找不到符号。把定义整个放进头文件,这个问题就没有了。
NULL 是一个宏。C 的头文件里通常这么写:
#ifndef NULL
#ifdef __cplusplus
#define NULL    0
#else
#define NULL    ((void *)0)
#endif
#endif
C++ 下它常常就是字面量 0,于是重载决议会被带偏:
#include <iostream>

void f(int x)
{
    std::cout << "f(int)\n";
}

void f(int* p)
{
    std::cout << "f(int*)\n";
}

int main()
{
    f(0);               // f(int)
    f(NULL);            // MSVC 下 NULL 是 0,选 f(int)
    f((int*)NULL);      // f(int*)
    // f((void*)NULL);  // error C2665:2 个重载中没有一个可以转换所有参数类型
    f(nullptr);         // f(int*)
    return 0;
}
(void*)NULL 报错是因为 void* 到 int* 没有隐式转换,两个重载都接不住。NULL 具体定义成 0、0L 还是 nullptr 由实现决定:MSVC 下它展开成 0,选的是 f(int);换成把 NULL 定义成 nullptr 的实现,选的就是 f(int*);还有实现在这里直接报重载歧义。同一个源码在不同编译器上走不同分支,这正是需要一个独立类型的理由。
C++11 引入的 nullptr 是 std::nullptr_t 类型的字面量,能隐式转成任意指针类型(包括成员指针),不能转成整数。f(nullptr) 只能走 f(int*),不再依赖宏怎么定义。新代码里空指针统一写 nullptr,NULL 留给需要兼容 C 头文件的场景。
还没有评论 — 第一条由你来留。