char char2[] = "abcd"; 和 const char* pChar3 = "abcd"; 两行几乎一样,char2 的四个字符落在栈上,pChar3 指向的内容却在只读段。判断一个变量住在哪,看三件事就够了:有没有 static、是不是数组、是不是指针。
课件给了一段函数内的代码,要求逐个判断位置:
#include <cstdlib>

int globalVar = 1;
static int staticGlobalVar = 1;

void Test()
{
    static int staticVar = 1;
    int localVar = 1;
    int num1[10] = {1, 2, 3, 4};
    char char2[] = "abcd";
    const char* pChar3 = "abcd";
    int* ptr1 = static_cast<int*>(std::malloc(sizeof(int) * 4));
    int* ptr2 = static_cast<int*>(std::calloc(4, sizeof(int)));
    int* ptr3 = static_cast<int*>(std::realloc(ptr2, sizeof(int) * 4));

    std::free(ptr1);
    std::free(ptr3);
}| 变量 | 所在区域 | 理由 |
|---|---|---|
globalVar | 数据段 | 已初始化的全局变量 |
staticGlobalVar | 数据段 | 静态全局变量,仍是静态存储期 |
staticVar | 数据段 | 函数内的 static 局部变量,程序结束时才销毁 |
localVar | 栈 | 普通局部变量 |
num1 | 栈 | 局部数组,整个数组都在栈上 |
char2 | 栈 | 数组本体,5 个字节(含 '\0')在栈上 |
*char2 | 栈 | 首元素,字面量已经复制进数组 |
pChar3 | 栈 | 指针变量本身在栈上 |
*pChar3 | 只读段(课件叫常量区) | 字符串字面量 |
ptr1 | 栈 | 指针变量本身在栈上 |
*ptr1 | 堆 | malloc 返回的那块空间 |
最容易混的两组就是 char2 与 *char2、pChar3 与 *pChar3。数组会复制字面量,所以从数组名到它的每个字符都在栈上;指针只保存地址,指针自己在栈上,地址那头的内容不在栈上。char2[0] = 'x'; 改的是自己的副本;pChar3[0] = 'x'; 连编译都过不去,类型是 const char*,用 const_cast 绕过去再写,通常直接触发段错误。
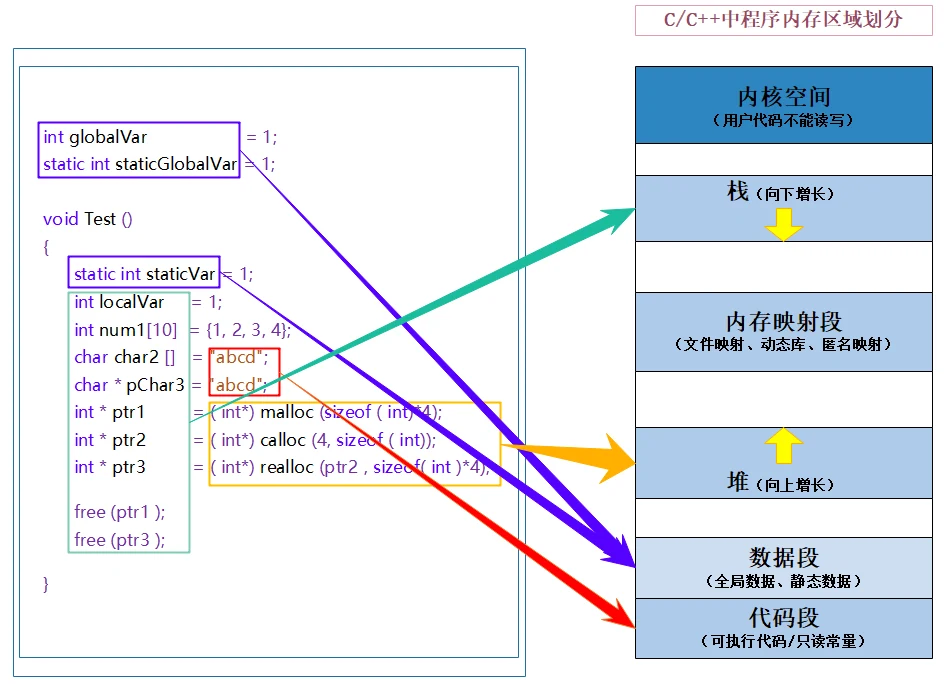
栈向下、堆向上,方向只是趋势
课件用五条说明概括了分区规则,逐条补齐更实际的边界:
- 栈(stack)放非静态局部变量、函数参数和返回值,调用约定规定它向低地址增长。容量有限,Windows 主线程默认 1MB,Linux 常见 8MB,
ulimit -s能查能改。int a[1000000];是 4MB,直接爆栈,收到的是段错误,不会有返回值告诉你失败。 - 内存映射段(memory mapping segment)用来装共享库、文件映射和匿名映射,也可以在这里开一块共享内存做进程间通信。
- 堆(heap)服务于运行时的动态分配,通常向高地址长。glibc 的实现主要靠
brk把堆顶往上推,大块分配走mmap另开一段。 - 数据段(data segment)放全局变量和静态变量。里面还分两层:已初始化的非零值进
.data,未初始化或初始化为零的进.bss,后者在可执行文件里不占空间,加载时由系统清零。 - 代码段(code segment)放机器指令。字符串字面量这类只读常量实际在
.rodata,与.text同属只读区域但不是同一节,课件把它合并写成“代码段(常量区)”,是个简化说法。
“堆向上、栈向下”不能拿来比较任意两个对象的地址。标准从不保证跨对象的地址顺序,mmap 出来的块、多线程 arena 里的块位置都不连续,方向只是整体趋势。
malloc 家族:清零、扩容、失败三种情况
#include <cstdlib>

int main()
{
    int* p2 = static_cast<int*>(std::calloc(4, sizeof(int)));
    if (p2 == nullptr)
        return 1;

    int* p3 = static_cast<int*>(std::realloc(p2, sizeof(int) * 10));
    if (p3 == nullptr)
    {
        std::free(p2);      /* realloc 失败,旧块还在,p2 仍然有效 */
        return 1;
    }

    std::free(p3);          /* 成功后 p2 已经失效,不能再 free(p2) */
    return 0;
}
四个函数的职责:
| 函数 | 做什么 | 容易忽略的点 |
|---|---|---|
malloc(size) | 申请 size 字节 | 不初始化,内容是上次留下的字节;失败返回 NULL |
calloc(n, size) | 申请 n * size 字节并清零 | 参数顺序是“个数、单个大小”,写反不一定报错,只会得到一块尺寸离谱的内存 |
realloc(p, size) | 把 p 指向的块改成 size 字节 | 可能原地扩、可能搬家、可能失败;新增部分不清零 |
free(p) | 释放 p 指向的块 | 只能释放 malloc 系列返回的指针;free(NULL) 什么也不做 |
realloc 是四个里最容易出事的,因为它有三种结局:
- 原地放得下,返回原指针;
- 原地放不下,另开一块、把内容拷过去、自动释放旧块,返回新指针;
- 申请失败,返回
NULL,旧块原样保留。
课件在 realloc 后面问“这里需要 free(p2) 吗”。就成功路径而言不需要——旧块要么被原地复用,要么已经被 realloc 自己释放,再 free(p2) 就是二次释放。但失败路径上必须释放:p3 为 NULL 时 p2 还活着,直接 return 就漏了。这也是不能把 realloc 的返回值直接写回 p2 的原因,一旦失败,唯一指向旧块的指针就没了。
课件留了一道面试题:malloc 的实现原理。展开讲要读 glibc 源码,实用层面的结论是:小块先看线程私有的 tcache 缓存,没有再进 arena 的空闲链表(bin);大块(默认超过 128KB 的阈值)单独 mmap;返回地址按至少 16 字节对齐。malloc(0) 的返回值是实现定义的,可能是一个能 free 的指针,也可能是 NULL。
还有一条硬规则:malloc 来的指针只能用 free / realloc 处理,不能用 delete;反过来 new 来的指针也不能 free。两套机制各自维护自己的块信息,混用是未定义行为,出错位置和肇事位置常常相距很远。
new 与 delete:申请和释放要成套
#include <iostream>

int main()
{
    int* p1 = new int;          /* 未初始化,值不确定 */
    int* p2 = new int(10);      /* 初始化为 10 */
    int* p3 = new int[3];       /* 3 个 int,默认初始化 */
    int* p4 = new int[3]();     /* 3 个 int,值初始化,全为 0 */

    std::cout << *p2 << ' ' << p4[0] << '\n';

    delete p1;
    delete p2;
    delete[] p3;
    delete[] p4;
    return 0;
}
单个元素配 new / delete,连续空间配 new[] / delete[]。这里的括号不是排版问题:new int[3] 与 delete[] 是一对,new int 与 delete 是一对,交叉使用是未定义行为。
课件这段代码的注释写着“动态申请 10 个 int 类型的空间”,代码却是 new int[3]。注释和代码对不上,以代码为准;照注释写 10 再按 3 个元素去用,越界时很难反应过来问题出在哪。
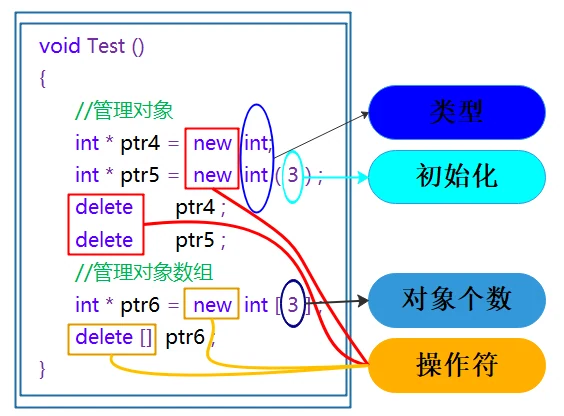
内置类型的 new 和 malloc 差别不大,对自定义类型差别就出来了:
#include <cstdlib>
#include <iostream>

class A
{
public:
    A(int a = 0) : _a(a) { std::cout << "A():" << this << '\n'; }
    ~A() { std::cout << "~A():" << this << '\n'; }

private:
    int _a;
};

int main()
{
    A* p1 = static_cast<A*>(std::malloc(sizeof(A)));
    A* p2 = new A(1);
    std::free(p1);
    delete p2;

    A* p3 = static_cast<A*>(std::malloc(sizeof(A) * 10));
    A* p4 = new A[10];
    std::free(p3);
    delete[] p4;
    return 0;
}
new A(1) 在申请到空间后调用构造函数,delete p2 先调析构再还内存,所以这段会打印一行 A() 和一行 ~A();new A[10] 打印 10 行构造、delete[] 打印 10 行析构。malloc 那两路一行都不打印——p1 指向的只是与 A 同样大的一块原始内存,构造函数没跑过,它还不算一个对象。
operator new 与 new T[N] 的底层步骤
new、delete 是操作符,operator new、operator delete 是标准库提供的全局函数。new 表达式在底层先调 operator new 拿空间,再在空间上构造;delete 先析构,再调 operator delete 还空间。
课件贴了 MSVC CRT 里 operator new 的实现,核心是一个循环:malloc 成功就返回;失败就调 _callnewh(用户设置的 new_handler,空间不足时的应对措施),handler 处理完继续重试,没有 handler 就抛出 bad_alloc。翻译成标准写法就是:
#include <cstdlib>
#include <new>

void* operator new(std::size_t size)
{
    for (;;)
    {
        void* p = std::malloc(size);
        if (p != nullptr)
            return p;

        std::new_handler handler = std::get_new_handler();
        if (handler == nullptr)
            throw std::bad_alloc();
        handler();
    }
}
operator delete 更短,最终就是 free。这段代码只用来理解流程:真要在项目里替换全局 operator new,必须同时替换配套的 delete,还要自己保证线程安全、对齐和失败时的异常语义,除非在写内存分析工具,否则不要动它。
四个过程的步骤可以逐条对照:
new T:调operator new(sizeof(T))申请空间 → 在这块空间上执行构造函数。delete p:执行析构函数 → 调operator delete(p)释放空间。new T[N]:调operator new[],它内部再调operator new申请 N 个对象的空间 → 在这块空间上执行 N 次构造函数。delete[] p:执行 N 次析构函数 → 调operator delete[],它内部再调operator delete释放空间。
delete[] 凭什么知道 N?标准允许数组分配带一段“未指定的额外开销”(cookie),实现通常把元素个数或析构次数存在这块开销里,new[] 返回的指针因此可能不等于分配函数返回的地址。带非平凡析构的类型一般都需要这段信息,这也是 new[] 配 delete、new 配 delete[] 一定出问题的原因:释放时按错误的协议去读块头。
定位 new:在已有内存上构造
定位 new(placement new)解决的是另一件事:内存已经有了,但那里还不是对象,需要只调构造函数。
#include <cstdlib>
#include <new>
#include <iostream>

class A
{
public:
    A(int a = 0) : _a(a) { std::cout << "A():" << this << '\n'; }
    ~A() { std::cout << "~A():" << this << '\n'; }

private:
    int _a;
};

int main()
{
    void* raw = std::malloc(sizeof(A));
    A* p1 = new (raw) A(10);
    p1->~A();
    std::free(raw);

    void* raw2 = ::operator new(sizeof(A));
    A* p2 = new (raw2) A(10);
    p2->~A();
    ::operator delete(raw2);
    return 0;
}格式有两种:new (place_address) type 和 new (place_address) type(initializer-list)。place_address 必须是已分配内存的指针,初始化列表按类型的构造函数来写。它不申请空间,因此也不负责释放——析构要自己显式调用 p->~A(),内存要按原来的来源还(malloc 的用 free,operator new 的用 operator delete)。
它的典型场景是内存池(memory pool):池子一次性申请一大块,切成小块反复使用,这些小块从没经过构造函数,交给自定义类型时就用定位 new 在上面构造。在构造之前直接读写那块裸内存的成员,对象还不存在,成员的初值和虚表都还没有建立。
六条差异
| 对比项 | malloc / free | new / delete |
|---|---|---|
| 身份 | 函数 | 操作符 |
| 初始化 | 不初始化 | 可带初始化值,new int(10) |
| 大小 | 手动算字节数传给函数 | 跟类型即可,数组用 [] 给个数 |
| 返回类型 | void*,使用时要强转 | 直接是目标类型的指针 |
| 失败 | 返回 NULL,调用处必须判空 | 抛出 bad_alloc,要捕获异常 |
| 自定义类型 | 只开辟空间,不调构造与析构 | 申请后调构造,释放前调析构 |
申请方式决定释放方式:new 对 delete,new[] 对 delete[],malloc/calloc/realloc 对 free。把这条配对关系收进一个类型的构造与析构里,就变成了 RAII,后面泄漏和异常路径的问题都从这里消掉。
还没有评论 — 第一条由你来留。