模板参数分两类。跟在 class 或 typename 后面的叫类型形参,用一个常量填进去的叫非类型形参。
#include <cstddef>

template<class T, std::size_t N>
class Array
{
public:
    T& operator[](std::size_t index)       { return _array[index]; }
    const T& operator[](std::size_t index) const { return _array[index]; }

    constexpr std::size_t size() const  { return N; }
    constexpr bool empty() const        { return N == 0; }
private:
    T _array[N];
};
N 在类里就是一个编译期常量,T _array[N] 的长度由它定,实例化 Array<int, 10> 和 Array<int, 20> 得到两个完全不同的类型。非类型参数也能带默认值,template<class T, std::size_t N = 10> 就允许写 Array<int>。课件那个版本的成员里还有一个 size_t _size,从未赋值,size() 实际返回的是未初始化的值;长度本来就是 N,这个成员不需要。
非类型实参的合法范围是编译期能算出来的值:整型、枚举、指针、左值引用、成员指针、nullptr。浮点数、类对象、字符串在 C++20 之前都不允许做非类型模板参数,C++20 才放开浮点类型和满足“结构类型”条件的字面量类类型(所有成员公开且可比较)。字符串字面量仍然不行,因为它没有可以比较的对象身份。这条规则的实质是:模板要在编译期生成代码,实参必须在编译期完全确定。
函数模板的全特化不参与重载
主模板对指针实参有天然的盲区:
struct Date
{
    int y, m, d;

    bool operator<(const Date& o) const
    {
        if (y != o.y) return y < o.y;
        if (m != o.m) return m < o.m;
        return d < o.d;
    }
};

template<class T>
bool Less(T left, T right)
{
    return left < right;
}
Less(1, 2) 比的是整数,Less(d1, d2) 走 Date 的 operator<,两者都对。Less(p1, p2) 里 T 被推成 Date*,比较的是两个地址,不是日期。指针的内建 < 只比较地址高低,模板不会自动解引用。
全特化的写法是:先有主模板,template 后接空尖括号,函数名后的尖括号里写明类型,形参表与主模板完全一致。
template<>
bool Less<Date*>(Date* left, Date* right)
{
    return *left < *right;
}
这四步缺一不可。形参类型如果和主模板推出来的不一致,不同编译器的反应会很不一致,有的报奇怪的错误,有的悄悄不用这份特化。
函数模板特化在实际代码里用得少,原因是它不是重载。调用时编译器先拿实参对主模板做推导,推导结果正好命中某份全特化,才会用那份;特化不会作为一个独立候选参与重载决议。想按类型分流,直接写普通函数更简单:
bool Less(Date* left, Date* right)
{
    return *left < *right;
}
重载决议在实参匹配一样好的情况下优先选非模板函数,所以 Less(p1, p2) 会稳定落到这个版本。函数模板没有偏特化,只能全特化,这也是它不如类模板好用的地方。
类模板有全特化和偏特化
全特化把参数列表里的每个参数都定死:
#include <iostream>

template<class T1, class T2>
class Data
{
public:
    Data() { std::cout << "Data<T1, T2>\n"; }
private:
    T1 _d1;
    T2 _d2;
};

template<>
class Data<int, char>
{
public:
    Data() { std::cout << "Data<int, char>\n"; }
private:
    int _d1;
    char _d2;
};
偏特化不要求定死所有参数,它做的是“进一步限制”:
// 只把第二个参数特化成 int
template<class T1>
class Data<T1, int>
{
public:
    Data() { std::cout << "Data<T1, int>\n"; }
private:
    T1 _d1;
    int _d2;
};

// 两个参数都限制成指针
template<class T1, class T2>
class Data<T1*, T2*>
{
public:
    Data() { std::cout << "Data<T1*, T2*>\n"; }
private:
    T1* _d1;
    T2* _d2;
};

// 两个参数都限制成引用
template<class T1, class T2>
class Data<T1&, T2&>
{
public:
    Data(const T1& d1, const T2& d2) : _d1(d1), _d2(d2)
    {
        std::cout << "Data<T1&, T2&>\n";
    }
private:
    const T1& _d1;
    const T2& _d2;
};
这几种写法分别落在谁身上,看实参形状就清楚:
| 写法 | 命中 |
|---|---|
Data<int, int> | Data<T1, int>,第二个参数被固定成 int |
Data<int, char> | 全特化 Data<int, char>,优先级最高 |
Data<double, int> | 还是 Data<T1, int> |
Data<int*, int*> | 指针偏特化 Data<T1*, T2*> |
Data<int&, int&> | 引用偏特化 Data<T1&, T2&> |
课件的注释把 Data<int&, int&> 写成“调用特化的指针版本”,实际命中的是引用偏特化。选择规则是:特化程度更高的版本优先,全特化优先于偏特化,偏特化优先于主模板。
排序指针时,特化补上解引用
std::sort 的第三个参数是比较器,默认用 operator<。元素是 Date* 时,默认比较器比的还是地址,结果按地址排序,和日期无关。类模板特化在这个场景里最有用:
#include <algorithm>
#include <iostream>
#include <vector>

struct Date
{
    int y, m, d;
    bool operator<(const Date& o) const
    {
        if (y != o.y) return y < o.y;
        if (m != o.m) return m < o.m;
        return d < o.d;
    }
};

template<class T>
struct Less
{
    bool operator()(const T& x, const T& y) const { return x < y; }
};

template<>
struct Less<Date*>
{
    bool operator()(Date* x, Date* y) const { return *x < *y; }
};

int main()
{
    Date d1{2022, 7, 7}, d2{2022, 7, 6}, d3{2022, 7, 8};
    std::vector<Date*> v{&d1, &d2, &d3};

    std::sort(v.begin(), v.end(), Less<Date*>());

    for (Date* p : v)
        std::cout << p->y << '-' << p->m << '-' << p->d << '\n';   // 7-6 / 7-7 / 7-8
}
Less<Date*> 一旦特化,所有拿它做比较器的地方都按日期比,不需要在每个调用点改参数。只在某一次调用里想换比法,lambda 更轻:
std::sort(v.begin(), v.end(), [](Date* a, Date* b) { return *a < *b; });模板的声明和定义拆开,链接器找不到符号
一个项目里的每个源文件单独编译成目标文件,再链接成可执行文件。模板如果按普通函数的习惯拆开放:
// a.h
template<class T>
T Add(const T& left, const T& right);

// a.cpp
#include "a.h"
template<class T>
T Add(const T& left, const T& right)
{
    return left + right;
}

// main.cpp
#include "a.h"
int main()
{
    Add(1, 2);
    Add(1.0, 2.0);
    return 0;
}
编译都过,链接报 无法解析的外部符号,符号名大概是 Add<int> 和 Add<double> 经过 name mangling 之后的形态。
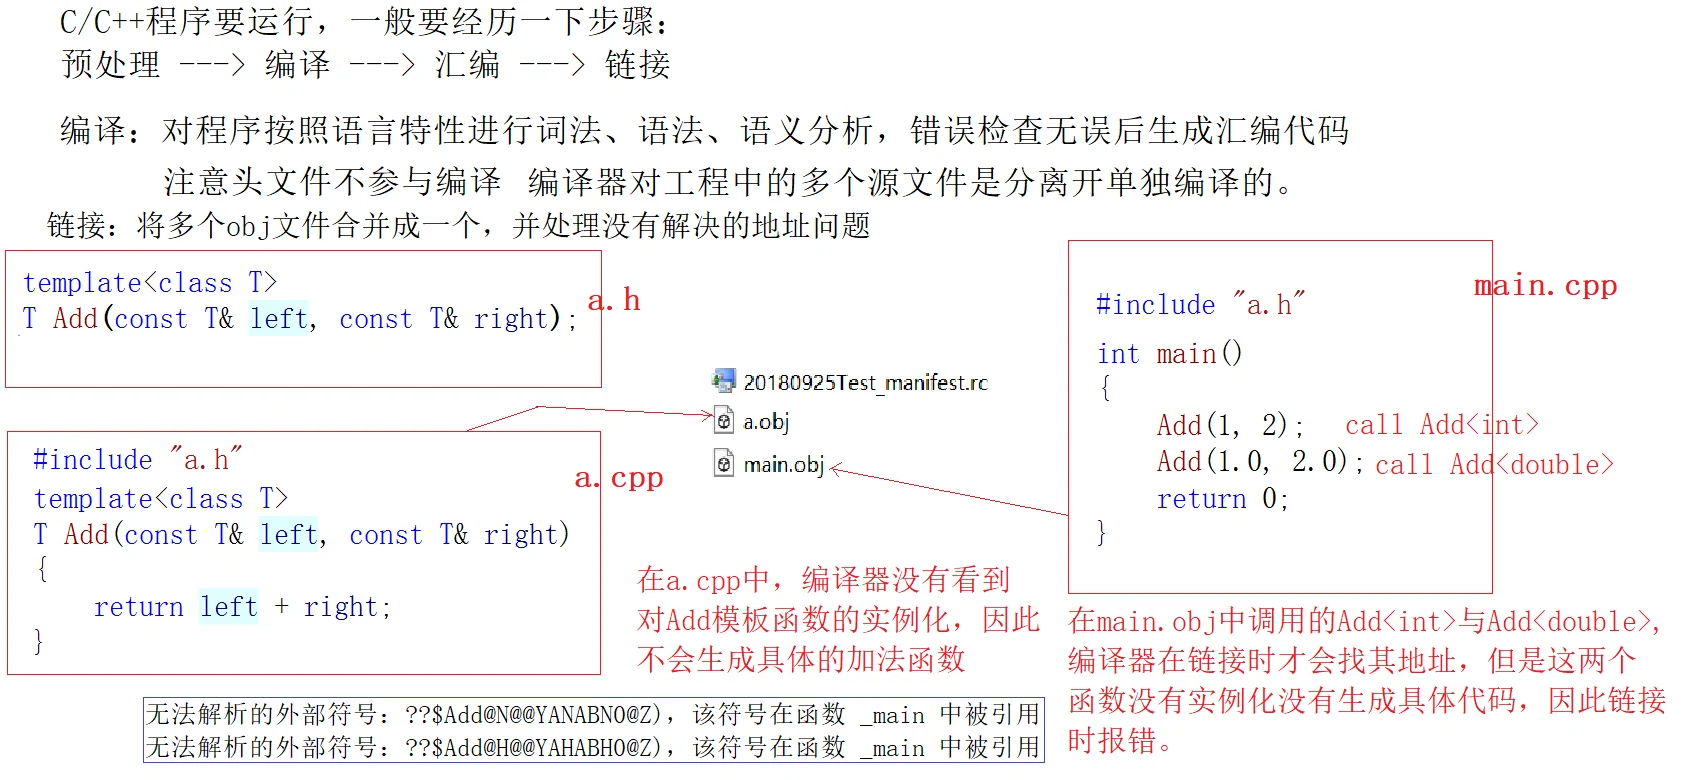
原因不在链接器。模板本身不是函数,是生成函数的图纸。a.cpp 里只有图纸、没有“用 T=int 来一份”的指令,编译器不会凭空实例化,a.obj 里自然没有这个符号。main.cpp 只看到了声明,编译 Add(1, 2) 时按声明实例化了 Add<int>,生成了调用,却拿不到函数体。两边各做各的,链接时正好缺一半。
两种补法。
把定义放进头文件,让每个包含它的翻译单元都能看到完整定义、按需实例化。扩展名写成 .hpp 只是提醒“这里面有定义”,.h 一样能用。这是主流做法。
另一种是在定义所在的源文件里显式实例化:
// a.cpp
#include "a.h"

template<class T>
T Add(const T& left, const T& right)
{
    return left + right;
}

template int Add<int>(const int&, const int&);
template double Add<double>(const double&, const double&);这两行告诉编译器“现在就把这两个版本生成出来”,a.obj 里于是有了符号。它适合类型集合固定的库,比如只对外提供 int、double 两种。代价是每加一个类型都要手写一行;C++11 还可以在头文件里写 extern template int Add<int>(const int&, const int&);,阻止其它翻译单元重复实例化,只保留 a.cpp 里那一份。
模板的收益和成本
收益是代码复用和灵活性:一份 Array<T, N> 顶掉所有定长数组,STL 整个建立在模板之上。成本也直接:每个不同的实参组合都生成一份代码,二进制会膨胀;模板要参与两阶段查找、在每个翻译单元里解析和实例化,编译时间变长;模板报错会带着长长的实例化栈,错误定位比普通函数难。
还没有评论 — 第一条由你来留。