图记作 G = (V, E):V 是顶点集合,非空且有限;E 是边的集合,元素要么是无序对 (x, y),要么是有序对 <x, y>。圆括号表示双向通路,尖括号表示单向通路,这一个符号就决定了整张图是有向还是无向。
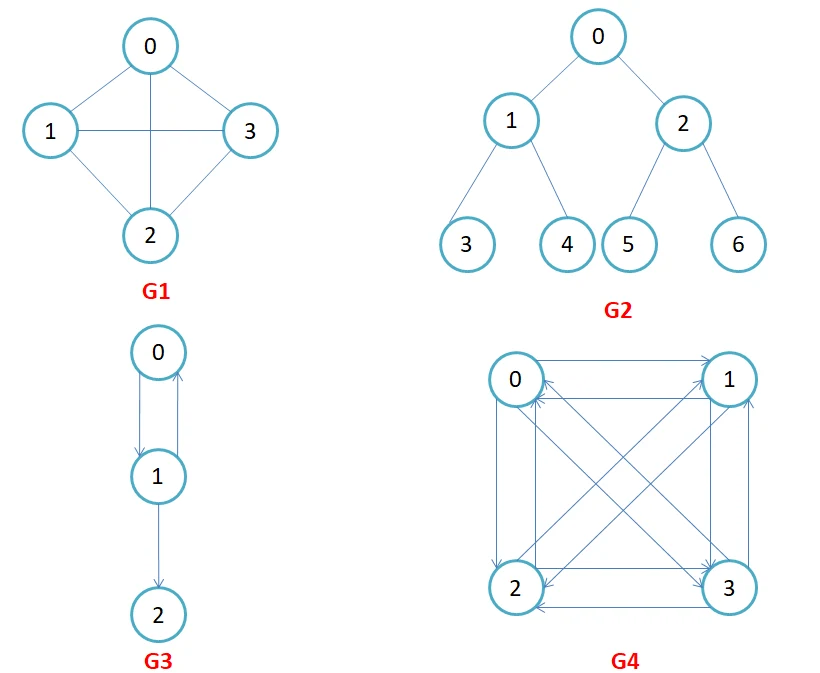
几个术语放在一张表里对照:
| 概念 | 含义 |
|---|---|
| 完全图 | n 个顶点的无向完全图有 n(n−1)/2 条边;有向完全图有 n(n−1) 条弧 |
| 邻接顶点 | 无向边 (u, v) 的两端互为邻接;有向边 <u, v> 称 u 邻接到 v、v 邻接自 u |
| 度 | 无向图中是与顶点关联的边数;有向图中 deg(v) = indeg(v) + outdeg(v) |
| 路径长度 | 无权图数边的条数;带权图求边权之和 |
| 简单路径 | 路径上的顶点不重复;首尾重合时叫回路或环 |
| 连通图 | 无向图中任意两点都有路径;有向图要求两个方向都有路径,叫强连通图 |
| 生成树 | 连通图的极小连通子图,n 个顶点、n−1 条边 |
“生成树是极小连通子图”里的“极小”是删边意义下的极小:去掉任何一条边就不连通,加入任何一条边就成环。课件写成“最小连通子图”,容易被读成“权值最小的连通子图”,那是后面最小生成树的概念。生成树本身不谈权值。
矩阵存关系,链表存邻居
图里只有两样东西要存:顶点和边。顶点用一段连续空间就够,边才是存储结构的分水岭。
邻接矩阵(adjacency matrix)把所有边摊成一张 V × V 的表,_matrix[i][j] 存 i 到 j 的权值,没有边就写一个哨兵。无向图的矩阵沿对角线对称,有向图不一定。
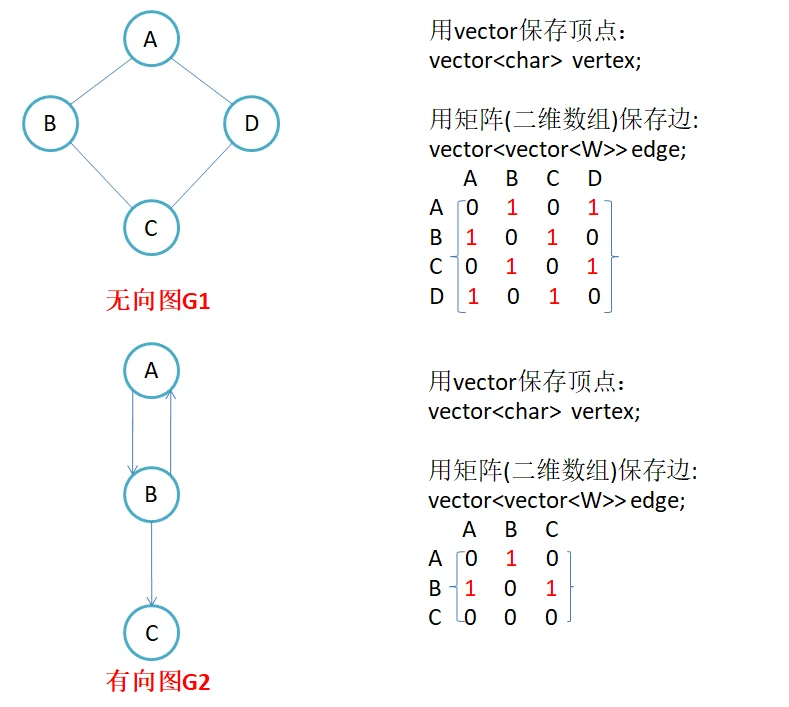
课件在这一节有两处表述要改。第一处是“矩阵中存储了大量的 0 成为系数矩阵”,这里该叫稀疏矩阵;系数矩阵是线性方程组 Ax = b 里的概念,和图没有关系。第二处是“第 i 行(列)元素之后就是顶点 i 的出(入)度”,那个“之后”应是“之和”:有向图第 i 行的非哨兵个数是出度,第 i 列是入度;无向图行列对称,行和列给出同一个数。
课件还有一句“对于无向图,顶点的度等于该顶点的入度和出度”。无向图根本不区分入度和出度,度就是关联边的条数;硬按“每条边对两端各进一次、各出一次”定义,会把度算成两倍。deg = indeg + outdeg 只对有向图成立。
矩阵的骨架如下,后面所有算法都挂在这张表上:
#include <vector>
#include <map>
#include <queue>
#include <limits>
#include <iostream>
#include <stdexcept>

using namespace std;

template<class V, class W, W MAX_W = numeric_limits<W>::max(), bool Direction = false>
class Graph
{
public:
    typedef Graph<V, W, MAX_W, Direction> Self;

    struct Edge
    {
        size_t _s, _d;
        W _w;
        Edge(size_t s, size_t d, const W& w) : _s(s), _d(d), _w(w) {}
    };

    struct Cmp
    {
        bool operator()(const Edge& a, const Edge& b) const { return a._w > b._w; }
    };

    Graph() = default;

    Graph(const V* v, size_t n)
    {
        _vertexs.reserve(n);
        for (size_t i = 0; i < n; ++i)
        {
            _vertexs.push_back(v[i]);
            _vIndexMap[v[i]] = i;
        }
        _matrix.assign(n, vector<W>(n, MAX_W));
    }

    size_t GetVertexIndex(const V& v) const
    {
        auto it = _vIndexMap.find(v);
        if (it == _vIndexMap.end())
            throw invalid_argument("不存在的顶点");
        return it->second;
    }

    void AddEdge(const V& s, const V& d, const W& w)
    {
        _AddEdge(GetVertexIndex(s), GetVertexIndex(d), w);
    }

    void BFS(const V& src) const;
    void DFS(const V& src) const;

    W Kruskal(Self& minTree) const;
    W Prim(Self& minTree, const V& src) const;

    void Dijkstra(const V& src, vector<W>& dist, vector<int>& parent) const;
    bool BellmanFord(const V& src, vector<W>& dist, vector<int>& parent) const;
    void Floyd(vector<vector<W>>& dist, vector<vector<int>>& parent) const;

    bool TopoSort(vector<size_t>& order) const;
    size_t ComponentCount() const;

private:
    void _AddEdge(size_t s, size_t d, const W& w)
    {
        _matrix[s][d] = w;
        if (!Direction)
            _matrix[d][s] = w;
    }

    void _DFS(size_t u, vector<bool>& vis) const;

    vector<V> _vertexs;
    map<V, size_t> _vIndexMap;
    vector<vector<W>> _matrix;
};
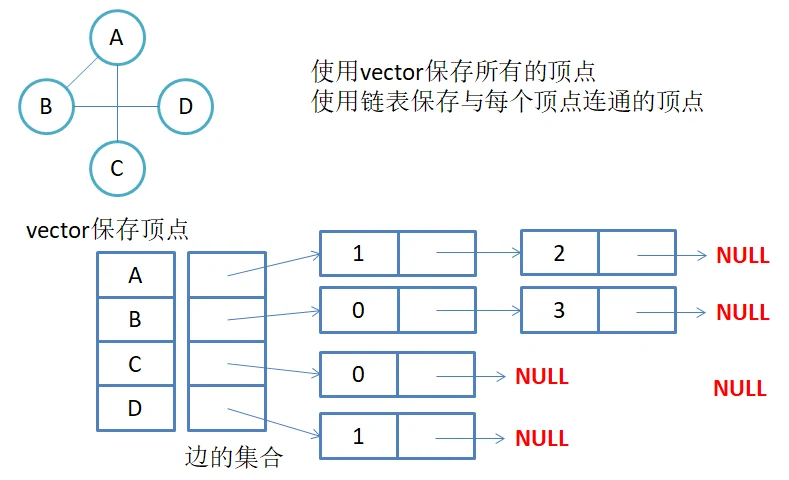
邻接表(adjacency list)换一个思路:数组存顶点,每个顶点挂一条链表,只记“从它出发能到谁、权值多少”。空间从 O(V²) 降到 O(V+E),稀疏图上差别很大。
template<class V, class W, bool Direction = false>
class LinkGraph
{
    struct EdgeNode
    {
        size_t _dst;
        W _w;
        EdgeNode* _next;
        EdgeNode(size_t d, const W& w, EdgeNode* n) : _dst(d), _w(w), _next(n) {}
    };

public:
    LinkGraph(const V* v, size_t n)
    {
        _vertexs.assign(v, v + n);
        for (size_t i = 0; i < n; ++i)
            _index[v[i]] = i;
        _head.assign(n, nullptr);
    }

    ~LinkGraph()
    {
        for (EdgeNode* p : _head)
            while (p)
            {
                EdgeNode* next = p->_next;
                delete p;
                p = next;
            }
    }

    void AddEdge(const V& src, const V& dst, const W& w)
    {
        size_t s = _index[src], d = _index[dst];
        _head[s] = new EdgeNode(d, w, _head[s]);
        if (!Direction && s != d)
            _head[d] = new EdgeNode(s, w, _head[d]);   // 无向边存两次
    }

private:
    vector<V> _vertexs;
    map<V, size_t> _index;       // 必须跟着 V 走
    vector<EdgeNode*> _head;
};
课件那份邻接表的类模板接受 V、W 两个类型参数,成员却是写死的 map<string, int> _vIndexMap。实例化成 Graph<char, int> 时,GetVertexIndex(const char&) 拿 char 去查 map<string, int>,类型对不上,编译直接失败。上面这段把映射类型改成 map<V, size_t>,就不是“碰巧只测过 string”的版本了。
有向图的邻接表只存一次,每个顶点的链表长度是出度。想要入度,得把所有链表扫一遍,或者再存一张逆邻接表。课件给出的入边表和出边表就是这个意思:出边表按起点组织,入边表按终点组织,两张表各管一个方向。
BFS 分层,DFS 到底才回头
遍历要解决的不是“怎么走”,而是“怎么不重复走”。visited 标记的位置决定了代码对不对。
BFS 用队列,按层扩散。标记必须在入队时做,不能等出队:放到出队时才标记,同一个顶点会被多个邻居重复塞进队列,层号也跟着乱——一个第 2 层能到的点,可能先被第 3 层的邻居入队,记成 3 跳。
template<class V, class W, W MAX_W, bool Direction>
void Graph<V, W, MAX_W, Direction>::BFS(const V& src) const
{
    size_t n = _vertexs.size();
    size_t s = GetVertexIndex(src);
    vector<bool> vis(n, false);
    queue<size_t> q;

    q.push(s);
    vis[s] = true;                      // 入队即标记

    size_t level = 0;
    while (!q.empty())
    {
        size_t sz = q.size();
        cout << "第 " << level << " 层:";
        while (sz--)
        {
            size_t u = q.front();
            q.pop();
            cout << " " << _vertexs[u];

            for (size_t v = 0; v < n; ++v)
                if (!vis[v] && _matrix[u][v] != MAX_W)
                {
                    vis[v] = true;
                    q.push(v);
                }
        }
        cout << '\n';
        ++level;
    }
}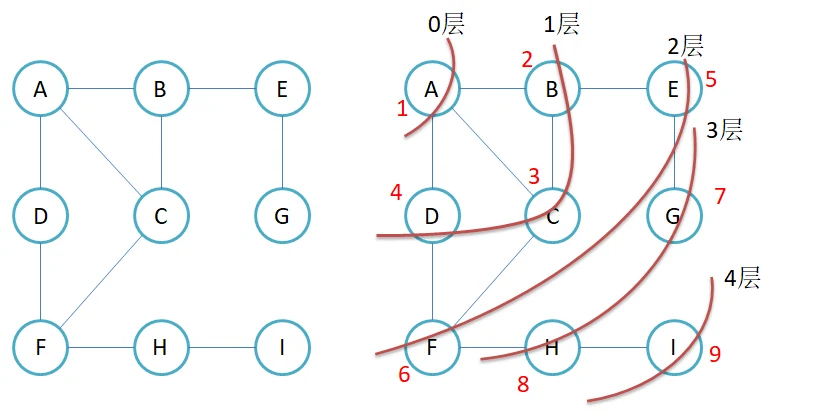
在课件那张九城市图上,从 a 出发的分层是:a;b h;c g i;d f;e。a 到 e 至少要四条边,走 a-b-c-d-e 或 a-h-g-f-e 都是。DFS 给不了这个保证,它只保证每个点都到过一遍。
DFS 用递归或栈,一条路走到底,走不动了再回溯:
template<class V, class W, W MAX_W, bool Direction>
void Graph<V, W, MAX_W, Direction>::_DFS(size_t u, vector<bool>& vis) const
{
    if (vis[u])
        return;
    vis[u] = true;
    cout << _vertexs[u] << ' ';

    for (size_t v = 0; v < _vertexs.size(); ++v)
        if (!vis[v] && _matrix[u][v] != MAX_W)
            _DFS(v, vis);
}

template<class V, class W, W MAX_W, bool Direction>
void Graph<V, W, MAX_W, Direction>::DFS(const V& src) const
{
    vector<bool> vis(_vertexs.size(), false);
    _DFS(GetVertexIndex(src), vis);
    cout << '\n';
}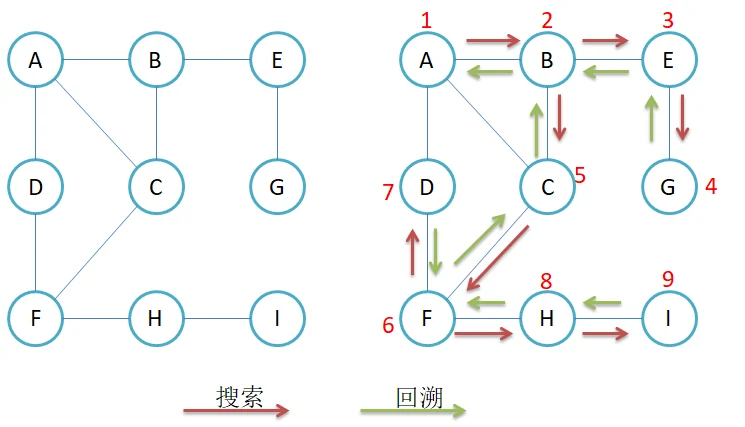
非连通图还要补一圈外层循环。只从 src 出发,只能走完它所在的连通分量,剩下的孤岛要各自再起一次遍历。课件 DFS 那段代码是从邻接表版本搬过来的,成员名写成 _v、_linkEdges,而类里叫 _vertexs、_linkTable,字段叫 _dstIndex,原样粘贴编译不过。同一段 BFS 里还有 printf("%s的%d度好友:", src.c_str(), d),模板参数换成 int 就编不过——c_str() 只属于 std::string。上面两段统一用 cout,模板换成 char、int 都能过。
最小生成树:Kruskal 按边贪心,Prim 按点贪心
最小生成树(minimum spanning tree)要在一张连通带权图里选出 n−1 条边,既把所有顶点连起来,又不许成环,并让总权值最小。构造准则只有三条:只能用图里的边;恰好 n−1 条;不能构成回路。两种算法都用贪心,区别是贪心的对象。
Kruskal 从全局最短的边开始,逐条检查:两端已经在同一连通分量就跳过,否则收下。判环用并查集,查询近似常数。
template<class V, class W, W MAX_W, bool Direction>
W Graph<V, W, MAX_W, Direction>::Kruskal(Self& minTree) const
{
    size_t n = _vertexs.size();
    minTree = Self(_vertexs.data(), n);

    priority_queue<Edge, vector<Edge>, Cmp> pq;
    for (size_t i = 0; i < n; ++i)
        for (size_t j = i + 1; j < n; ++j)
            if (_matrix[i][j] != MAX_W)
                pq.push(Edge(i, j, _matrix[i][j]));

    vector<int> uf(n, -1);
    auto find = [&uf](int x)
    {
        while (uf[x] >= 0)
            x = uf[x];
        return x;
    };

    W total{};
    size_t used = 0;
    while (!pq.empty() && used + 1 < n)
    {
        Edge e = pq.top();
        pq.pop();

        int a = find(static_cast<int>(e._s));
        int b = find(static_cast<int>(e._d));
        if (a == b)                       // 已成环
            continue;

        uf[a] += uf[b];
        uf[b] = a;
        minTree._AddEdge(e._s, e._d, e._w);
        total += e._w;
        ++used;
    }
    return (used + 1 == n) ? total : W{};
}
九城市那张图的 14 条边排好是:g-h 1、c-i 2、f-g 2、a-b 4、c-f 4、g-i 6、c-d 7、h-i 7、a-h 8、b-c 8、d-e 9、e-f 10、b-h 11、d-f 14。前五条全收;g-i 6 两端已经在同一块,跳过;c-d 7 收下;h-i 7 成环,跳过;a-h 8 把两块接上;b-c 8 成环;d-e 9 收下。总数 1+2+2+4+4+7+8+9 = 37。
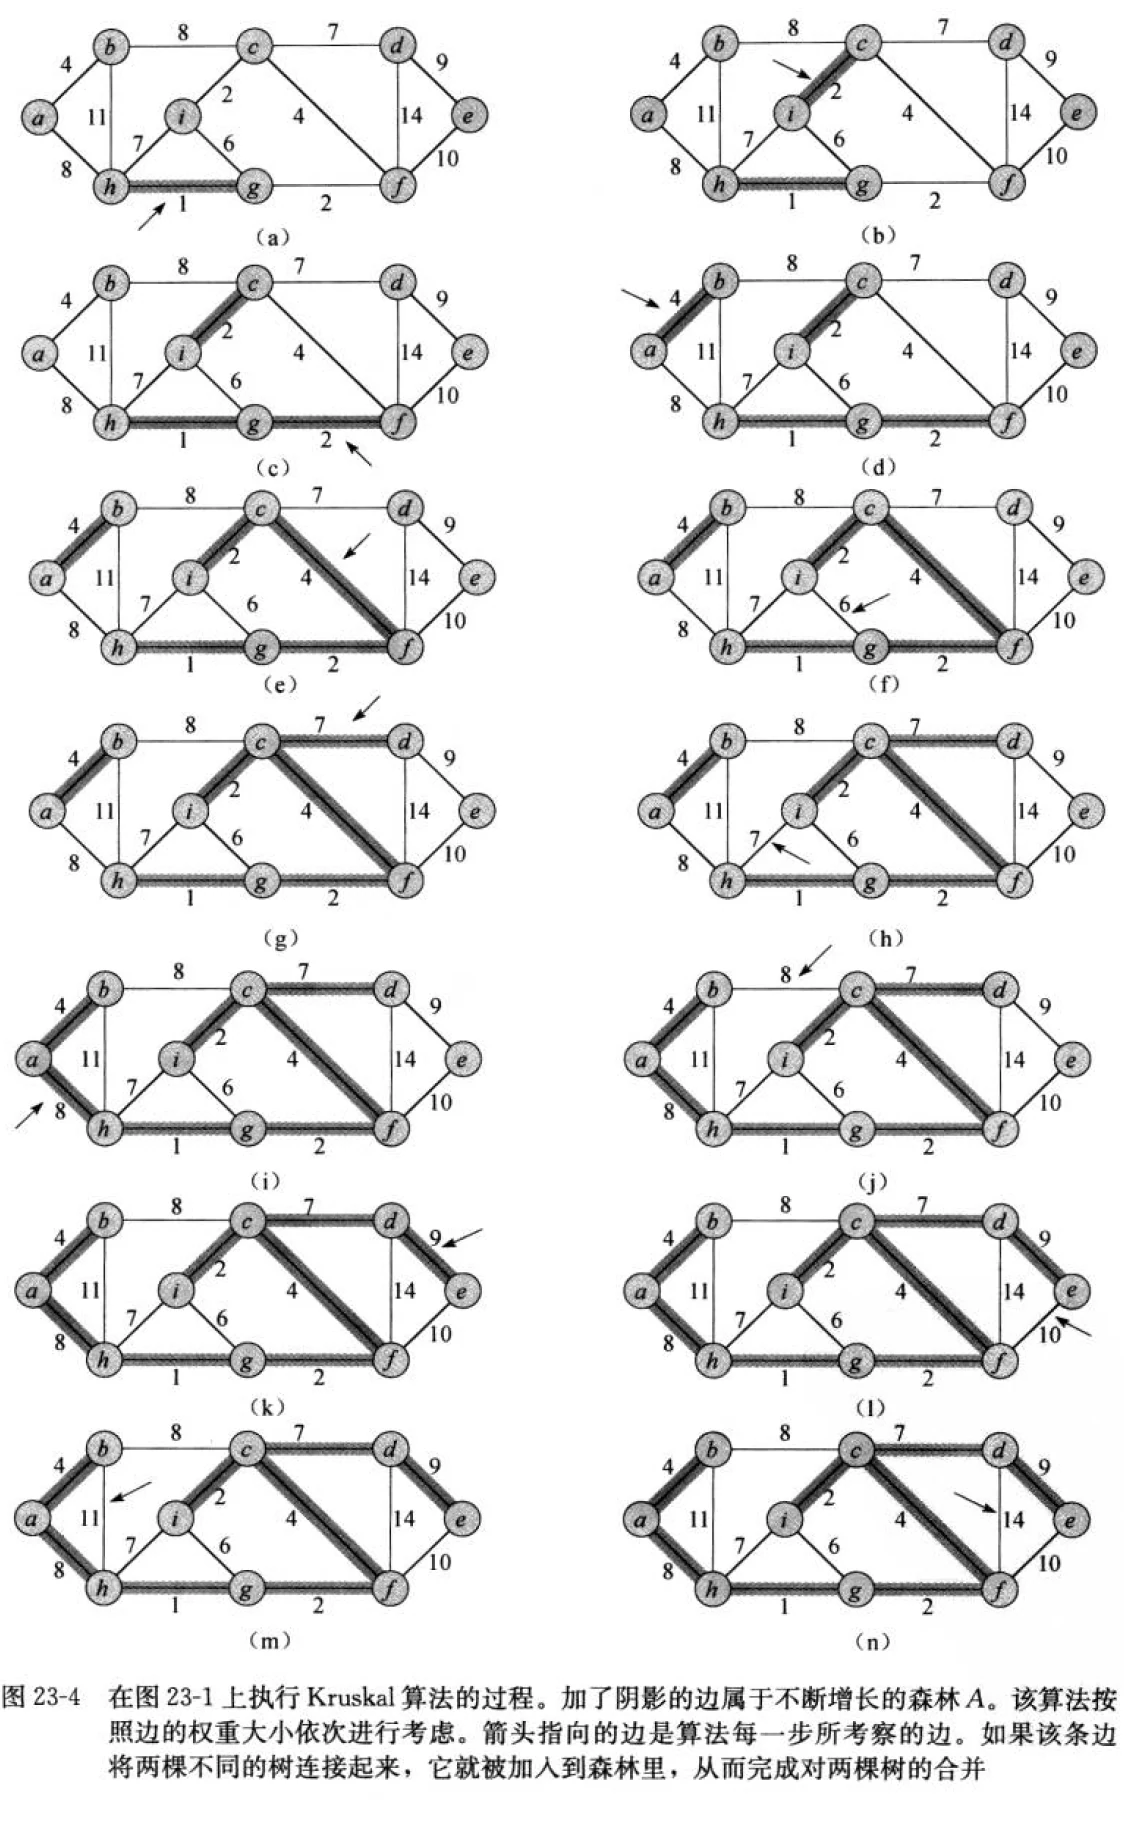
Prim 换一个贪心对象:从一个起点开始,维护“已选顶点集合”,每轮从集合内外之间挑一条最短的边,把新顶点拉进来。下面用 low[v] 记录当前树到 v 的最短边,矩阵实现是 O(V²),配堆可以做到 O(E log V)。
template<class V, class W, W MAX_W, bool Direction>
W Graph<V, W, MAX_W, Direction>::Prim(Self& minTree, const V& src) const
{
    size_t n = _vertexs.size();
    size_t s = GetVertexIndex(src);
    minTree = Self(_vertexs.data(), n);

    vector<bool> in(n, false);
    vector<W> low(n, MAX_W);
    vector<size_t> from(n, s);

    in[s] = true;
    low[s] = W{};
    for (size_t v = 0; v < n; ++v)
        low[v] = _matrix[s][v];

    W total{};
    size_t cnt = 1;
    while (cnt < n)
    {
        size_t u = n;
        W best = MAX_W;
        for (size_t v = 0; v < n; ++v)
            if (!in[v] && low[v] < best)
            {
                best = low[v];
                u = v;
            }
        if (u == n)                       // 剩下的点都不可达,图不连通
            return W{};

        in[u] = true;
        total += best;
        minTree._AddEdge(from[u], u, best);
        ++cnt;

        for (size_t v = 0; v < n; ++v)
            if (!in[v] && _matrix[u][v] < low[v])
            {
                low[v] = _matrix[u][v];
                from[v] = u;
            }
    }
    return total;
}
同一张图上,Prim 从 a 出发的选择是 a-b 4、a-h 8、h-g 1、g-f 2、f-c 4、c-i 2、c-d 7、d-e 9,加起来还是 37,但选的边和 Kruskal 不完全一样。最小生成树本来就不唯一,只要总权值最小。
两个边界要记住。有向图上没有“最小生成树”,有向版本叫最小树形图,要求从一个根能到所有点、每个非根点入度为 1,得用 Edmonds 算法;课件的 Kruskal 和 Prim 默认无向,拿有向图去调,结果错得毫无征兆。另一个是返回值:不连通时返回 W(),也就是 0,调用方分不清“不连通”和“生成树权值恰好是 0”,工程实现更稳的是返回 bool,权值走输出参数。
最短路径:Dijkstra、Bellman-Ford、Floyd
Dijkstra 是单源最短路(single-source shortest path):把所有顶点分成已确定的集合 S 和未确定的集合 Q,每轮从 Q 里挑当前距离最小的点 u 收进 S,再用 u 松弛它的邻居。松弛就是比较 dist[u] + w(u, v) 与 dist[v],更小就更新。
| 轮次 | 选中 | s | t | x | y | z |
|---|---|---|---|---|---|---|
| 初始 | 无 | 0 | ∞ | ∞ | ∞ | ∞ |
| 1 | y(5) | 0 | 8 | 14 | 5 | 7 |
| 2 | z(7) | 0 | 8 | 13 | 5 | 7 |
| 3 | t(8) | 0 | 8 | 9 | 5 | 7 |
| 4 | x(9) | 0 | 8 | 9 | 5 | 7 |
这是课件那张五顶点图:s→t 10、s→y 5、y→t 3、y→x 9、y→z 2、z→s 7、z→x 6、t→y 2、t→x 1、x→z 4。y 一进集合,y→t 3 把 t 从 10 压到 8;t 进来后 t→x 1 再把 x 从 13 压到 9。每次下降都发生在“u 已经确定”之后。
template<class V, class W, W MAX_W, bool Direction>
void Graph<V, W, MAX_W, Direction>::Dijkstra(const V& src,
                                             vector<W>& dist,
                                             vector<int>& parent) const
{
    size_t n = _vertexs.size();
    size_t s = GetVertexIndex(src);

    dist.assign(n, MAX_W);
    parent.assign(n, -1);
    vector<bool> done(n, false);
    dist[s] = W{};

    for (size_t i = 0; i < n; ++i)
    {
        size_t u = n;
        W best = MAX_W;
        for (size_t v = 0; v < n; ++v)
            if (!done[v] && dist[v] < best)
            {
                best = dist[v];
                u = v;
            }
        if (u == n)                       // 剩下的点都不可达
            break;

        done[u] = true;
        for (size_t v = 0; v < n; ++v)
            if (!done[v] && _matrix[u][v] != MAX_W
                && dist[u] + _matrix[u][v] < dist[v])
            {
                dist[v] = dist[u] + _matrix[u][v];
                parent[v] = static_cast<int>(u);
            }
    }
}
矩阵实现的复杂度是 O(V²),邻接表配二叉堆是 O((V + E) log V),稀疏图上才划算。
Dijkstra 不能处理负权边。课件写“只能解决正权图”,这个要求比实际更严:边权为 0 是可以的,真正不能碰的是负数。原因在正确性论证里:一个顶点 u 被收进 S 时,算法认定它的距离已经最小,此后不会再有更短的路径。这个论证依赖“所有边权非负”——从 S 出发的任何一条新路径,第一步就要加上一个非负权值,不可能比已经确定的 dist[u] 更小;出现负权边时,先确定的点可能在后面被更短的路径推翻。
课件的反例 s→t 10、s→y 5、t→y −7 就是这样:y 以 5 先被收进集合,之后 s→t→y 只有 3,但 y 已经“盖章”,不会再更新。代码没错,是算法的前提没了。负权回路更严重——绕着环走一圈距离可以无限变小,最短路径根本不存在。
Bellman-Ford 放弃“按点确定”,改成每轮把所有边松一遍,做 n−1 轮。一条最短路径最多 n−1 条边,每轮至少能多确定一条,够了。它支持负权,也能检测负权回路。
template<class V, class W, W MAX_W, bool Direction>
bool Graph<V, W, MAX_W, Direction>::BellmanFord(const V& src,
                                                vector<W>& dist,
                                                vector<int>& parent) const
{
    size_t n = _vertexs.size();
    size_t s = GetVertexIndex(src);
    dist.assign(n, MAX_W);
    parent.assign(n, -1);
    dist[s] = W{};

    for (size_t round = 1; round < n; ++round)
    {
        bool changed = false;
        for (size_t i = 0; i < n; ++i)
        {
            if (dist[i] == MAX_W)          // 不可达就别参与加法
                continue;
            for (size_t j = 0; j < n; ++j)
                if (_matrix[i][j] != MAX_W
                    && dist[i] + _matrix[i][j] < dist[j])
                {
                    dist[j] = dist[i] + _matrix[i][j];
                    parent[j] = static_cast<int>(i);
                    changed = true;
                }
        }
        if (!changed)                      // 这一轮没有任何更新,提前收敛
            break;
    }

    for (size_t i = 0; i < n; ++i)
    {
        if (dist[i] == MAX_W)
            continue;
        for (size_t j = 0; j < n; ++j)
            if (_matrix[i][j] != MAX_W && dist[i] + _matrix[i][j] < dist[j])
                return false;              // 还能松弛,说明存在负权回路
    }
    return true;
}
课件这段代码少了一个保护:它没有跳过 dist[i] == MAX_W 的顶点。W 取 int、MAX_W 取 INT_MAX 时,dist[i] + _matrix[i][j] 会把 INT_MAX 加上一个正权值,有符号整数溢出在 C++ 里是未定义行为,优化器可以把整段判断改得面目全非。上面这段先判可达再相加。复杂度是 O(VE),邻接矩阵实现是 O(V³)。
Floyd-Warshall 一次算全源最短路径。它的本质是三维动态规划:D[i][j][k] 表示从 i 到 j、只允许经过编号 0 到 k 的点作中转时的最短距离,转移方程是“不用 k”与“用 k 中转”取小,然后把第三维优化掉,变成原地更新的三重循环。
template<class V, class W, W MAX_W, bool Direction>
void Graph<V, W, MAX_W, Direction>::Floyd(vector<vector<W>>& dist,
                                          vector<vector<int>>& parent) const
{
    size_t n = _vertexs.size();
    dist.assign(n, vector<W>(n, MAX_W));
    parent.assign(n, vector<int>(n, -1));

    for (size_t i = 0; i < n; ++i)
        for (size_t j = 0; j < n; ++j)
            if (_matrix[i][j] != MAX_W)
            {
                dist[i][j] = _matrix[i][j];
                parent[i][j] = static_cast<int>(i);
            }
    for (size_t i = 0; i < n; ++i)
    {
        dist[i][i] = W{};
        parent[i][i] = -1;
    }

    for (size_t k = 0; k < n; ++k)                 // k 必须最外层
        for (size_t i = 0; i < n; ++i)
        {
            if (dist[i][k] == MAX_W)
                continue;
            for (size_t j = 0; j < n; ++j)
                if (dist[k][j] != MAX_W
                    && dist[i][k] + dist[k][j] < dist[i][j])
                {
                    dist[i][j] = dist[i][k] + dist[k][j];
                    parent[i][j] = parent[k][j];
                }
        }
}
k 放在外层,含义是“这一轮只允许编号不超过 k 的点当中转”。把 i 放外层,你用的 dist[i][k] 可能还没经历第 k 轮更新,转移就不成立。parent[i][j] = parent[k][j] 不能写成 k:i 到 j 经由 k 时,j 的前驱继承的是“k 到 j”那条路径的末尾。Floyd 允许负权边,但负环会让 dist[i][i] 被压成负数,所有结果都不可信;O(V³) 的时间和 O(V²) 的空间,只适合几百个顶点以内的图。
拓扑排序与连通分量
拓扑排序(topological sort)只对有向无环图(DAG)有意义:把顶点排成一条线,让每条边都从前指向后。Kahn 算法的做法是不断取出入度为 0 的点,删掉它的出边,再把新出现的入度 0 点入队。
template<class V, class W, W MAX_W, bool Direction>
bool Graph<V, W, MAX_W, Direction>::TopoSort(vector<size_t>& order) const
{
    size_t n = _vertexs.size();
    vector<size_t> indeg(n, 0);
    for (size_t i = 0; i < n; ++i)
        for (size_t j = 0; j < n; ++j)
            if (_matrix[i][j] != MAX_W)
                ++indeg[j];

    queue<size_t> q;
    for (size_t i = 0; i < n; ++i)
        if (indeg[i] == 0)
            q.push(i);

    order.clear();
    while (!q.empty())
    {
        size_t u = q.front();
        q.pop();
        order.push_back(u);

        for (size_t v = 0; v < n; ++v)
            if (_matrix[u][v] != MAX_W && --indeg[v] == 0)
                q.push(v);
    }
    return order.size() == n;              // 少于 n 个说明有环
}
拓扑序不唯一:同一时刻有多个入度 0 的点,先取谁都合法。如果图里有环,环上的点入度永远降不到 0,最终 order 的长度小于 n,这就是判环的依据。无向图不要拿这个函数试,对称矩阵会把每条边算成两次入度。
连通分量分两种。无向图的连通分量用一次 DFS/BFS 就能数:每个未访问顶点起一次遍历,计数器加一。
template<class V, class W, W MAX_W, bool Direction>
size_t Graph<V, W, MAX_W, Direction>::ComponentCount() const
{
    size_t n = _vertexs.size();
    vector<bool> vis(n, false);
    size_t cnt = 0;

    for (size_t s = 0; s < n; ++s)
    {
        if (vis[s])
            continue;
        ++cnt;

        queue<size_t> q;
        q.push(s);
        vis[s] = true;
        while (!q.empty())
        {
            size_t u = q.front();
            q.pop();
            for (size_t v = 0; v < n; ++v)
                if (!vis[v] && _matrix[u][v] != MAX_W)
                {
                    vis[v] = true;
                    q.push(v);
                }
        }
    }
    return cnt;
}
有向图的强连通分量(strongly connected component)不是这个函数能算的:从 s 能到 t、从 t 也能到 s 才算同一个分量。两条常见路线,Kosaraju 在原图和反图上各做一次 DFS,按完成时间逆序处理;Tarjan 用一次 DFS,靠 dfn、low 和一个栈把分量弹出来。两者都是 O(V+E)。
把这几种问法放在一起,选择只有三步:边权有没有负数,有就排掉 Dijkstra;单源还是全源,全源且点少才上 Floyd;图稠不稠,稠密用矩阵,稀疏用邻接表加堆。真正难的部分在建图之前:关系有没有方向、代价是不是权、边要不要显式存。建错了,后面所有算法都只是在正确地算一张错的图。
还没有评论 — 第一条由你来留。