并查集(union-find set,也叫 disjoint-set)解决的问题很窄:把 n 个元素分成若干不相交的集合,支持“合并两个集合”和“问某个元素属于哪个集合”。它不维护集合内部的顺序,也不支持拆分,只关心等价关系。
课件用校招分队举例:10 个学生编号 0 到 9,西安 4 人、成都 3 人、武汉 3 人,结果形成 {0,6,7,8}、{1,4,9}、{2,3,5} 三个集合。每个集合选一个队长当代表元,其余人只记“自己的队长是谁”。
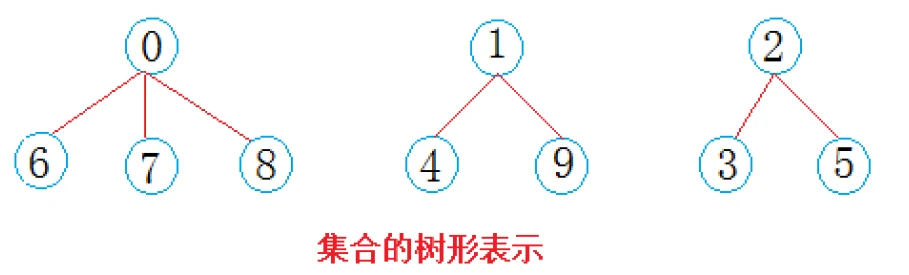
负数才是根,正数是父亲下标
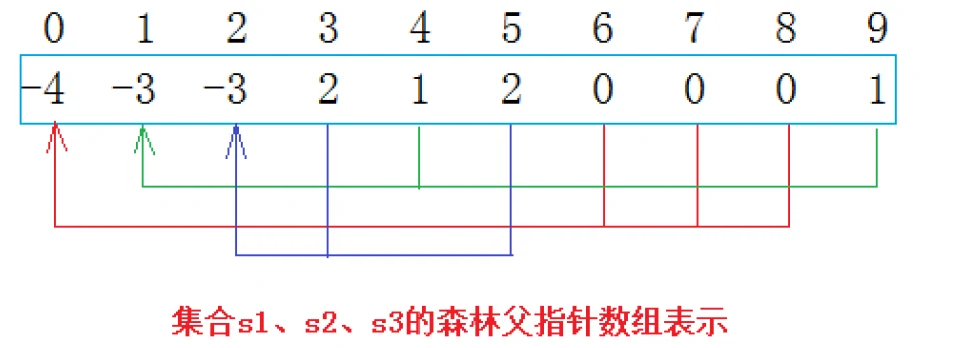
这套结构只用一个一维数组。下标是元素编号,数组值有两种含义:
- 负数:这个位置是根,绝对值是该集合的元素个数;
- 非负数:这个位置不是根,值是父亲结点在数组中的下标。
初始时每个元素自成一个集合,数组全是 -1:自己是根,人数为 1。
课件在这里有一处注释和代码相反:构造函数注释写“初始时,将数组中元素全部设置为 1”,紧跟的代码却是 _ufs(size, -1)。如果真按注释设成全 1,所有位置都成了“父亲下标为 1”的非根结点,一个根都没有,FindRoot 会顺着 1 一路越界。以代码为准,注释是错的。
课件另一处笔误在同一页:它说 3 号和 5 号属于 2 号小分队,“包含队长 1”。按它自己给的 s3 = {2,3,5} 和数组 _ufs[2] = -3,队长是 2 号。不影响算法,但对着图核对数组时会多算一次。
这套编码有一个便宜的自检:所有元素的值加起来恰好等于 -n。合并只是把两个负数相加,总和不变;只要总和对不上 -n,就说明某次合并把下标当人数加进去了,或者根上的负数被改成了正数。
Find 往上爬,Union 先把人数记账再搬家
#include <vector>
#include <string>
#include <algorithm>
#include <utility>
#include <cstddef>

using namespace std;

class UnionFindSet
{
public:
    explicit UnionFindSet(size_t n) : _ufs(n, -1) {}

    int FindRoot(int x)
    {
        while (_ufs[x] >= 0)          // 负数即根
            x = _ufs[x];
        return x;
    }

    bool Union(int x1, int x2)
    {
        int r1 = FindRoot(x1);
        int r2 = FindRoot(x2);
        if (r1 == r2)                 // 已经在同一个集合
            return false;

        if (_ufs[r1] > _ufs[r2])      // 负数是人数:-3 > -5,说明 r1 人更少
            swap(r1, r2);
        _ufs[r1] += _ufs[r2];         // 先记账:人数累加
        _ufs[r2] = r1;                // 后搬家:r2 认 r1 当父亲
        return true;
    }

    size_t Count() const
    {
        size_t cnt = 0;
        for (int e : _ufs)
            if (e < 0)
                ++cnt;                // 负数的个数就是集合的个数
        return cnt;
    }

private:
    vector<int> _ufs;
};
Union 那两行的顺序不能颠倒。假设两个根的值是 -4 和 -3,先写 _ufs[r2] = r1,r2 那格就变成了 0;再执行 _ufs[r1] += _ufs[r2],加进去的是 0 而不是 -3,合并后的根还写着 -4,人数少算三个。反过来先记账再搬家,加的是集合人数,得到 -7。
这套编码还让 Union 天然幂等:两个元素已经在同一集合时直接返回 false,重复合并不会改变任何东西。课件的省份代码扫整张矩阵,对称矩阵会让每条边被处理两次,靠的就是这一点兜底;下面改成只扫上三角。
固定让第一个参数当根,会退化成一条链
先把按大小合并的那三行去掉,固定让 r2 挂到 r1 下面,朴素版的弱点就出来了。按 Union(1,0)、Union(2,1)、Union(3,2) 一直到 Union(7,6) 的顺序合并,0 号会被一路压到链底,查 0 要爬 7 步;N 个元素就是 N 步。这不是运气问题,输入顺序可以精确构造出最坏情况。
路径压缩(path compression)就是冲着这条链来的:Find 已经从头爬到根,返回前顺手把路上的每个结点都改成直接指向根。把上面类里的 FindRoot 换成下面这个成员函数,其余成员不动:
int FindRoot(int x)
{
    int root = x;
    while (_ufs[root] >= 0)              // 第一趟:爬到根
        root = _ufs[root];

    while (_ufs[x] >= 0)                 // 第二趟:沿原路把结点挂到根
    {
        int parent = _ufs[x];
        _ufs[x] = root;
        x = parent;
    }
    return root;
}
第二趟不能省。第一趟结束时 root 已经站在根上,原来路径上的中间下标全丢了;不回头走一遍,只能压到当前结点,而当前结点本来就是根。递归版可以靠调用栈记住路径,但长链上的递归深度是 O(n),几百万个元素足以爆栈,所以工程实现通常用这两趟循环。
压缩不改变正确性:父亲指针只用来找根,不承载顺序。把“指向父亲”改成“指向根”,等价关系没有变化,变的只是下一次要走几步。
按大小合并把树高压在对数,两件一起用才到 α(n)
路径压缩只在 Find 被调用时发生。如果一口气做几百万次 Union、一次 Find 都不做,丑树照样越长越高。所以还需要一条合并规则:把小树挂到大树下。
把这三行放回 Union:比较两个根的负数,绝对值小的那个根挂到绝对值大的下面。-3 > -5 成立,但 -3 代表 3 个人、-5 代表 5 个人;值更大意味着人更少,所以要交换,让 r1 指向人多的根。照抄正数世界的 <,就会把大树挂到小树下。
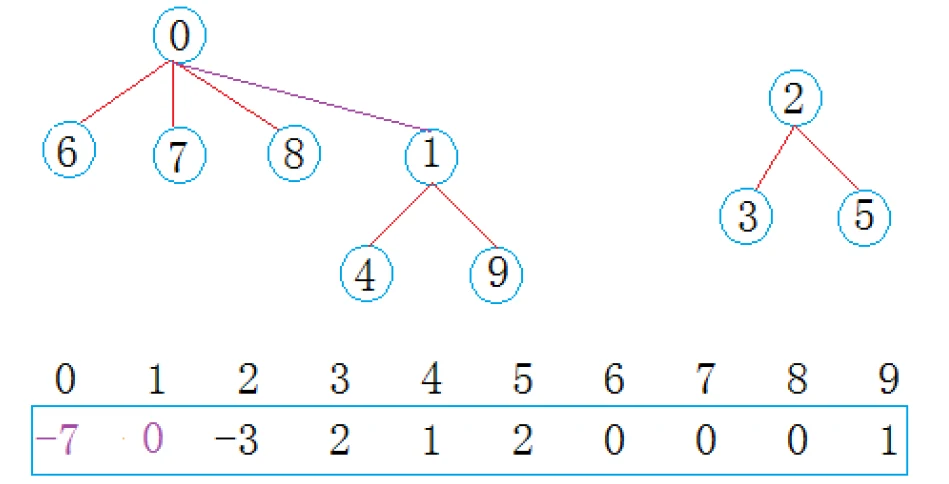
按大小合并能把树高压在 O(log n)。理由很短:高度只在两棵同样高的树合并时增加 1,而每次发生这种情况,集合大小至少翻倍;从 1 长到 n,最多翻 log₂n 次。
用大小而不是高度,是因为路径压缩随时在改树高,维护精确高度既麻烦又不准;集合大小在合并时直接相加,永远准确。教材里更常见的按秩合并(union by rank)用“树高上界”作秩,需要额外一个数组,效果一样。
两件一起用,单次操作的摊还代价是 O(α(n))。Tarjan 在 1975 年的论文里给出了这个上界(《Efficiency of a Good But Not Linear Set Union Algorithm》,JACM 第 22 卷)。α 是反阿克曼函数(inverse Ackermann function),增长极慢,实际规模下 α(n) 都不超过 4。所以“并查集是 O(1)”只是工程上的近似,准确说法是摊还 O(α(n))。
两个常被记反的结论:只做路径压缩、不做按大小合并,摊还复杂度是 O(log n);只做按大小合并、不做压缩,单次最坏也是 O(log n)。两者都上,才降到 O(α(n))。
省份数量、等式方程,以及 Kruskal 的判环
三个应用都只用到“同根即同集合”这一条。
省份数量给一张 n × n 的 isConnected 矩阵,1 表示两座城市直接相连,问有几个连通分量。矩阵对称,扫上三角就够:
int FindCircleNum(const vector<vector<int>>& isConnected)
{
    int n = static_cast<int>(isConnected.size());
    UnionFindSet uf(n);

    for (int i = 0; i < n; ++i)
        for (int j = i + 1; j < n; ++j)       // 对称矩阵只扫上三角
            if (isConnected[i][j] == 1)
                uf.Union(i, j);

    return static_cast<int>(uf.Count());
}
等式方程要判断 a==b、a!=b 这一组约束能否同时成立。做法分两遍:先把所有 == 合并,再逐条检查 != 的两端是不是已经同根。
bool EquationsPossible(const vector<string>& equations)
{
    UnionFindSet uf(26);

    for (const auto& s : equations)          // 第一遍:只处理等号
        if (s[1] == '=')
            uf.Union(s[0] - 'a', s[3] - 'a');

    for (const auto& s : equations)          // 第二遍:检查不等号
        if (s[1] == '!' && uf.FindRoot(s[0] - 'a') == uf.FindRoot(s[3] - 'a'))
            return false;

    return true;
}
顺序必须是“合并全部完成,再检查全部不等”。处理到 a!=c 时,a 和 c 可能还没被后面的 b==c 连起来,边合并边检查会漏掉矛盾。课件第二个循环的注释写成了“第一遍”,那是第二遍,读代码时容易把两遍的职责看反。
Kruskal 里的用法更直接:一条边加进去会成环,当且仅当它的两个端点当前已经连通。Union 返回 false 正好就是“已连通”:
struct Edge
{
    int u, v, w;
};

int KruskalTotal(vector<Edge> edges, int n)
{
    sort(edges.begin(), edges.end(),
         [](const Edge& a, const Edge& b) { return a.w < b.w; });

    UnionFindSet uf(n);
    int total = 0;
    int used = 0;

    for (const auto& e : edges)
    {
        if (!uf.Union(e.u, e.v))      // 两端已同集合,收下这条边必成环
            continue;
        total += e.w;
        if (++used == n - 1)
            break;
    }
    return (used == n - 1) ? total : -1;
}
主循环被压成“排序、合并一次”,并查集部分的 O(E α(V)) 远小于排序的 O(E log E),Kruskal 的瓶颈在排序,不在并查集。
并查集还有一个边界:它只支持合并,不支持拆分。需要“删掉一条边再看连不连通”时,得换 Link-Cut Tree 或离线分治;拿只支持加边的结构处理会删边的场景,是误用而不是代码写错。
还没有评论 — 第一条由你来留。