有序链表的查找是 O(N):从头一个个比,找末尾要摸 N 个结点。跳表(skiplist)在这条链表上叠几层稀疏索引,把“逐个比”变成“先大步跳,跳不动再降一层”。
Pugh 在 1990 年的论文里提出了它,skip 指的就是高层指针跳过中间结点。
一层索引减一半,严格比例却维护不了
最直接的想法:每相邻两个结点挑一个升高一层,在这一层多一个指针,指向下面隔一个的结点。新增的指针自己连成一条链表,结点数只有原来的一半;查找先在这条稀疏链上走,走不动再降回底层,比较次数大致砍半。同样的操作再做一遍,就有第三层,查找过程越来越像二分。
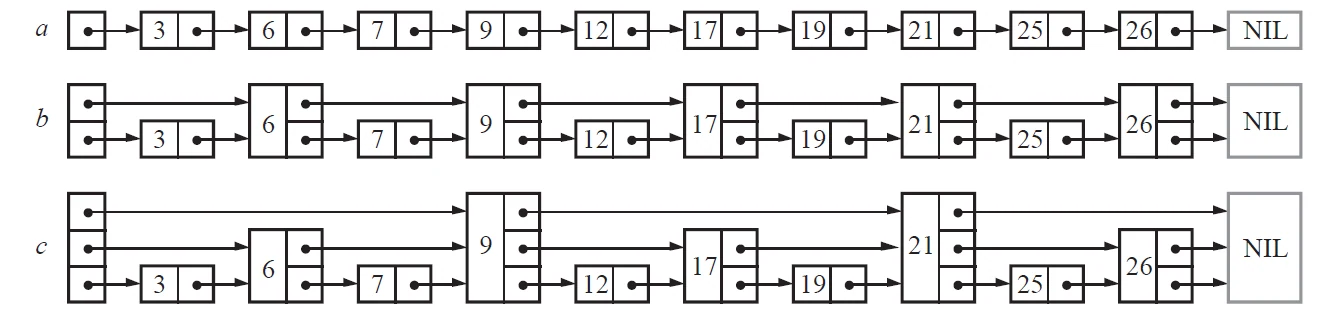
严格 2:1 靠的是跨层约束:谁升到第二层由底层编号决定,逢二的升。底层插一个结点,从它往后所有编号都变,整段映射失效;删一个结点,若它正好是某层指针的端点,上面那根指针立刻悬空。恢复比例要把插入位置之后的结点重排一遍,O(N)。一次本该 O(1) 的链表插入,被目录维护拖回了线性。
跳表的做法是放弃比例:插入时给新结点随机摇一个层数,摇到几层就占几层,跟前后的结点完全无关。插入只关心一件事——在自己占用的每一层上,前驱是谁、后继是谁,把指针接上;别的结点是一层还是十层,一概不管。删除同理,只摘自己出现过的那些层。
随机层数的分布与平均指针数
摇法是连续掷有偏硬币:从第 1 层开始,以概率 p 成功升一层,成功就再掷,失败就停,摸到 maxLevel 也停。
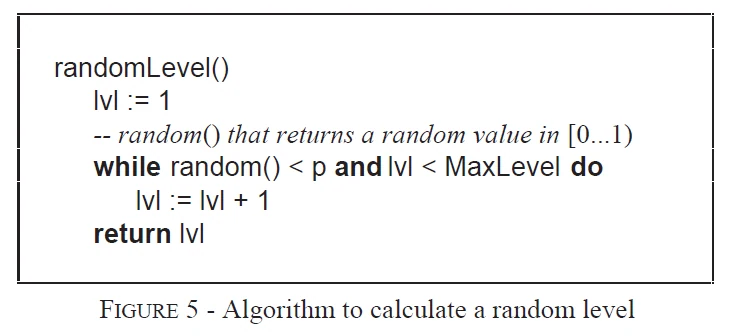
没碰到 maxLevel 截断时,层数 L 服从几何分布:
| 事件 | 概率 |
|---|---|
L ≥ 1 | 1 |
L ≥ 2 | p |
L ≥ k | p^(k−1) |
L 恰好等于 k(k < maxLevel) | p^(k−1)(1−p) |
课件漏了截断:循环条件 level < maxLevel 让最高层强制停,P(L = maxLevel) = p^(maxLevel−1),而不是 p^(maxLevel−1)(1−p)。这个概率极小,但公式上不是几何分布的原样。
一个结点的平均层数,也就是平均持有多少个 forward 指针(每一层的后继指针),用 E[L] = Σ P(L ≥ k) 算(忽略最高层截断)是 1/(1−p)。p=1/2 得 2,p=1/4 得 1.33。这个数只跟 p 有关,跟元素总数无关:十亿个元素的跳表,每个结点平均还是一点几个指针。
maxLevel 取 32 也是算出来的。第 k 层期望剩 N × p^(k−1) 个结点,当它接近 1 时再高就没结点了,实际最高层大约在 log_{1/p} N。p=1/4 时是 log₄N;覆盖 N = 2⁶⁴ 需要 log₄2⁶⁴ = 32。Redis 源码里的两个常量正好对得上:ZSKIPLIST_MAXLEVEL 32、ZSKIPLIST_P 0.25。
期望 O(log N):每层走 1/p 步,共 log 层
课件只给了“平均 O(logN)”的结论,推导可以自己算。
跳表的查找路径从最高层开始,能往右就往右,走不动就下降。把这条路径倒过来看:从命中位置回到头结点,每一步要么向左走,要么向上升一层。在一个固定层上,当前结点“向上”的概率是 p(它的层数超过当前层),继续向左的概率是 1−p,所以在这一层向左走的期望步数是 (1−p)/p,再加上上升的那一步,总共 1/p 步。
层数有 log_{1/p}N 量级,于是整条路径的期望长度是:
(1/p) × log_{1/p}N
p=1/4 时,log_{1/p}N = log₄N = 0.5 log₂N,乘 4 得 2 log₂N。也就是说,跳表的常数比理想平衡树略大(大约两倍的比较次数),但它是期望,不是最坏保证。
最坏情况是所有结点都摇成一层,跳表退化成一条普通链表,查找 O(N)。这个概率是 (1−p)^N,p=1/4、N=100 万时小到可以忽略。坏运气也不累积:这次形状难看,下次插入又是新的随机数,不像平衡树那样留下一个需要持续修补的结构。
查找、插入、删除:三处接线不能反
实现只有三件事:找各层前驱、摇层数、逐层接线。查找的规则可以压成两句:下一个比目标小就往右,下一个为空或比目标大就下降。
#include <vector>
#include <random>
#include <cstddef>

using namespace std;

struct SkipNode
{
    int _val;
    vector<SkipNode*> _next;        // _next[i] 是第 i 层的后继
    SkipNode(int val, int level) : _val(val), _next(level, nullptr) {}
};

class Skiplist
{
public:
    Skiplist()
        : _head(new SkipNode(-1, 1))
        , _rng(random_device{}())
        , _dist(0.0, 1.0)
    {}

    ~Skiplist()
    {
        SkipNode* cur = _head;
        while (cur)
        {
            SkipNode* next = cur->_next[0];
            delete cur;
            cur = next;
        }
    }

    bool search(int target) const
    {
        SkipNode* cur = _head;
        int level = static_cast<int>(_head->_next.size()) - 1;

        while (level >= 0)
        {
            if (cur->_next[level] && cur->_next[level]->_val < target)
                cur = cur->_next[level];              // 能往右就往右
            else if (!cur->_next[level] || cur->_next[level]->_val > target)
                --level;                              // 走不动就下降
            else
                return true;                          // 下一个正好相等
        }
        return false;
    }

    void add(int num)
    {
        vector<SkipNode*> prev = PrevNode(num);
        int n = RandomLevel();

        if (n > static_cast<int>(_head->_next.size()))
        {
            _head->_next.resize(n, nullptr);          // 先拔高头结点
            prev.resize(n, _head);                    // 新层的前驱都是 head
        }

        SkipNode* node = new SkipNode(num, n);
        for (int i = 0; i < n; ++i)
        {
            node->_next[i] = prev[i]->_next[i];       // 先接后继
            prev[i]->_next[i] = node;                 // 再改前驱
        }
    }

    bool erase(int num)
    {
        vector<SkipNode*> prev = PrevNode(num);
        if (!prev[0]->_next[0] || prev[0]->_next[0]->_val != num)
            return false;                             // 底层都没有,值不在表里

        SkipNode* del = prev[0]->_next[0];
        for (size_t i = 0; i < del->_next.size(); ++i)
            prev[i]->_next[i] = del->_next[i];
        delete del;

        int i = static_cast<int>(_head->_next.size()) - 1;
        while (i > 0 && !_head->_next[i])             // 至少保留第 0 层
            --i;
        _head->_next.resize(i + 1);
        return true;
    }

private:
    vector<SkipNode*> PrevNode(int num) const
    {
        SkipNode* cur = _head;
        int level = static_cast<int>(_head->_next.size()) - 1;
        vector<SkipNode*> prev(level + 1, _head);

        while (level >= 0)
        {
            if (cur->_next[level] && cur->_next[level]->_val < num)
                cur = cur->_next[level];
            else
            {
                prev[level] = cur;                    // 该层前驱
                --level;
            }
        }
        return prev;
    }

    int RandomLevel()
    {
        int level = 1;
        while (level < _maxLevel && _dist(_rng) < _p)
            ++level;
        return level;
    }

    SkipNode* _head;
    int _maxLevel = 32;
    double _p = 0.25;
    mt19937 _rng;
    uniform_real_distribution<double> _dist;
};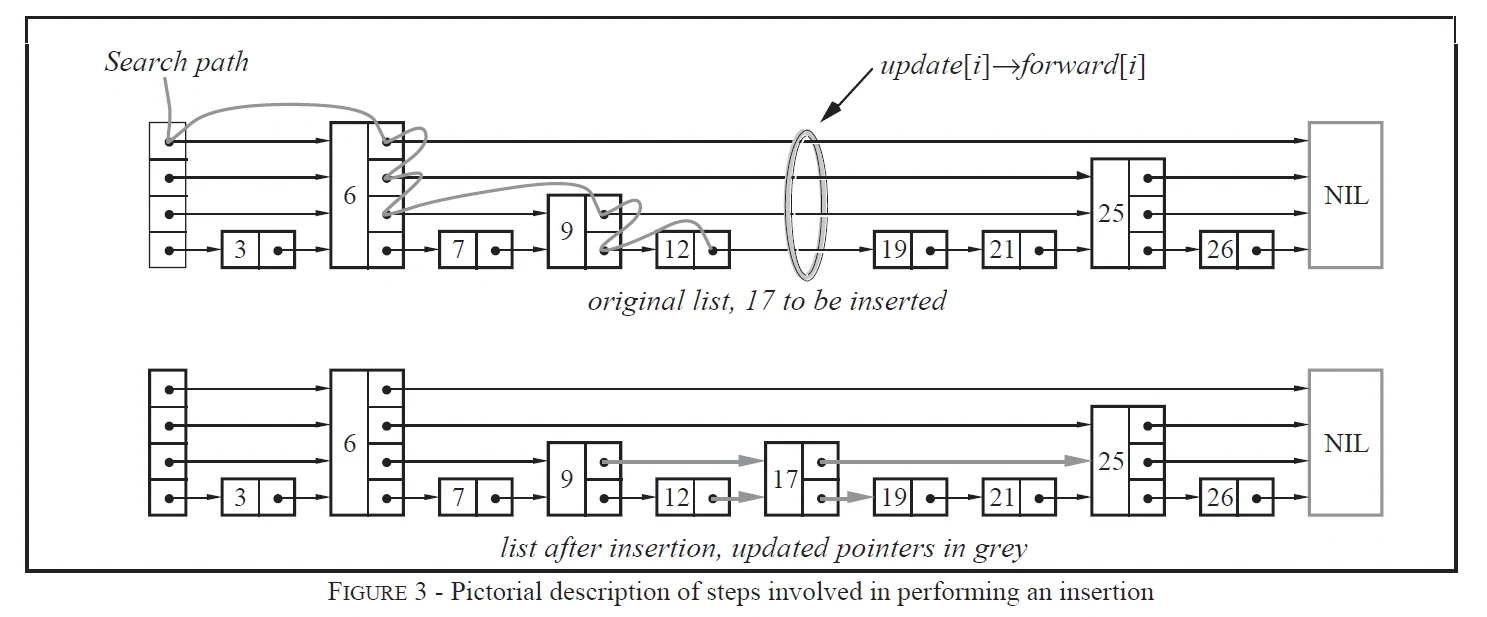
找前驱时,比较符要写成 <,遇到相等就停。这样新结点会排在等值序列的前面,删除时第 0 层前驱的下一个也一定是要删的那个;如果跨过相等结点,插入会追加到同值序列的尾部,删除也不稳定。
头结点拔高那一段的顺序不能反。新结点摇出 n 层,而 head 只有 h 层,h 到 n 之间除了 head 一个入口都没有。如果先接线再 resize,prev[i]->_next[i] 在这一层根本不存在,直接越界。先把 head 扩到 n 层,再把 prev 扩到 n(新增层的前驱默认是 head),再逐层挂。
删除后的收顶层,下界必须卡在 1。课件写的是 int i = _head->_nextV.size() - 1; 再一路减到 -1,然后 resize(i + 1)。如果删空整张表,这会把 head 缩成 0 层;下一次 search 里 size() - 1 是无符号 0 减 1,得到 SIZE_MAX,转成 int 是实现定义行为,换编译器就可能变成负数或者别的值。上面这段把循环条件写成 i > 0,最少保留第 0 层。
构造函数里的 srand(time(0)) 会重置全局序列,同一秒内建的两个对象层数完全一样;rand() <= RAND_MAX * _p 把边界也算进成功区间,p=1/4 时刚好精确,换成别的 p 就有系统偏差。上面改用成员 mt19937 加 uniform_real_distribution,不碰全局状态。
与平衡树、哈希表比,赢在实现和并发
| 跳表 | 平衡树(AVL/红黑) | 哈希表 | |
|---|---|---|---|
| 查找 | 期望 O(logN) | 最坏 O(logN) | 平均 O(1),最坏 O(N) |
| 有序遍历 | 沿第 0 层顺序走 | 中序遍历 | 不支持 |
| 单次插入的改动 | 改 O(1) 个前驱指针 | 可能旋转,动父、子、祖父 | 可能扩容、rehash |
| 最坏情况 | O(N) | O(logN) | O(N) |
| 额外空间 | 平均 1/(1−p) 个指针 | 每个结点固定几个指针加平衡信息 | 桶数组加结点指针 |
跳表相对平衡树的优势是实现短、容易控制:没有旋转、没有颜色,插入只改几个指针。代价是“期望”而不是“最坏”,以及对随机数质量的依赖。
哈希表只能点查,跳表还能范围查询和按排名取元素;代价是每个结点多一个 vector 头(常见实现 24 字节)加一次堆分配。
Redis 的有序集合不是“一个跳表”,而是哈希表加跳表:哈希表负责 member 到 score 的点查,跳表负责按 score 排序和范围扫描。只有这两样还不够支撑 ZSet 的命令集,Redis 在跳表结点里又加了两个字段:
span:这一层指针跨过了多少个第 0 层结点。ZRANK找排名时,向下走的同时把 span 累加,就能O(logN)算出名次;没有它只能从头数一遍。backward:第 0 层的反向指针。ZREVRANGE要倒着输出,没有它就得再扫一次。
ZRANGEBYSCORE 定位到起点后沿底层链表顺扫,ZRANK 靠 span 累加,ZREVRANGE 靠 backward 回退。这些字段不是炫技,是被命令集逼出来的。
跳表的改动天生局部,插入只改每层前驱的 forward 指针;Java 的 ConcurrentSkipListMap 因此可以读无锁、插入用 CAS 逐层挂。平衡树做不到,一次旋转要同时动父、子、祖父三个结点。
还没有评论 — 第一条由你来留。