性能测试和功能测试都在系统测试阶段做,问的问题不同。功能测试问“这个操作能不能完成”,性能测试问“在多少人同时用、用多快的情况下还能完成”。同一套功能,五菱和法拉利都能把人从 A 送到 B,差别不在功能表上,在座椅、加速和极限。落到软件上,页面突然打不开、刷新又好、双十一进不去商品页、列表转圈十几秒,都是功能还在、性能已经不行。
性能测试的定义是:为了发现系统性能问题或获取性能相关指标而进行的测试。通常在真实环境、特定负载条件下,用工具模拟实际运行和操作,同时监控各项指标,最后分析结果确定系统性能。
并发数是三类数字,别混着报
课件把并发用户数分成业务层面和后端层面。业务并发是“实际使用系统的用户总数”,例如一个系统有 5000 名员工使用,最多同时有 2500 人在线,业务并发就是 2500。后端并发是 Web 服务器在一段时间内处理的 HTTP 连接数或生成的线程数。还有一个“实际并发”,课件说它是“提交订单和查询订单操作的用户”——这句话描述的是用户类型,不是数量。实际并发要给出的是同一时刻正在向服务器发请求的用户数,是一个数字。
在线人数和并发请求数差得很远。1000 个用户在线,每人每 10 秒发一次请求,单次响应 100 毫秒,同一刻在途的请求约为 1000 × 0.1 / 10 = 10 个。在线的人绝大多数时间在看页面、填表单、发呆,不发请求。压测里说的“并发”通常指虚拟用户数,也不等于服务器上同时在处理的请求数;这两个数一起看,才能解释为什么 1000 个线程压不出 1000 个并发请求。
吞吐量是速率,TPS 与 QPS 差在事务边界
课件写“吞吐量是单位时间内处理的并发数”,这句把两个量纲混了:并发数是瞬时在场的个数,吞吐量是速率。准确的说法是单位时间内成功完成的事务数或请求数,失败请求不计入,否则重试风暴会把数字虚抬。
两个场景可以说明吞吐量和并发的区别。A 场景 100 个用户,每人每秒发一个请求;B 场景 1000 个用户,每人每 10 秒发一个请求。两边的吞吐量都是每秒 100 个请求,但 A 的思考时间短,占用的系统资源更多。并发数翻十倍,吞吐量可以不变。一般来说,吞吐量越大,单位时间内完成的业务越多,性能越好;超过拐点后继续加并发,吞吐量反而下降。
按请求数量分,吞吐量有 TPS 和 QPS 两个口径:
- TPS(transactions per second)是每秒处理的事务数,公式是成功事务数除以总运行时间。
- QPS(queries per second)是每秒查询数。
- 一个事务里只有一个接口,且这个接口是查询接口时,QPS 和 TPS 数值相等;一个下单事务包含验库存、建订单、扣款、查详情四个请求时,每秒请求数是 TPS 的四倍,其中只有查询请求计入 QPS。
课件的几个算例值得走一遍。某系统 1 分钟处理 1000 个业务,TPS = 1000 / 60 ≈ 16.7。某系统一天 10 万笔交易,平均到 24 小时是 100000 / 86400 ≈ 1.16 TPS;但这个平均值没有意义,订单会在某些时段集中。没有更细的数据时按二八定律估算,80% 的事务集中在 20% 的时间:
TPS = 100000 × 0.8 / (24 × 60 × 60 × 0.2) ≈ 4.6如果有详细数据,5 万笔交易集中在晚上 8 点到 9 点:
TPS = 50000 / (60 × 60) ≈ 13.9再按每年业务增长 30% 预留:
TPS = (50000 + 50000 × 0.3) / (60 × 60) ≈ 18.1课件最后一行写的是 50000 + 50000*0.3 / 60*60 = 18。按四则运算优先级,乘除先算,实际是 50000 + 15000 = 65000,得不到 18。要加括号,先算总量再除以秒数。
响应时间要问从哪算到哪
响应时间是从请求发出开始,到客户端收到最后一个字节所消耗的时间。对 Web 系统,它包含前端展现时间和系统响应时间:前者是页面渲染,后者包含服务器、数据库、通讯网络。
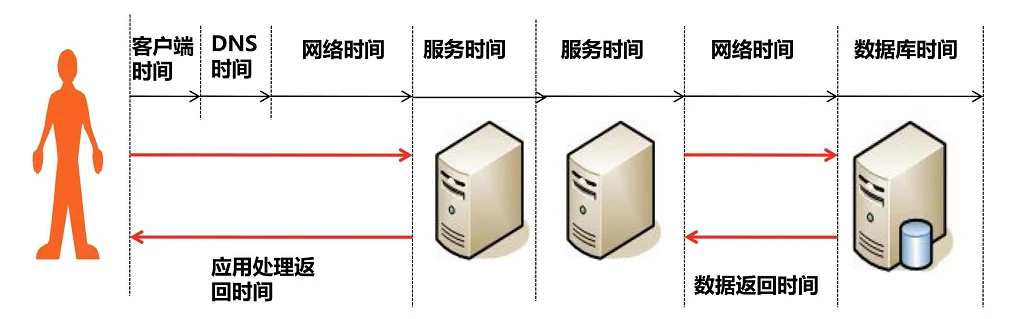
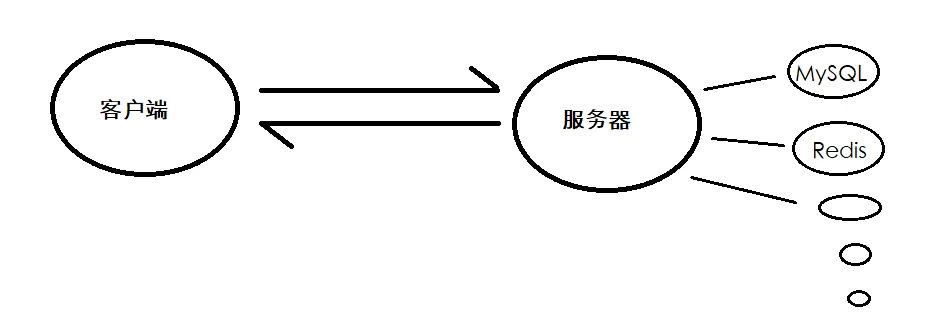
报“响应时间 800 毫秒”时要追问口径:含不含前端渲染、含不含 DNS、含不含返程。只优化应用层,结果前端渲染占了四成,用户体感不会变。
统计口径更容易骗人。假设 98.4% 的请求 40 毫秒,1.6% 的请求 3 秒,平均响应时间是 40 × 0.984 + 3000 × 0.016 ≈ 87 毫秒,报告上写“平均 87 毫秒,良好”。可一万个请求里就有 160 个用户各等了三秒。实际验收要看分位数:P90、P95、P99。JMeter 聚合报告里的 90% Line 表示 90% 的样本耗时不超过这个值,剩下 10% 至少这么慢。平均值用来算总账,P99 用来判断最慢的那批用户能不能接受。
资源利用率和一条带拐点的曲线
资源利用率看 CPU、内存、磁盘、网络,用来定位瓶颈。粗判原则是谁先接近饱和谁最可疑,但有两个例外:
- CPU 接近打满不一定是瓶颈。只有“CPU 接近 100% + 吞吐量不再上涨 + 响应时间变长”三条同时出现,才说明 CPU 是限制项。
- 瓶颈也可能出现在没满的资源上。锁竞争、连接池上限、线程池队列、GC 停顿,经常发生在 CPU 只有 40% 的时候。
把并发数、吞吐量和响应时间放在一张图上,能看出系统处在哪个区间:
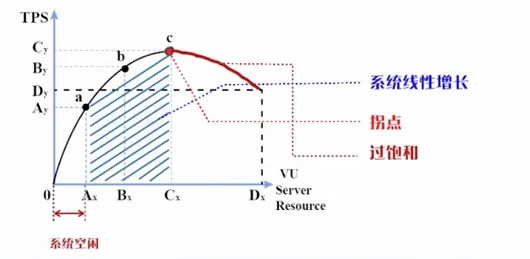
并发用户少、吞吐量低、响应时间短,是空闲区间。加并发,吞吐量近似线性增长、响应时间基本不变,是线性增长区间。吞吐量到某个点不再涨,这个点叫饱和点或拐点。再往上加,请求开始排队,响应时间变长,吞吐量逐渐下降,进入过饱和区间。拐点通常是性能测试的主要目的。
过饱和之后吞吐量为什么会掉?设系统每秒最多处理 C 个请求,并发 N,吞吐量被 min(C, N / 响应时间) 卡住。N 超过 C × 响应时间之后,多出来的只能排队,响应时间随队列变长;而虚拟用户是“发一个等一个”的闭环,响应变慢,每个用户发请求的频率就变低,吞吐量继续下降。越压越慢、越慢越少,是闭环压测的典型现象。
五类压测,停在哪里才算结束
课件的分类不在指标上,在“怎么加压、加到哪里停”。
| 类型 | 加压方式 | 停止条件 | 回答的问题 |
|---|---|---|---|
| 基准测试 | 单用户跑关键业务 | 记录完指标 | 系统在低压力下的基线是多少 |
| 并发测试 | 多个用户同时做同一操作 | 观察到争用、锁、泄漏 | 并发条件下会不会出错 |
| 负载测试 | 逐步增加负载 | 某项指标到达安全临界值 | 指标合格时最多能扛多少 |
| 压力测试 | 继续加到超出预期容量 | 资源饱和或系统失效 | 压到哪会崩、崩成什么样 |
| 稳定性测试 | 在负载基础上拉长时间 | 通常 3×24 小时以上 | 长时间运行是否平稳 |
基准测试是单用户测试,选业务模型里的重要业务,记录低压力下的数据,为后面的并发和混合场景做参照。没有基准,分不清“变慢”是负载造成的还是版本退化。
并发测试盯“同时做同一件事”:同时登录、同时抢同一行库存、同时改同一条记录。它要暴露的是内存泄漏、线程锁、资源争用、数据库写入冲突这类只在并发下出现的缺陷,通常要用工具的多线程或多进程模拟。几乎所有的性能测试都会涉及一部分并发测试,它对多个线程在同一时间点动作的要求很苛刻。
负载测试是在指标还达标的前提下找最大负载。响应时间要求不超过 2 秒,加到 1 万人刚好 2 秒,超过 1 万人就超标,那么 1 万就是在该指标下的最大负载量。
压力测试是越过这条线继续加,直到资源饱和甚至系统失效。课件的例子是:1 万时响应不超过 2 秒,2 万时响应 5 秒,3 万时崩溃、无法响应。课件接着说“由此可以确定系统能达到的极限访问量是 3 万”,这句不对。3 万是崩溃点,系统在那个点已经不响应了,不能叫“能达到的极限”。准确说法是 2 万还能返回、3 万崩溃,极限落在两者之间,应该在 2 万附近继续细化,找到开始不返回的那个点。
还有一种企业常用的峰值模型:几秒内把并发拉到峰值,再迅速回落,检查系统能不能扛住突发流量、恢复后是否正常。它和压力测试的区别在持续时间:压力测试停在崩溃点附近观察,峰值测试看的是瞬时冲击和恢复能力。
一句话区分:负载测试停在“还合格”的临界,压力测试越过临界去找崩溃点。前者回答健康时能扛多少,后者回答压到哪会崩、崩成什么样。
稳定性测试是在负载测试的基础上拉长时间,课件给的线是 3×24 小时以上。很多问题的时间常数很长:内存每小时涨几十 MB,72 小时才把 4 GB 吃光;每次请求漏一个句柄,几万次之后才耗尽。它看的是这 72 小时里吞吐量、响应时间、内存和错误率是不是始终平稳,不是某一刻的峰值。
错误率、四种角色和一句验收标准
错误率是失败数除以总数,难的是“什么算失败”。HTTP 500 算,返回 200 但业务码写着“余额不足”算不算?压测正常业务路径时通常算,因为这条请求没有完成预期业务。这就是为什么错误率必须由断言定义,只看状态码会系统性低估。
课件把可靠性目标写成 99.99% 和 99.9999%,对应错误率上限 0.01% 和 0.0001%。错误率高的原因分三层:接口本身报错、服务器撑不住(代码问题、内存泄漏、硬件资源)、保护机制被触发。限流是超过阈值直接拒绝一部分请求;熔断是在下游持续失败时主动切断调用,例如某个支付渠道失败率突增就临时停掉它;降级是主动关掉非核心功能保核心,例如视频站故障时用户名先显示成默认名称。看到 5% 的错误率先别当 bug,先看是不是保护机制在干活。
同一份报告,四种角色只看自己那一段:
- 终端用户只关心从提交到看见结果的主观时间,包含系统响应和前端展现。
- 运维关心大量并发下的系统健康、最大并发与响应时间的取舍、容量、数据库调优和长时间稳定性。课件那个例子很典型:A 方案 100 万并发、登录 3 秒,B 方案 500 万并发、登录 8 秒,运维通常选 B,因为兜住更多人比快几秒对全局更值。
- 开发关心根因:算法是否高效、有没有内存泄漏、架构能不能扩展、代码是否可测试。
- 性能测试人员关心场景设计、脚本开发执行、缺陷定位,还要懂数据库执行计划、JVM 垃圾回收、多线程常见问题。
做之前先问报告给谁看、要支撑什么决策。写错对象,数字再漂亮也没人用。
落到执行,性能测试的流程是:先把验收指标和业务模型定下来,再设计场景——多少用户、各业务什么比例、加压多久、什么时候停;接着准备脚本和数据,执行时同步采集服务端资源;最后按响应时间、错误率、吞吐量三组数据定位瓶颈,改完再回归同一套场景做对比。跳过业务模型直接压一个接口,得到的数字说明不了整站容量。
性能测试有一个不能跳过的前置动作:先把需求写成可验收的一句话,例如“1 万并发用户下,下单接口 P95 不超过 3 秒,TPS 不低于 500,错误率低于 1%”。写不出这句话,压出来的数字只能自己看。
还没有评论 — 第一条由你来留。