课件的实战从一张脑图开始,把博客系统拆成登录页、博客列表页、编辑博客页、博客详情页,再按页面写脚本。这个顺序是对的:UI 自动化先决定验什么,再决定怎么点。脚本本身不难,难的是用例之间的状态怎么传、断言挑哪条证据,以及失败之后能不能判断是产品坏了还是脚本没等到。
课件示例用 Python 绑定,下面的 C++ 版本用 webdriverxx。结构不变:一个 driver,一个页面对象,一个入口。代码假设 selenium-server 和被测博客系统已经启动。
先拆状态,再拆页面
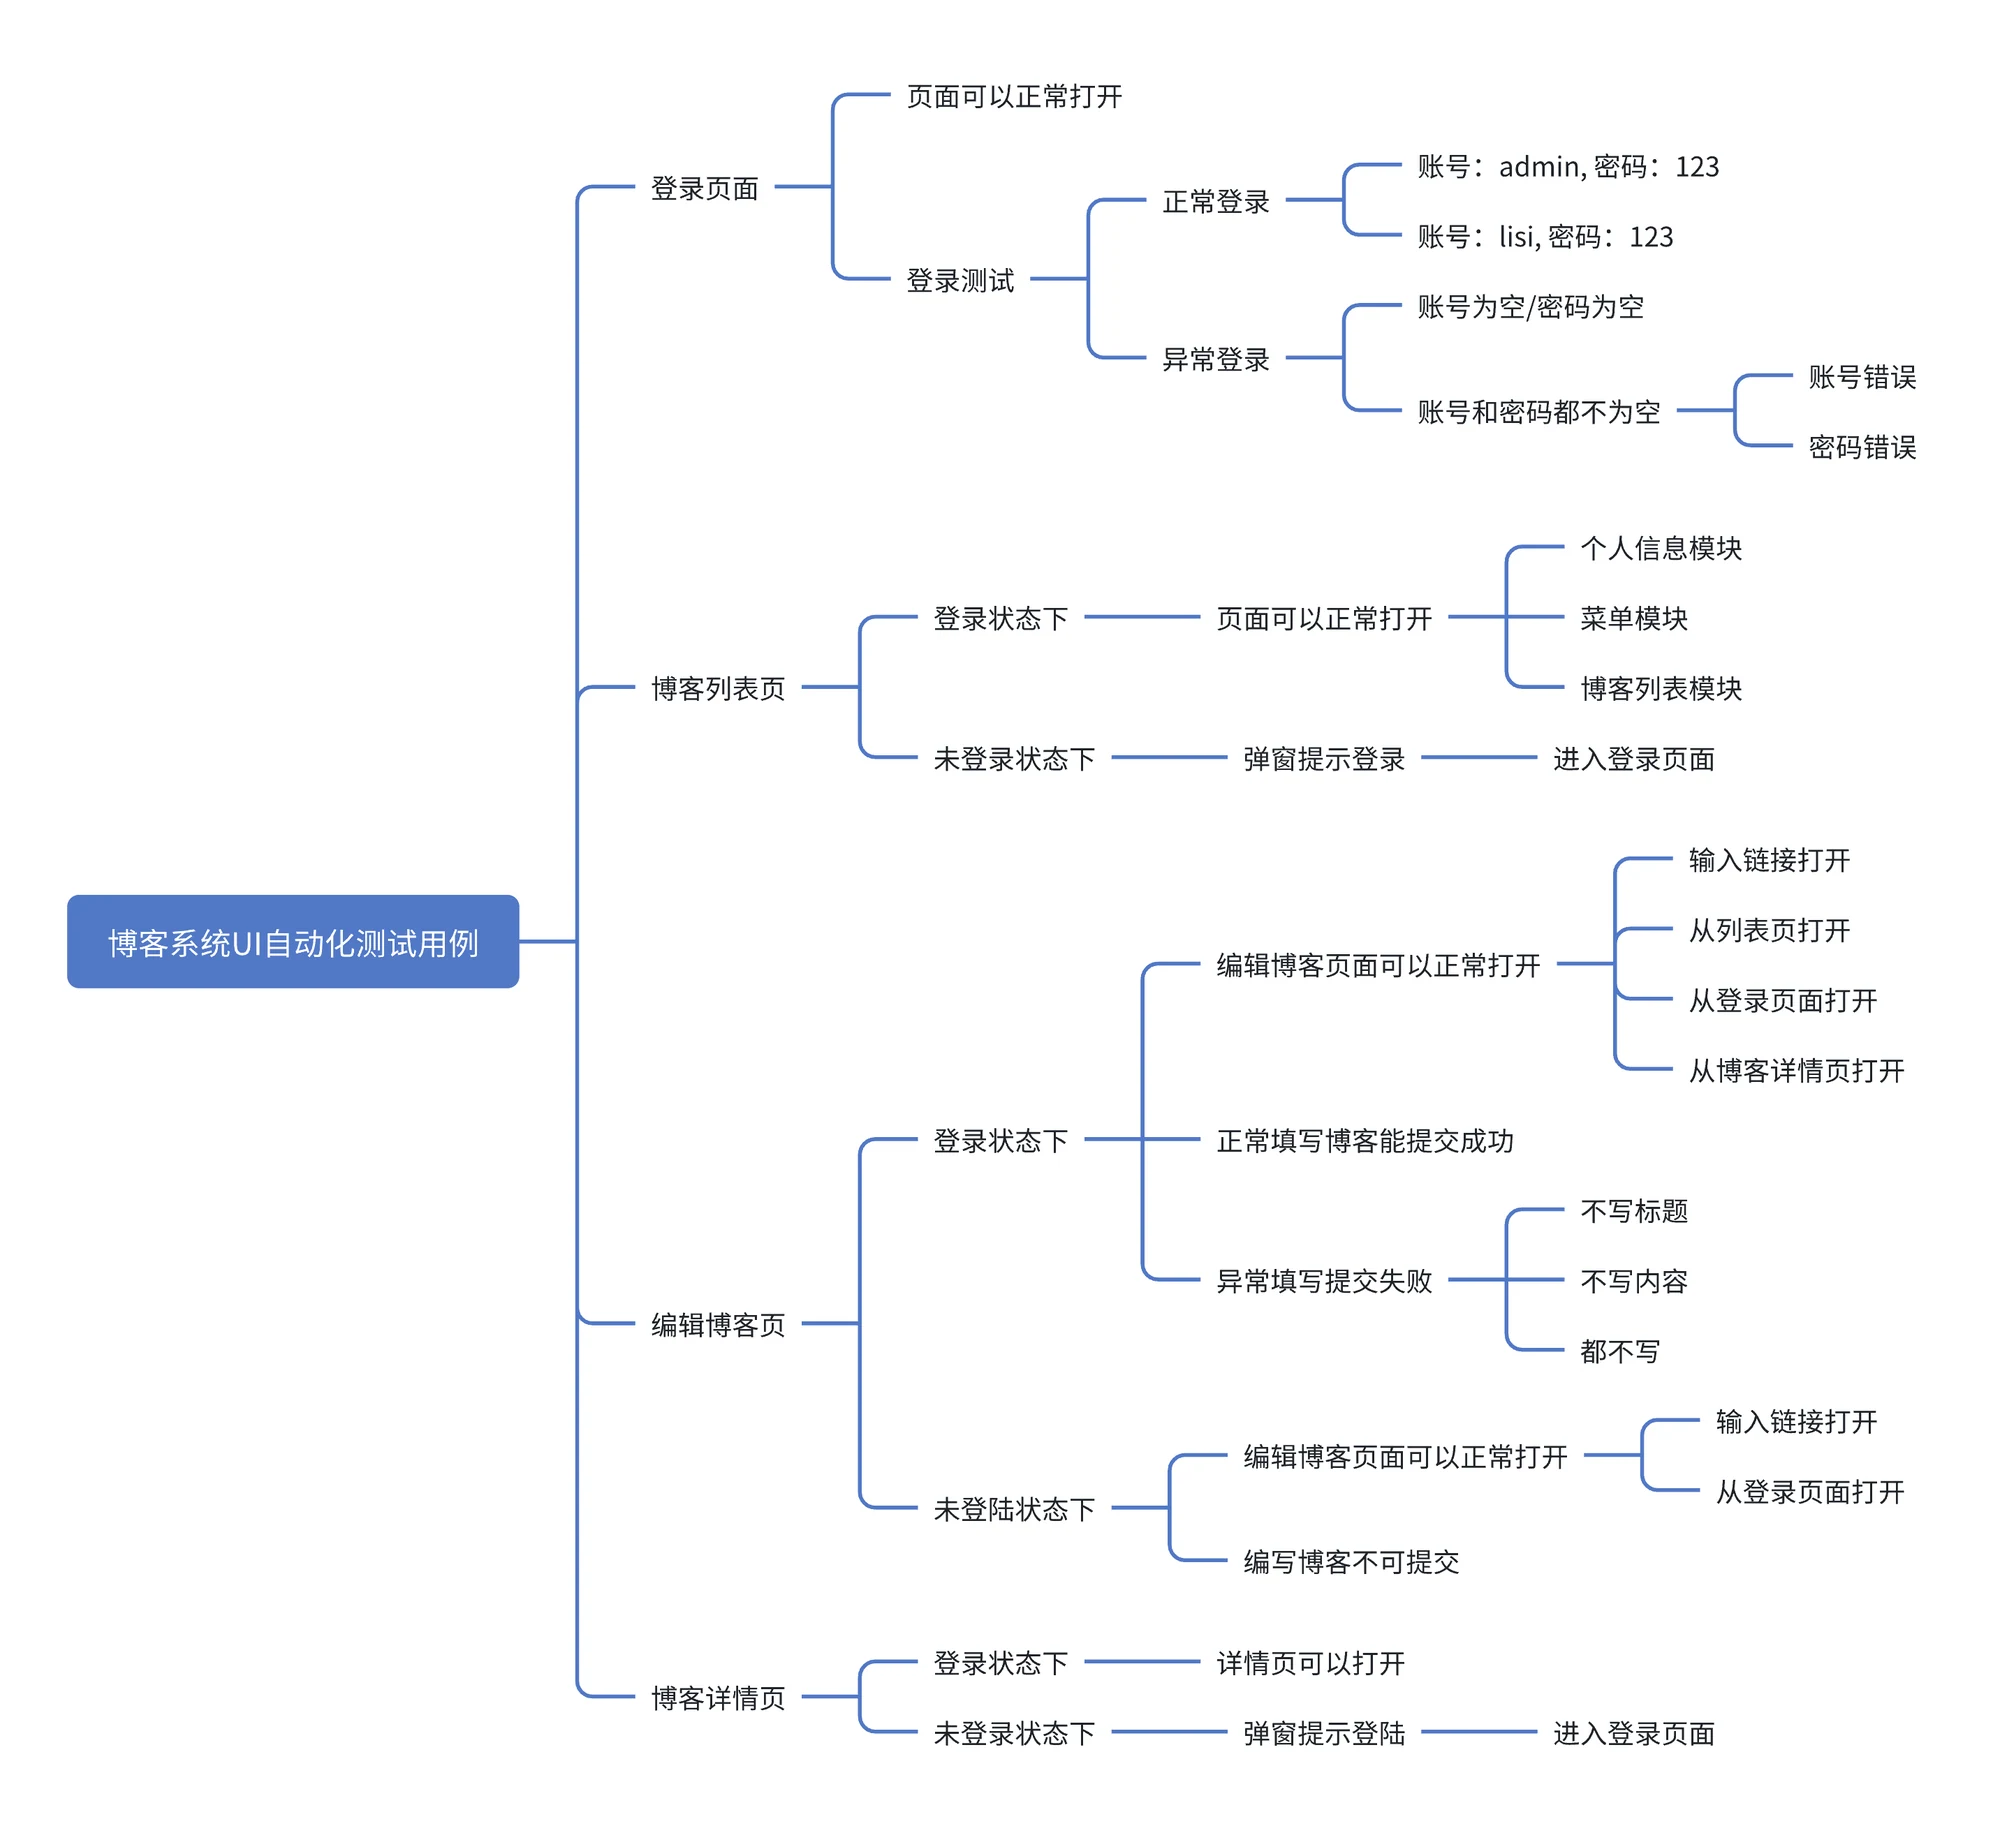
脑图里的分支值得逐条看。登录页分“页面可以正常打开”和“登录测试”,登录测试再分正常登录(admin/123、lisi/123)和异常登录(账号为空、密码为空、账号和密码都不为空但其中一个是错的)。列表页分登录状态下三个模块能正常打开,以及未登录时弹窗提示并进入登录页。编辑页分登录状态下的正常提交和异常提交(不写标题、不写内容、都不写),以及未登录时可以从哪些入口打开、能不能提交。详情页只有登录与未登录两种。
页面只是外壳,用例覆盖的是状态:未登录、已登录、数据合法、数据缺失。登录页是入口,它决定后面三页能不能进,所以第一条用例必须留下一个已登录的会话,后面的列表、详情都踩着它。
课件的入口脚本就是按这个依赖顺序排的:
BlogLogin.BlogLogin().loginSucTest()
BlogList.BlogList().ListTest()
BlogDetail.BlogDetail().DetailCheck()
BlogDriver.driver.quit()
一行一条,跑完统一退出。中间任何一条失败,后面的用例会连锁失败,报告上看起来像“全线崩溃”,实际只是一个前置没成立。这个顺序可以保留,但每条用例失败时要在日志里写清是前置失败还是自身失败。
一个 driver 跑到底,省时间也把状态带进下一条
common/Utils.py 做了两件事:创建驱动、失败截图。驱动是模块级单例,整个进程只开一个浏览器。
class Driver:
    driver = ""

    def __init__(self):
        options = webdriver.ChromeOptions()
        self.driver = webdriver.Chrome(
            service=Service(ChromeDriverManager().install()), options=options
        )
每条用例重开浏览器要两三秒,二十条就是一分钟,单例省下的就是这段时间。代价是 cookie、登录态、滚动位置、弹窗全都带到下一条用例里。一条用例不小心点出一个确认框,后面三条可能全挂在“元素被遮挡”上。
C++ 里可以把 driver 放进一个对象的成员,用析构函数收尾:
#include <webdriverxx.h>
#include <string>

using namespace webdriverxx;

class Browser {
public:
    Browser() : driver_(Start(Chrome())) {}
    WebDriver& Get() { return driver_; }
private:
    WebDriver driver_;
};
WebDriver 的析构会结束会话,异常路径也不会把浏览器进程留在机器上。需要多条用例共享时,把这个对象提到 main 里,按引用传给页面对象;不要做成全局变量,否则清理时机又变成隐式的。
状态污染最典型的一处是返回。back() 之后浏览器很可能把表单值恢复出来,紧接着再 send_keys("admin") 就变成 adminadmin;密码框重复输入同一个值也是同样的拼接。课件在 loginFailTest 开头先 clear(),这一步是对的;如果省略,这条用例可能因为输入内容变化而“通过”,原因和想验证的不是一回事。每次输入前清空,或者每条用例从干净的页面开始。
页面对象只暴露动作,断言留在用例里
课件的 BlogLogin、BlogList、BlogDetail 已经按页面分了类,但断言写在了页面方法里,例如 loginFailTest 里的 assert expect == actual。页面对象一旦包含断言,换个页面复用就得复制一份,改判据时也会漏。
把职责切开:页面对象(page object)负责“打开、输入、点击、取数”,用例负责“这个数应该等于什么”。
#include <webdriverxx.h>
#include <webdriverxx/wait.h>
#include <stdexcept>
#include <string>
#include <utility>

using namespace webdriverxx;

class LoginPage {
public:
    LoginPage(WebDriver& driver, std::string base)
        : driver_(driver), base_(std::move(base)) {}

    void Open() { driver_.Navigate(base_ + "/blog_login.html"); }

    void Submit(const std::string& user, const std::string& password) {
        Element username = driver_.FindElement(ById("username"));
        username.Clear();
        username.SendKeys(user);

        Element password_box = driver_.FindElement(ById("password"));
        password_box.Clear();
        password_box.SendKeys(password);

        driver_.FindElement(ById("submit")).Click();
    }

    std::string Url() { return driver_.GetUrl(); }

private:
    WebDriver& driver_;
    std::string base_;
};

class BlogListPage {
public:
    explicit BlogListPage(WebDriver& driver) : driver_(driver) {}

    int ArticleCount() {
        return static_cast<int>(driver_.FindElements(
            ByCss("body > div.container > div.right > div")).size());
    }

    void WaitForArticles(int least) {
        WaitUntil([&] { return ArticleCount() >= least; });
    }

    void OpenFirstArticle() {
        driver_.FindElement(
            ByCss("body > div.container > div.right > div:nth-child(1) > a")).Click();
    }

    std::string Url() { return driver_.GetUrl(); }

private:
    WebDriver& driver_;
};

int main() {
    WebDriver driver = Start(Chrome());
    const std::string base = "http://192.168.47.135:8653/blog_system";

    LoginPage login(driver, base);
    login.Open();
    login.Submit("admin", "123");
    if (login.Url().find("blog_list") == std::string::npos) {
        throw std::runtime_error("login did not reach blog_list");
    }

    BlogListPage list(driver);
    list.WaitForArticles(11);
    if (list.ArticleCount() <= 10) {
        throw std::runtime_error("article count is not greater than 10");
    }

    list.OpenFirstArticle();
    if (list.Url().find("blog_detail") == std::string::npos) {
        throw std::runtime_error("first article did not open detail page");
    }
    return 0;
}
WaitForArticles 是显式等待:轮询的是“条数够不够”,不是固定的秒数。比起在断言前加 sleep(2),它只在没满足时等,页面快的时候不白等。
账号、密码、博客 id 不要写死在页面对象里。课件把 admin/123 写在方法内,换环境或换账号池就要改代码;把这些值提到数据文件或环境变量,页面对象只接收参数。
三处断言,给出的是假结论
拿整个 body 做全等。 课件的登录失败用例:
expect = "用户名或密码错误!"
actual = self.driver.find_element(By.CSS_SELECTOR, "body").text
assert expect == actual
注释已经写了“不能仅仅通过 body 来校验结果,因为登录成功的结果页也有 body 元素”,代码仍然拿整页可见文本做全等。body.text 会把用户名标签、密码标签、按钮文字全拼进来,不可能正好等于一句提示。这条断言要么一直失败,要么某次页面改版后偶然通过,两种都不能说明产品有问题。
判据要落在提示本身。页面没有给提示元素固定的 id 时,可以按文本来找:
tip = driver.find_element(By.XPATH, "//*[contains(., '用户名或密码错误')]")
assert tip.is_displayed()
用 contains 而不是全等,是因为提示后面常带标点或动态内容;但也不能宽到只写 assert tip,那只是在验证节点存在。前端如果给了固定的提示容器,优先用那个容器的选择器。
用登录后才有的头像判断“登录成功”。 课件登录成功用例检查 body > div.container > div.left > div > img,列表页用例又用同一个选择器判断“已经在登录态”。如果这个元素在未登录页也存在,它连登录态都证明不了;即便它只在已登录页出现,也区分不了列表页和详情页。登录成功的判据应该落在列表页独有的东西上,例如 URL 里包含 blog_list,或者列表容器出现了。
用条数断言验证数据正确。 find_elements 加 assert len(articles) > 10 属于数量断言。它验证的是列表渲染了,不是列表内容对;换一套测试数据、同事清一次库,条数就可能不够。数量断言适合验“有没有渲染”,要验“数据对不对”,得先造已知数据再比对字段。
详情页还有数据依赖。课件把 blogId=15 写死在 URL 里,这条用例能不能过取决于库里第 15 篇文章还在不在。更稳的做法是在 setup 里创建一篇文章,拿返回的 id 拼 URL;或者在断言前先确认这条数据存在,不存在就跳过并记录原因,而不是报成产品缺陷。
课件的详情页构造函数还有一个隐式前提:它先读当前标题,不是“博客列表页”才 get(url)。这依赖上一步停在列表页;单独跑详情页用例时标题为空,会走跳转,URL 里仍然带着写死的 id。用例之间共享状态时,这类前提要写进日志,否则失败时看不出是哪一步断的。
不稳定用例的四个来源
渲染、状态、顺序、导入路径,四条都跟产品逻辑无关。
渲染:列表页登录后立刻数条数,页面还没渲染完,find_elements 返回空列表,断言直接炸;手工复测时人多等了两秒,所以是通的。修法是等条件,不是加睡眠。课件 loginSucTest 开头的 time.sleep(2) 也是同一个问题:页面快时白等,页面慢时不够;换成等登录后的页面元素出现。
状态:back() 恢复表单、单例带着 cookie 和滚动位置、上一条用例留下的弹窗,都会改变下一条的起点。每条用例开始前回到确定的页面,输入前 clear()。
顺序:登录失败后后面的用例全红,看起来像产品崩了。入口脚本要能在前置失败时标记“skipped”,而不是继续跑。
导入路径:课件入口写 from tests import BlogLogin,文件却放在 cases/ 目录下。照抄会得到 ModuleNotFoundError: No module named 'tests';导入的是目录名,目录叫 cases 就从 cases 导。
失败重试要克制。只对已经确认是等待或环境抖动的步骤重试,最多一两次,每次记录尝试序号、耗时、当前 URL、标题和截图。断言失败说明产品行为不符合预期,盲目重试只会把真缺陷藏起来。日志里至少要有:用例名、开始时间、当前 URL、当前标题、失败步骤、截图路径。只有截图没有上下文,读日志的人仍然要猜。
课件 getScreenShot 用调用者的函数名做文件名:
filename = sys._getframe().f_back.f_code.co_name + "-" + \
           datetime.datetime.now().strftime('%Y-%m-%d-%H%M%S') + ".png"
C++ 不用栈帧取调用者的名字,直接把用例名作为参数传进去最清楚。文件按天建目录,失败时写 images/2025-06-27/BlogLogin-101503.png,比 image1.png 有用。
报告里的 19/20 只是结果
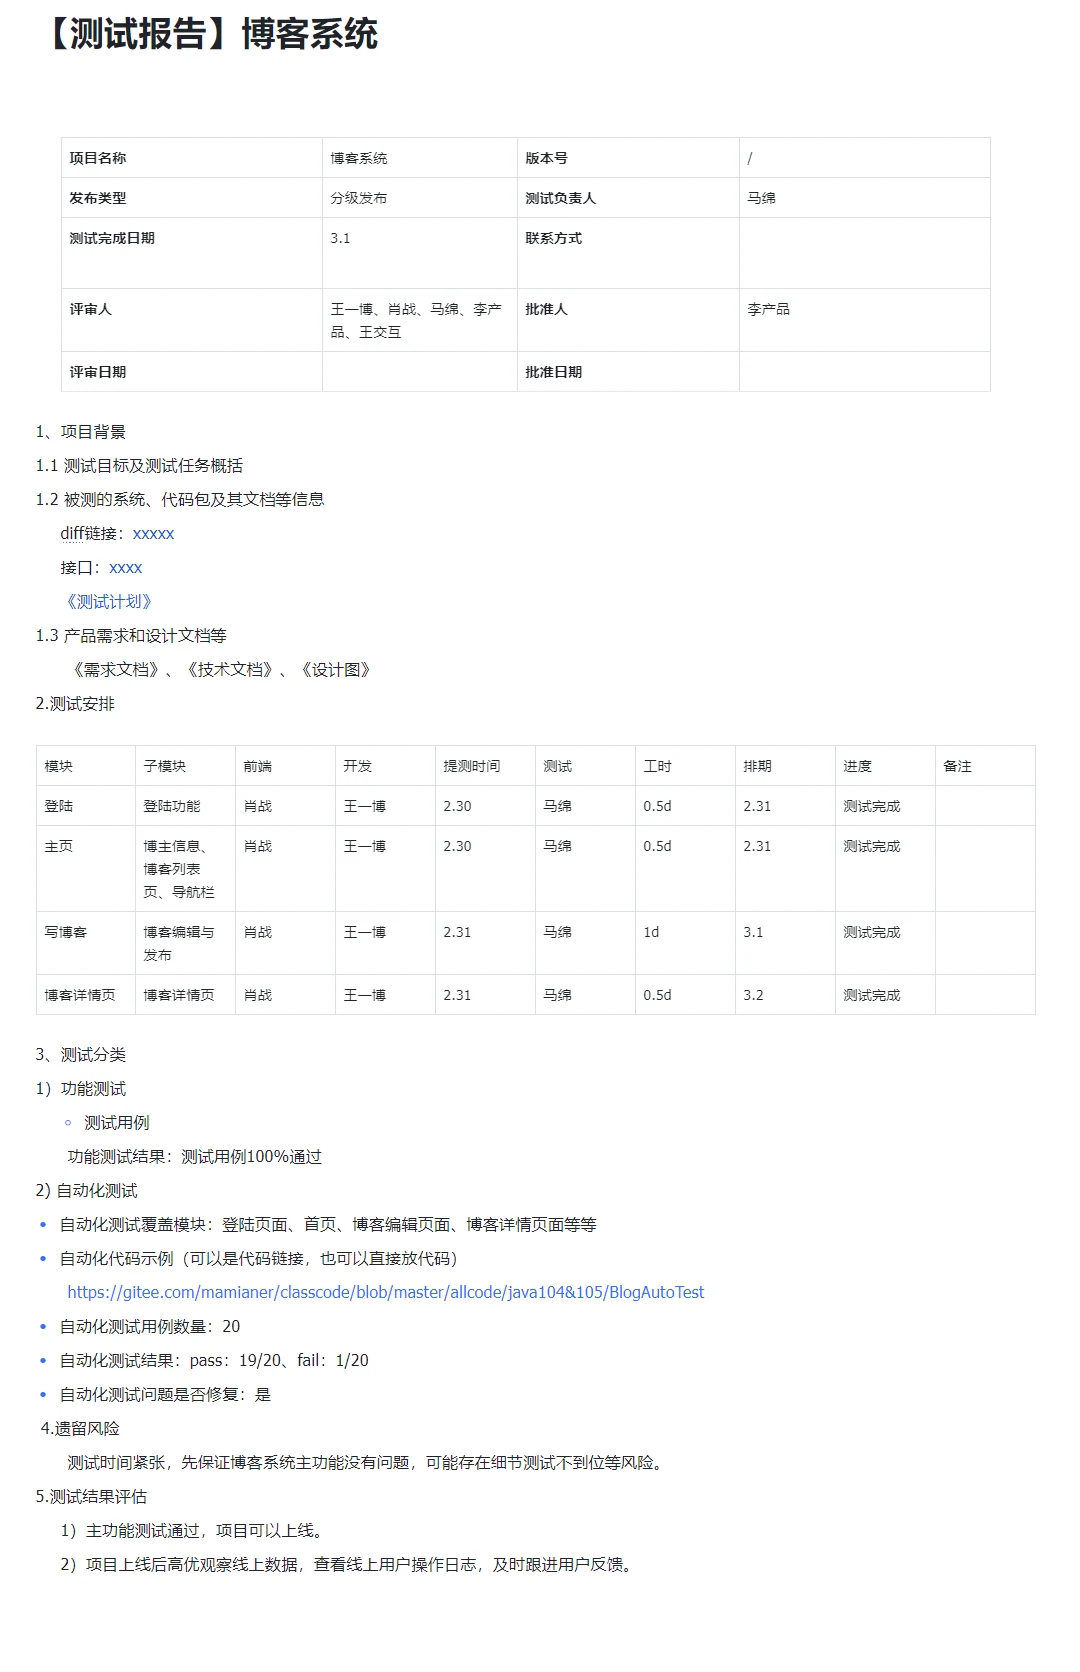
模板里的字段分两类。项目信息、测试安排、测试分类是流程记录;自动化那几行才是结论的证据:覆盖了哪些页面、代码在哪里、跑了多少条、通过多少、失败的那条有没有修。只写通过率,等于把判断权丢给读报告的人。
一份能支撑决策的报告还要多三样东西:跑在什么环境(浏览器版本、驱动版本、被测地址)、失败归因(产品问题、脚本等待、数据缺失、环境差异)、失败后的复跑结果。19/20 说明有一条没过;补上“失败原因是列表页等待不足,修复后复跑 20/20”,读的人才知道这个数字该不该担心。
UI 自动化的可信度不在通过率,而在失败的那一条能不能被解释清楚。能稳定复现的失败才值得提单,复现不了的先查等待、数据和环境,别急着把脚本的判断当成产品的结论。
还没有评论 — 第一条由你来留。