JMeter 的一个测试计划是一棵树:测试计划下面挂线程组,线程组下面挂取样器、配置元件、定时器、断言和监听器。树的父子关系决定元件的作用域,也决定谁先执行。把这棵树搭对,再谈压多少并发;树搭错了,报告里的数字再漂亮也是错的。
装好之后,用命令行启动
JMeter 是 Apache 基于 Java 开发的压测工具,课件用的版本是 5.5。下载 tar 包解压即可,不需要安装程序;解压后 bin 目录里有 jmeter.bat(Windows)和 jmeter.sh(Linux)。JMeter 5.5 需要 Java 8 或更高版本,机器上没有 JRE 时双击 bat 只会闪退。
启动方式有两种:双击 bin/jmeter.bat,或者把 bin 目录加进系统 PATH,在命令行敲 jmeter。课件推荐后者,因为脚本化和切换版本都方便。界面语言在 bin/jmeter.properties 里改:
language=zh_CN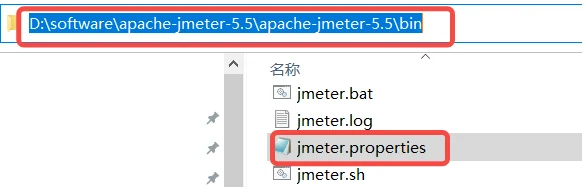
命令行启动时,控制台会先打印一段提示:
Don't use GUI mode for load testing!, only for Test creation and Test debugging.
For load testing, use CLI Mode (was NON GUI):
   jmeter -n -t [jmx file] -l [results file] -e -o [Path to web report folder]
Increase Java Heap to meet your test requirements:
   Modify current env variable HEAP="-Xms1g -Xmx1g -XX:MaxMetaspaceSize=256m" in the jmeter batch file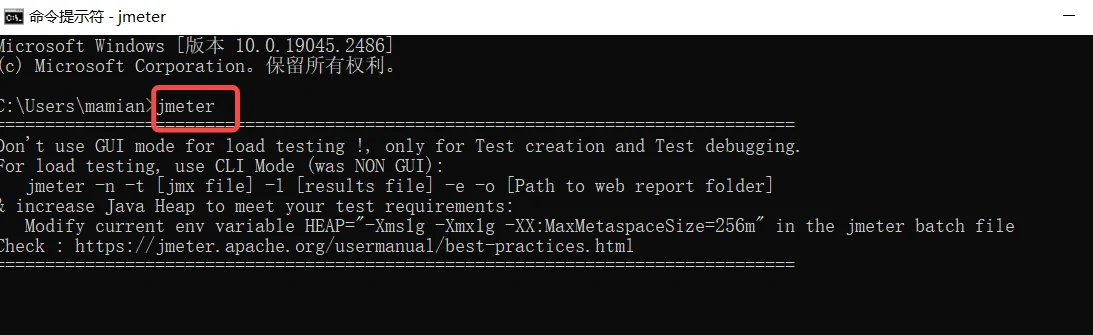
GUI 模式会把每个请求的监听数据都画到界面上,线程一多,压测机自己先成为瓶颈。正式压测走 -n;GUI 只用来搭脚本、调断言。默认 JVM 堆是 1 GB,几百个线程以上要按提示改 HEAP,否则压测机先 OOM。
线程组定节奏,取样器发请求
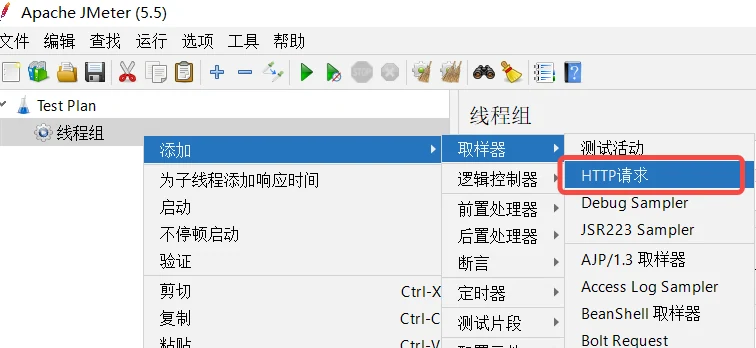
基本流程是:测试计划下加线程组,线程组下加 HTTP 取样器,取样器下加查看结果树,点启动看结果。添加取样器的入口在右键菜单里:
线程组控制 JMeter 用多少个线程执行测试,一个线程可以理解为一个虚拟用户:
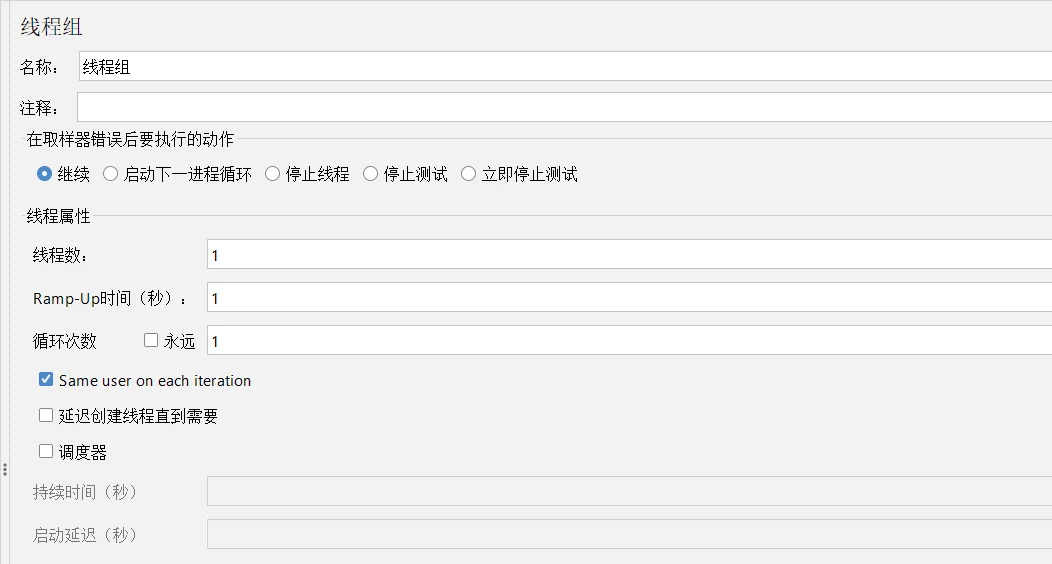
课件对两个字段的解释需要改:
- 线程数不是“设置发送的请求次数”,它是同时活着的虚拟用户数。总请求数等于线程数乘循环次数(每个线程循环几次就发几轮)。
- Ramp-Up 不是“性能测试运行时间”,它是“用多少秒把所有线程启动完”。线程数 100、Ramp-Up 60,表示 60 秒内陆续拉起 100 个线程,每秒约 1.7 个新用户进场;Ramp-Up 填 0,100 个线程几乎同时创建,曲线一开始就是尖峰。
循环次数选“永远”时,调度器里的持续时间才是刹车;循环次数为 1 时,线程跑完自己就退,持续时间填 600 秒也不会等满十分钟。延迟启动时间同理,只在需要的时候生效。
元件的作用域由树形结构决定,执行顺序则是固定的:
| 顺序 | 元件 |
|---|---|
| 1 | 配置元件 |
| 2 | 前置处理器 |
| 3 | 定时器 |
| 4 | 取样器 |
| 5 | 后置处理器 |
| 6 | 断言 |
| 7 | 监听器 |
配置元件只对它的子节点生效;取样器本身不依赖其他元件,所以取样器没有作用域问题;监听器收集的是它作用范围内元件的结果。把 CSV 放在线程组下,整个线程组都能用;放在某个取样器下,就只有那个取样器能读到。
HTTP 取样器与四个配置元件
取样器负责发请求。协议、主机名或 IP、端口、方法、路径、内容编码填全。除了手填,JMeter 也能录制:在测试计划下加“非测试元件 → HTTP(S) Test Script Recorder”,默认监听 8888 端口,把浏览器代理指过去,操作产生的请求会生成取样器。录制只省去手写 URL 和参数,参数化、关联和断言仍要手工补;录出来的脚本常带固定的 SESSIONID 和时间戳,直接拿去压测会互相干扰。
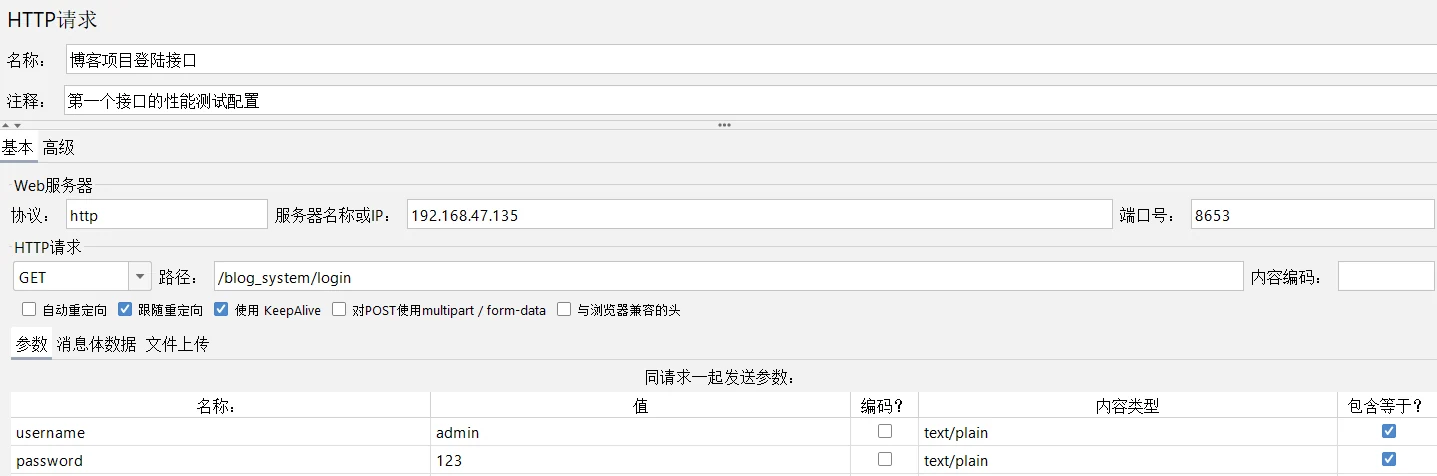
- 端口按协议填:HTTP 默认 80,HTTPS 默认 443。
- 参数可以拼在路径里,也可以填在参数表里。GET 用参数表最直观;POST 的 JSON 要放到“消息体数据”里,课件写的
{wd:test}不是合法 JSON,要写成{"wd":"test"}。 - 内容编码留空时 JMeter 默认按 ISO-8859-1 处理,课件把它叫“ISO 国际标准”;中文参数会乱码,填
UTF-8。 - 超时建议填上。留空时服务器一卡,线程就挂在那儿等,聚合报告里并发数看着很高,吞吐量却低得离谱。
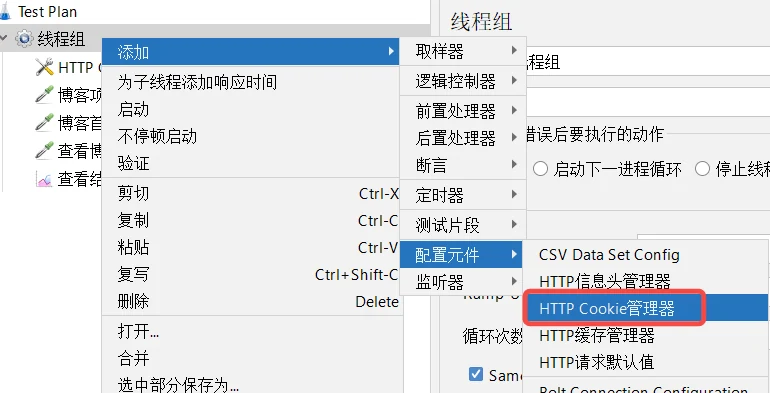
四个配置元件解决重复和状态:
HTTP 请求默认值把协议、IP、端口抽出来,博客系统所有接口都相同,其他取样器只写路径即可。改环境时只改一处。
HTTP Cookie 管理器像浏览器一样存储和发送 Cookie。登录接口返回的 SESSIONID 会被自动保存,后续请求带上;每个 JMeter 线程有自己的 Cookie 存储区,100 个线程就是 100 个独立会话。不装它,后面的业务接口全在返回“未登录”,压的其实是登录页。
用户定义的变量用于跨脚本共享的固定值,添加方式是在线程组下加“配置元件 → 用户定义的变量”,引用时写 ${变量名}。只在一个取样器里用的值,不必提到全局。
CSV 数据文件设置用于批量账号,下一节单独讲。
参数化:CSV 喂账号,JSON 提取器做关联
登录压测不能所有线程都用同一个账号。CSV 数据文件设置的字段:
- 文件名:CSV 路径,建议绝对路径。
- 文件编码:UTF-8。
- 变量名称:逗号分隔,例如
username,password。 - 是否忽略首行:首行是表头就勾。
- 分隔符:和文件里的分隔符一致。
- 遇到文件结束符再次循环:True 时取完从头再来。
- 遇到文件结束符停止线程:False 且不勾停止时,取完数据后变量为空,后续请求会报错。
- 线程共享模式:默认所有线程共享,100 个线程排队各取一行;改成“当前线程”后,每个线程都从第一行读起,100 个线程同时拿
user01登录,压出来的是一百次同账号互踢。
CSV 示例:
username,password
admin,123
lisi,123
wangwu,456
JSON 提取器解决接口依赖:登录拿 token,列表拿 blogId,详情页再拿 blogId 去查。给某个取样器加“后置处理器 → JSON 提取器”,用 JSONPath 从响应里取值,存进变量,后面的请求用 ${blogId} 引用。这一步在 LoadRunner 里叫关联(correlation),在 JMeter 里由后置处理器完成。
课件给的响应是一个数组:
[
  {"postTime": "2024-04-18 05:20:16", "title": "ddddd", "blogId": 13, "userId": 3, "content": "test"},
  {"postTime": "2022-10-22 02:38:21", "title": "同学,请问你今天学习了吗", "blogId": 12, "userId": 3, "content": "hello"}
]
JSONPath 操作符:
| 操作符 | 含义 |
|---|---|
$ | 根元素 |
@ | 当前元素 |
* | 通配符,所有节点 |
.. | 递归选择所有符合条件的节点 |
.<name> | 子元素 |
['<name>' (, '<name>')] | 子元素或子元素列表 |
[<number> (, <number>)] | 数组索引或索引列表 |
[start:end] | 数组切片 |
[?(<expression>)] | 过滤表达式,结果必须是布尔值 |
取所有 blogId 写 $..blogId,取第一个写 $[0].blogId。课件写的是 $.[0]blogId,中间多了一个点,方括号后面要直接用 .blogId 接字段。写错时 JMeter 不一定报语法错,可能取到空值继续往下跑,后面所有详情请求都在查同一个不存在的东西。
Default Value 建议填一个显眼的值,例如 NOT_FOUND。取不到时它会在请求里露出来,比空字符串好查。
断言:200 不等于通过
接口返回 200 只说明 HTTP 层通了,业务是否成功要看响应体。JSON 断言从一个 JSON 路径取值,和期望值比较。课件的三条注意事项里,第一条把语义写反了:
- 不勾“Additionally assert value”:只判断字段是否存在,不比较值。
- 勾上“Additionally assert value”:必须填 Expected Value,并和取到的值比较。
- 不勾“Match as regular expression”:期望值必须和实际值整串相等,少一个字符都失败。
- 勾上“Match as regular expression”:期望值可以只写部分关键词,按正则或片段匹配。
按课件第一条“不选 Additionally assert value,表示添加断言值”来配,会得到一个只验“字段存在”的断言,密码错了它也判过。路径写错时,结果树里会出现 No results for path,先检查路径再改期望值:响应是对象用 $.code,是数组用 $[0].code。
断言的作用范围跟着树走。放在线程组下,组内所有取样器都执行;放在某个取样器下,只验那一个接口。
集合点、事务和阶梯线程组
100 个线程不代表 100 个请求同时到服务器。一个线程的循环是发请求、等响应、思考几秒、再发;单请求 100 毫秒、思考 2 秒时,同一刻在途的请求大约是 100 × 0.1 / 2.1 ≈ 5 个。想让请求挤到同一瞬间,加同步定时器。
- 模拟用户数:一般填线程数。
- 超时时间:凑不齐时等多久,单位毫秒;超时后放走已经到的线程,不要让它永远卡住。
同步定时器能约束请求“几乎同时发出”,不能保证“同时到达服务器”,中间还有网络和队列。课件把它叫集合点,这个类比很准确:人到齐了才放行,但每个人走到对面花的时间不一样。
场景设计就是把这些元件组合起来:线程组给并发规模,Ramp-Up 给进场速度,同步定时器给瞬时并发,事务控制器给业务口径,阶梯线程组给分级加压。
事务控制器解决另一个问题:用户关心“下单一次要多久”,不是“验库存这个接口多快”。把多个取样器放到一个事务控制器下,报告里会多一行这个事务的总耗时。不添加时,一个取样器就是一个事务;添加后,多个接口合并成一个事务。
标准线程组一次把 N 个线程上满,企业压测更想看系统在第几级台阶开始变慢,这要装插件。把 jmeter-plugins-manager.jar 放进 lib/ext,重启 JMeter,右上角出现插件入口,再装 Custom Thread Groups 和 Custom Listeners。Stepping Thread Group 的字段:
- This group will start:最终启动多少线程。
- First, wait for:等待多少秒才开始压测。
- Then start:一开始启动多少线程。
- Next, add:下一级增加多少线程。
- threads every:当前这级运行多久后启动下一批。
- using ramp-up:每批线程用多少秒启动完。
- then hold load for:全部启动后保持多久。
- finally, stop/threads every:结束后每隔多久释放多少线程。
读阶梯图时盯拐点:哪一级开始响应时间抬头,容量边界就在那一级附近。
监听器与报告:先看三列
查看结果树适合调试,逐条看请求头、请求体、响应码、响应体:
- Thread Name:线程组名称。
- Sample time:取样器耗时。
- Load time:响应时间。
- Response code:接口状态码。
正式压测看聚合报告。一屏数字里先看三列:
- Error%:失败率。要分清是 HTTP 失败还是断言失败。
- 90% Line:90% 的请求耗时不超过这个值。
- Throughput:吞吐量,单位随取样器标签变化,常见是每秒请求数。
Average 是最容易被误读的一列。99 个请求 0.1 秒、1 个请求 100 秒,平均 1.1 秒,九成九的人体感很好;反过来 99 个请求 2 秒、1 个 0.1 秒,平均也接近 2 秒,这一列看不出“几乎所有人都在等”。中位数描述典型用户,P90 描述大多数用户,P99 描述最倒霉的那批。验收写“90% 请求不超过 500 毫秒”,判的就是 90% Line。
Response Times Over Time 看趋势:横轴是运行时间,纵轴是响应时间(毫秒)。如果某个时间点突然抬头,说明系统在那个时间点遇到了问题;整条线缓慢上扬,说明并发增加后系统在变慢。TPS(transactions per second,每秒事务数)监听器看吞吐量形状:横轴时间,纵轴 TPS;爬坡、平台、掉落三段比单个峰值更有信息。
正式压测用命令行出报告:
jmeter -n -t blog_test.jmx -l result.jtl -e -o report_dir-n:无图形化运行。-t:被运行的脚本。-l:把运行信息写入 jtl 日志。-e:生成 HTML 报告。-o:报告输出目录。
课件说日志和目录都必须为空,这句要分开看:-o 指定的目录必须不存在或为空,否则 JMeter 拒绝生成;-l 指向的 jtl 如果已经存在,新结果会追加进去,跑第二轮时旧数据会混进新报告。要干净结果就每次先删 jtl,或者加 -f 强制删除已有结果文件。报告生成后,打开 report_dir/index.html。
三个指标怎么定位瓶颈
响应时间超标,先问“在多少线程下开始超标”。单独一句“变慢了”没有信息。响应时间变化有两种常见形态:系统不稳定,有时快有时慢;随着并发压力变大慢慢变慢。后者通常意味着资源开始排队。
错误率抬头,分三层看:接口本身报错、服务器撑不住(代码问题、内存泄漏、硬件资源)、保护机制被触发。限流、熔断、降级都会让错误率上升,但那是系统在自保,不是 bug。看到 5% 的失败率,先去响应体里找业务码,比直接提单有用。
吞吐量的形状对应三种判断:
| 形状 | 判断 |
|---|---|
| 波动很大 | 系统性能不稳定 |
| 慢慢变高,再趋于稳定 | 和并发量强相关,接近容量上限 |
| 慢慢变低,并发量也减少 | 压测收尾,或者系统变卡导致线程发得慢 |
JMeter 之外,课件没有展开 LoadRunner,但两套工具的概念能一一对应:LoadRunner 用 VuGen 录制和编写 Vuser 脚本,Controller 设计场景,Analysis 分析结果;参数化、关联、集合点、事务、场景这些词在 JMeter 里分别是 CSV/JSON 提取器、同步定时器、事务控制器、线程组。差别主要在授权模式和协议覆盖,JMeter 开源、基于 Java,LoadRunner 商业、协议支持更广。会用其中一套,另一套的脚本结构不难迁移。
压测报告里最有用的数字是拐点出现在第几级负载,以及那一级的响应时间和错误率。峰值只能说明某一刻跑到了多少,拐点才说明系统从哪里开始不健康。
还没有评论 — 第一条由你来留。