把 {19, 30, 5, 36, 13, 20, 21, 12} 按 key % 11 放进 11 个格子,先算下标:
| key | 19 | 30 | 5 | 36 | 13 | 20 | 21 | 12 |
|---|---|---|---|---|---|---|---|---|
key % 11 | 8 | 8 | 5 | 3 | 2 | 9 | 10 | 1 |
19 和 30 都算到 8 号位,一格只能放一个。线性探测的规则是冲突就往后找空位,依次落成:
| 下标 | 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 元素 | 21 | 12 | 13 | 36 | 空 | 5 | 空 | 空 | 19 | 30 | 20 |
20 本来算到 9,被 30 占了,只能去 10;21 算到 10,又被 20 占了,绕回 0。整张表的关键零件只有三个:把 key 算成下标的哈希函数、存元素的数组、冲突后的落脚规则。
直接定址法只在值域窄的时候成立
如果关键字集中在 [0, 99],开 100 个格子,key 自己就是下标;只有小写字母时,开 26 个格子,ch - 'a' 就是下标。LeetCode 387 的“第一个唯一字符”就是这套写法:
#include <cstddef>
#include <string>

int firstUniqChar(const std::string& s)
{
    int count[26] = {0};
    for (char ch : s)
        count[ch - 'a']++;

    for (std::size_t i = 0; i < s.size(); ++i)
        if (count[s[i] - 'a'] == 1)
            return static_cast<int>(i);
    return -1;
}这段代码成立的前提是输入只含小写字母。混进大写字母、数字或其他字符时,ch - 'a' 可能落到负数或超过 25,直接越界。另一个边界是值域:真实数据只有一百个,却分布在 [0, 9999],开一万个格子,空间利用率只有百分之一。
直接定址法的本质是“用关键字直接算出绝对位置或相对位置”,不需要哈希函数,也没有冲突。它解决不了范围分散的数据,这时才引入 h(key) 把关键字压进 [0, M)。
哈希函数先保证结果落在 [0, M)
除留余数法(除法散列法)写成 h(key) = key % M。M 是桶数,余数落在 [0, M);不同的 key 可能算出同一个余数,这就是哈希冲突。冲突无法彻底消除:N 个 key 映射到 M 个格子,超过 M 必有碰撞,没超过也可能扎堆。
写 key % M 之前先处理符号。C++ 的整数除法向零截断,余数的符号跟被除数一致:
#include <iostream>

int main()
{
    const int M = 11;
    int key = -20;
    std::cout << key % M << '\n';               // -9
    std::cout << ((key % M) + M) % M << '\n';   // 2
}
-20 % 11 是 -9,拿它当下标会越界。(key % M + M) % M 把结果拉回 [0, M);因为 key % M 一定落在 (-M, M),加一次 M 再取模就够了。自定义哈希函数的输出必须满足这个区间,任何可能为负的中间结果都要处理。
M 的取值影响分布。M 是 2 的幂时,key % M 等价于保留二进制的低 X 位:63 和 31 的后四位都是 1111,M = 16 时都落到 15。M 是 10 的幂时保留十进制后缀,112 和 12312 在 M = 100 时都落到 12。低位有规律的数据会全部挤在一起。教材的建议是取不太接近 2 的整数次幂的质数,SGI STL 干脆准备了一张近似翻倍的质数表:
53, 97, 193, 389, 769, 1543, 3079, 6151, 12289, 24593,
49157, 98317, 196613, 393241, 786433, 1572869, 3145739,
6291469, 12582917, 25165843, 50331653, 100663319,
201326611, 402653189, 805306457, 1610612741,
3221225473, 4294967291
扩容时用 lower_bound 找不小于目标值的第一个质数,找不到就用最后一个。质数表的价值在于桶数不会退化成 2 的幂,同时扩容幅度接近两倍。
Java 的 HashMap 走了另一条路:桶数直接取 2 的幂,用 key & (M - 1) 代替取模,再用 key ^ (key >> 16) 把高位掺进来。位运算比取模快,扰动补上了低位信息的丢失。这两条路线都能用,关键是让 key 的每一位都参与计算。
乘法散列法对 M 没有要求:先算 A * key 的小数部分,再乘以 M 向下取整。
h(key) = floor(M * ((A * key) % 1.0))
A = (sqrt(5) - 1) / 2 ≈ 0.6180339887
M = 1024、key = 1234 时,A * key ≈ 762.6539,小数部分 0.6539,乘 1024 得 669.6,取整为 669。Knuth 推荐黄金分割数,理由是相邻 key 映射出的位置间隔稳定。
全域散列法(universal hashing)给哈希函数加随机性,专门对付“知道哈希函数就能构造最坏数据”的攻击:
h_ab(key) = ((a * key + b) % P) % MP 取足够大的质数,a 从 [1, P-1] 随机选,b 从 [0, P-1] 随机选,一共 P * (P - 1) 组函数。P = 17、M = 6、a = 3、b = 4 时,h(8) = ((3 * 8 + 4) % 17) % 6 = 5。a 和 b 必须在建表时一次选定,之后增删查都用同一组;每次操作重新随机,插入和查找就会用不同的函数,键根本找不回来。
平方取中法、折叠法、随机数法、数学分析法属于教材里的补充手段,适合特定数据分布,实际工程里除留余数加扰动最常见。
负载因子决定扩容时机
负载因子 α = N / MN 是已存元素数,M 是桶数,英文 load factor。α 越大,空间越满,冲突越多;α 越小,查找越快,内存越浪费。
两种冲突方案对 α 的约束不同。开放定址法的元素全部住在表里,α 必须小于 1,表满后再也找不到空位;链表法(链地址法)的元素挂在桶外,α 可以大于 1。课件写“开放定址法中负载因子一定是小于的”,漏了关键数字,完整说法是“必须小于 1”;它前面又说“一般情况下 M >= N”,这句话只对开放定址法成立,链地址法并不要求。标准库的 unordered_* 把最大负载因子控制在 1 附近,超过就 rehash。
扩容不是简单的“桶数翻倍”。桶数变了,每个 key 的 key % M 都变了,所有元素要重新计算位置。闭散列重建整张表,链地址法只把结点摘下来挂到新桶,地址不变。
闭散列:探测、墓碑和 0.7
线性探测的公式是:
hash0 = h(key) = key % M
hashi = (hash0 + i) % M,  i ∈ [1, M - 1]
走到表尾就回绕到表头。它实现简单,但会出现堆积:一段连续位置被占满后,后续映射到这段区间的 key 都要越过整段,冲突区越滚越大。
二次探测把步长改成平方,左右跳:
hashi = (hash0 ± i²) % M, i ≥ 1初始位置相邻的 key 会被迅速拉开。它只能覆盖大约一半的格子(M 为质数时更明显),所以负载因子通常压到 0.5 以下。写代码时别直接用无符号减法:hash0 - i * i 在 size_t 下不会得到负数,只会回绕成一个巨大的正数,if (hashi < 0) 永远不成立。先转成有符号中间量,或者写成 (hash0 + M - (i * i) % M) % M。
双重散列用第二个哈希函数算偏移量:
hashi = (hash0 + i * h2(key)) % M, i ∈ [1, M - 1]h2(key) 必须小于 M 且与 M 互质。互质的理由是探测序列会形成一个环:M = 12、偏移量 3 时,从 1 出发只能到 {1, 4, 7, 10} 四个位置,M / gcd(M, 3) = 4,其余格子永远走不到。M 是 2 的幂时让 h2 取奇数,M 是质数时用 h2(key) = key % (M - 1) + 1。
删除是闭散列最容易写错的地方。假设 8 号是 19、9 号是 30、10 号是 20,直接把 9 号清空,查找 20 时从 9 开始,遇到空位就判定不存在,可 20 明明还在 10 号。所以每个格子需要三个状态:EMPTY 没用过,EXIST 存着数据,DELETE 删过。删除只把状态改成 DELETE;查找遇到 DELETE 继续往后,遇到 EMPTY 才停;插入可以把 DELETE 当空位复用。两条规则方向相反,写反就是隐藏 bug。
墓碑的代价是“假满”:_n 在减少,墓碑在增加,表看上去空,探测链还是那么长。只按 _n / M 判断扩容不够,删得多的表要在墓碑比例高时重排一次,把墓碑清掉。
把状态位、线性探测和扩容拼起来,负载因子超过 0.7 就重建表:
#include <algorithm>
#include <cstddef>
#include <iostream>
#include <string>
#include <utility>
#include <vector>

template<class K>
struct HashFunc
{
    std::size_t operator()(const K& key) const
    {
        return static_cast<std::size_t>(key);
    }
};

inline std::size_t next_prime(std::size_t n)
{
    static const std::size_t primes[] =
    {
        53, 97, 193, 389, 769,
        1543, 3079, 6151, 12289, 24593,
        49157, 98317, 196613, 393241, 786433,
        1572869, 3145739, 6291469, 12582917, 25165843,
        50331653, 100663319, 201326611, 402653189, 805306457,
        1610612741, 3221225473u, 4294967291u
    };
    const std::size_t count = sizeof(primes) / sizeof(primes[0]);
    const std::size_t* pos = std::lower_bound(primes, primes + count, n);
    return pos == primes + count ? primes[count - 1] : *pos;
}

namespace closed
{
enum State { EMPTY, EXIST, DELETE };

template<class K, class V>
struct HashData
{
    std::pair<K, V> _kv{};
    State _state = EMPTY;
};

template<class K, class V, class Hash = HashFunc<K>>
class HashTable
{
public:
    HashTable()
    {
        _tables.resize(::next_prime(0));
    }

    bool Insert(const std::pair<K, V>& kv)
    {
        if (Find(kv.first) != nullptr)
            return false;

        if (_n * 10 >= _tables.size() * 7)
            Rehash(::next_prime(_tables.size() + 1));

        Hash hash;
        const std::size_t hash0 = hash(kv.first) % _tables.size();
        std::size_t hashi = hash0;
        std::size_t i = 1;
        while (_tables[hashi]._state == EXIST && i < _tables.size())
        {
            hashi = (hash0 + i) % _tables.size();
            ++i;
        }

        _tables[hashi]._kv = kv;
        _tables[hashi]._state = EXIST;
        ++_n;
        return true;
    }

    HashData<K, V>* Find(const K& key)
    {
        Hash hash;
        const std::size_t hash0 = hash(key) % _tables.size();
        for (std::size_t i = 0; i < _tables.size(); ++i)
        {
            const std::size_t hashi = (hash0 + i) % _tables.size();
            HashData<K, V>& slot = _tables[hashi];
            if (slot._state == EMPTY)
                return nullptr;
            if (slot._state == EXIST && slot._kv.first == key)
                return &slot;
        }
        return nullptr;
    }

    bool Erase(const K& key)
    {
        HashData<K, V>* pos = Find(key);
        if (pos == nullptr)
            return false;
        pos->_state = DELETE;
        --_n;
        return true;
    }

private:
    void Rehash(std::size_t newSize)
    {
        std::vector<HashData<K, V>> old;
        old.swap(_tables);
        _tables.resize(newSize);
        _n = 0;
        for (auto& e : old)
        {
            if (e._state == EXIST)
                Insert(e._kv);
        }
    }

    std::vector<HashData<K, V>> _tables;
    std::size_t _n = 0;
};
}
Find 的循环上限是 M 次。这样写有两个好处:表里没有 EMPTY 时不会死循环,墓碑堆积时也能在有限步内返回。Insert 的循环只停在非 EXIST 的格子上,DELETE 和 EMPTY 都能落位。
开散列:桶里挂链表
链地址法把元素移到桶外:桶数组只存链表头,冲突的元素挂成一条单链表,也叫哈希桶。
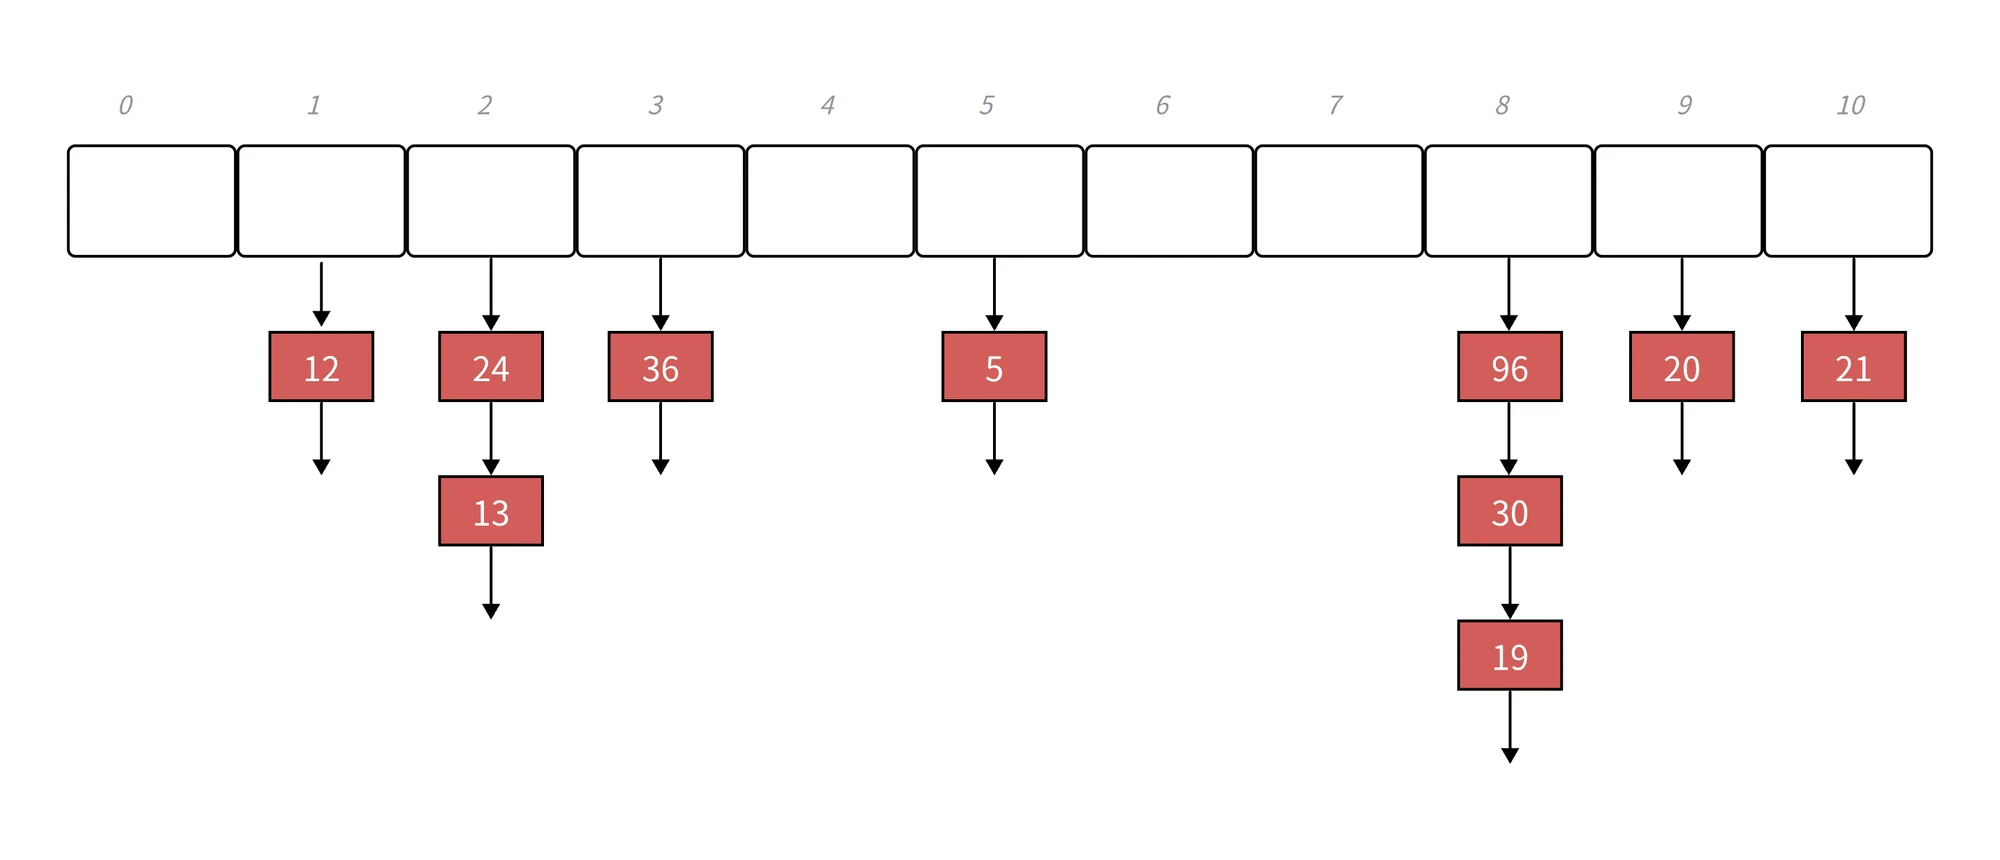
开散列的负载因子可以大于 1,但标准库仍把上限设在 1 附近:桶越多,链越短,查找越接近 O(1)。插入用头插,O(1);删除要找前驱,头结点单独处理;扩容搬结点,不复制值。
先看课程实现里的一处顺序问题。那段代码先算桶号,再判断扩容:
size_t hashi = hs(kv.first) % _tables.size();   // 旧表长

if (_n == _tables.size())
{
    vector<Node*> newtables(__stl_next_prime(_tables.size() + 1), nullptr);
    // 搬完旧结点了
    _tables.swap(newtables);
}

Node* newnode = new Node(kv);
newnode->_next = _tables[hashi];   // 这里用的是旧表长算出的 hashi
_tables[hashi] = newnode;
桶数从 53 变成 97 后,同一个 key 的桶号可能从 47 变成 3。Find 按新表长算出 3,去 3 号桶找不到,结点却挂在 47 号桶。正确顺序是扩容之后再用新表长算桶号。
完整实现:
namespace bucket
{
template<class K, class V>
struct HashNode
{
    std::pair<K, V> _kv;
    HashNode* _next;

    HashNode(const std::pair<K, V>& kv)
        : _kv(kv), _next(nullptr) {}
};

template<class K, class V, class Hash = HashFunc<K>>
class HashTable
{
    using Node = HashNode<K, V>;

public:
    HashTable()
    {
        _tables.resize(::next_prime(0), nullptr);
    }

    ~HashTable()
    {
        Clear();
    }

    HashTable(const HashTable&) = delete;
    HashTable& operator=(const HashTable&) = delete;

    bool Insert(const std::pair<K, V>& kv)
    {
        if (Find(kv.first) != nullptr)
            return false;

        Hash hash;
        if (_n == _tables.size())
        {
            std::vector<Node*> newTables(::next_prime(_tables.size() + 1), nullptr);
            for (std::size_t i = 0; i < _tables.size(); ++i)
            {
                Node* cur = _tables[i];
                while (cur != nullptr)
                {
                    Node* next = cur->_next;
                    const std::size_t hashi = hash(cur->_kv.first) % newTables.size();
                    cur->_next = newTables[hashi];
                    newTables[hashi] = cur;
                    cur = next;
                }
                _tables[i] = nullptr;
            }
            _tables.swap(newTables);
        }

        const std::size_t hashi = hash(kv.first) % _tables.size();
        Node* node = new Node(kv);
        node->_next = _tables[hashi];
        _tables[hashi] = node;
        ++_n;
        return true;
    }

    Node* Find(const K& key)
    {
        Hash hash;
        const std::size_t hashi = hash(key) % _tables.size();
        for (Node* cur = _tables[hashi]; cur != nullptr; cur = cur->_next)
        {
            if (cur->_kv.first == key)
                return cur;
        }
        return nullptr;
    }

    bool Erase(const K& key)
    {
        Hash hash;
        const std::size_t hashi = hash(key) % _tables.size();
        Node* prev = nullptr;
        Node* cur = _tables[hashi];
        while (cur != nullptr)
        {
            if (cur->_kv.first == key)
            {
                if (prev == nullptr)
                    _tables[hashi] = cur->_next;
                else
                    prev->_next = cur->_next;
                delete cur;
                --_n;
                return true;
            }
            prev = cur;
            cur = cur->_next;
        }
        return false;
    }

private:
    void Clear() noexcept
    {
        for (std::size_t i = 0; i < _tables.size(); ++i)
        {
            Node* cur = _tables[i];
            while (cur != nullptr)
            {
                Node* next = cur->_next;
                delete cur;
                cur = next;
            }
            _tables[i] = nullptr;
        }
        _n = 0;
    }

    std::vector<Node*> _tables;
    std::size_t _n = 0;
};
}

int main()
{
    bucket::HashTable<int, int> t;
    for (int key : {19, 30, 5, 36, 13, 20, 21, 12, 24, 96})
        t.Insert({key, key});

    t.Erase(30);
    std::cout << (t.Find(20) != nullptr ? "found" : "lost") << '\n';
    return 0;
}
_tables 是 vector<Node*>,不是 vector<Node>。结点必须在堆上,地址才稳定;vector 扩容会把元素整体搬走,桶里保存的 _next 和外部持有的结点地址都会失效。结点自己 new、自己 delete,扩容只换桶数组。
删除必须先找前驱,因为单链表没有反向指针;头结点没有前驱,要单独改桶头。也可以给每个结点加一个 prev,代价是每个结点多一个指针。
扩容时直接摘结点挂到新桶,不做 new Node。结点地址不变,外部持有的指针和引用仍然有效。标准库也给出同样的承诺:指向元素的引用和指针只在元素被删除时失效。
极端场景是某个桶特别长。Java 8 的 HashMap 在单桶长度超过 8 时把链表转成红黑树,查找从 O(N) 降到 O(logN);C++ 标准库的 unordered_* 一般仍用单链加定期 rehash。键可能被外部构造时,选择随机种子的哈希或全域散列,或者接受最坏情况,把安全成本算进去。
字符串 key 先变成整数
string 不能直接取模,先转成整数。最朴素的办法是把 ASCII 码相加,但 "abcd" 和 "bcad" 字符集合相同,和也相同,任何“相同字符不同顺序”的串都会撞;对单词、重排词这类数据几乎失去区分度。
BKDR 哈希每读一个字符,先把当前结果乘一个质数,再加上字符:
hash = 0
for ch in s:
    hash = hash * seed + ch
展开后是一个以 seed 为底的多项式,每个字符乘的权由位置决定,顺序信息编进去了。seed 常取 31、131、1313,这类数与字符编码、2 的幂都互质,取模后分布更均匀。
template<>
struct HashFunc<std::string>
{
    std::size_t operator()(const std::string& key) const
    {
        std::size_t h = 0;
        for (unsigned char ch : key)
            h = h * 131 + ch;
        return h;
    }
};
size_t 是无符号整数,溢出按模 2^64 回绕,结果确定,不用刻意防溢出。char 可能是有符号的,编码超过 127 时先变成负数再转无符号会改变结果,套一层 unsigned char 更稳。
C++ 标准没有规定 std::hash<std::string> 的具体算法,各家实现不同,有的用 MurmurHash 变体,有的用 FNV,有的加随机种子。别跨进程、跨标准库依赖它的具体值。手写 BKDR 是为了看懂原理、分布够用;生产代码直接用标准库。
哈希表的所有细节都围绕三件事展开:哈希函数把 key 均匀压进 [0, M),冲突方案决定撞了以后往哪放,负载因子决定什么时候重建。把这三件事分开看,闭散列和开散列的代码差别只是“冲突元素住在表里还是挂在表外”。
还没有评论 — 第一条由你来留。