std::list 的底层结构是一句话:带头结点的双向循环链表。节点只有三个字段:
template<class T>
struct ListNode
{
    ListNode* _prev;
    ListNode* _next;
    T _data;
};
“双向”意味着 --it 合法,it + 5 不合法;“循环”意味着尾节点的 _next 不指向空,而是指回头结点;“带头结点”意味着有一个不存数据的哨兵。哨兵让 end() 有了实体——end() 就是哨兵本身,begin() 是哨兵的 _next,末尾那个数据节点自增一次就回到 end()。libstdc++ 里 list 的迭代器只包一个节点指针 _M_node,ilist.node 就是那个哨兵。
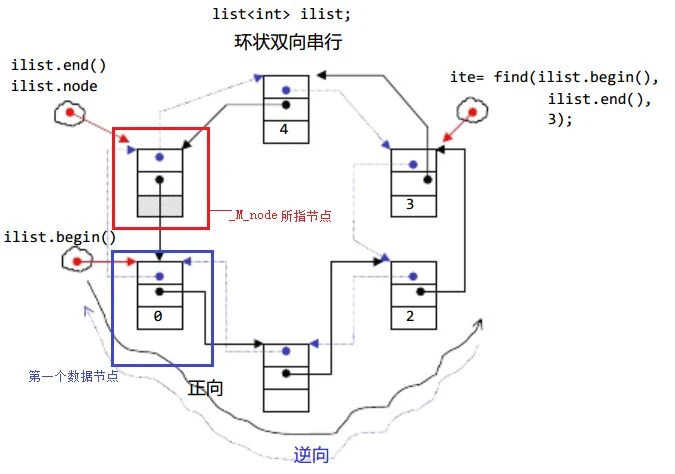
哨兵消掉了两处特判。没有它时,空表要单独判 head == nullptr,头插要单独改 head;有了它,空表就是“哨兵自己指向自己”,此时 begin() == end(),任何位置的插入都是同一段改指针的代码。
五组接口
| 组 | 接口 | 语义 |
|---|---|---|
| 构造 | list() / list(n, val) / list(const list&) / list(first, last) | 空表、n 个 val、拷贝、把 [first, last) 区间里的元素逐个插入 |
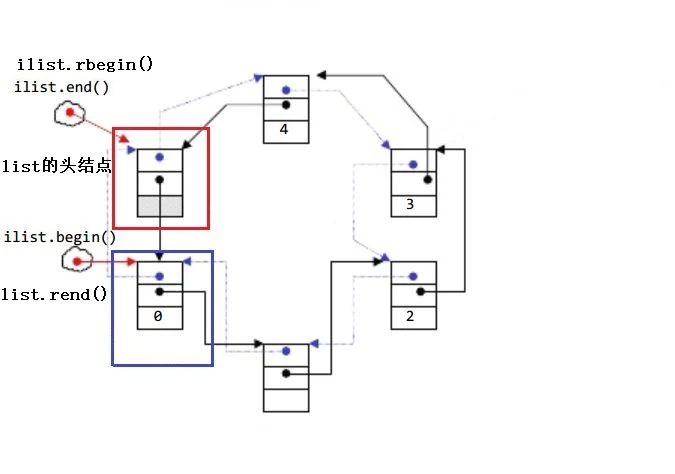
| 迭代器 | begin / end / rbegin / rend | 正向首元素、正向尾后、反向首元素(内部对应 end)、反向尾后(内部对应 begin) |
| 容量 | empty / size | 是否为空;有效节点个数 |
| 访问 | front / back | 首、尾节点中值的引用 |
| 修改 | push_front / pop_front / push_back / pop_back / insert / erase / swap / clear | 头尾增删、指定位置增删、交换两个容器、清空有效元素 |
几条边界:区间构造是左闭右开,last 不计入;它只认迭代器,vector 的迭代器和裸数组指针都能填进来,因为裸指针在泛型算法里本来就是一档迭代器。size() 从 C++11 起要求常数时间,实现靠一个计数器,不会遍历。clear() 只销毁数据节点,哨兵留着,清空后还能继续 push_back。空容器上调 front()、back()、pop_front()、pop_back() 都是未定义行为。
insert 插在 position 之前
课件把 insert 写成“在 list position 位置中插入值为 val 的元素”,按字面容易理解成新元素占住了 position 的位置。标准语义是插到 position 所指元素之前,插入后 position 仍指向原来那个元素,返回值才是新元素的迭代器(cppreference 对 std::list::insert 的说明:inserts elements before the position)。push_back(v) 等价于 insert(end(), v)。
#include <list>

int main()
{
    std::list<int> l{1, 2, 3};
    auto it = l.begin();
    ++it;                        // 指向 2
    auto pos = l.insert(it, 9);  // 9 插在 2 前面,链表是 1 9 2 3
    *pos = 90;                   // pos 指向新插入的 9
}
只有被删节点上的迭代器会失效
list 的插入不改任何已有节点的地址,所以插入不会让任何迭代器、指针、引用失效。删除只销毁被删除的那个节点,于是失效的也只有指向它的迭代器,其余迭代器照常可用。
课件给过一段错误示范:
#include <list>

int main()
{
    std::list<int> l{1, 2, 3, 4};
    auto it = l.begin();
    while (it != l.end())
    {
        l.erase(it);
        ++it;         // it 指向的节点已经被销毁,这里读的是悬空指针
    }
}
erase 从 C++11 起返回被删元素之后那个迭代器,所以正确写法是把返回值接住:
#include <list>

int main()
{
    std::list<int> l{1, 2, 3, 4};
    auto it = l.begin();
    while (it != l.end())
        it = l.erase(it);
}
另一种写法是先把 it 推到下一个节点再删:
#include <list>

int main()
{
    std::list<int> l{1, 2, 3, 4};
    auto it = l.begin();
    while (it != l.end())
        l.erase(it++);     // 后置 ++ 交出旧副本,it 已经站在下一个节点
}
erase(it++) 成立的原因是后置 ++ 先返回旧值、再修改 it,erase 拿到的是旧副本。范围 for 循环不要在里面删元素:它在语义上缓存了 begin(),循环体把当前节点删掉后,下一轮自增就是未定义行为。
反向迭代器只是把 ++ 和 -- 对调
rbegin() 内部对应正向 end(),rend() 对应正向 begin()。end() 不能解引用,而 *rbegin() 必须取到尾节点,所以 operator* 的做法是先把内部的正向迭代器退一格,再取值。
#include <iostream>
#include <iterator>
#include <list>

template<class Iterator>
class ReverseIterator
{
public:
    // std::iterator_traits<Iterator>::reference 是依赖类型名,不加 typename 编译器会按静态成员去解析
    using reference = typename std::iterator_traits<Iterator>::reference;
    using pointer   = typename std::iterator_traits<Iterator>::pointer;
    using Self      = ReverseIterator<Iterator>;

    explicit ReverseIterator(Iterator it) : _it(it) {}

    reference operator*() const
    {
        Iterator tmp = _it;
        --tmp;
        return *tmp;
    }
    pointer operator->() const { return &(operator*()); }

    Self& operator++() { --_it; return *this; }
    Self  operator++(int) { Self tmp(*this); --_it; return tmp; }
    Self& operator--() { ++_it; return *this; }
    Self  operator--(int) { Self tmp(*this); ++_it; return tmp; }

    bool operator==(const Self& rhs) const { return _it == rhs._it; }
    bool operator!=(const Self& rhs) const { return _it != rhs._it; }

private:
    Iterator _it;
};

int main()
{
    std::list<int> l{1, 2, 3, 4};
    ReverseIterator<std::list<int>::iterator> first(l.end()), last(l.begin());
    for (auto it = first; it != last; ++it)
        std::cout << *it << ' ';      // 4 3 2 1
}课件这段实现里有一处真错:operator== 写成了 return _it != l._it;,和 operator!= 一模一样。两个不同的反向迭代器会被判成相等,依赖 it != rend 的循环会直接失效。正确写法是 _it == rhs._it。
标准库的 std::reverse_iterator 多一个 base(),返回内部那个正向迭代器。它比当前所指元素靠后一格,所以“反向找、正向删”时要用 std::next(rit).base() 才能拿到元素本身的位置:
#include <iterator>
#include <list>

int main()
{
    std::list<int> l{1, 2, 3, 4};
    auto rit = l.rbegin();
    while (rit != l.rend())
    {
        if (*rit % 2 == 0)
            rit = std::make_reverse_iterator(l.erase(std::next(rit).base()));
        else
            ++rit;
    }
}
直接写 rit.base() 删掉的是下一个元素,这类差一格的错误在反向迭代器上很常见。
splice、sort、merge 为什么必须是成员函数
list 的迭代器是双向的,std::sort 要求随机访问,所以通用算法用不了。标准库的做法是把链式版本做成成员:sort、splice、merge、unique、remove、remove_if、reverse。
| 成员 | 做的事 | 复杂度 |
|---|---|---|
splice(pos, other) | 把 other 的全部节点接到 pos 前,other 变空 | O(1) |
splice(pos, other, it) | 搬一个节点 | O(1) |
splice(pos, other, first, last) | 搬 [first, last);跨容器时要先算距离 | 跨容器 O(n),同容器 O(1) |
merge(other) | 两边都有序,按同一规则摘节点接上 | O(n) |
sort() | 归并排序,只改 _prev/_next,节点不动 | O(n log n),稳定 |
unique() | 只压掉相邻的重复 | O(n) |
remove(val) | 真删所有等于 val 的节点,size() 立刻变小 | O(n) |
reverse() | 逐节点反转指针 | O(n) |
splice 不失效任何迭代器或引用,但被搬走的元素上的迭代器和引用会改指目标容器。同容器内 splice 时,目标位置不能落在被搬的区间里;两个容器的分配器必须相等,否则是未定义行为。sort 只重排指针,排序前后指向元素的迭代器和引用依然有效,只是邻居换了。unique 不是全局去重,{1, 1, 2, 1} 只会压掉开头两个 1,要全局去重得先 sort 再 unique。
还有一个同名陷阱:l.remove(val) 是成员函数,会真的删节点;std::remove(first, last, val) 是算法,只把不等于 val 的元素往前挪,返回新的逻辑尾,容器长度不变,尾部留着旧值。
和 vector 的分工
| 维度 | vector | list |
|---|---|---|
| 底层 | 动态顺序表,一段连续空间 | 带头结点的双向循环链表 |
| 随机访问 | O(1) | O(N),不支持 it + n |
| 任意位置插入删除 | O(N),要搬元素;扩容要拷贝全部元素 | O(1),只改指针 |
| 空间 | 连续空间,无内存碎片,缓存利用率高 | 每节点单独分配,有碎片,缓存利用率低 |
| 迭代器 | 多数实现就是裸指针 | 对节点指针的封装 |
| 迭代器失效 | 插入时若扩容则全部失效,否则插入点及之后失效;删除时当前及之后失效 | 插入不失效;删除只失效被删节点 |
缓存这条比复杂度表更能决定实测性能。遍历散落在堆上的节点,每次跳转都可能是一次缓存未命中;vector 的连续内存能被预取器整段读进来。内存账也反直觉:64 位平台上 list<int> 一个节点通常是 24 字节(两个 8 字节指针加一个 4 字节 int,再对齐),一百万个元素光节点就要 24 MB;vector<int> 同样一百万个只要 4 MB。
list 真正占优的条件通常要同时满足:增删位置已经由迭代器给出、不必先查找;操作落在头部或中部,vector 每次都要搬一大段;元素较大或地址必须长期稳定。只要有一条不成立,先用 vector 更稳,尾插尤其如此——push_back 摊销 O(1),缓存还友好。
还没有评论 — 第一条由你来留。