vector 对象本身很小,主流实现里就是三个指针:
template <class T>
class vector
{
private:
    T* _start;            /* 第一个元素 */
    T* _finish;           /* 最后一个元素的下一个位置 */
    T* _end_of_storage;   /* 已申请空间的末尾 */
};
size() 是 _finish - _start,capacity() 是 _end_of_storage - _start。两个数不重复:前者记录已经构造了多少个元素,后者记录这块内存一共能装多少个。
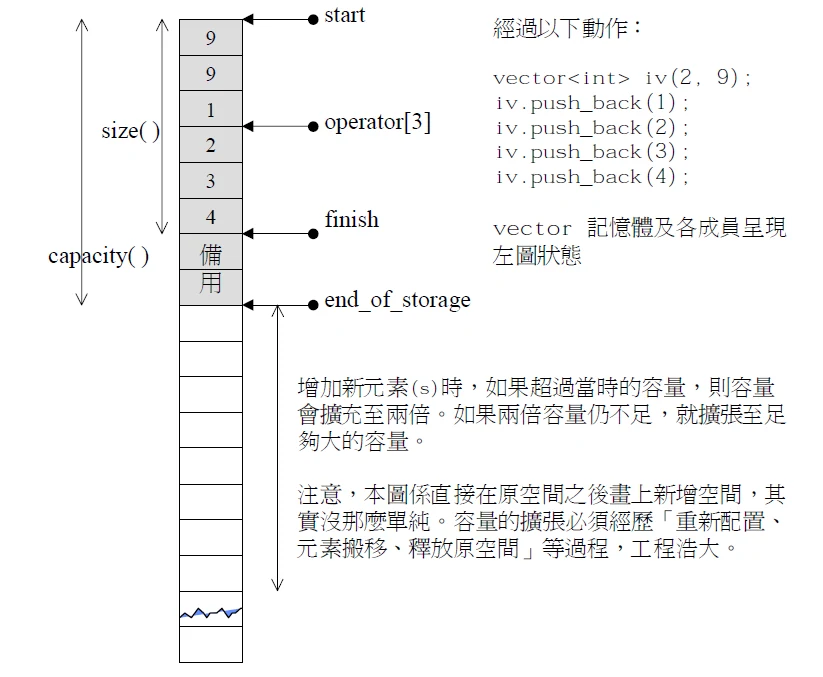
operator[] 做的就是 *(_start + n),一次指针加法,没有边界检查;at(n) 多一次比较,越界抛 std::out_of_range。下标来自外部输入时用 at,内部循环用 []。push_back 先看 _finish == _end_of_storage:没满就原地构造,满了才申请新空间、搬元素、释放旧空间。单次搬家是 O(n),但按几何级数扩容,n 次追加的总搬运量仍与 n 成正比,所以标准写的是均摊常数时间。
扩容倍数:VS 约 1.5 倍,g++ 2 倍
#include <iostream>
#include <vector>

int main()
{
    std::vector<int> v;
    std::size_t cap = v.capacity();
    std::cout << "capacity changed: " << cap;

    for (int i = 0; i < 100; ++i)
    {
        v.push_back(i);
        if (cap != v.capacity())
        {
            cap = v.capacity();
            std::cout << " -> " << cap;
        }
    }
    std::cout << '\n';
    return 0;
}
课件在两边各跑了一次。VS 的容量依次是 1、2、3、4、6、9、13、19、28、42、63、94、141,大约是上一次的 1.5 倍;g++ 是 1、2、4、8、16、32、64、128,正好翻倍。VS 用的是 P.J. 版 STL,g++ 用的是 SGI 版,倍数由实现自己定。
标准对扩容倍数没有任何规定,只要求 push_back 均摊常数时间、增长策略足以摊平搬运成本。1.5 倍和 2 倍都合法。所以“vector 扩容是两倍”这句话只在某些实现上成立,换编译器、换标准库版本就不对了。1.5 倍的策略还有个副作用:新空间可能只比旧空间大一点,释放掉的旧块很难被下一次分配复用;2 倍增长浪费空间更多,但搬的次数少。
知道容量怎么涨,reserve 的用处就清楚了。确定要存十万条记录,先 reserve(100000),整个追加过程一次家都不用搬:
#include <iostream>
#include <vector>

int main()
{
    std::vector<int> v;
    v.reserve(100);

    std::size_t cap = v.capacity();
    for (int i = 0; i < 100; ++i)
    {
        v.push_back(i);
        if (cap != v.capacity())
        {
            cap = v.capacity();
            std::cout << "capacity changed: " << cap << '\n';
        }
    }
    return 0;
}
这段一行 capacity changed 都不会打印,reserve(100) 之后容量足够装 100 个,后续 push_back 不再触发扩容。
reserve 与 resize 是两件事,课件把它们放在同一张表里,容易混:
reserve(n)只改容量,size()不变。reserve(100)之后v.size()还是 0,v[50] = 1;是越界访问——空间有,元素没构造。resize(n)改有效元素个数,多出来的位置会调用默认构造或填充指定值,size()直接变成 n;n 小于当前大小时只销毁尾部元素,容量不变。
reserve 只增不减,参数比当前容量小时什么也不做;标准也不允许它缩容。想把多余空间还回去用 shrink_to_fit(),但那只是个非强制请求,实现可以不理,真缩了就是一次 O(n) 搬运,所有迭代器作废。
构造、迭代器与遍历
| 构造函数 | 作用 |
|---|---|
vector() | 空 vector |
vector(n, val) | n 个值为 val 的元素,val 可省略,此时用值初始化 |
vector(const vector&) | 拷贝构造 |
vector(first, last) | 用迭代器区间 [first, last) 构造 |
#include <vector>

int main()
{
    std::vector<int> v1;                                  /* 空 */
    std::vector<int> v2(5, 7);                            /* 5 个 7 */
    std::vector<int> v3(v2);                              /* 拷贝 */
    int a[] = {1, 2, 3, 4};
    std::vector<int> v4(a, a + sizeof(a) / sizeof(a[0]));  /* 迭代器区间 */
    return 0;
}
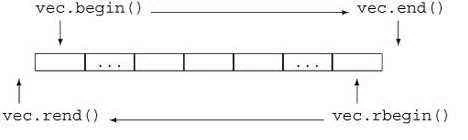
begin() / end() 拿到正向迭代器,rbegin() / rend() 拿到反向迭代器。反向的两个起点在尾部:rbegin() 指向最后一个元素,rend() 指向第一个元素之前,++ 往回走。
vector 的迭代器是随机访问迭代器(random access iterator),能做 + n、- n、[i]、比较大小,所以 std::sort、std::binary_search 这类需要跳着走的算法能直接用在它上面。list 的迭代器只有双向能力,last - first 写不出来,sort 就用不了,只能调 list::sort。
增删查改:find 不是成员函数
| 接口 | 作用 | 代价 |
|---|---|---|
push_back | 尾部插入 | 均摊 O(1) |
pop_back | 尾部删除 | O(1) |
insert(pos, val) | 在 pos 之前插入 | O(n),可能扩容 |
erase(pos) | 删除 pos 位置元素,返回下一个位置 | O(n) |
swap(other) | 交换两块数据空间 | O(1) |
operator[] | 像数组一样访问 | O(1),不检查边界 |
find(first, last, val) | 查找 | O(n),来自 <algorithm>,不是成员 |
find 是算法而不是容器的成员,这一点在使用上体现得很直接:所有容器、数组、甚至自定义区间都能用同一个 find,因为它只依赖迭代器。
#include <algorithm>
#include <iostream>
#include <vector>

int main()
{
    std::vector<int> v = {1, 2, 3, 4, 5};

    v.push_back(6);
    v.pop_back();

    auto it = std::find(v.begin(), v.end(), 3);
    if (it != v.end())
        v.insert(it, 30);

    auto pos = std::find(v.begin(), v.end(), 2);
    if (pos != v.end())
        v.erase(pos);

    for (int x : v)
        std::cout << x << ' ';
    std::cout << '\n';
    return 0;
}
insert 和 erase 都要搬元素。在头部插入一个元素,后面所有元素整体后移一位,连续做 n 次就是 O(n²)。中间增删多、又不需要随机访问时,list 更合适;只在尾部追加,vector 的连续内存对缓存最友好。
迭代器失效:扩容、assign、erase 三处
vector 的迭代器在实现上通常是指向元素的指针或包装过的指针,失效的意思是:它指向的那块空间已经被释放,或者元素已经搬到别处,再解引用就是访问无效内存。课件把可能触发失效的操作列了一组:resize、reserve、insert、assign、push_back,共同点是它们都可能让底层空间重新分配。
#include <iostream>
#include <vector>

int main()
{
    std::vector<int> v{1, 2, 3, 4, 5, 6};
    auto it = v.begin();

    v.assign(100, 8);          /* 元素变 100 个,通常会重新分配 */

    while (it != v.end())      /* it 还指着旧空间 */
    {
        std::cout << *it << ' ';
        ++it;
    }
    std::cout << '\n';
    return 0;
}
修法只有一句:这些操作做完之后,重新取迭代器。课件演示的几种操作都适用。
erase 的规则要单独说。课件写的是“删除后元素前移,底层空间没变,理论上迭代器不该失效,只是 VS 认为该位置迭代器失效”。这个说法把标准行为降级成了某个编译器的偏好。标准规定:erase 会让指向被删位置及其之后所有元素的迭代器与引用失效,end() 也在失效范围内。跟“是不是最后一个元素”“空间有没有变”无关,它是接口契约。
删除所有偶数的两段代码,课件放在一起让人选:
#include <vector>

int main()
{
    std::vector<int> v{1, 2, 3, 4};

    for (auto it = v.begin(); it != v.end();)
    {
        if (*it % 2 == 0)
            it = v.erase(it);   /* 接住返回值,它指向被删元素的下一个 */
        else
            ++it;
    }
    return 0;
}
另一版是 if (*it % 2 == 0) v.erase(it); ++it;。erase 之后 it 已经失效,++it 是在失效迭代器上做运算;即使碰巧没崩,被删元素的下一个也会被跳过,结果仍然不对。第二版接住了 erase 的返回值,才既安全又不漏元素。
GCC 下这几类错误不一定当场崩,课件给了三组现象:
reserve(100)之后拿旧迭代器继续遍历,容量从 5 变成 100,旧空间已释放,打印出的是残留字节,程序不崩但结果全错。erase掉中间的元素后继续用旧迭代器,*it打出来是后一个元素的值(元素前移了),看起来“还能用”,实际上已经不受保护。erase掉最后一个元素后++it,迭代器越过end,元素个数为 5 的版本碰巧还能跑,换成 6 个就段错误。
同一个原因,不同表现:SGI STL 不做迭代器追踪,失效之后代码不一定崩,结果一定不可靠。std::string 同理,resize 触发扩容、insert、erase 之后旧迭代器都会失效;课件那段在循环里调用 s.erase(it) 却不接返回值的写法,崩溃是迟早的事。
memcpy 扩容搬走的是指针
课件让读者判断:手写的 vector 在 reserve 里用 memcpy 搬元素,往一个存 bit::string 的 vector 里 push_back 三次,会发生什么。
课件跟踪的是元素本身。bit::string 对象里也有 _str、_size、_capacity 三个字段,第一次 push_back("1111") 之后,这个元素的 _str 指向单独申请的 "1111" 缓冲。第二次插入时 vector 需要扩容,新空间申请好之后用 memcpy 把旧元素贴过去——贴过去的是 _str 这个指针的值,不是它指向的字符。
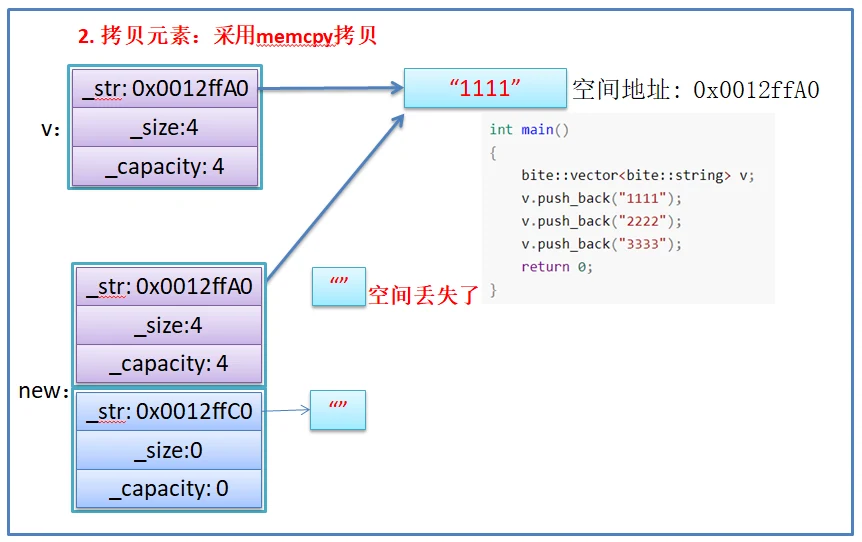
接着旧空间被释放,旧元素里的 _str 变成悬空指针;新空间里那份拷贝持有同样的地址,也跟着悬空。之后的 push_back("2222") 再往悬空指针写入,崩溃或数据错乱都在预期之内。
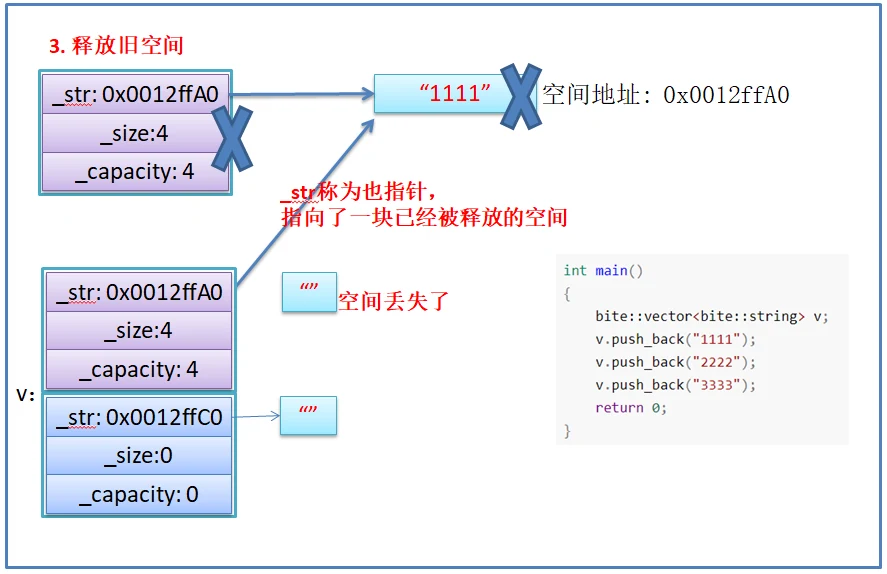
课件把原因写成“如果拷贝的是自定义类型元素并且涉及资源管理就会出错”,前一句又写“如果拷贝的是自定义类型的元素,memcpy 既高效又不会出错”,两句自相矛盾。判据不是“自定义”还是“标准库”,而是这个类型能不能按字节复制:
struct Point { int x; int y; };是自定义类型,没有资源要管理,memcpy完全安全,这类类型叫平凡可复制(trivially copyable)。std::string是标准库类型,内部持有堆指针,memcpy一定出错。
正确做法是在新空间上一一构造元素,再销毁旧元素,最后释放旧内存:
#include <cstddef>
#include <new>
#include <utility>

template <class T>
T* grow(T* old_start, std::size_t old_size, std::size_t new_cap)
{
    T* new_start = static_cast<T*>(::operator new(sizeof(T) * new_cap));

    for (std::size_t i = 0; i < old_size; ++i)
        new (new_start + i) T(std::move_if_noexcept(old_start[i]));

    for (std::size_t i = 0; i < old_size; ++i)
        old_start[i].~T();

    ::operator delete(old_start);
    return new_start;
}
这里有三处和 memcpy 不同:用定位 new 在裸内存上调用构造函数;用 std::move_if_noexcept 在“移动可能抛异常、拷贝更安全”时退回复制,保证搬到一半出错时源容器还完整;最后逐个调析构再还内存。真实实现还要在构造抛异常时回滚已经构造好的部分,这段最小版本省略了这一步。
vector 套 vector 就是二维数组
vector<vector<int>> 的外层每个元素本身又是一个 vector 对象,也就是三个指针。刚构造出来时,外层有 n 个元素,每个内层都是空 vector,三个指针全为空:
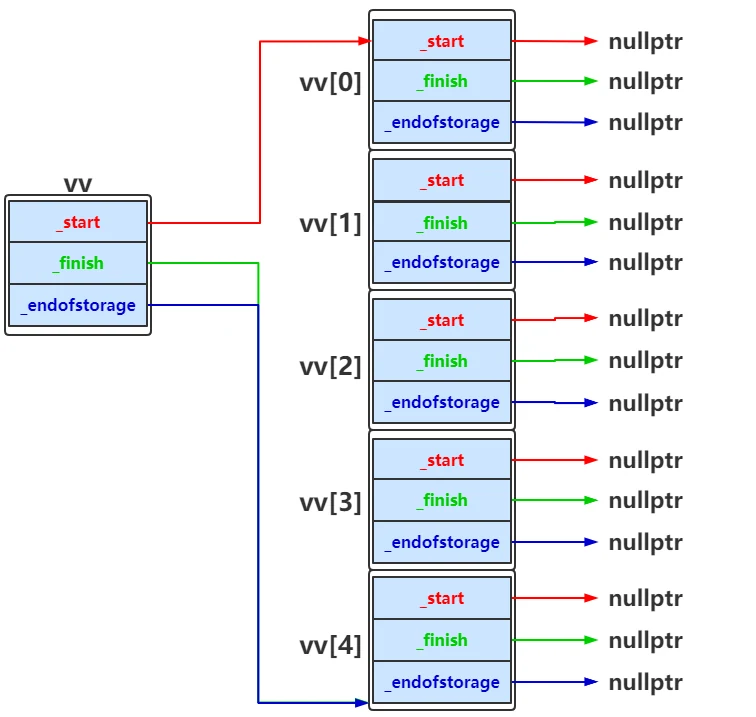
给每行 resize 之后,内层各自申请自己的缓冲,行长可以不同。杨辉三角就是这么写出来的:
#include <vector>

std::vector<std::vector<int>> generate(int numRows)
{
    std::vector<std::vector<int>> vv(numRows);

    for (int i = 0; i < numRows; ++i)
        vv[i].resize(i + 1, 1);

    for (int i = 2; i < numRows; ++i)
        for (int j = 1; j < i; ++j)
            vv[i][j] = vv[i - 1][j] + vv[i - 1][j - 1];

    return vv;
}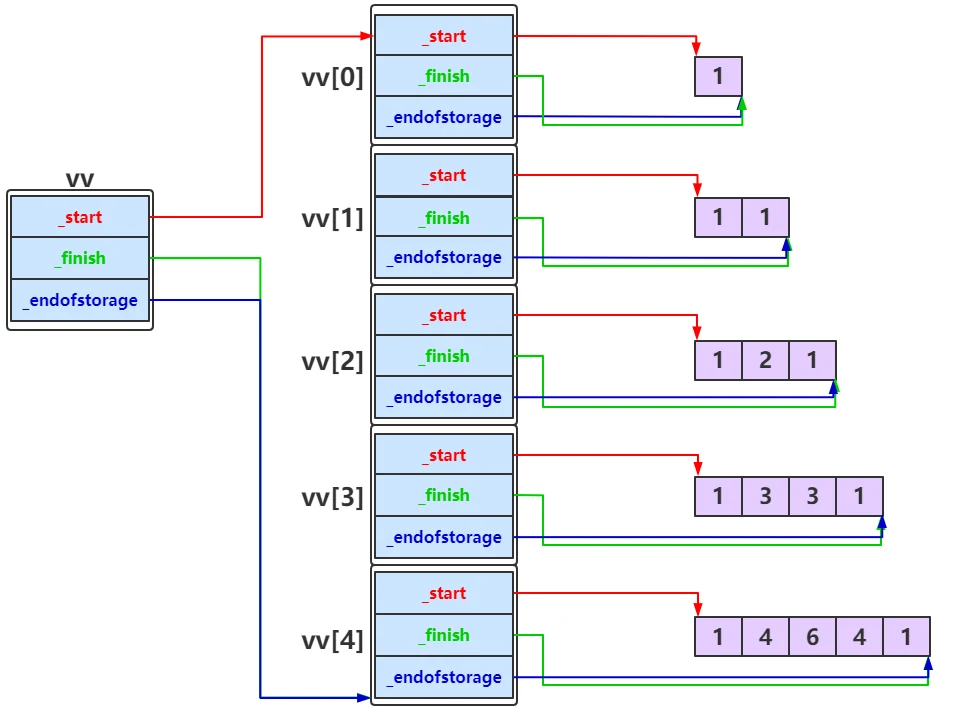
外层扩容时搬的是内层那三个指针,各行真正的数据一个字节都不用动,行与行之间也不会共享缓冲。如果外层也用 memcpy 搬,搬过去的三个指针会把每行的堆缓冲变成“有两个主人”,旧行释放后新行全悬空——和上一节 bit::string 的问题是同一个。
vector 用得最多的还是尾部追加和按下标遍历。课件总结里也提到这一点:遍历优先用 operator[] 或范围 for,插入集中在尾部,扩容交给 reserve,中间频繁增删就换容器。三根指针的模型记住之后,容量、失效、二维结构都能从同一处推导出来。
还没有评论 — 第一条由你来留。