数据量到 100GB 这个级别,内存就装不下了,搜索结构的选择标准也跟着换:不再看比较了多少次,而是看读了多少次盘。
课件开头列了五种常见搜索结构:
| 种类 | 对数据的要求 | 时间复杂度 |
|---|---|---|
| 顺序查找 | 无 | O(N) |
| 二分查找 | 有序、连续存放 | O(log₂N) |
| 二叉搜索树 | 无 | 平均 O(log₂N),退化时 O(N) |
| 二叉平衡树(AVL、红黑树) | 无 | O(log₂N) |
| 哈希 | 无 | 平均 O(1),冲突集中时退化 |
这几样都默认数据能一次性放进内存。放不下的时候,节点里只能保留关键字和“记录在磁盘上的地址”,真正的记录留在盘上,访问时先拿地址再去读盘。
二叉平衡树的问题正在这里:高度是 log₂N,内存里三十层不算什么,磁盘上就是三十次随机读。哈希看起来是 O(1),但冲突一集中访问次数就上去了,而且它天然无序,做不了范围查询。能走的路只有两条:把 IO 本身提速,或者把树压矮。SSD 比机械盘快很多,但没有改变“按页搬运”的基本模型;真正有效的是第二条,用多叉平衡树把扇出做大。
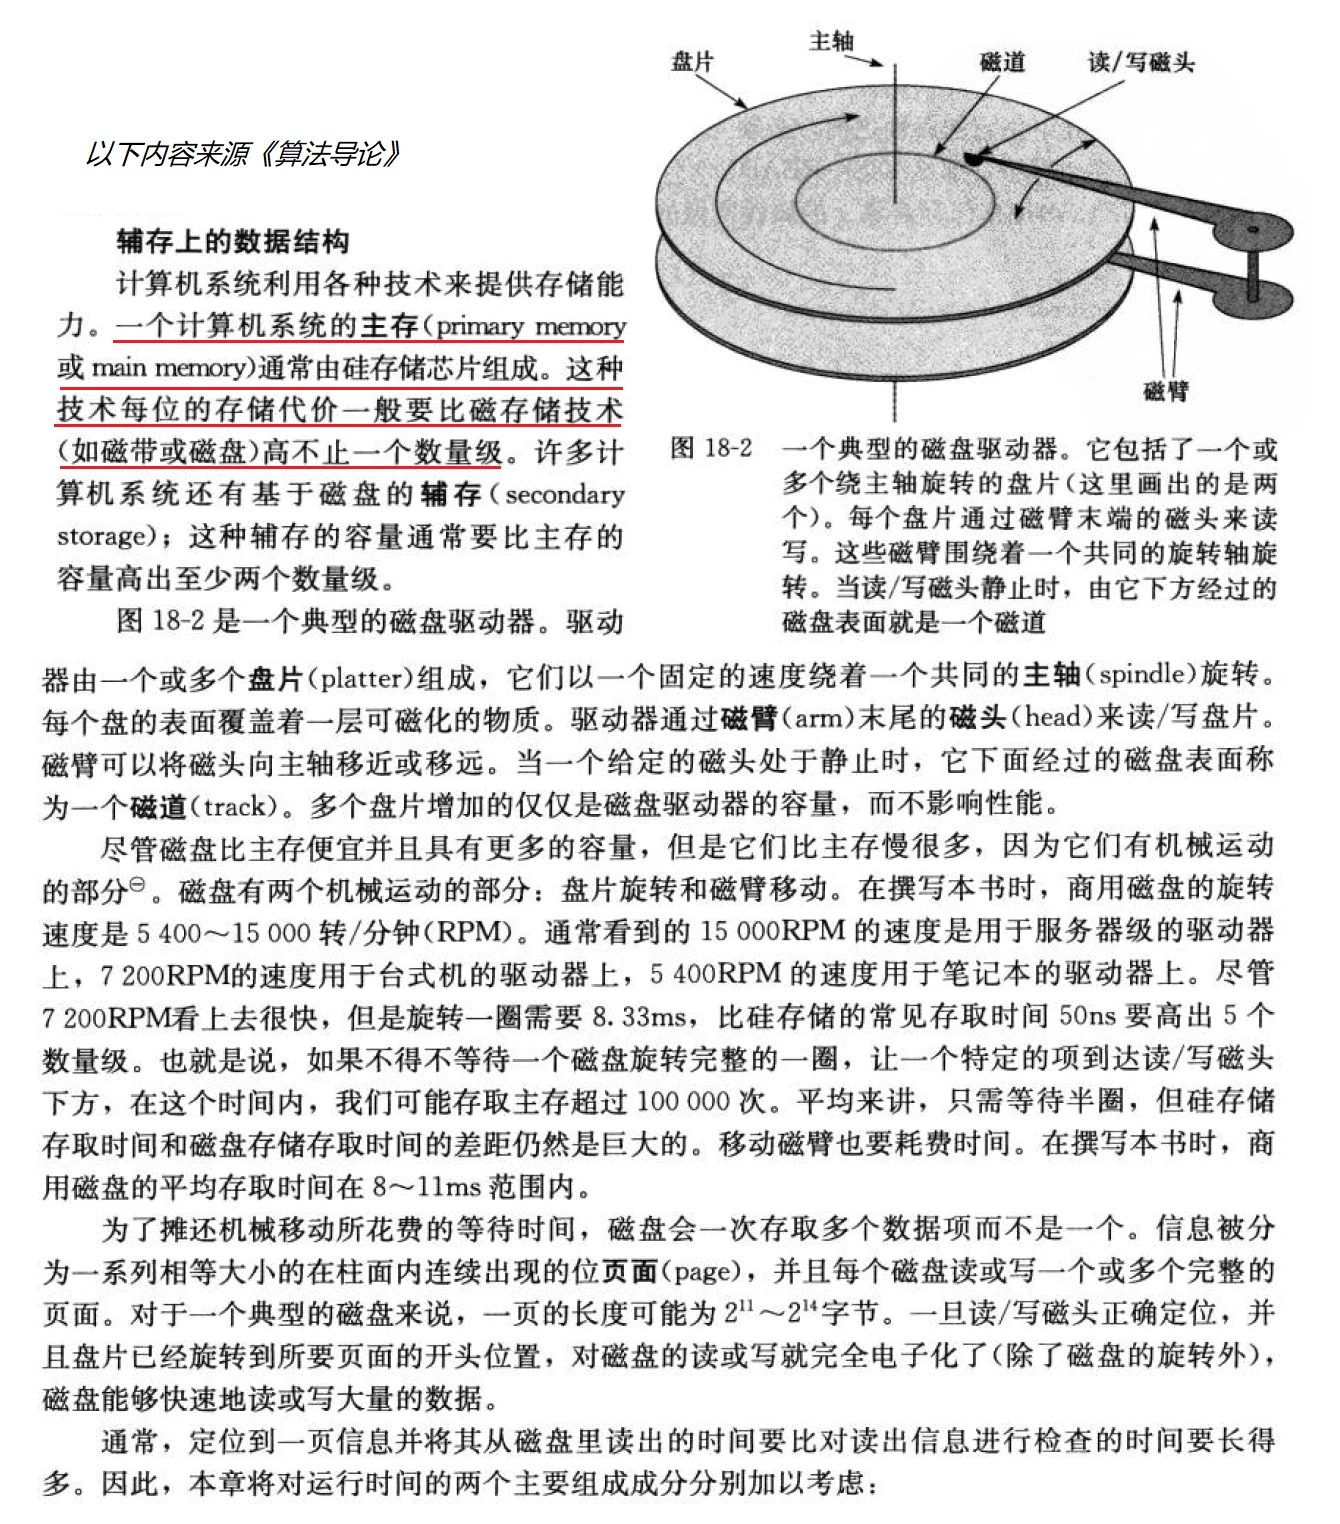
页是磁盘 IO 的最小单位,节点的大小就该跟页对齐。假设一页 16KB(InnoDB 的默认索引页大小),每个索引项是 8 字节关键字加 8 字节孩子指针,一页能放 16384 / 16 = 1024 项。十亿个键,按 1024 的扇出算,树高只有 log_1024(10⁹) ≈ 3.3,也就是四层左右。三十次读盘变成四次,差的不是常数,是能不能扛住每秒上千次查询。
阶 m:孩子最多 m 个,关键字最多 m−1 个
B 树(B-tree)是 1970 年 Bayer 和 McCreight 提出的多路平衡查找树,有些资料写成 B-树,那个连字符不是减号。一棵 m 阶(m > 2)B 树满足:
- 每个结点最多 m 个孩子、m−1 个关键字;非根分支结点至少有
ceil(m/2)个孩子,非根叶子没有孩子,只要求ceil(m/2)−1到m−1个关键字。 - 根结点至少 2 个孩子,除非它本身就是叶子。
- 所有叶子结点都在同一层。
- 结点内的关键字从小到大排列。
- 结点结构是
(n, A₀, K₁, A₁, K₂, A₂, …, Kₙ, Aₙ):n是关键字个数,Kᵢ是关键字,Aᵢ是指向子树根的指针。 Aᵢ所指子树里的键都落在Kᵢ与Kᵢ₊₁之间;A₀子树全小于K₁,Aₙ子树全大于Kₙ。
课件对这几条有三处要收紧。
一处是叶子结点的关键字数量。课件写的是“每个叶子节点都包含 k−1 个关键字,其中 ceil(m/2) ≤ k ≤ m”,可叶子没有孩子,k 这个“孩子数”根本不存在。正确的说法是:非根叶子至少 ceil(m/2)−1 个、至多 m−1 个关键字。m=3 时非根结点最少 1 个、最多 2 个关键字,所以插入到第 3 个键就超载,必须分裂。
另一处是关键字个数的下界。课件写“n 满足 ceil(m/2)−1 ≤ n ≤ m−1”,这个下界只对非根结点成立;根结点不受它约束,只要求 1 ≤ n ≤ m−1,允许只有 1 个关键字、2 个孩子。把根也按非根的下界管,一棵只有根的小树就成了“非法结构”。
性质 6 也不能只写一半。课件只说了“Aᵢ 所指子树的关键字均小于 Kᵢ₊₁”,漏了下界。少了“大于 Kᵢ”这一半,Aᵢ 子树里可以塞一个比 Kᵢ 还小的键;这个键本该在左边,查找从根按比较结果走就不会进入 Aᵢ,直接漏掉。完整的约束是 Aᵢ 子树落在 (Kᵢ, Kᵢ₊₁) 之间,两端缺哪边就只取另一边。
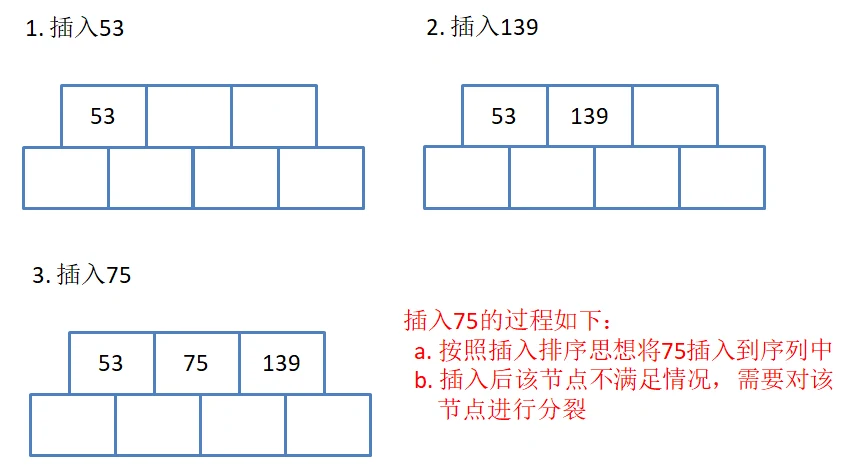
结点里“孩子永远比关键字多一个”,这是由值域划分决定的:n 个键把数轴切成 n+1 段,每段对应一个孩子。代码里关键字数组开 M 格而不是 M−1 格,是为了给插入留一格临时超载位:先塞进去、再检查、超了才分裂。
高度上下界可以直接从这两条数量关系推出来。设键总数为 N、高度为 h(层数):
- 装满时每层扇出 m,
N ≤ mʰ − 1,所以h ≥ log_m(N+1); - 最瘦时根两个孩子,其余结点至少
t = ceil(m/2)个孩子,N ≥ 2tʰ⁻¹ − 1,反解出h ≤ 1 + log_t((N+1)/2)。
课件在性能分析里写“每个结点的子节点个数为 M/2 到 M−1,因此高度在 log_{M−1}N 和 log_{M/2}N 之间”,这里的扇出上限和下限都偏了。上限是 m,不是 m−1——定义本身写的就是“最多 m 个孩子”;下限是向上取整的 ceil(m/2),不是 m/2。按课件的口径,3 阶树的结点最多两个孩子,“2-3 树”这个名字就矛盾了。正确的夹法是:
log_m(N+1) ≤ h ≤ 1 + log_{ceil(m/2)}((N+1)/2)
以 620 亿个键、m=1024 为例,按最瘦的扇出 512 算,log_512(6.2×10¹⁰) ≈ 4.0,四层左右的结点就够,一条查找路径只有几次页读。
插入只发生在叶子,超载一格就把中间键顶上去
插入的第一步是找到落点。每个结点内部从前往后比较,key 比当前关键字小就停在它左边,比它大就继续往右;比较完整个结点还没命中,就沿着第 i 个孩子往下走。落点一定是叶子:往分支结点塞一个键,会连带打乱孩子数量和值域划分,还要给它重新找分界键;叶子没有孩子,塞进去最干净。
结点结构与插入代码:
#include <cstddef>
#include <iostream>
#include <utility>

template<class K, int M = 3>
class BTree
{
    struct Node
    {
        K _keys[M];                 // 多开一格,容纳分裂前的临时超载
        Node* _sub[M + 1];          // 孩子比关键字多一个
        Node* _parent;
        size_t _size;

        Node() : _parent(nullptr), _size(0)
        {
            for (size_t i = 0; i <= M; ++i)
                _sub[i] = nullptr;
        }
    };

public:
    BTree() : _root(nullptr) {}
    ~BTree() { Destroy(_root); }

    bool Insert(const K& key)
    {
        if (!_root)
        {
            _root = new Node;
            _root->_keys[0] = key;
            _root->_size = 1;
            return true;
        }

        Node* cur = _root;
        while (true)                        // 先找到落点叶子
        {
            size_t i = 0;
            while (i < cur->_size && key > cur->_keys[i])
                ++i;
            if (i < cur->_size && key == cur->_keys[i])
                return false;               // 约定键唯一
            if (!cur->_sub[0])
                break;
            cur = cur->_sub[i];
        }

        K up = key;
        Node* right = nullptr;
        while (true)
        {
            InsertKey(cur, up, right);
            if (cur->_size < static_cast<size_t>(M))
                return true;

            const int mid = M / 2;
            up = cur->_keys[mid];           // 先保存中间键,再改 _size
            Node* fresh = new Node;
            for (size_t i = mid + 1; i < cur->_size; ++i)
            {
                fresh->_keys[fresh->_size] = cur->_keys[i];
                fresh->_sub[fresh->_size] = cur->_sub[i];
                if (cur->_sub[i])
                    cur->_sub[i]->_parent = fresh;
                ++fresh->_size;
            }
            fresh->_sub[fresh->_size] = cur->_sub[cur->_size];   // 孩子多搬一个
            if (cur->_sub[cur->_size])
                cur->_sub[cur->_size]->_parent = fresh;
            cur->_size = mid;               // 左半留 mid 个键

            if (cur == _root)
            {
                Node* r = new Node;
                r->_keys[0] = up;
                r->_sub[0] = cur;
                r->_sub[1] = fresh;
                r->_size = 1;
                cur->_parent = fresh->_parent = r;
                _root = r;
                return true;                // 分裂到根,树高加一,结束
            }
            right = fresh;                  // 否则把中间键和新结点继续插进双亲
            cur = cur->_parent;
        }
    }

    void InOrder() const
    {
        _InOrder(_root);
        std::cout << '\n';
    }

private:
    void InsertKey(Node* cur, const K& key, Node* sub)
    {
        int end = static_cast<int>(cur->_size) - 1;
        while (end >= 0 && key < cur->_keys[end])
        {
            cur->_keys[end + 1] = cur->_keys[end];
            cur->_sub[end + 2] = cur->_sub[end + 1];     // 孩子的错位比键晚一格
            --end;
        }
        cur->_keys[end + 1] = key;
        cur->_sub[end + 2] = sub;
        if (sub)
            sub->_parent = cur;
        ++cur->_size;
    }

    void _InOrder(Node* cur) const
    {
        if (!cur)
            return;
        for (size_t i = 0; i < cur->_size; ++i)
        {
            _InOrder(cur->_sub[i]);
            std::cout << cur->_keys[i] << ' ';
        }
        _InOrder(cur->_sub[cur->_size]);
    }

    void Destroy(Node* cur)
    {
        if (!cur)
            return;
        for (size_t i = 0; i <= cur->_size; ++i)
            Destroy(cur->_sub[i]);
        delete cur;
    }

    Node* _root;
};
InsertKey 里的两行移位不能写反:关键字右移一格后,它右边那个孩子的指针也要右移一格,落到 end+2,因为孩子数组整体比关键字数组多一个位置。
用课件那条序列 53、139、75、49、145、36、101 走一遍:
插 53、139:            [53 139]

插 75,结点三格占满:   [53 75 139] → 中间键 75 上提
                            [75]
                           /    \
                        [53]    [139]

插 49、145:                [75]
                           /    \
                     [49 53]    [139 145]

插 36,左叶三格占满:    [36 49 53] → 49 上提
                             [49 75]
                            /   |   \
                         [36] [53] [139 145]

插 101,右叶三格占满:  [101 139 145] → 139 上提,根也满了
                              [49 75 139] → 75 上提
                                   [75]
                                  /    \
                              [49]      [139]
                             /   \      /    \
                          [36]  [53] [101]  [145]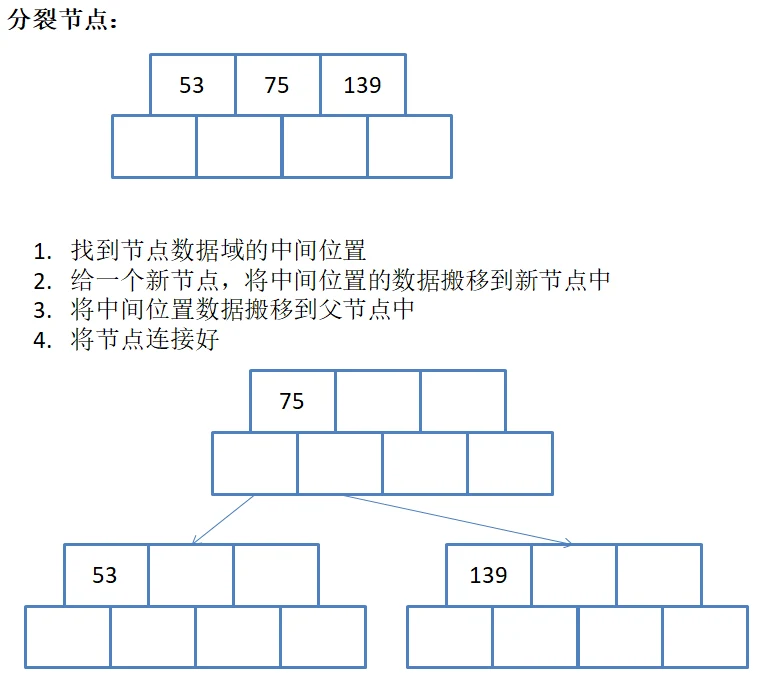
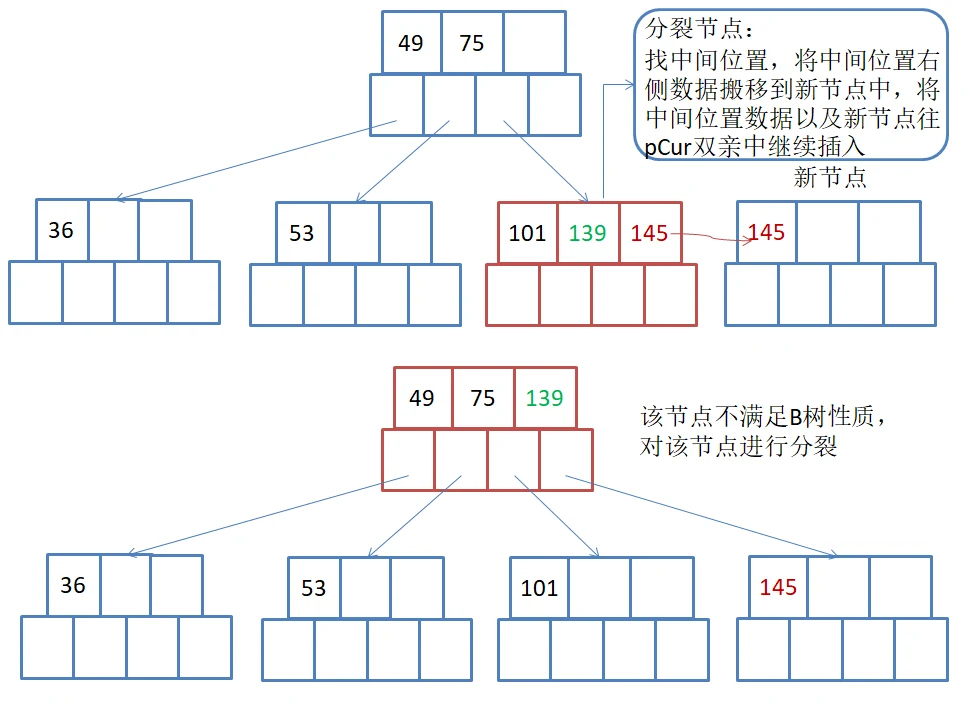
中序遍历打出来是 36 49 53 75 101 139 145,有序。但“中序有序”只是必要条件,它看不出叶子是否都在同一层,也看不出每个结点是否够半满。要验证结构,还得检查这两条。
课件的分裂代码有一处时序问题:它先执行 pCur->_size -= (temp->_size + 1),之后才在“分裂的是根”那条分支里读 pCur->_keys[mid]。此时 mid 已经落在有效范围之外,读到的是没被搬走的旧槽。它之所以能跑对,是因为搬移时没有清空原位置;如果换成会把多余槽位清零的调试版本,根里拿到的就是垃圾值。上面这段先把 up 存进局部变量,再收缩 _size,顺序就不依赖“旧槽还在”这个巧合。
删除:先向兄弟借一个键,借不到就合并
课件把删除留给《算法导论》,但删除的判定和插入是同一套数量关系,绕不开。非根结点至少有 ceil(m/2)−1 个关键字,低于这个数就叫下溢(underflow)。
从叶子删键分三种情况:
- 删完仍然不少于下限,直接删,结束。
- 删完下溢,但左右兄弟里有一个的关键字多于下限:向它借。通过双亲做一次旋转——双亲的分隔键下来填补空位,兄弟最靠边的键上去当新的分隔键。以 m=3 为例,结点只剩 0 个键、右兄弟有 2 个键时,双亲的分隔键移进来,兄弟最小的键移上去,两边仍然有序。
- 两个兄弟都只有下限个键:合并。把“左兄弟 + 双亲的分隔键 + 当前结点”并成一个结点,双亲少一个键和一个孩子。双亲如果因此下溢,就对双亲重复第 2、3 步;如果双亲是根且只剩 0 个键,就把它唯一的那个孩子提为新的根,树高减一。
从分支结点删键时,不能直接拿掉,否则值域划分会出现空洞。做法是用它的前驱或后继替换:前驱是左子树里最大的键,后继是右子树里最小的键,这两个键一定在叶子上。把叶子上的那个键搬上来,再按叶子的规则删掉它,问题就回到上面三种情况。
以 [49 75] 为根、孩子是 [36]、[53]、[139 145] 的树为例:
- 删 139(原始树):右叶剩
[145],仍然够下限,直接删。 - 删 53(原始树):
[53]变成空结点,右兄弟[139 145]有 2 个键,可以借。双亲的分隔键 75 下来,右兄弟最小的 139 上去,根变成[49 139],三个孩子是[36]、[75]、[145]。 - 在借完后的树上接着删 36:
[36]变成空结点,右兄弟[75]只有 1 个键(左边没有兄弟),只能合并。把空结点、双亲的分隔键 49、右兄弟[75]并成[49 75],根少掉 49,只剩[139],孩子变成[49 75]和[145]。根还有 1 个键,合法,树高没有变。
删除只在“合并”时会向上传染,和插入的分裂一样,路径长度受树高限制。
B+树:记录全部赶到叶子,再把叶子串起来
B 树的每个结点都可能命中,这带来两个副作用:查找路径长度不固定;分支结点里塞着真实数据,同样一页能放的分界键变少,扇出被压缩。B+树把这两件事拆开:
- 分支结点只留关键字做路标,不存记录;
- 所有关键字和记录都出现在叶子层,查找一定走到叶子;
- 叶子结点之间用指针串成有序链表。
课件列出的 B+ 规则里,两条最容易记混:分支结点的子树指针个数与关键字个数相同,p[i] 指向键值落在 [k[i], k[i+1]) 区间的子树;叶子之间增加链接指针,所有关键字及其映射数据都在叶子出现。于是 B+ 树有三个直接结果:叶子链表天然有序;分支结点永远不可能命中,命中只发生在叶子;分支层只是索引,叶子层才是数据层。
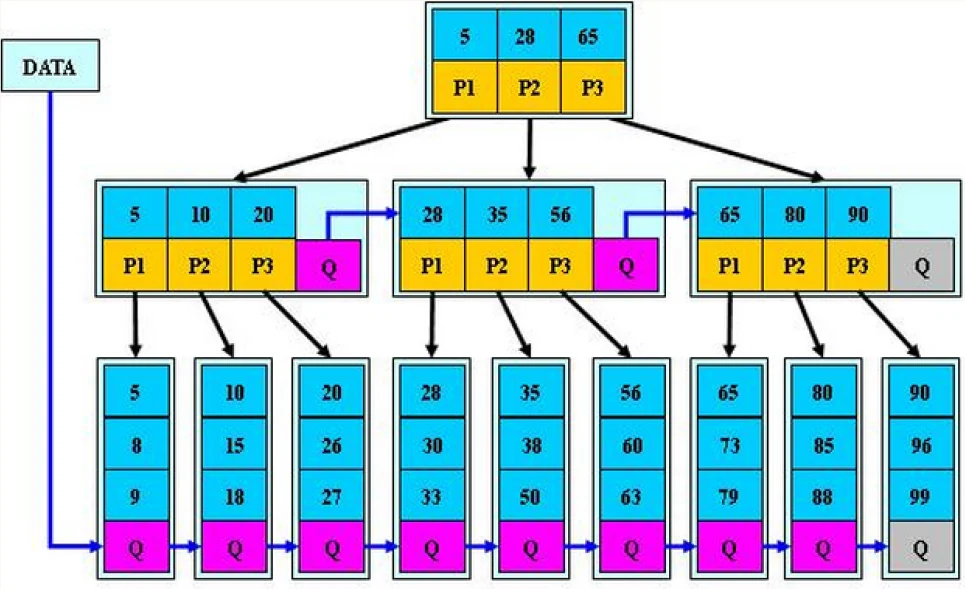
既然结果全在叶子、叶子又有序相连,范围查询就变成“定位一次,再顺着叶子链表扫”,不需要像 B 树那样在分支结点之间来回中序回溯。这是数据库索引选 B+树而不是 B 树的关键原因之一。
B*树是 B+树的变形,在非根、非叶结点上再加指向兄弟结点的指针。它的分裂策略也改了:结点满时,如果相邻兄弟还有空位,就把一部分数据挪到兄弟,再插入新键,并修改双亲里兄弟的分界键;兄弟也满了,才在原结点和兄弟之间新建一个结点,各复制三分之一的数据。分配新结点的概率因此比 B+树低,空间利用率更高。
| B 树 | B+树 | B*树 | |
|---|---|---|---|
| 记录位置 | 所有结点 | 只在叶子 | 只在叶子 |
| 查找终点 | 可能在分支命中 | 一定到叶子 | 一定到叶子 |
| 叶子链接 | 无 | 有 | 有 |
| 结点间兄弟指针 | 无 | 无 | 有(非根非叶) |
| 分裂方式 | 中间键上提,对半分裂 | 中间键上提,对半分裂 | 先看兄弟,必要时按 1/3 复制 |
| 典型用途 | 文件系统、部分内存索引 | 数据库索引 | 对空间利用率要求更高的索引 |
MySQL:索引归存储引擎管,聚簇与非聚簇差在叶子放什么
课件对索引的定义可以直接用:索引是帮助 MySQL 高效获取数据的数据结构。它属于存储引擎级别的概念,不同引擎实现方式不同,而且索引建在表上,不是建在数据库上。
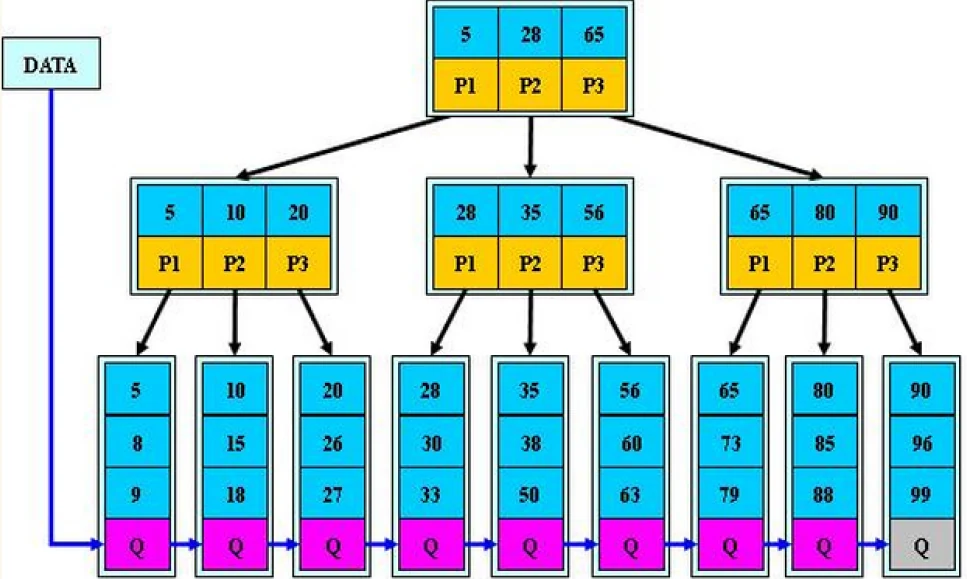
MyISAM 用 B+树,叶子结点的 data 域存的是数据记录的地址,不是整行记录。主索引和辅助索引在结构上完全一样,唯一差别是主索引的键必须唯一、辅助索引的键可以重复。查一条记录要两步:先在索引树里拿到地址,再去数据文件里读那一行。这种索引叫非聚集索引(non-clustered index)。
InnoDB 反过来:数据文件本身就是一棵按主键组织的 B+树,叶子结点的 data 域放的是完整记录,这棵树既是主索引也是数据文件,叫聚集索引(clustered index)。因为数据按主键聚集,InnoDB 要求表必须有主键;没有显式主键时,MySQL 会自动选一个能唯一标识记录的列,选不出来就生成一个 6 字节的隐藏长整型字段。
两种索引的差别也决定了辅助索引的查法。InnoDB 的辅助索引叶子存的是主键值,不是地址,所以查辅助索引要检索两遍:先拿到主键,再回主索引取整行,这一步叫回表。主键越短,每个辅助索引要复制的部分就越小,这也是“主键尽量短”的实际理由。
课件在这里有一处版本号要改:它写 MyISAM 是“MySQL 5.5.8 之前默认”,InnoDB“从 5.5.8 开始默认”。MySQL 5.5 官方手册的说法是 InnoDB 从 5.5.5 起成为默认存储引擎,5.5.8 是 5.5 系列的一个 GA 版本,不是切换点。结论不受影响,但版本数字最好对一遍官方文档。
回到开头那笔账:一棵索引树能压到几层,只取决于三个数——这台机器一次 IO 搬多少字节,一页能放几个键,总共多少个键。算完这三个数,为什么数据库用 B+树而不是二叉平衡树,就不用再背结论了。
还没有评论 — 第一条由你来留。