LeetCode 189 的朴素解法是每次把整个数组右移一格,重复 k 次。样例 n = 7、k = 3 时瞬间跑完;n = 300000、k = 299999 时,赋值次数接近 900 亿,提交一定超时。复杂度分析要做的,就是在这段代码还没跑之前,先判断它随 n 增长的速度。
void rotate(int* nums, int numsSize, int k)
{
    while (k--)
    {
        int end = nums[numsSize - 1];
        for (int i = numsSize - 1; i > 0; --i)
            nums[i] = nums[i - 1];
        nums[0] = end;
    }
}
执行次数 T(N) 替代秒表
直接测运行时间有三个躲不开的问题:同一份源码换编译器、换优化级别,指令条数会变;换机器,主频、缓存、内存带宽会变;程序得先写出来才能测,而写之前就要决定这个思路值不值得写。时间复杂度(time complexity)用一个函数 T(N) 数基本操作的执行次数,绕开了前两个问题。它假设每条指令的代价大致相同,次数翻倍,时间也按比例增长。这个假设并不严格,乘法比加法贵,访存比寄存器访问贵,但比较的是增长趋势,不是某条指令的纳秒数。
#include <stdio.h>

void Func1(int N)
{
    int count = 0;

    for (int i = 0; i < N; ++i)
        for (int j = 0; j < N; ++j)
            ++count;              /* N² 次 */

    for (int k = 0; k < 2 * N; ++k)
        ++count;                  /* 2N 次 */

    int M = 10;
    while (M--)
        ++count;                  /* 10 次,与 N 无关 */

    printf("%d\n", count);
}
++count 的总次数是 T(N) = N² + 2N + 10。N = 10 时是 130,N = 100 时是 10210,N = 1000 时是 1002010。第三组里 N² 占了一百万,另外两项加起来才 2010。N 越大,低阶项和常数越会被最高阶项遮住。
大 O 符号(Big O notation)描述的就是这个“遮住”的过程。严格定义是:存在正常数 C 和 n0,使得 n ≥ n0 时 |f(n)| ≤ C·|g(n)|,记作 f(n) = O(g(n))。翻译过来,从某个规模开始,f 永远被 g 的某个常数倍压住。所以大 O 给出的是上界,O(N²) 的意思是“不会比平方级更差”,不排除它其实只有 O(N),只是这个上界不够紧。
课件的三条化简规则可以直接从定义推出来:只留最高阶项,因为低阶项除以最高阶项会趋于零,可以被常数 C 吞掉;去掉最高阶项的系数,因为 C 本来就可以任意大;只有常数项时记作 O(1),取 g = 1、C = 100 就成立。规则是方便手算的口诀,不是新的定义。
常见阶在 n 变大时的排序
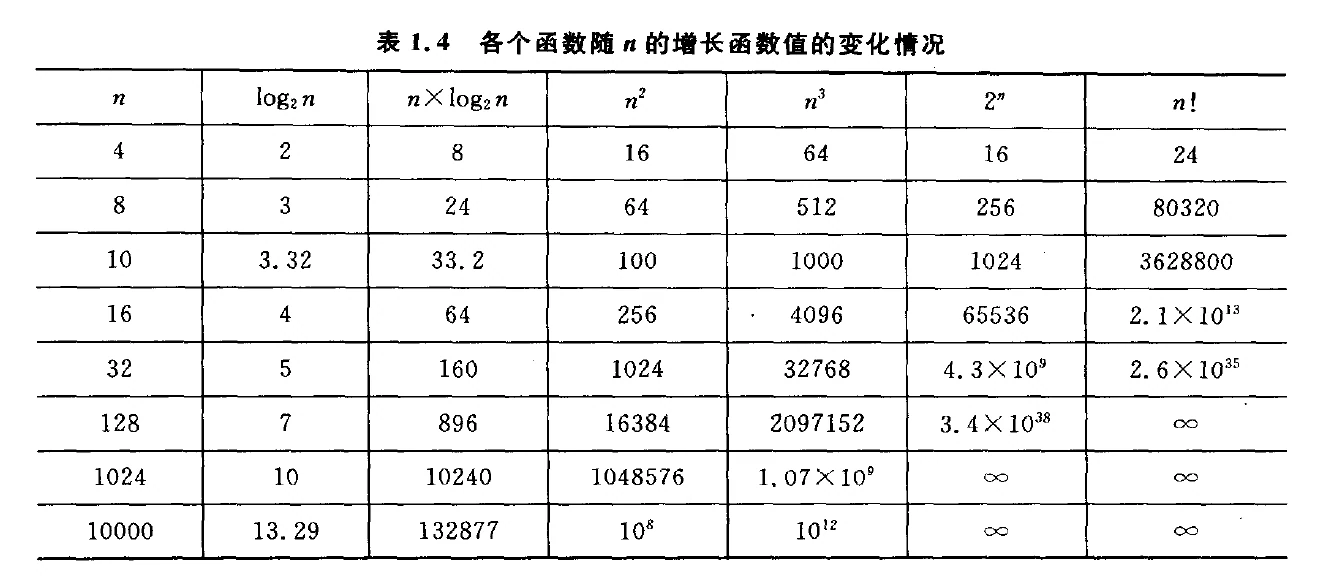
按增长速度从慢到快排:O(1)、O(log n)、O(n)、O(n log n)、O(n²)、O(n³)、O(2ⁿ)、O(n!)。O(1) 表示执行次数与 n 无关;O(log n) 通常来自每次把问题规模折半,或者循环变量每次翻倍;O(n log n) 常见于每层做 O(n) 工作、一共 log n 层;O(2ⁿ) 和 O(n!) 出现在枚举子集、全排列这类组合问题里。
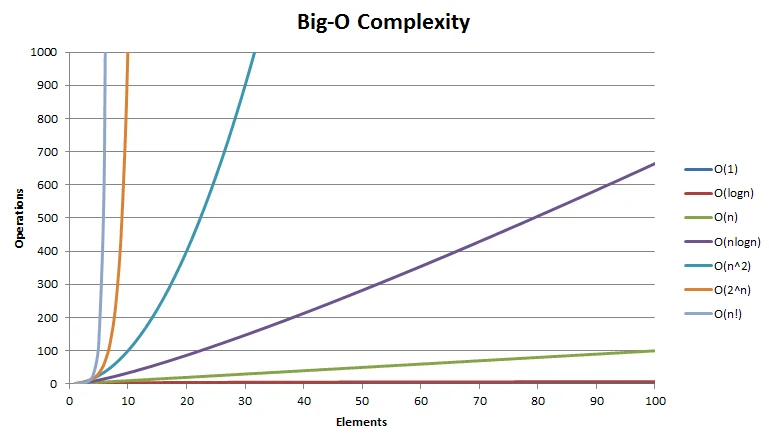
对数底数在复杂度里不写。log₂n、ln n、lg n 只差一个常数倍:log_a n = log_b n / log_b a,换底只改变系数,不改变量级。教材里三种写法都有,统一记作 log n 即可。
把表里的数字放进具体规模:n = 1024 时 log₂n = 10,n×log₂n = 10240,n² = 1048576,n³ ≈ 1.07×10⁹,2ⁿ 和 n! 已经超出可写范围。n = 10000 时 log₂n ≈ 13.29,n×log₂n ≈ 132877,n² = 10⁸,n³ = 10¹²。这些数字决定了一个思路在评测机上能不能活下来:一秒大约能跑一亿次简单操作,O(n²) 在 n = 10 万时就是 100 亿次。
最好、平均、最坏不是三个复杂度记号
同一个函数,输入不同,执行次数也不同。strchr 找字符:
#include <stddef.h>

const char* MyStrchr(const char* str, int character)
{
    const char* p = str;

    while (*p != character)
    {
        if (*p == '\0')
            return NULL;
        ++p;
    }
    return p;
}要找的字符在第一位,比较一次就结束,O(1);在末位或者根本不存在,要走完整个串,O(N);随机位置,平均走一半,仍是 O(N)。课件这段代码写的是 const char* p_begin = s;,形参名却是 str,s 没有定义,原样编译会报未声明标识符;改成 str 才能通过。
三种情况的定义各不相同:
- 最坏情况:同一规模的所有输入里,执行次数最多的那一个,给出上界。
- 平均情况:按某种输入分布取期望,必须先说明分布假设。
- 最好情况:同一规模的所有输入里,执行次数最少的那个。
课件把最好情况标成“下界”,这里混了两个概念。最好情况是某类输入下的最少执行次数;渐近下界是 Ω 记号描述的东西。大 O 本身是上界,Ω 是下界,Θ 是上下界同阶。工程上默认看最坏情况,因为性能保证关心的是“输入再差,也不会慢过这个量级”。
课件在几个示例的编号和结论上也串了行。Func3(int N, int M) 同时有两个规模,结论应是 O(M + N),课件写成了 O(N),把 M 丢了;如果题目另有 M 是常数的前提,才应该化简成 O(N)。Func4 只有一个 100 次的循环,是 O(1),课件把结论标成了“Func2”,又写成“根据推导规则第1条”,实际用的是第3条(只有常数项)。这类编号错误不影响答案,复习时却容易把三条规则记串。
递归的时间看调用次数,空间看同一时刻
long long Fac(size_t N)
{
    if (N == 0)
        return 1;
    return Fac(N - 1) * N;
}
时间上是 Fac(N) 一路调到 Fac(0),一共 N + 1 次调用,O(N)。空间上,Fac(0) 返回之前,N + 1 个栈帧同时压在栈上,也是 O(N)。课件写“递归调用了 N 次,额外开辟了 N 个函数栈帧”,少算了一个:Fac(0) 那个帧真实存在,只是它最先返回。
空间复杂度(space complexity)记的是运行过程中的额外空间峰值,不是累计总量。循环里 malloc 一次、立刻 free,峰值仍然只有一块,空间是 O(1);递归里每一层都没返回,峰值就是递归深度。课件说“空间复杂度算的是变量的个数”,这句话只在变量个数与 n 无关时成立。开一个长度为 n 的数组,结构体里仍然只有指针、size、capacity 三个变量,额外空间却是 O(n)。
冒泡排序只用了 exchange 等有限个局部变量,空间 O(1)。它的时间要看输入:已经有序时,一趟比较完就退出;完全逆序时,每一趟都要把当前最大值换到末尾。
冒泡与对数循环:课件里的两个次数写错了
void BubbleSort(int* a, int n)
{
    for (int end = n; end > 0; --end)
    {
        int exchange = 0;
        for (int i = 1; i < end; ++i)
        {
            if (a[i - 1] > a[i])
            {
                int t = a[i - 1];
                a[i - 1] = a[i];
                a[i] = t;
                exchange = 1;
            }
        }
        if (exchange == 0)
            break;
    }
}
课件在冒泡排序旁写了两组次数:数组有序时 T(N) = N,有序且为降序时 T(N) = N×(N+1)/2。两处都不对。有序且升序时,第一趟做 n - 1 次比较,exchange 保持 0,第二趟开始前就退出,次数是 n - 1,不是 n;完全逆序时,比较次数是 (n - 1) + (n - 2) + … + 1 = n(n - 1)/2,不是 n(n + 1)/2。另外“有序且为降序”这个说法自相矛盾,准确说法是“完全逆序”。课件在这里还残留了一句“若要查找的字符在字符串中间位置”,是从 strchr 那一题复制过来的,与冒泡无关。
void func5(int n)
{
    int cnt = 1;
    while (cnt < n)
        cnt *= 2;
}
cnt 按 1、2、4、8 增长,执行 x 次后 2^x ≥ n,所以 x = ceil(log₂n),复杂度 O(log n)。n = 2 时一次,n = 4 时两次,n = 16 时四次,和课件给的数据一致。这个循环没有依赖输入的分支,不存在“取最差情况”这回事,课件那句“取最差情况”是从上一题顺手抄下来的。
旋转数组的三种空间
回到开头。第一版加上 k %= numsSize,最坏仍是 O(n²),n = 30 万时照样过不去。
第二版拿空间换时间:开一块新数组,每个元素一步放到下标 (i + k) % n,再整体拷回。时间 O(n),空间 O(n)。课件写的是 int newArr[numsSize];,这是变长数组(VLA)。C11 起 VLA 是可选特性,实现可以定义 __STDC_NO_VLA__ 不支持;按常见实现它落在栈上,n 到几十万时栈直接爆。工程代码改用 malloc:
#include <stdlib.h>

void rotate(int* nums, int numsSize, int k)
{
    if (numsSize <= 1)
        return;

    k %= numsSize;
    int* newArr = (int*)malloc(sizeof(int) * (size_t)numsSize);
    if (newArr == NULL)
        return;

    for (int i = 0; i < numsSize; ++i)
        newArr[(i + k) % numsSize] = nums[i];
    for (int i = 0; i < numsSize; ++i)
        nums[i] = newArr[i];

    free(newArr);
}
第三版原地三段逆置,空间 O(1):
static void reverse_range(int* nums, int begin, int end)
{
    while (begin < end)
    {
        int t = nums[begin];
        nums[begin] = nums[end];
        nums[end] = t;
        ++begin;
        --end;
    }
}

void rotate(int* nums, int numsSize, int k)
{
    if (numsSize <= 1)
        return;

    k %= numsSize;
    reverse_range(nums, 0, numsSize - k - 1);
    reverse_range(nums, numsSize - k, numsSize - 1);
    reverse_range(nums, 0, numsSize - 1);
}
把数组看成 A | B,A 是前 n-k 个,B 是后 k 个,目标是 B | A。逆置有性质 reverse(A|B) = reverse(B) | reverse(A),两段各自翻一次得 A' | B',整体再翻就是 (A'|B')' = B | A。三段加起来扫过 2n 个元素,O(n) 时间,常数个下标,O(1) 空间。
三版对照:第一版最坏 O(n²);第二版 O(n) 时间、O(n) 空间;第三版两头都省。复杂度分析的价值就在这儿,代码还没提交,就能知道哪一版会挂在评测机上。
还没有评论 — 第一条由你来留。