顺序表(sequential list)和链表(linked list)解决同一个问题:把 n 个同类型元素按逻辑顺序存起来。区别在物理布局。顺序表把元素挨着放,靠下标算地址;链表把每个元素单独放,结点里存下一个结点的地址。布局决定了谁能随机访问、谁插入便宜、谁更吃缓存。
顺序表是数组加一条有效长度
线性表(linear list)是 n 个具有相同特性的数据元素的有限序列,逻辑上是一条线。物理上可以用连续内存,也可以用链式结构。顺序表选择连续内存:用一段物理地址连续的存储单元依次存放元素,底层就是数组。
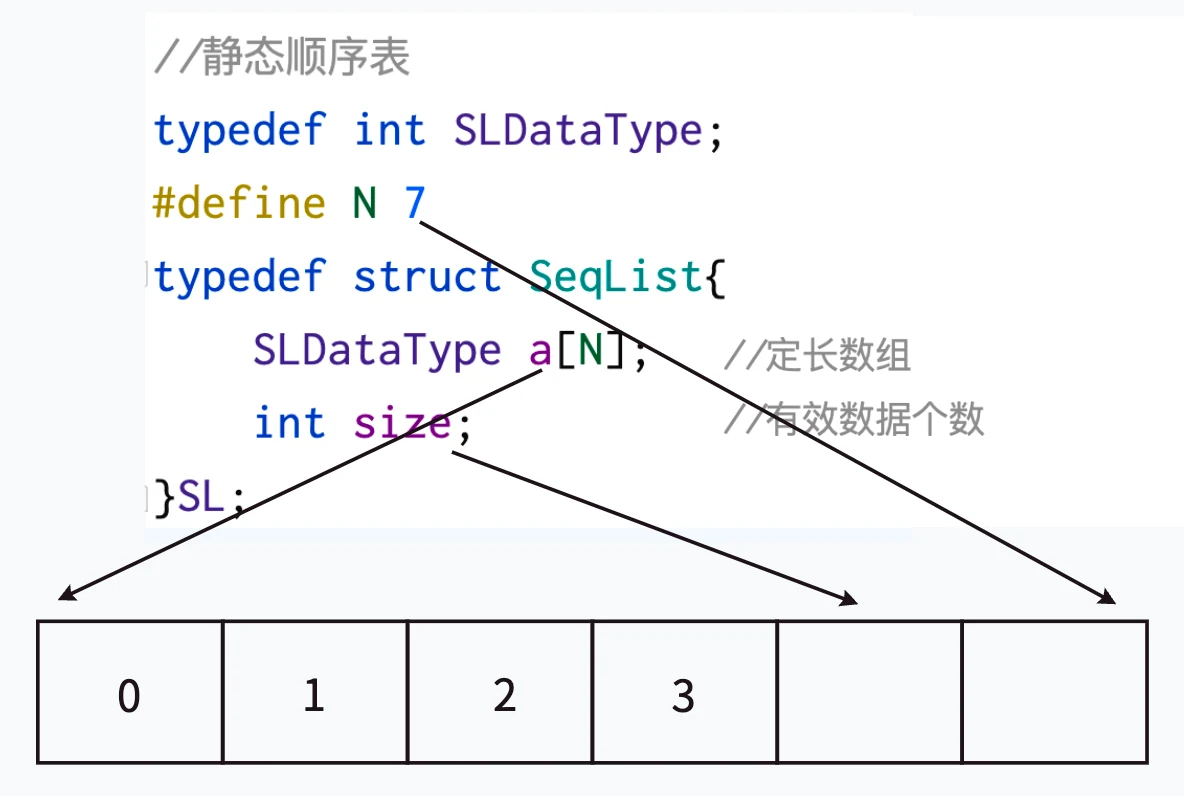
顺序表和数组的区别不在“更长”,而在顺序表给数组加了一层封装:用 size 划出有效数据,用 capacity 划出容量,再提供增删改查接口。静态顺序表把长度写死,给少了不够用,给多了浪费;动态顺序表按需申请。
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <assert.h>

typedef int SLDataType;

typedef struct SeqList
{
    SLDataType* a;
    int size;       /* 有效数据个数 */
    int capacity;   /* 空间容量 */
} SL;

void SLInit(SL* ps)
{
    assert(ps != NULL);
    ps->a = NULL;
    ps->size = 0;
    ps->capacity = 0;
}

void SLDestroy(SL* ps)
{
    assert(ps != NULL);
    free(ps->a);
    ps->a = NULL;
    ps->size = 0;
    ps->capacity = 0;
}

static int SLCheckCapacity(SL* ps, int need)
{
    if (ps->size + need <= ps->capacity)
        return 1;

    int newcap = ps->capacity == 0 ? 4 : ps->capacity * 2;
    while (newcap < ps->size + need)
        newcap *= 2;

    SLDataType* tmp = (SLDataType*)realloc(ps->a, sizeof(SLDataType) * (size_t)newcap);
    if (tmp == NULL)
        return 0;

    ps->a = tmp;
    ps->capacity = newcap;
    return 1;
}

int SLPushBack(SL* ps, SLDataType x)
{
    if (!SLCheckCapacity(ps, 1))
        return 0;
    ps->a[ps->size++] = x;
    return 1;
}

int SLPushFront(SL* ps, SLDataType x)
{
    if (!SLCheckCapacity(ps, 1))
        return 0;
    memmove(ps->a + 1, ps->a, sizeof(SLDataType) * (size_t)ps->size);
    ps->a[0] = x;
    ++ps->size;
    return 1;
}

int SLPopBack(SL* ps)
{
    if (ps->size == 0)
        return 0;
    --ps->size;
    return 1;
}

int SLPopFront(SL* ps)
{
    if (ps->size == 0)
        return 0;
    memmove(ps->a, ps->a + 1, sizeof(SLDataType) * (size_t)(ps->size - 1));
    --ps->size;
    return 1;
}

int SLInsert(SL* ps, int pos, SLDataType x)
{
    if (pos < 0 || pos > ps->size)
        return 0;
    if (!SLCheckCapacity(ps, 1))
        return 0;

    memmove(ps->a + pos + 1, ps->a + pos,
            sizeof(SLDataType) * (size_t)(ps->size - pos));
    ps->a[pos] = x;
    ++ps->size;
    return 1;
}

int SLErase(SL* ps, int pos)
{
    if (pos < 0 || pos >= ps->size)
        return 0;

    memmove(ps->a + pos, ps->a + pos + 1,
            sizeof(SLDataType) * (size_t)(ps->size - pos - 1));
    --ps->size;
    return 1;
}

int SLFind(const SL* ps, SLDataType x)
{
    for (int i = 0; i < ps->size; ++i)
        if (ps->a[i] == x)
            return i;
    return -1;
}

void SLPrint(const SL* ps)
{
    for (int i = 0; i < ps->size; ++i)
        printf("%d ", ps->a[i]);
    printf("\n");
}
realloc 失败时返回空指针,原来那块内存不会被释放。所以不能写 ps->a = realloc(ps->a, sizeof(SLDataType) * (size_t)newcap);:失败时旧地址丢了,新块也没拿到,泄漏和空指针解引用一起出现。先用 tmp 接返回值,成功后再赋回 ps->a。
头部和中间插入要搬元素,O(N);尾部插入只写一个位置,均摊 O(1)。扩容一次要搬 size 个元素,按 2 倍增长时,扩容总搬运量是 1 + 2 + 4 + … + n/2 < n,均摊到每次插入仍是常数。按每次加 1 增长,总搬运量是 1 + 2 + … + n,平方级。代价是空间:容量 100 扩到 200,只再插 5 个数据就用满了,剩下 95 格空着。
头部插入用 memmove 而不是 memcpy。源区间 [a, a+size) 和目标区间 [a+1, a+size+1) 重叠,memcpy 要求两块区域不重叠,重叠时行为未定义;memmove 允许重叠,效果等同于先拷进临时数组再拷回来。
单链表(singly linked list):结点自己保存下一站
链表在物理上不连续,数据元素的逻辑顺序由指针链接次序实现。每个结点独立申请,里面放数据和下一个结点的地址:
typedef int SLTDataType;

typedef struct SListNode
{
    SLTDataType data;
    struct SListNode* next;
} SLTNode;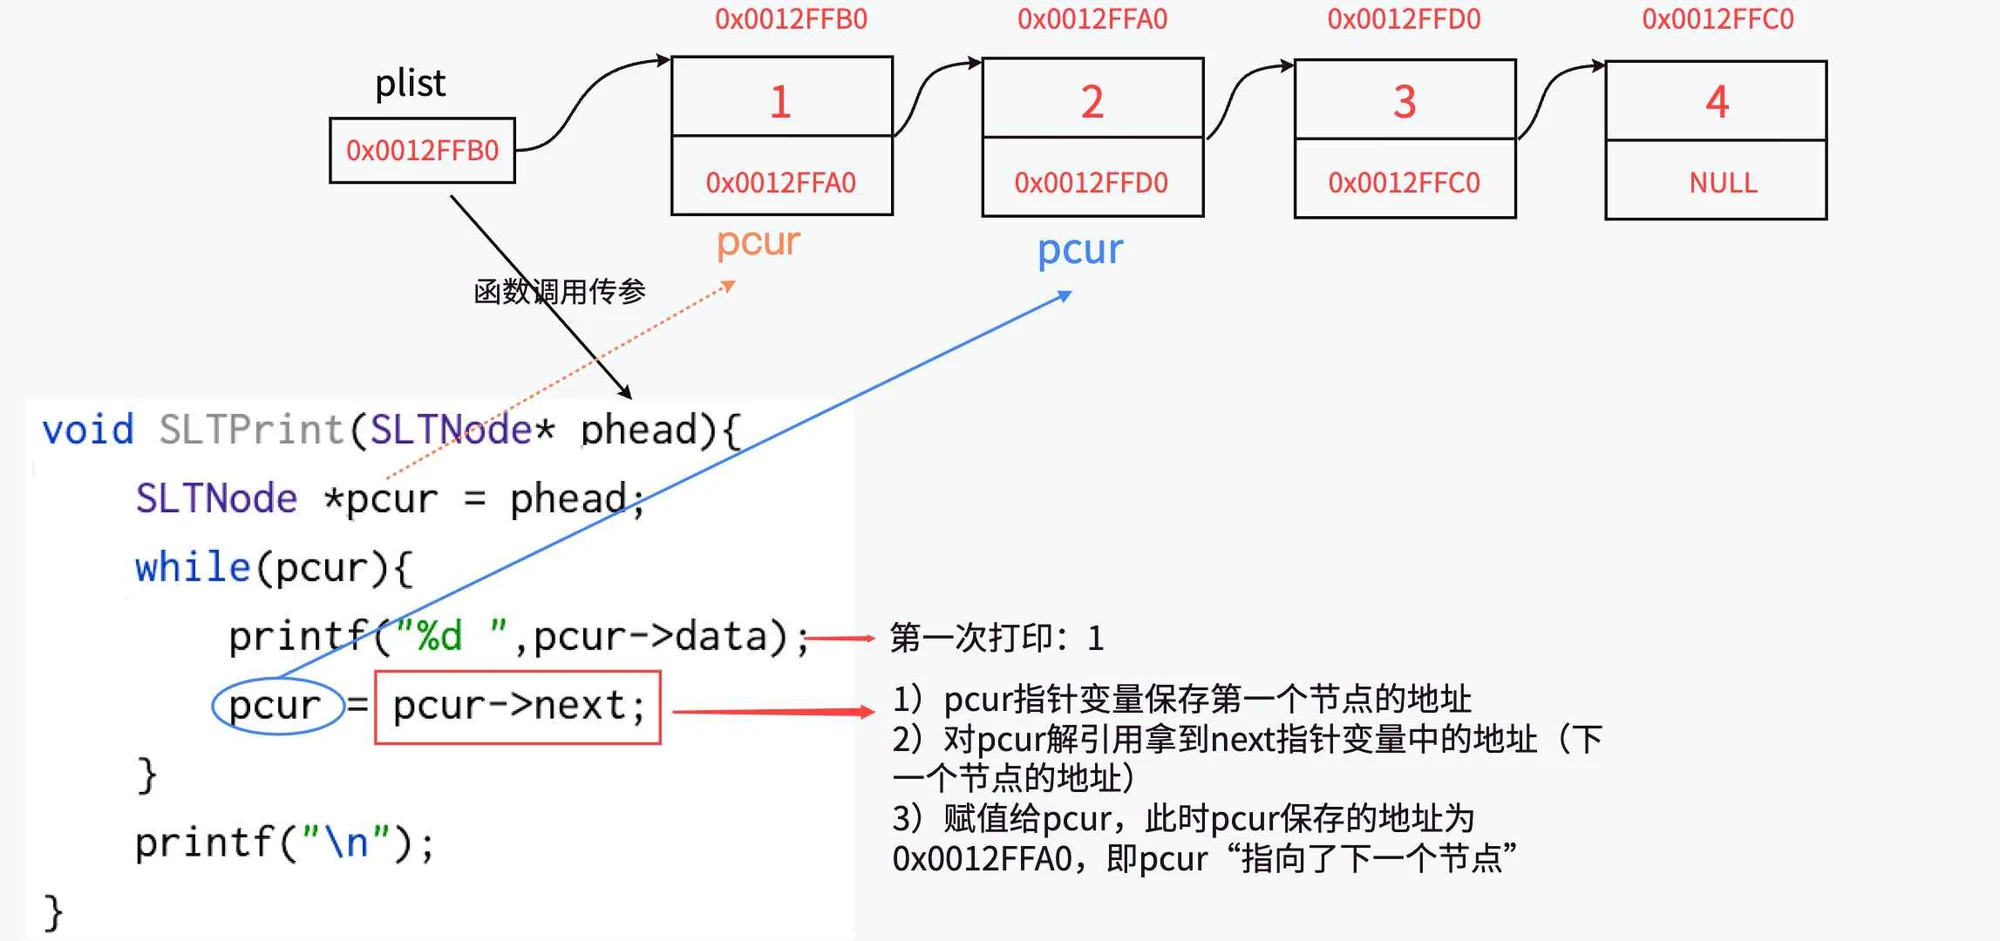
plist 保存第一个结点的地址,叫它“指向”第一个结点。想前进到下一个结点,读当前结点的 next 就行。最后一个结点的 next 是 NULL,遍历靠它停。下面这组接口覆盖头尾插入删除、查找、指定位置插入删除和销毁:
#include <stdio.h>
#include <stdlib.h>
#include <assert.h>

SLTNode* SLTNewNode(SLTDataType x)
{
    SLTNode* newnode = (SLTNode*)malloc(sizeof(SLTNode));
    if (newnode == NULL)
        return NULL;
    newnode->data = x;
    newnode->next = NULL;
    return newnode;
}

void SLTPrint(const SLTNode* phead)
{
    for (const SLTNode* pcur = phead; pcur != NULL; pcur = pcur->next)
        printf("%d->", pcur->data);
    printf("NULL\n");
}

int SLTPushFront(SLTNode** pphead, SLTDataType x)
{
    SLTNode* newnode = SLTNewNode(x);
    if (newnode == NULL)
        return 0;
    newnode->next = *pphead;
    *pphead = newnode;
    return 1;
}

int SLTPushBack(SLTNode** pphead, SLTDataType x)
{
    SLTNode* newnode = SLTNewNode(x);
    if (newnode == NULL)
        return 0;

    if (*pphead == NULL)
    {
        *pphead = newnode;
        return 1;
    }

    SLTNode* tail = *pphead;
    while (tail->next != NULL)
        tail = tail->next;
    tail->next = newnode;
    return 1;
}

int SLTPopFront(SLTNode** pphead)
{
    if (*pphead == NULL)
        return 0;
    SLTNode* next = (*pphead)->next;
    free(*pphead);
    *pphead = next;
    return 1;
}

int SLTPopBack(SLTNode** pphead)
{
    if (*pphead == NULL)
        return 0;

    if ((*pphead)->next == NULL)
    {
        free(*pphead);
        *pphead = NULL;
        return 1;
    }

    SLTNode* prev = *pphead;
    while (prev->next->next != NULL)
        prev = prev->next;
    free(prev->next);
    prev->next = NULL;
    return 1;
}

SLTNode* SLTFind(SLTNode* phead, SLTDataType x)
{
    for (SLTNode* pcur = phead; pcur != NULL; pcur = pcur->next)
        if (pcur->data == x)
            return pcur;
    return NULL;
}

int SLTInsert(SLTNode** pphead, SLTNode* pos, SLTDataType x)
{
    if (pos == NULL)
        return 0;
    if (*pphead == pos)
        return SLTPushFront(pphead, x);

    SLTNode* prev = *pphead;
    while (prev != NULL && prev->next != pos)
        prev = prev->next;
    if (prev == NULL)
        return 0;

    SLTNode* newnode = SLTNewNode(x);
    if (newnode == NULL)
        return 0;
    newnode->next = pos;
    prev->next = newnode;
    return 1;
}

int SLTErase(SLTNode** pphead, SLTNode* pos)
{
    if (pos == NULL || *pphead == NULL)
        return 0;
    if (*pphead == pos)
        return SLTPopFront(pphead);

    SLTNode* prev = *pphead;
    while (prev != NULL && prev->next != pos)
        prev = prev->next;
    if (prev == NULL)
        return 0;

    prev->next = pos->next;
    free(pos);
    return 1;
}

int SLTInsertAfter(SLTNode* pos, SLTDataType x)
{
    if (pos == NULL)
        return 0;
    SLTNode* newnode = SLTNewNode(x);
    if (newnode == NULL)
        return 0;
    newnode->next = pos->next;
    pos->next = newnode;
    return 1;
}

int SLTEraseAfter(SLTNode* pos)
{
    if (pos == NULL || pos->next == NULL)
        return 0;
    SLTNode* next = pos->next;
    pos->next = next->next;
    free(next);
    return 1;
}

void SLTDestroy(SLTNode** pphead)
{
    SLTNode* pcur = *pphead;
    while (pcur != NULL)
    {
        SLTNode* next = pcur->next;
        free(pcur);
        pcur = next;
    }
    *pphead = NULL;
}单链表的代价从接口签名就能看出来。SLTPushFront、SLTPopFront 只动头指针,O(1);SLTPushBack 没有尾指针,要从头走到尾,O(N);SLTPopBack 要找到尾结点的前驱,也是 O(N)。SLTInsertAfter 已经拿到 pos,只需改两个指针,O(1);SLTInsert 要插在 pos 之前,仍得从头找前驱,O(N)。想在尾部 O(1) 删除,单链表做不到,因为结点里没有指向前驱的指针,这也是双向链表存在的理由。
会改头指针的函数收二级指针
头指针本身是一个变量。函数按值接收 SLTNode* 时,参数是头指针的副本,函数里改它不影响调用者。下面这个头删只改副本:
/* 错误版本:只传一级指针 */
int SLTPopFrontWrong(SLTNode* phead)
{
    if (phead == NULL)
        return 0;
    SLTNode* next = phead->next;
    free(phead);
    phead = next;        /* 调用者手里的头指针没变 */
    return 1;
}
free(phead) 把结点还给了分配器,phead = next 只让局部副本指向下一个结点;调用者的头指针仍指向已经释放的地址。下一次访问或插入就踩到悬垂指针。正确做法是传 SLTNode**,用 *pphead 改调用者的变量:
int SLTPopFront(SLTNode** pphead)
{
    if (*pphead == NULL)
        return 0;
    SLTNode* next = (*pphead)->next;
    free(*pphead);
    *pphead = next;
    return 1;
}
规矩是:会改头指针的函数传 SLTNode**,只读或只改结点内部指针的函数传 SLTNode*。SLTPrint、SLTFind 不需要改头指针,一级就够;SLTPushFront、SLTPopFront、SLTPushBack、SLTPopBack、SLTInsert、SLTErase、SLTDestroy 都可能改头指针,收二级。SLTInsertAfter、SLTEraseAfter 的前提是 pos 已经存在,不会碰头指针,一级就够。
八种链表与两种常用结构
单向或双向、带头或不带头、循环或不循环,三个开关组合出 2×2×2 = 8 种链表。
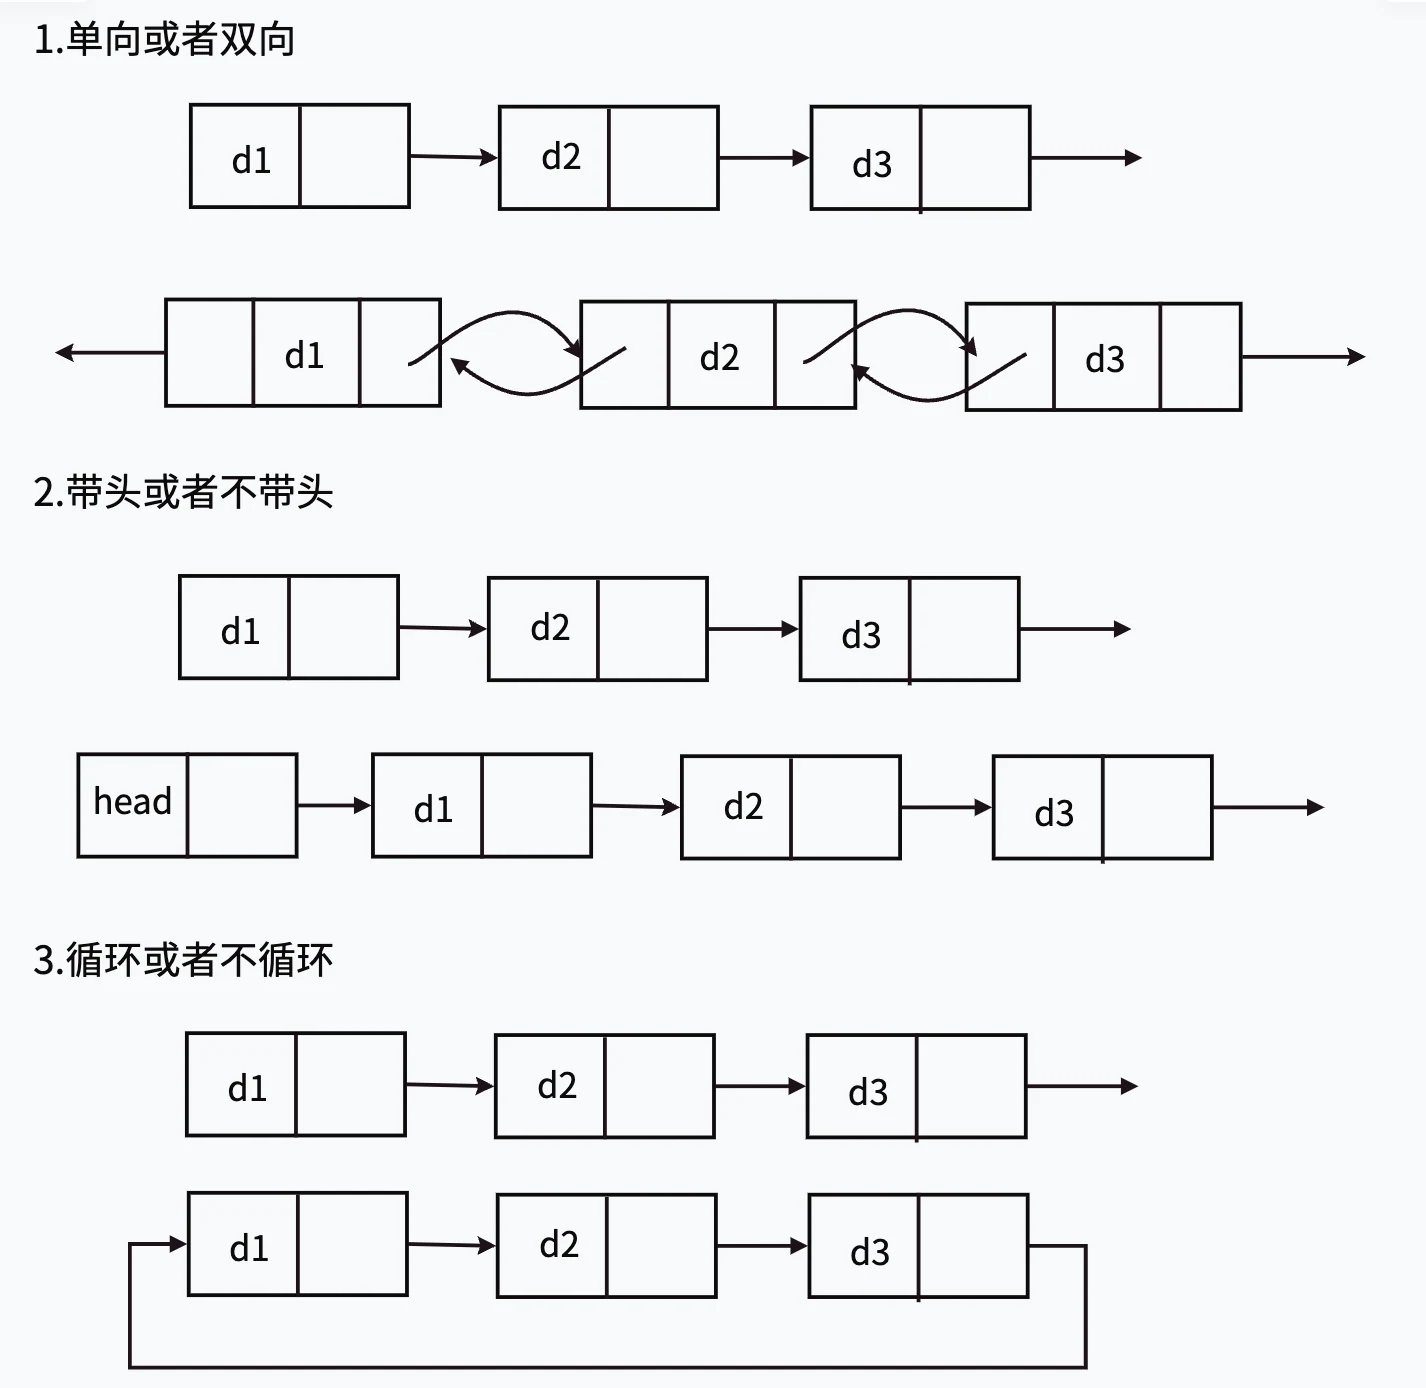
“带头”里的头结点是哨兵位(sentinel),不存有效数据,只站在链表最前面,让插入删除不用单独处理空表和头结点。它和“单链表的头指针指向第一个数据结点”不是一回事。课件说单链表阶段把第一个数据结点叫“头结点”称呼不严谨,这个提醒是对的:数据结点和哨兵位要分开叫。
常用的两种结构:
- 无头单向非循环链表:结构最简单,常做其他结构的子结构,哈希桶、图的邻接表都用它,笔试面试里出现最多。
- 带头双向循环链表:哨兵位的
next指向第一个数据结点,prev指向最后一个数据结点;空表时哨兵的next和prev都指自己。插入删除不用判空。
课件说“实际中使用的链表数据结构都是带头双向循环链表”,这句话太绝对。C++ 的 std::forward_list 是单向链表,Linux 内核里的 hlist 也常是无头单向。准确的说法是:需要独立存数据、又频繁在任意位置增删时,才常用带头双向循环;作为其他结构的子结构时,无头单向更常见。
反转、找中点、合并、判环
反转链表用三个指针,把每个结点的 next 从指向后继改成指向前驱:
SLTNode* ReverseList(SLTNode* head)
{
    SLTNode* prev = NULL;
    SLTNode* cur = head;
    while (cur != NULL)
    {
        SLTNode* next = cur->next;
        cur->next = prev;
        prev = cur;
        cur = next;
    }
    return prev;
}
循环结束时 cur 是 NULL,prev 是原来的尾结点,也就是新头。每个结点只访问一次,时间 O(N),额外指针三个,空间 O(1)。
找中间结点用快慢指针(fast and slow pointers)。慢指针一次一步,快指针一次两步:
SLTNode* MiddleNode(SLTNode* head)
{
    SLTNode* slow = head;
    SLTNode* fast = head;
    while (fast != NULL && fast->next != NULL)
    {
        slow = slow->next;
        fast = fast->next->next;
    }
    return slow;
}
偶数个结点时,快指针走到最后一对的前一个,慢指针停在第二个中间结点。LeetCode 876 要的就是第二个中间结点;如果题目要第一个,循环条件改成 fast->next != NULL && fast->next->next != NULL。
合并两个有序链表用哨兵结点省掉“结果为空”的分支:
SLTNode* MergeTwoLists(SLTNode* l1, SLTNode* l2)
{
    SLTNode dummy = {0, NULL};
    SLTNode* tail = &dummy;

    while (l1 != NULL && l2 != NULL)
    {
        if (l1->data <= l2->data)
        {
            tail->next = l1;
            l1 = l1->next;
        }
        else
        {
            tail->next = l2;
            l2 = l2->next;
        }
        tail = tail->next;
    }

    tail->next = l1 != NULL ? l1 : l2;
    return dummy.next;
}
dummy 在栈上,函数返回后不能再用,但 dummy.next 指向的结点都在堆上,返回的是那条链的头,安全。相等时取 l1,保持稳定;把 <= 改成 <,相等时先取 l2,相同关键字的相对次序会反。
判环用快慢指针,慢指针一次一步,快指针一次两步:
SLTNode* CycleEntry(SLTNode* head)
{
    SLTNode* slow = head;
    SLTNode* fast = head;

    while (fast != NULL && fast->next != NULL)
    {
        slow = slow->next;
        fast = fast->next->next;
        if (slow == fast)
        {
            SLTNode* p1 = head;
            SLTNode* p2 = slow;
            while (p1 != p2)
            {
                p1 = p1->next;
                p2 = p2->next;
            }
            return p1;
        }
    }
    return NULL;
}
为什么慢 1 快 2 一定相遇:设环长 C,慢指针刚入环时与快指针沿环方向的距离为 N。慢指针每轮走 1,快指针每轮走 k,t 轮后满足 (k-1)t ≡ N (mod C)。这个同余方程有解,当且仅当 gcd(k-1, C) 整除 N。k = 2 时 gcd(1, C) = 1,对任何环长都整除,所以一定相遇。
课件接着写“快指针一次走 3、4、5 步最终也会相遇,证明方式同上”,这个结论不成立。k = 3 时 gcd(2, C) 可能是 2,环长为偶数、N 为奇数时方程无解;k = 4 时 gcd(3, C) 可能是 3,环长为 3、N = 1 时快指针每轮相对前进 3 步,刚好绕回原位置,永远追不上。课件那组路径等式写的是 fast: L+xC+C-N、slow: L,把慢指针入环后走的 X 漏掉了,所以推导并没有证明它想证明的结论。工程和 OJ 里统一用慢 1 快 2,原因是 gcd(1, C) = 1 这个性质对任何环长都成立,不是习惯问题。
环入口的结论可以顺着同一个式子推。设头到入口为 L,入口到相遇点为 X,环长 R。相遇时慢指针走了 L + X,快指针走了 L + X + nR,速度是两倍:
2(L + X) = L + X + nR
L + X = nR
L = nR - X = (n-1)R + (R - X)
一个指针从头出发,一个从相遇点出发,两者都每次走一步。从头出发的走 L 步到入口;从相遇点出发的走 R - X 步到入口,绕过的 (n-1)R 圈不影响位置。两个指针在入口相遇,所以上面的代码在第一次相遇后,用两个同速指针就能找到入口。
相交链表要判断两个链表是否共享同一段尾部:
SLTNode* IntersectionNode(SLTNode* headA, SLTNode* headB)
{
    int lenA = 0, lenB = 0;
    for (SLTNode* p = headA; p != NULL; p = p->next)
        ++lenA;
    for (SLTNode* p = headB; p != NULL; p = p->next)
        ++lenB;

    SLTNode* pa = headA;
    SLTNode* pb = headB;
    if (lenA > lenB)
        for (int i = 0; i < lenA - lenB; ++i)
            pa = pa->next;
    else
        for (int i = 0; i < lenB - lenA; ++i)
            pb = pb->next;

    while (pa != NULL && pb != NULL && pa != pb)
    {
        pa = pa->next;
        pb = pb->next;
    }
    return pa == pb ? pa : NULL;
}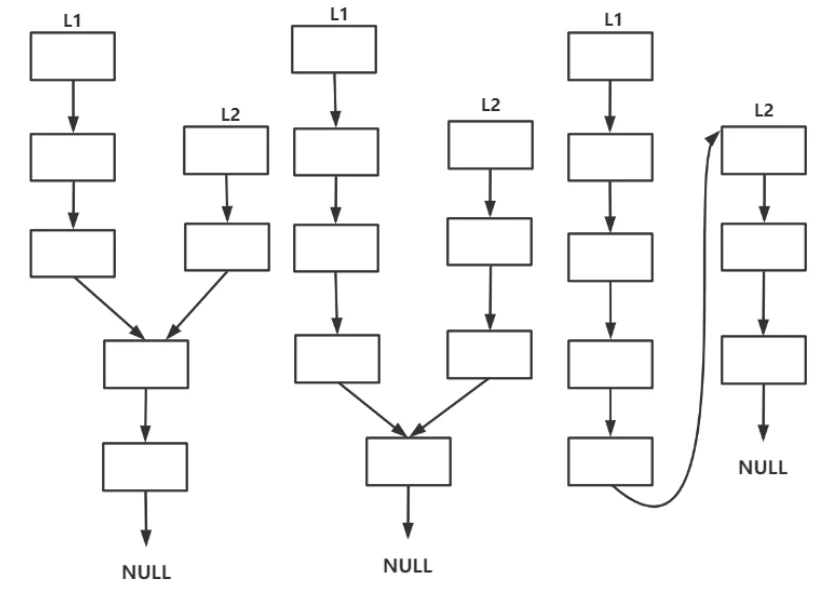
先各走一遍拿到长度,让长的先走 |lenA - lenB| 步,两个指针到尾部距离就一样了,再同步走,第一个地址相同的结点就是交点。时间复杂度 O(N + M),空间 O(1)。比较的是结点地址,不是 data;两条链表里出现相同的值不代表相交。
双向链表(doubly linked list):用 prev 把前驱找回来
带头双向循环链表的哨兵位不存数据,next 和 prev 都指自己时表示空表。每个数据结点同时存前驱和后继:
typedef int LTDataType;

typedef struct ListNode
{
    struct ListNode* next;
    struct ListNode* prev;
    LTDataType data;
} LTNode;

LTNode* LTInit(void)
{
    LTNode* phead = (LTNode*)malloc(sizeof(LTNode));
    if (phead == NULL)
        return NULL;
    phead->next = phead;
    phead->prev = phead;
    return phead;
}

int LTEmpty(const LTNode* phead)
{
    return phead->next == phead;
}

void LTInsert(LTNode* pos, LTDataType x)
{
    LTNode* newnode = (LTNode*)malloc(sizeof(LTNode));
    if (newnode == NULL)
        return;

    newnode->data = x;
    newnode->next = pos->next;
    newnode->prev = pos;
    pos->next->prev = newnode;
    pos->next = newnode;
}

void LTErase(LTNode* pos)
{
    pos->prev->next = pos->next;
    pos->next->prev = pos->prev;
    free(pos);
}

void LTPushBack(LTNode* phead, LTDataType x)
{
    LTInsert(phead->prev, x);
}

void LTPopBack(LTNode* phead)
{
    if (!LTEmpty(phead))
        LTErase(phead->prev);
}

void LTPushFront(LTNode* phead, LTDataType x)
{
    LTInsert(phead, x);
}

void LTPopFront(LTNode* phead)
{
    if (!LTEmpty(phead))
        LTErase(phead->next);
}

LTNode* LTFind(LTNode* phead, LTDataType x)
{
    for (LTNode* pcur = phead->next; pcur != phead; pcur = pcur->next)
        if (pcur->data == x)
            return pcur;
    return NULL;
}

void LTDestroy(LTNode* phead)
{
    LTNode* pcur = phead->next;
    while (pcur != phead)
    {
        LTNode* next = pcur->next;
        free(pcur);
        pcur = next;
    }
    free(phead);
}
LTInsert(pos, x) 把新结点插到 pos 后面,四行指针要按顺序改:先接新结点的 next 和 prev,再让 pos->next->prev 指回新结点,最后让 pos->next 指向新结点。LTErase(pos) 把 pos 从环上摘下来,前驱的后继改到 pos 的后继,后继的前驱改到 pos 的前驱,然后 free(pos)。有了 prev,删除尾结点不用从头找前驱;插入和删除只要拿到位置指针,都是 O(1)。
顺序表与链表怎么选
| 维度 | 顺序表 | 单链表 |
|---|---|---|
| 物理存储 | 一段连续内存 | 结点分散,用 next 串起来 |
| 随机访问 | O(1),a[i] 直接算地址 | O(N),从头走 |
| 头部插入/删除 | O(N),搬 n 个元素 | O(1),改头指针 |
| 尾部插入 | 均摊 O(1),扩容那次 O(N) | 有尾指针 O(1),只有头指针 O(N) |
| 尾部删除 | O(1) | O(N),要找前驱 |
| 任意位置插入/删除 | O(N),搬移元素 | 已拿到前驱或位置时 O(1),定位本身 O(N) |
| 空间开销 | 可能预留容量浪费 | 每结点多一个指针,分配器还有额外开销 |
| 缓存友好度 | 连续访问,命中率高 | 跳地址,容易缓存未命中 |
课件在对比表里写“链表任意位置插入删除只需修改指针指向”,少了一个前提:你已经拿着那个位置的前驱或结点指针。找位置本身仍是 O(N)。面试里这句话经常被追问,补上前提才完整。
选哪个取决于操作分布:频繁按下标读、元素总量可预估,选顺序表;频繁在已知位置插入删除、元素逐个申请释放,选链表。数据越小、结点越多,链表的指针开销和缓存未命中越明显;顺序表的扩容搬家和预留空间也是成本。没有“更高级”的结构,只有更合适的成本。
还没有评论 — 第一条由你来留。