一个文件在磁盘上占哪些字节,可以拆成三个更小的问题:盘怎么编址,文件系统把管理信息存在哪,名字怎么连到文件本身。这三个问题分别对应扇区与 LBA、块组结构、目录项。先把地址算清楚,后面全是据此推出的结论。
扇区先被编成一条一维数组
机械盘里真正读写数据的是盘片上的磁介质。每个盘片有正反两面,每面对应一个磁头(head);盘面上是一圈圈同心圆,叫磁道(track),磁道从外圈往内编号,靠近主轴的那几圈用来停靠磁头,不存数据;每条磁道被切成若干扇区(sector),同一盘面上每条磁道的扇区数相同。几个盘片的同一半径上的磁道在逻辑上合成一个柱面(cylinder),柱面数等于磁道数。
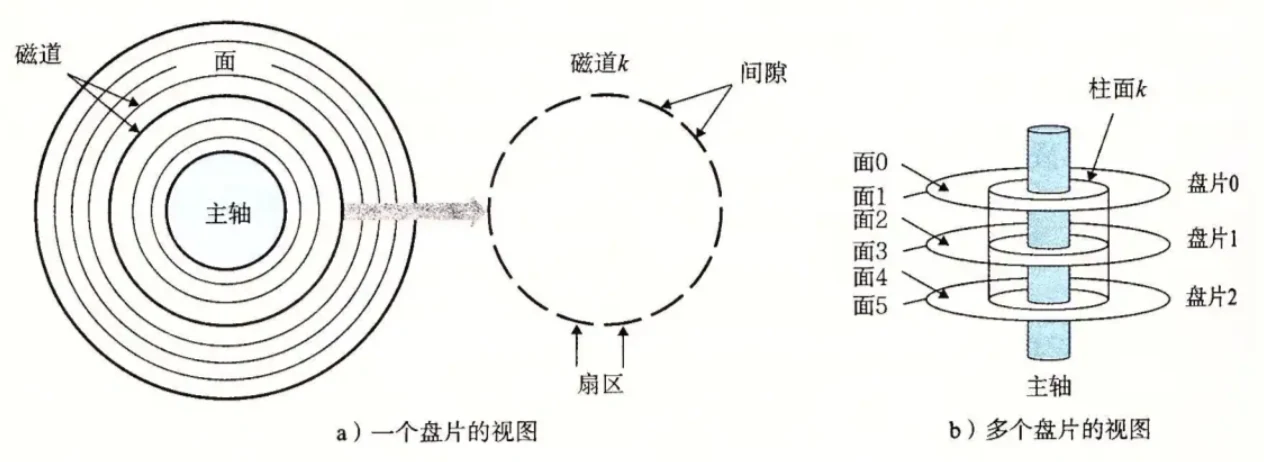
扇区是磁盘读出和写入信息的最小单位,传统上 512 字节。定位一个扇区要三个数:用哪个磁头、哪个柱面、柱面上第几个扇区,这就是 CHS 寻址。磁盘容量按 磁头数 × 柱面数 × 每道扇区数 × 512 算。
CHS 的天花板来自位宽:磁头地址 8 位、柱面地址 10 位、扇区地址 6 位。扇区编号从 1 开始,6 位能表示 1~63,所以
256 × 1024 × 63 × 512 B ≈ 8064 MB换一个说法,CHS 最大只能管到 8 GB 左右。
绕开这个限制的办法是把盘当成一维数组。把柱面依次排开,每个柱面内的磁道依次排开,每条磁道内的扇区依次排开,每个扇区就得到一个线性下标,叫 LBA(Logical Block Address)。换算公式是
LBA = C × (磁头数 × 每磁道扇区数) + H × 每磁道扇区数 + (S - 1)
C   = LBA / (磁头数 × 每磁道扇区数)
H   = (LBA % (磁头数 × 每磁道扇区数)) / 每磁道扇区数
S   = (LBA % 每磁道扇区数) + 1
注意 S - 1 和 + 1:CHS 的扇区号从 1 起,LBA 从 0 起,柱面和磁头都从 0 起。做完这层换算,操作系统眼里磁盘就是一个元素为扇区的数组,下标就是 LBA;CHS 与实际磁道之间的对应由磁盘固件自己维护,操作系统不再关心。
块与分区
逐个扇区读效率太低,内核一次连续读多个扇区,这个单位叫块(block)。块大小在格式化时确定,之后不能改。最常见 4 KB,正好 8 个扇区。块号 = LBA / 8 只在 4 KB 块下成立,通用写法是 块号 = LBA / (块大小 / 512),块大小还可以是 1 KB 或 2 KB,对应 2 个或 4 个扇区。
分区(partition)是在块设备上再切一刀。MBR 分区表记录每个分区的起始和结束位置,早期按柱面边界切,因为柱面大小一致、每柱面扇区数一致,知道起止柱面号就能算出这个分区有多大、它的 LBA 从哪儿开始。现代固件和 GPT 已经改成按扇区计。
课件说"分区从实质上说就是对硬盘的一种格式化",这句把两步合成一步了。分区只写分区表,分区里仍然什么都没有;mkfs 才在分区里写入文件系统。只分区不格式化,mount 上去是个空壳。
块组里每一块都有固定职责
ext2 把整个分区切成若干个同样大小的块组(Block Group),每组结构完全相同,所以管好一个组,就管好了整个分区。
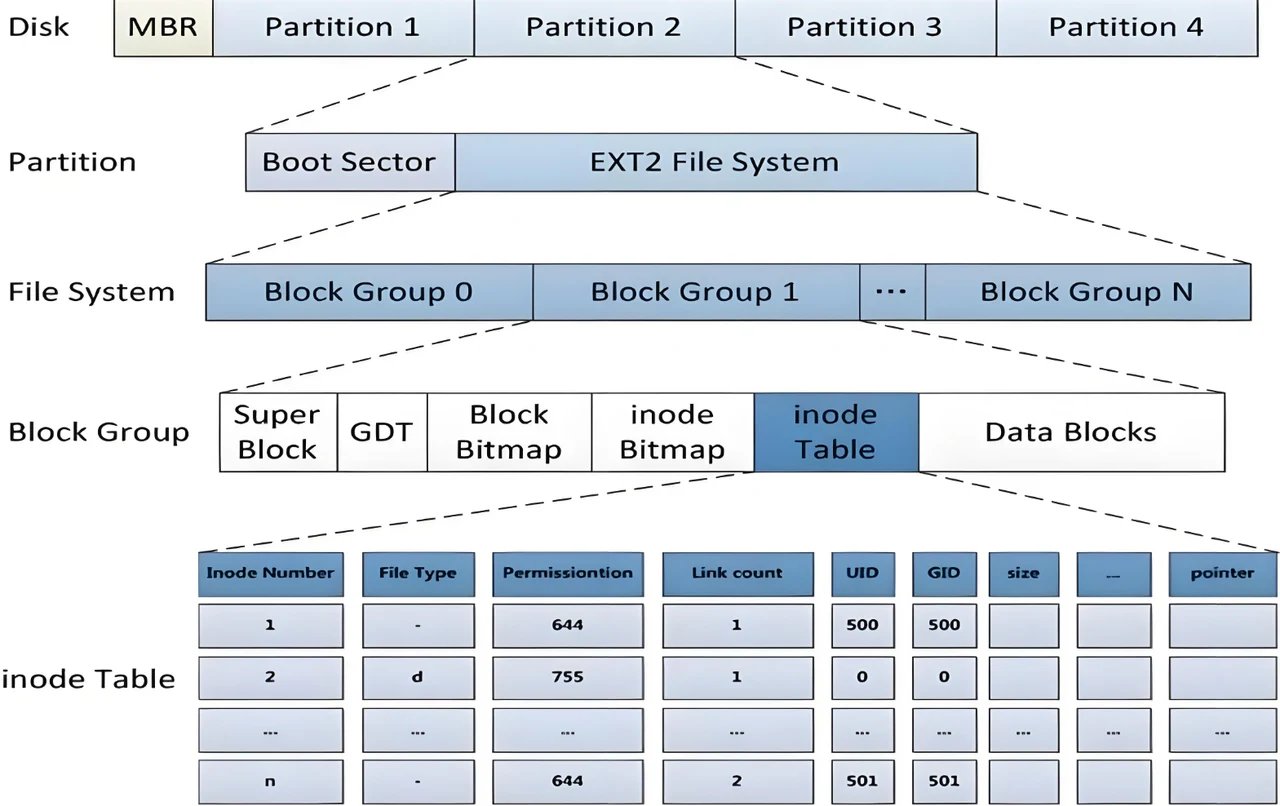
块组前面还有一个启动块(Boot Block),用来存分区信息和启动代码,文件系统不碰它。
课件写"启动块大小为 1 KB,由 PC 标准规定"。PC 标准规定的是 MBR 引导扇区 512 字节;ext2 的做法是在文件系统开头空出 1024 字节,块大小为 1 KB 时刚好占满一块。两件事容易混,但大小来源不同:一个来自 BIOS 的扇区约定,一个来自 ext2 对块 0 的保留。
超级块(Super Block)描述整个分区的文件系统状态,struct ext2_super_block 里几个字段最常用:
| 字段 | 含义 |
|---|---|
s_inodes_count / s_blocks_count | 本分区 inode 总数、块总数 |
s_free_inodes_count / s_free_blocks_count | 空闲 inode、空闲块数 |
s_log_block_size | 块大小(以 2 的幂表示) |
s_inode_size | 单个 inode 的字节数 |
s_inodes_per_group / s_blocks_per_group | 每组多少 inode、多少块 |
s_mtime / s_wtime / s_lastcheck | 挂载时间、写入时间、上次校验时间 |
s_magic | 魔数,0xEF53 才算 ext 系列 |
超级块坏了,整个文件系统等于废了,所以它有多份备份。课件先说"超级块在每个块组的开头都有一份拷贝",紧接着又说"后面的块组可以没有",两句自相矛盾。实际行为取决于 sparse_super 这个特性:开启之后,冗余副本只放在组号 0、1,以及 3、5、7 的幂次组,其余组不预留。dumpe2fs 输出里以 Backup superblock at 开头的行就是这些位置。
块组描述符表(Group Descriptor Table,GDT)一个表项管一个块组,struct ext2_group_desc 里最关键的是三个块号:
struct ext2_group_desc
{
    __le32 bg_block_bitmap;      /* 块位图在哪一块 */
    __le32 bg_inode_bitmap;      /* inode 位图在哪一块 */
    __le32 bg_inode_table;       /* inode 表从哪一块开始 */
    __le16 bg_free_blocks_count;
    __le16 bg_free_inodes_count;
    __le16 bg_used_dirs_count;
    __le16 bg_pad;
    __le32 bg_reserved[3];
};
块位图(Block Bitmap)用一位标记数据区里一个块是否被占用,inode 位图(Inode Bitmap)用一位标记一个 inode 槽位是否空闲。inode 表(Inode Table)是定长槽位组成的数组,ext2 的槽位 128 字节,ext4 常见 256 字节。数据区(Data Blocks)放文件内容——目录的内容也在这里,形式是目录项。
inode 大小固定带来一个直接结论:一个 0 字节的空文件和一个 1 GB 的文件,在 inode 表里占的位置一样大。空文件也占空间,一半来自这个槽位,一半来自目录里那条记录。
inode 的十五个格子,和它不存什么
stat 的输出基本就是 inode 的字段挨个打印出来:
$ stat test.c
  File: test.c
  Size: 654          Blocks: 8          IO Block: 4096   普通文件
Device: 802h/2050d   Inode: 263715      Links: 1
Access: (0644/-rw-r--r--)  Uid: ( 0/ root)   Gid: ( 0/ root)
Access: 2017-09-13 14:56:57.059012947 +0800
Modify: 2017-09-13 14:56:40.067012944 +0800
Change: 2017-09-13 14:56:40.069012948 +0800
Size 是文件内容的字节数,Blocks 是实际占用的 512 字节块数——所以 654 字节的文件 Blocks 是 8,占了 4 KB 的一个块(8 个 512B 扇区)。Inode 是 inode 号,Links 是硬链接数,Access 是权限位,Uid/Gid 是所有者,三个时间是下面要说的坑。
inode 与数据块的连接靠一个定长数组:
__le32 i_block[EXT2_N_BLOCKS]; /* EXT2_N_BLOCKS = 15 */前 12 项直接给出数据块号,第 13 项指向一个"装块号的块",第 14 项指向二级索引,第 15 项指向三级索引。
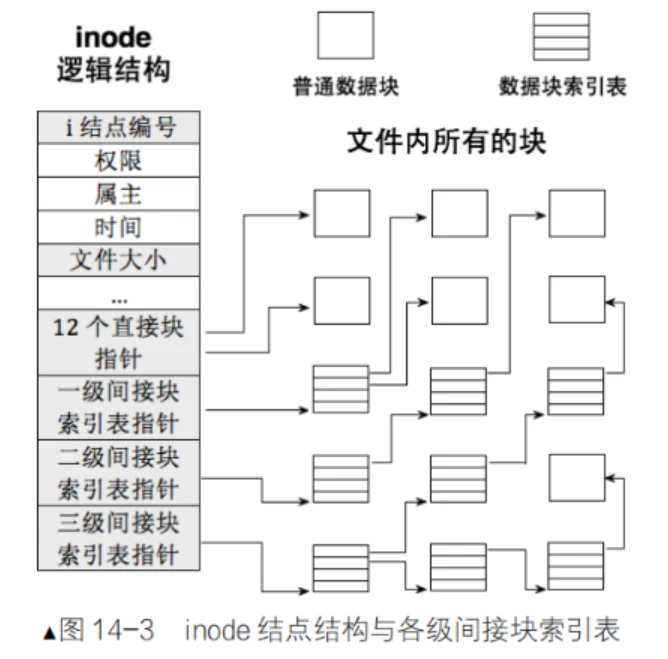
按 4 KB 块、4 字节块号算,一个索引块能装 1024 个块号:
(12 + 1024 + 1024² + 1024³) × 4 KB ≈ 4 TiB块大小降到 1 KB,一个索引块只能装 256 个块号,上限掉到约 16 GiB。块大小既影响空间利用率,也决定单文件能多大。另一个天花板是 i_size 只有 32 位,单文件卡在 4 GiB,所以 ext2 的实际上限往往由 i_size 而不是指针层数决定。ext4 换成了 extent(一段连续块用一条记录描述),i_size 也扩到 64 位。
这里有两处要说明。
第一处,课件把 i_ctime 的注释照抄成 Creation time。Linux 上 ctime 是 inode 元数据变更时间,改权限、改链接数都会更新它,跟创建时间无关;stat 里这个字段打印成 Change 也是同一个意思。ext2 根本没有保存创建时间的字段,ext4 才加了 i_crtime。核对办法很简单:chmod 644 test.c 之后再看 stat,Modify 不变,Change 变了。
第二处,15 指的是数组总长度,不是直接块的个数。EXT2_NDIR_BLOCKS 是 12,所以直接块 12 个,后三个位置依次是一级、二级、三级索引指针。按 15 个直接块去估算容量会多算一截。
目录是文件,内容是"名字 → inode 号"
ls -l 的输出里,文件名那一列并不来自 inode。名字和 inode 号的对应关系存在目录的数据块里,每条叫一个目录项(directory entry)。
struct ext2_dir_entry_2 {
    __le32 inode;      /* inode 号,0 表示这一项已空 */
    __le16 rec_len;    /* 这一条占多少字节 */
    __u8   name_len;
    __u8   file_type;
    char   name[];
};
rec_len 是给删除用的:删掉一条目录项时,把它的 inode 写成 0,再把它占的字节数并给前一条,这样目录块不用重排。readdir 直接读出这串记录:
#include <stdio.h>
#include <string.h>
#include <dirent.h>

int main(int argc, char *argv[])
{
    if (argc != 2) {
        fprintf(stderr, "用法: %s <目录>\n", argv[0]);
        return 1;
    }
    DIR *d = opendir(argv[1]);
    if (d == NULL) {
        perror("opendir");
        return 2;
    }

    struct dirent *e;
    while ((e = readdir(d)) != NULL) {
        if (strcmp(e->d_name, ".") == 0 || strcmp(e->d_name, "..") == 0)
            continue;
        printf("%-20s inode=%lu\n", e->d_name, (unsigned long)e->d_ino);
    }

    closedir(d);
    return 0;
}
d_ino 就是目录项里那个 inode 号,d_name 是名字。同一个目录里两个名字对应同一个 d_ino,它们就是同一个文件的硬链接。
于是访问一个文件必须经过名字这一层:open("/home/whb/test.c") 从根目录开始,读根目录的数据块找 home 的 inode 号,再用这个 inode 号读 home 的目录块找 whb,逐级下去。根目录的 inode 号是格式化时定死的,内核启动就能拿到,这是递归的出口。pwd 之所以有意义,是因为进程带着当前工作目录(CWD),路径解析从这个目录开始;进程不带 CWD,就必须从 / 走全程。
每打开一个文件都读一遍目录块太慢,内核在内存里维护了一棵由 struct dentry 组成的树。每个 dentry 记着名字、父目录、对应的 inode,同时挂进哈希表(快查)和 LRU 链表(淘汰)。打开文件先在这棵树里按路径找,命中就直接拿到 inode;没命中才去磁盘读目录块,并把新节点挂上去。
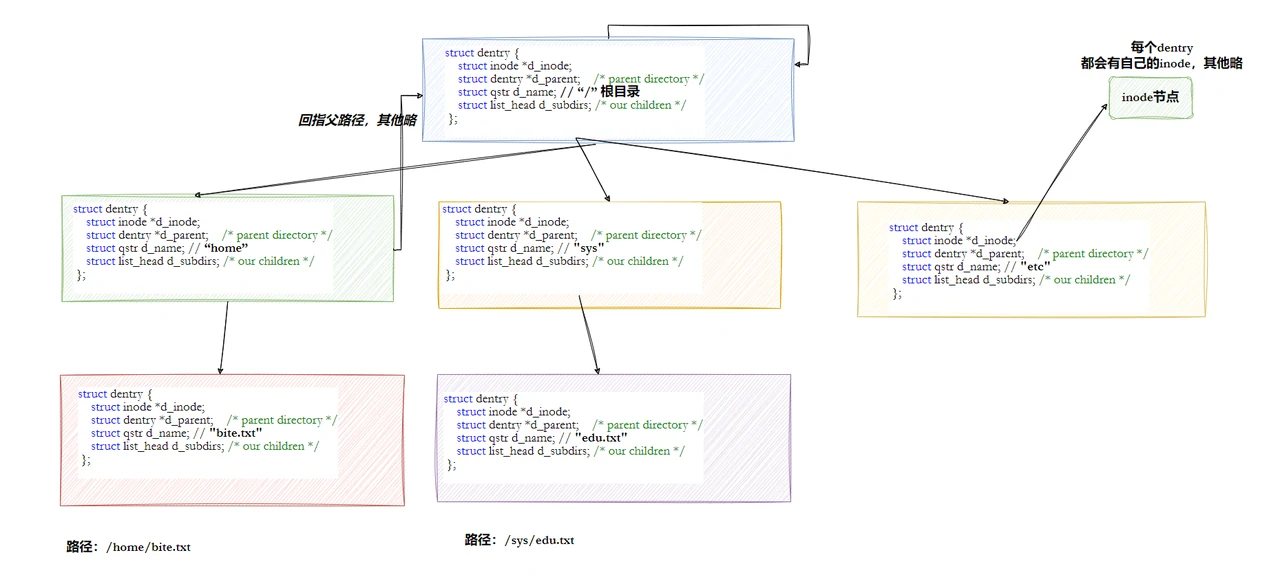
所以磁盘上没有"目录对象",只有 inode 和装着目录项的数据块。"目录"这个概念是内核用 dentry 在内存里拼出来的,掉了可以重建。
创建、删除、读取各动了哪几块
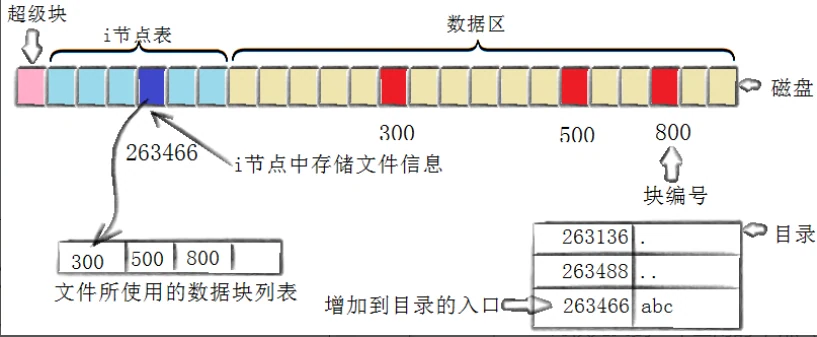
新建一个文件,内核按四步走。touch abc 之后 ls -i abc 给出 263466,这个号就来自第一步:
- 在 inode 位图里找空闲位,拿到一个槽位,把权限、所有者、时间写进 inode 表;
- 在块位图里找空闲块,比如 300、500、800,把数据写进去;
- 把这三个块号写进 inode 的
i_block; - 在父目录的数据块里追加一条目录项,内容是
(263466, "abc")。
删除走反方向。unlink 先把目录项里的 inode 号写成 0,再把 i_links_count 减一;减到 0 才释放 inode 和那些数据块。所以 rm 的第一层效果是"这个名字不再指向任何东西",第二层才轮到字节。删除后名字找不回来,是因为目录块里那一项已经被改写了;内容还有机会,前提是块没被新数据覆盖。
读取则是从路径出发的整条链:
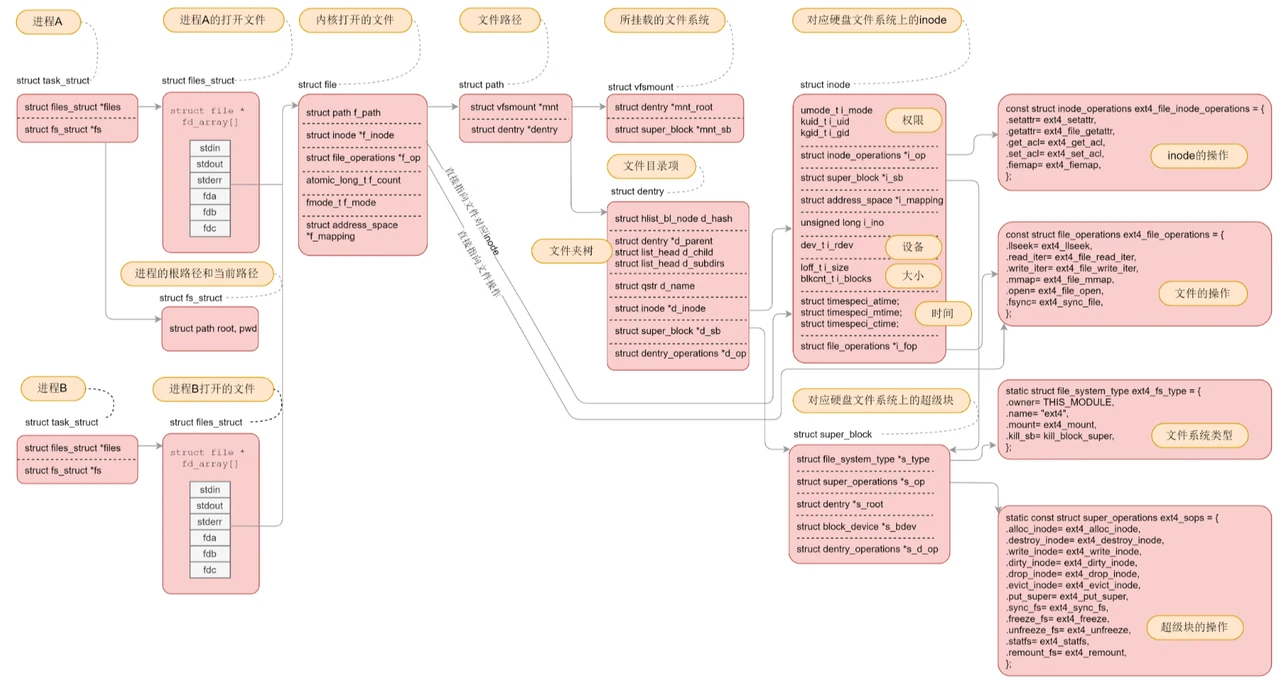
同一条路径在两个进程里,struct file 和 dentry 可以共享,fs_struct、files_struct 是各自的。这也解释了为什么 open 之后 fork,父子两个进程的同一个 fd 号指向同一个 struct file。
挂载把分区接到路径上
路径解析的起点是 /,而 inode 号只在分区内唯一。既然一个系统里可以有多个分区,内核必须知道"这个路径属于哪个分区",答案来自挂载。做一遍实验就能看到这个过程:
dd if=/dev/zero of=disk.img bs=1M count=5   # 造一个 5MB 的镜像当分区
mkfs.ext4 disk.img                          # 在里面写文件系统
sudo mkdir -p /mnt/mydisk
sudo mount -t ext4 ./disk.img /mnt/mydisk   # 挂到目录上
df -h /mnt/mydisk                           # 设备名会显示 /dev/loop0
sudo umount /mnt/mydisk
/dev/loop0 是循环设备(loop device),一种伪设备:内核把普通文件伪装成块设备,镜像文件才挂得上去。ls -l /dev/loop* 会看到它们的主设备号是 7,属于块设备。
挂载的本质是把那个分区的根 inode 接到目录树上的某个 dentry,之后访问这个前缀,VFS 自动切过去。这也意味着访问路径的前缀就足以判断自己在哪个分区。挂载还有一个容易吓人的行为:它会把挂载点原有的内容遮住,umount 之后那些文件又回来。
软链接是另一个文件,硬链接只是多了个名字
touch abc
ln abc def          # 硬链接:def 与 abc 共用一个 inode
ln -s abc abc.sym   # 软链接:新建一个文件,内容是字符串 "abc"
ls -li abc def abc.sym
ls -li 的输出能区分两者:abc 和 def 的 inode 号相同、链接数各是 2;abc.sym 有自己的 inode,链接数是 1,大小正好是路径字符串的长度,权限以 l 开头。
硬链接有两条硬约束。不能跨文件系统,因为 inode 号只在分区内唯一,跨分区没有可指向的对象。一般不能给目录建,否则目录树会出现环,find、du 和备份工具都会绕不出来;系统只放行 . 和 .. 这两个受控的。也正因为如此,目录的链接数等于 2 加上子目录数:2 是父目录给的 . 和自己这条 ..,每多一个子目录再加一。
软链接没有这两条限制。它的内容就是目标路径,因此目标被删掉之后它还在,只是变成了悬空链接,open 时报 No such file or directory。改名字也不会自动跟着改,这一点和硬链接正好相反——硬链接认的是 inode,改名不影响。
用途上分得也清楚:需要"同一份数据多个入口"用硬链接,rsync -a --link-dest=昨天的目录 源 今天的目录 就是让未变化的文件共享同一批块;需要"路径别名、版本切换"用软链接。
顺带两个和这套结构直接相关的排查手段。df -h 显示还有空间而写入报 No space left on device,先看 df -i:inode 表被海量小文件吃光了,ext4 在 mkfs 时按每 16 KiB 一个 inode 预分配,在线扩容不会自动加 inode。想知道某个 inode 落在哪,dumpe2fs -h 分区 给出 Inodes per group、Inode size、Block size,再用 (ino - 1) / inodes_per_group 算出组号、(ino - 1) % inodes_per_group * inode_size 算出组内偏移,配合该组的 bg_inode_table 就能落到具体字节;debugfs -R "stat <263466>" 则直接把这个 inode 的字段和 i_block 里的块号列出来。
还没有评论 — 第一条由你来留。