一个可执行文件依赖哪些库,ldd 列得出来;它自己导出了哪些符号,nm 列得出来。这两张表就是"库"在二进制层面的全部内容:一批已经编译好的机器码,加上一份名字清单。库分两种存法——编译时整块搬进可执行文件,或者运行时再挂进进程地址空间。
静态库是一包放好的 .o
静态库(libx.a)就是一串目标文件用 ar 归档成一个文件,本质上没有新格式。ar -rc libmystdio.a my_stdio.o my_string.o 里的 r 是 replace、c 是 create:库不存在就新建,存在就把同名成员换掉,其余保留。
ar -rc libmystdio.a my_stdio.o my_string.o
ar -tv libmystdio.a          # t 列表,v 显示详细信息
rw-rw-r-- 1000/1000 2848 Oct 29 14:35 2024 my_stdio.o
rw-rw-r-- 1000/1000 1272 Oct 29 14:35 2024 my_string.o一段能用的 Makefile 大致长这样:
libmystdio.a: my_stdio.o my_string.o
	@ar -rc $@ $^
	@echo "build $^ to $@ done"

%.o: %.c
	@gcc -c $<

.PHONY: clean output
clean:
	@rm -rf *.a *.o stdc*

output:
	@mkdir -p stdc/include stdc/lib
	@cp -f *.h stdc/include
	@cp -f *.a stdc/lib
	@tar -czf stdc.tgz stdc
使用时有三种摆放方式,对应三个编译选项:
# 头文件和库都装进了系统路径
gcc main.c -lmystdio

# 头文件和库就在当前目录
gcc main.c -I. -L. -lmystdio

# 头文件和库各有自己的目录
gcc main.c -I头文件目录 -L库文件目录 -lmystdio-I加头文件的搜索目录,编译器找#include时用;-L加库文件的搜索目录,链接器找-l指定的库时用;-l写库的名字,但要去掉lib前缀和.a/.so后缀:libc.so的库名是c。
-L 只在链接这一刻有效,它不会写进二进制。程序运行时找不找得到库,是另一套规则。
静态库最直接的性质:链接完成后,库里的代码已经在可执行文件里了,把 libmystdio.a 删掉,程序照样跑。
课件在"场景 2"里写的是 gcc main.c -L. -lmymath,而前面造的库叫 libmystdio.a。这个名字对不上,照抄会得到 cannot find -lmymath。-l 后面跟的是库名,-L 后面跟的是目录,两者不能串。
动态库给出去的是符号表
动态库(libx.so)在运行时才被链接。可执行文件里不放库函数的机器码,只留一张"我用到哪些外部符号"的表,加上调用它们的入口。程序启动前,动态链接器把这些库从磁盘映射进进程地址空间,这个过程叫动态链接(dynamic linking)。
生成动态库要两个选项:
gcc -fPIC -c my_stdio.c my_string.c
gcc -shared -o libmystdio.so my_stdio.o my_string.o
-shared 表示产出共享库格式,-fPIC 表示按位置无关代码(position independent code)编译——库可能被映射到任意地址,编译时不能写死绝对地址。
用起来和静态库一样:
gcc main.c -I. -L. -lmystdio
ldd a.out
linux-vdso.so.1 => (0x00007ffecb5be000)
libmystdio.so => not found
libc.so.6 => /lib64/libc.so.6 (0x00007f8e2a5dc000)
/lib64/ld-linux-x86-64.so.2 (0x00007f8e2a9d2000)编译通过了,ldd 却说 not found。这条消息来自动态链接器,它不认识 -L。
同一个目录下同时有 libmystdio.so 和 libmystdio.a 时,GNU ld 优先选 .so,找不到才退回 .a。想强制静态链接,加 -static;只是想让某个库静态,可以写 -Wl,-Bstatic -lfoo -Wl,-Bdynamic。
用外部库同理,比如 ncurses:
sudo apt install -y libncurses-dev      # CentOS: yum install -y ncurses-devel
gcc progress.c -o progress -lncurses
运行时找不到 .so,改的是谁的搜索路径
动态链接器(ld-linux-x86-64.so.2)按固定顺序找库,-L 不在其中。让程序找到库的做法有四种:
- 把
.so拷到系统库目录,如/usr/lib、/usr/local/lib、/lib64; - 在系统库目录里给这个库建同名软链接;
- 设环境变量
LD_LIBRARY_PATH,只对当前 shell 及其子进程有效; - 把目录写进
/etc/ld.so.conf.d/*.conf,再执行ldconfig刷新缓存。
echo "/opt/app/lib" > /etc/ld.so.conf.d/app.conf
ldconfig # 重建 /etc/ld.so.cache第四种是系统级方案。ldconfig 会把配置里所有目录下的库扫描一遍,写进 /etc/ld.so.cache;动态链接器优先查这个缓存,比逐个目录扫快得多。改完配置不跑 ldconfig,新的路径不会生效。
前三种方案各有代价:拷贝会留下版本分裂,软链接要在系统目录里动手,环境变量只对从这个 shell 启动的进程有效,而且它会同时影响所有依赖库的查找,容易把别的程序带偏。生产环境通常用第四种,或者链接时直接写 -Wl,-rpath。
readelf -d 能看出二进制里到底写了什么路径:
readelf -d a.out | grep -E 'RPATH|RUNPATH|NEEDED'NEEDED 是它记下的依赖库名,RPATH/RUNPATH 是编译时写进去的搜索目录。这两项存在时,LD_LIBRARY_PATH 的优先级会被打乱——RPATH 排在它前面,RUNPATH 排在它后面。
.o 里那条 call 后面为什么是 0
把一个多文件工程拆开编译,能看到链接器到底在修什么:
gcc -c hello.c code.c
objdump -d hello.o
0000000000000000 <main>:
0: f3 0f 1e fa endbr64
4: 55 push %rbp
5: 48 89 e5 mov %rsp,%rbp
8: 48 8d 3d 00 00 00 00 lea 0x0(%rip),%rdi
f: e8 00 00 00 00 callq 14 <main+0x14>callq 后面是四个 0。不是因为被调用的函数在地址 0,而是编译 hello.c 时编译器根本不知道 run 和 printf 在哪:run 在另一个 .o 里,printf 在 libc 里。编译器只能先填 0,并把"这里需要修正"记进重定位表。
符号表把这件事说得很清楚:
readelf -s hello.o10: 0000000000000000 37 FUNC GLOBAL DEFAULT 1 main
12: 0000000000000000 0 NOTYPE GLOBAL DEFAULT UND puts
13: 0000000000000000 0 NOTYPE GLOBAL DEFAULT UND runNdx 一列是 UND(undefined),意思是"本文件里没有这个符号的定义"。run 在 code.o 里,puts 在 libc.so 里。链接器的工作就是把每个 UND 在其他目标文件的符号表里找一遍,找到定义就把地址填回去。
hello.o 和 code.o 都有 .text 节,链接之后它们被并进同一个 .text:
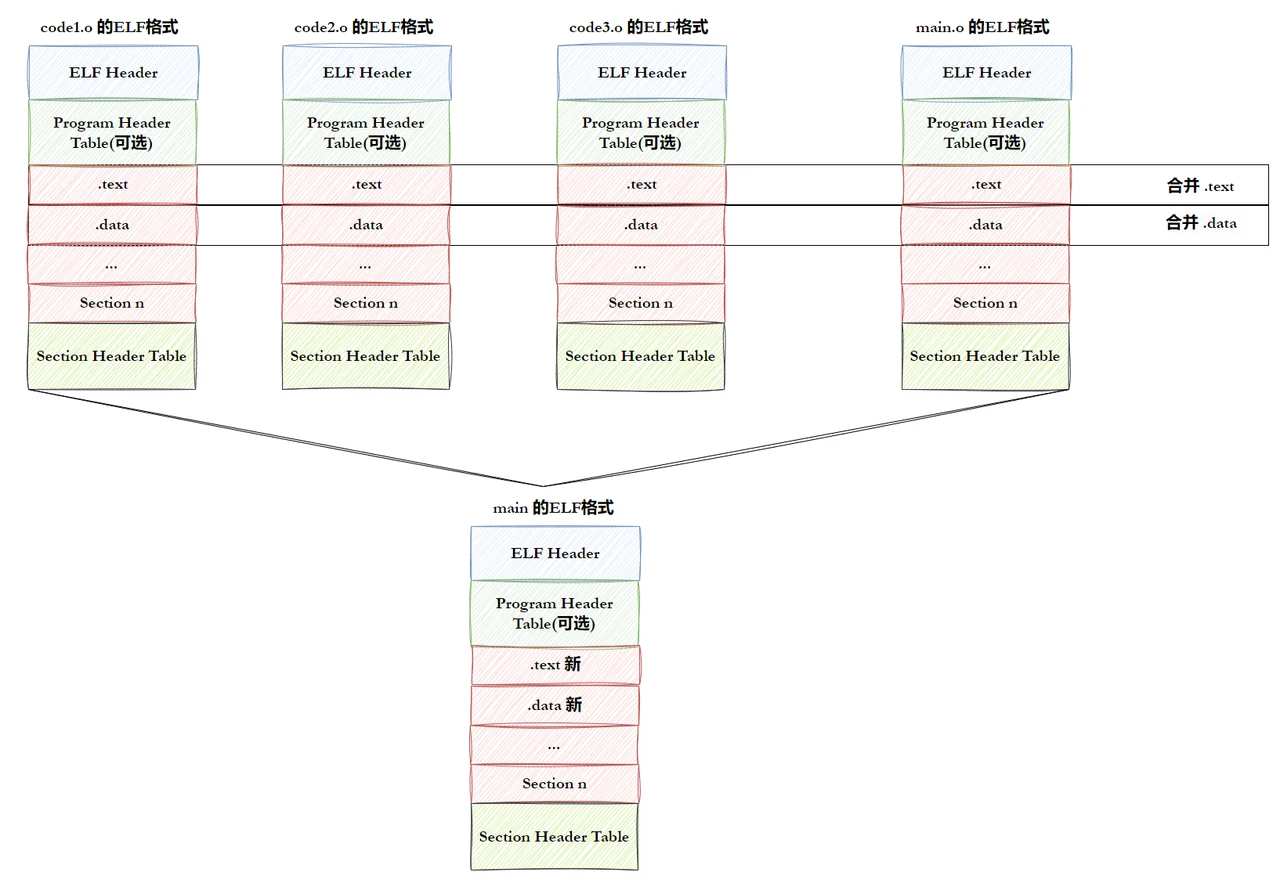
合并完成后统一编址,main.exe 里的 callq 就变成了具体地址:
0000000000001160 <main>:
 1160: f3 0f 1e fa          endbr64
 1164: 55                   push   %rbp
 1165: 48 89 e5             mov    %rsp,%rbp
 1168: 48 8d 3d a0 0e 00 00 lea    0xea0(%rip),%rdi
 116f: e8 dc fe ff ff       callq  1050 <puts@plt>
 1174: b8 00 00 00 00       mov    $0x0,%eax
 1179: e8 cb ff ff ff       callq  1149 <run>
e8 是相对调用,后面四字节是目标地址与本指令下一条之间的差值,1149 就是 run 在合并后的 .text 里的位置。readelf -s main.exe 里 run 的 Ndx 从 UND 变成了具体节号——链接完成的标志就是这个。
静态库走的是同一条路:ar 里的成员是 .o,链接器按需取出被引用到的那些,和其他 .o 一起合并。所以静态链接本质上是"把一批 .o 拼起来,再统一修正地址",也叫静态重定位。
链接顺序在这里会咬人。GNU ld 从左到右扫描命令行,处理到某个库时只解决"当前已经出现但还没定义的符号"。若 libfoo 依赖 libbar,写成 -lbar -lfoo 就找不到 libbar 里的定义,因为轮到 libbar 时还没有任何未定义符号指向它。正确顺序是依赖者在前、被依赖者在后:-lfoo -lbar。循环依赖可以套 -Wl,--start-group -lfoo -lbar -Wl,--end-group,让链接器反复扫描。
ELF 的链接视图与执行视图
file 先给个结论:
file hello.o
# hello.o: ELF 64-bit LSB relocatable, x86-64, version 1 (SYSV), not stripped
file a.out
# a.out: ELF 64-bit LSB pie executable, x86-64, version 1 (SYSV), dynamically linked, interpreter /lib64/ld-linux-x86-64.so.2
ELF 涵盖四类文件:可重定位文件(.o)、可执行文件、共享目标文件(.so)、内核转储(core dump)。结构上分四部分:
- ELF 头:文件特性,以及在文件中的程序头表、节头表偏移,作用是定位其他部分;
- 程序头表(Program header table):列出所有有效段(segment)的偏移、虚拟地址、长度、权限;
- 节头表(Section header table):描述每个节(section);
- 节:基本组成单位,
.text存机器指令,.data存已初始化的全局变量和静态变量。
常用的节还有几类:.rodata 存只读数据(字符串字面量就在这),只能落在只读段里;.bss 只为未初始化的全局和静态变量占位,不占文件空间,readelf -S 里它的类型是 NOBITS;.symtab 是符号表,名字与地址的对应;.got/.got.plt 是给动态链接用的跳转地址表。
两个视图对应两张表:
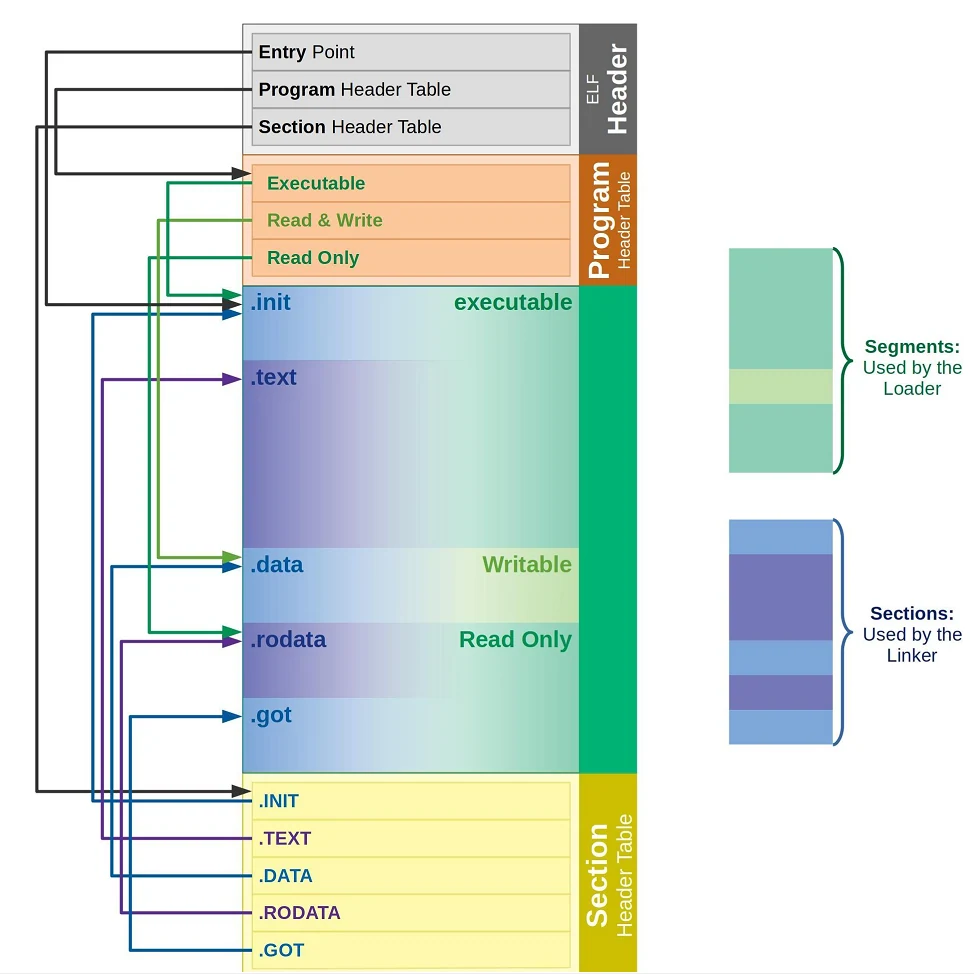
readelf -S 看节,readelf -l 看段。readelf -l 末尾有一段 Section to Segment mapping,直接写出哪个段包含哪些节:
| 段 | 权限 | 包含的节 |
|---|---|---|
LOAD(第一个) | R E | .interp .note.* .gnu.hash .dynsym .dynstr .text .plt .rodata .eh_frame |
LOAD(第二个) | RW | .init_array .fini_array .dynamic .got .got.plt .data .bss |
合并的原则是属性相同:可读可执行的一组,可读可写的一组,只读的一组。理由有两个。一是减少页内碎片——页是最小分配单位,如果 .text 4097 字节、.init 512 字节各自独立占页,要 3 页;合并后只需 2 页。二是权限控制——同一个段只有一种权限,代码段只读可执行,数据段可读写,这样页表项的权限位才有意义。
这里有一处课件要改。课件用 readelf -h a.out 看到 Type: DYN (Shared object file),注释成"文件类型:动态共享库(.so)"。这个输出本身没错,但结论错了:a.out 是可执行文件,DYN 只说明它以 PIE(position independent executable)形式生成——现代发行版的 gcc 默认开 -pie,可执行文件也按"可重定位"的方式编址,加载时整体加一个随机基址。区分办法是 file 的输出:pie executable 与 shared object 是两回事;另外 PIE 的入口地址是文件内偏移(比如 0x1060),而老式 EXEC 类型的入口是虚拟地址(比如 0x400640)。想回到老样子编译,加 -no-pie。
从 _start 到 main,以及地址在编译时就已经定好
一个 ELF 文件还没被加载时就已经有地址了。objdump -S 左边那一列就是虚拟地址,起始按 0 算,各段依次排开。这是"平坦模式"的要求:编译器和操作系统必须约定同一套编址,加载时才能把每个段直接摊到进程地址空间里。
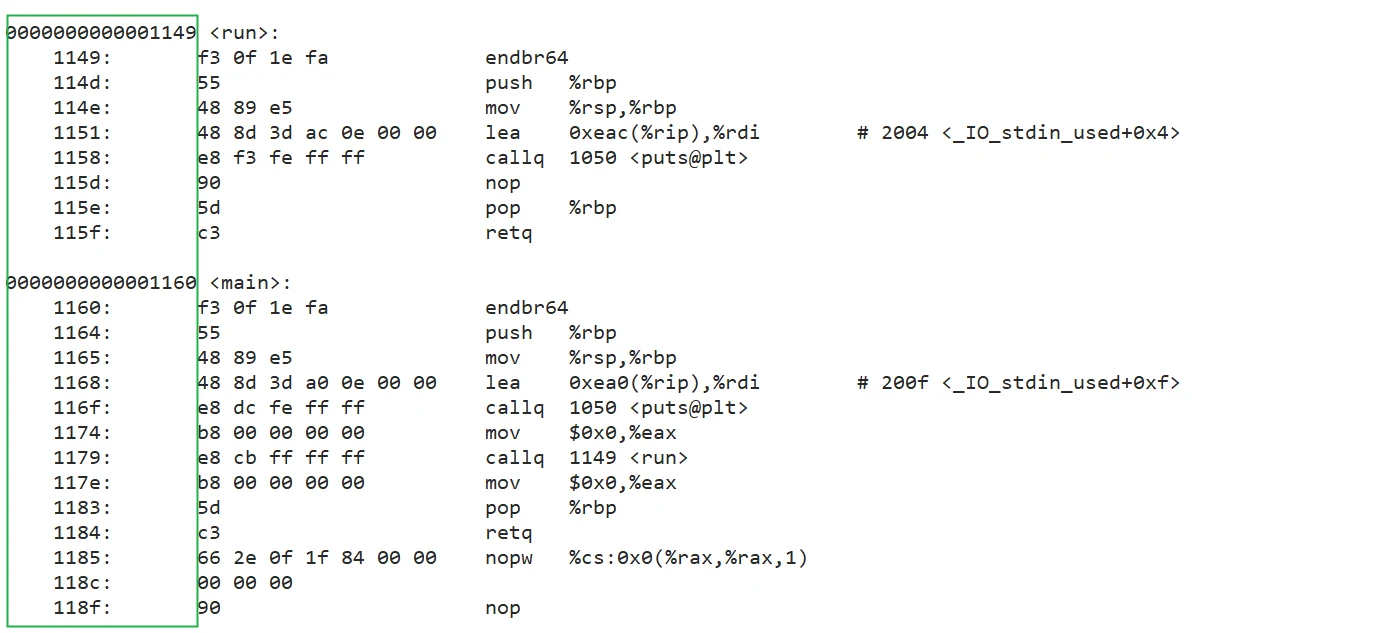
程序的入口不写在这个约定里,写在 ELF 头的 Entry point 字段。readelf -h 能看到它,readelf -l 里的 INTERP 段则指出由谁来做加载后的收尾:
[Requesting program interpreter: /lib64/ld-linux-x86-64.so.2]启动顺序大致是:
- 内核读 ELF 头,按程序头表里的
LOAD段把文件内容映射到各段的虚拟地址; - 跳到
Entry point,那里是_start,由 C 运行时库或链接器提供; _start搭好初始栈,做完数据段初始化,再调用__libc_start_main;__libc_start_main里完成动态链接器的收尾工作、初始化线程库和信号处理,最后调用main;main返回后,__libc_start_main处理返回值并调用exit。
_start 不做这些细节,它只是把 main 的地址交给 __libc_start_main——objdump -d 里能看到 lea 0xd8(%rip),%rdi # 1160 <main> 这一行。
那程序运行起来之后,内存里那些区域是谁划的?进程刚创建时 mm_struct、vm_area_struct 的数据来自 ELF 的各个 segment:每个 segment 带自己的起始地址和长度,正好填进 VMA 的 [vm_start, vm_end],再用具体地址填页表。
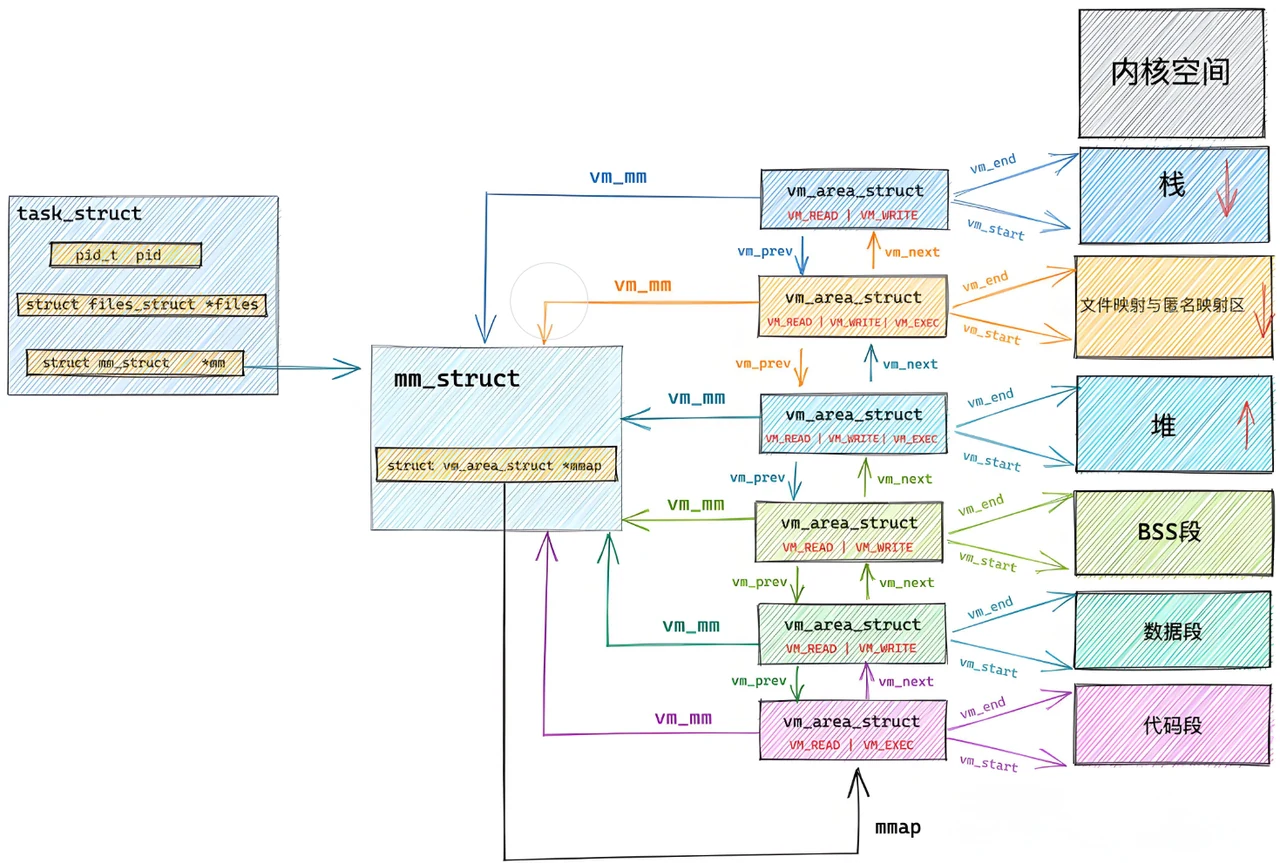
所以虚拟地址机制要编译器配合,不只靠操作系统:编译器负责把段摆到约定的地址上,操作系统负责把这些地址映射到物理页。
库被映射进来之后,如何调用:GOT 与 PLT
动态库也是一个文件,要访问同样要先打开、再映射。差别在映射地址:库的加载地址每次运行都可能不同(ASLR),所以可执行文件里那条 call 不能写死库函数的绝对地址。
代码段是只读的,改不了;能改的只有可写段。于是每个模块在自己可写的数据区里留了一张表,每项存一个外部函数或全局变量的地址,这张表叫全局偏移表(Global Offset Table,GOT)。加载时动态链接器把真实地址填进 GOT,调用时先查表再跳。
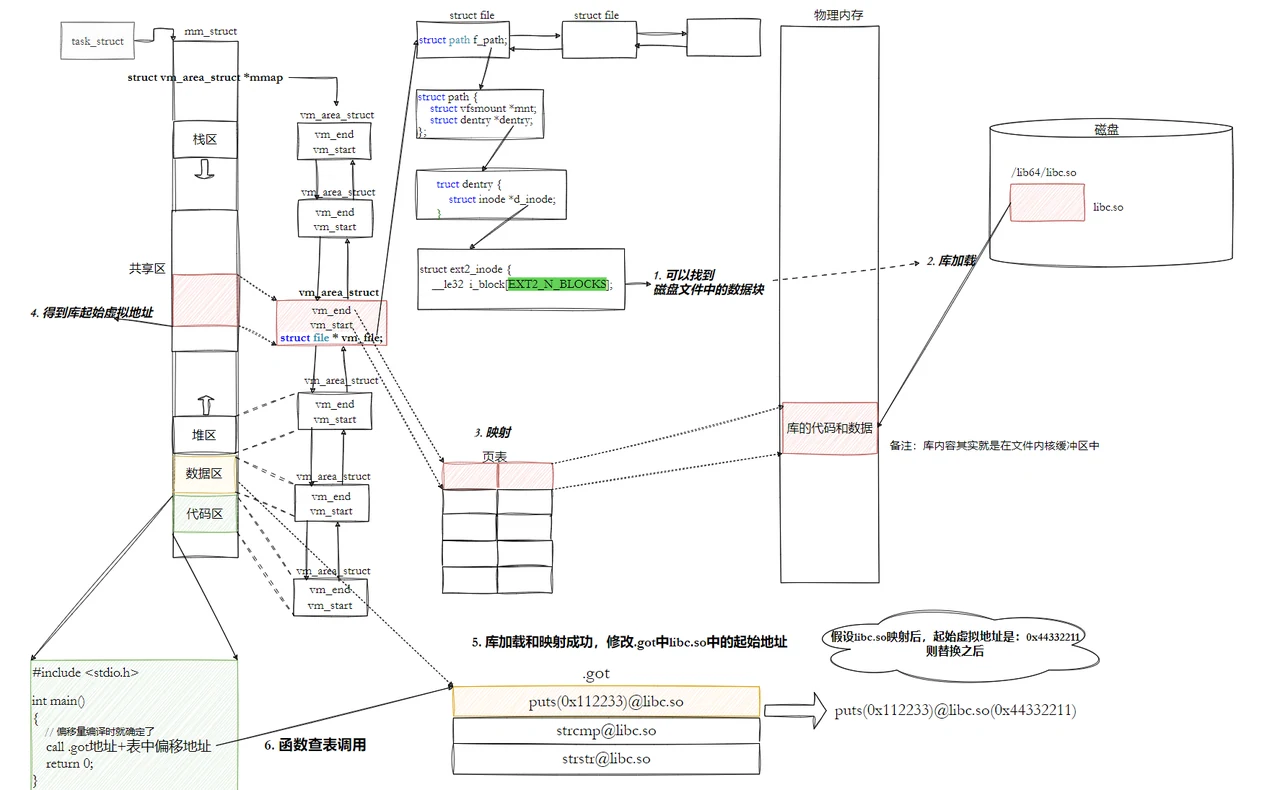
.got 是独立的一个节,readelf -S 能看到它带 WA 标志(可写、需分配)。课件说它"在 .data 中预留一片区域",更准确的说法是:.got/.got.plt 单独成节,加载时与 .data 一起并进同一个可写 segment,readelf -l 的映射表里 RW 那个 LOAD 段包含 .got、.got.plt、.data 三项。
三个结论合起来就是 PIC 的定义:
- 代码段只读,所以不能改代码,只能改 GOT;因此同一份代码可以被所有进程共享;
- 每个进程的每个动态库都有自己的 GOT,GOT 本身不共享;
- 在单个
.so内部,GOT 与.text的相对位置固定,所以代码可以用 RIP 相对寻址找到自己的 GOT。
这正是编译时加 -fPIC 的原因:PIC = 相对编址 + GOT。
GOT 不是一次性填完的。链接时若把所有函数都立刻重定位,启动会很慢,而多数函数整个运行期可能一次都不调用。常用的优化是延迟绑定,也就是过程链接表(Procedure Linkage Table,PLT)。objdump -d 里每个外部函数都有一个 foo@plt 桩:
0000000000001050 <puts@plt>:
 1050: f3 0f 1e fa          endbr64
 1054: f2 ff 25 75 2f 00 00 bnd jmpq *0x2f75(%rip)   # 3fd0 <puts@GLIBC_2.2.5>
第一次跳到 puts@plt 时,GOT 里那一项还指向"查符号"的桩代码,它找到真正地址后回填 GOT;之后再调用就走直达路径。gcc 默认给 -z lazy,改成 -Wl,-z,now 可以要求启动时全部绑定。
库之间也会互相依赖。两个 .so 都在调用对方的函数,各自都有自己的 .got,加载时按依赖顺序映射、逐个填表——这就是"解析依赖关系"的实际含义。
命名、链接顺序与三个查看命令
三条容易踩的规则放在一起。
库名规则:文件叫 libxxx.so 或 libxxx.a,-l 写 xxx。libc.so → -lc,libmystdio.so → -lmystdio。文件名写成 mystdio.so,-lmystdio 找不到。
链接顺序:命令行从左到右生效,被依赖的库放后面;循环依赖用 --start-group。
三个排查命令:
file  a.out            # 类型:可重定位 / 可执行 / PIE / 共享库
ldd   a.out            # 运行时依赖的每个库,以及解析到的实际路径
nm -D libfoo.so        # 导出(T)与未定义(U)的符号
nm    a.out            # 静态链接的程序,符号还能在这里看到定义
ldd 报 not found 是运行时搜索问题,查搜索路径;nm 报某个符号是 U 而在任何库里都找不到 T 版本,那是链接问题,去查 -l 和链接顺序。file 与 readelf -h 给出的是文件类型,用它区分静态链接、动态链接和 PIE,比看大小可靠——静态链接的程序通常大一圈,但那不是判据。
还没有评论 — 第一条由你来留。