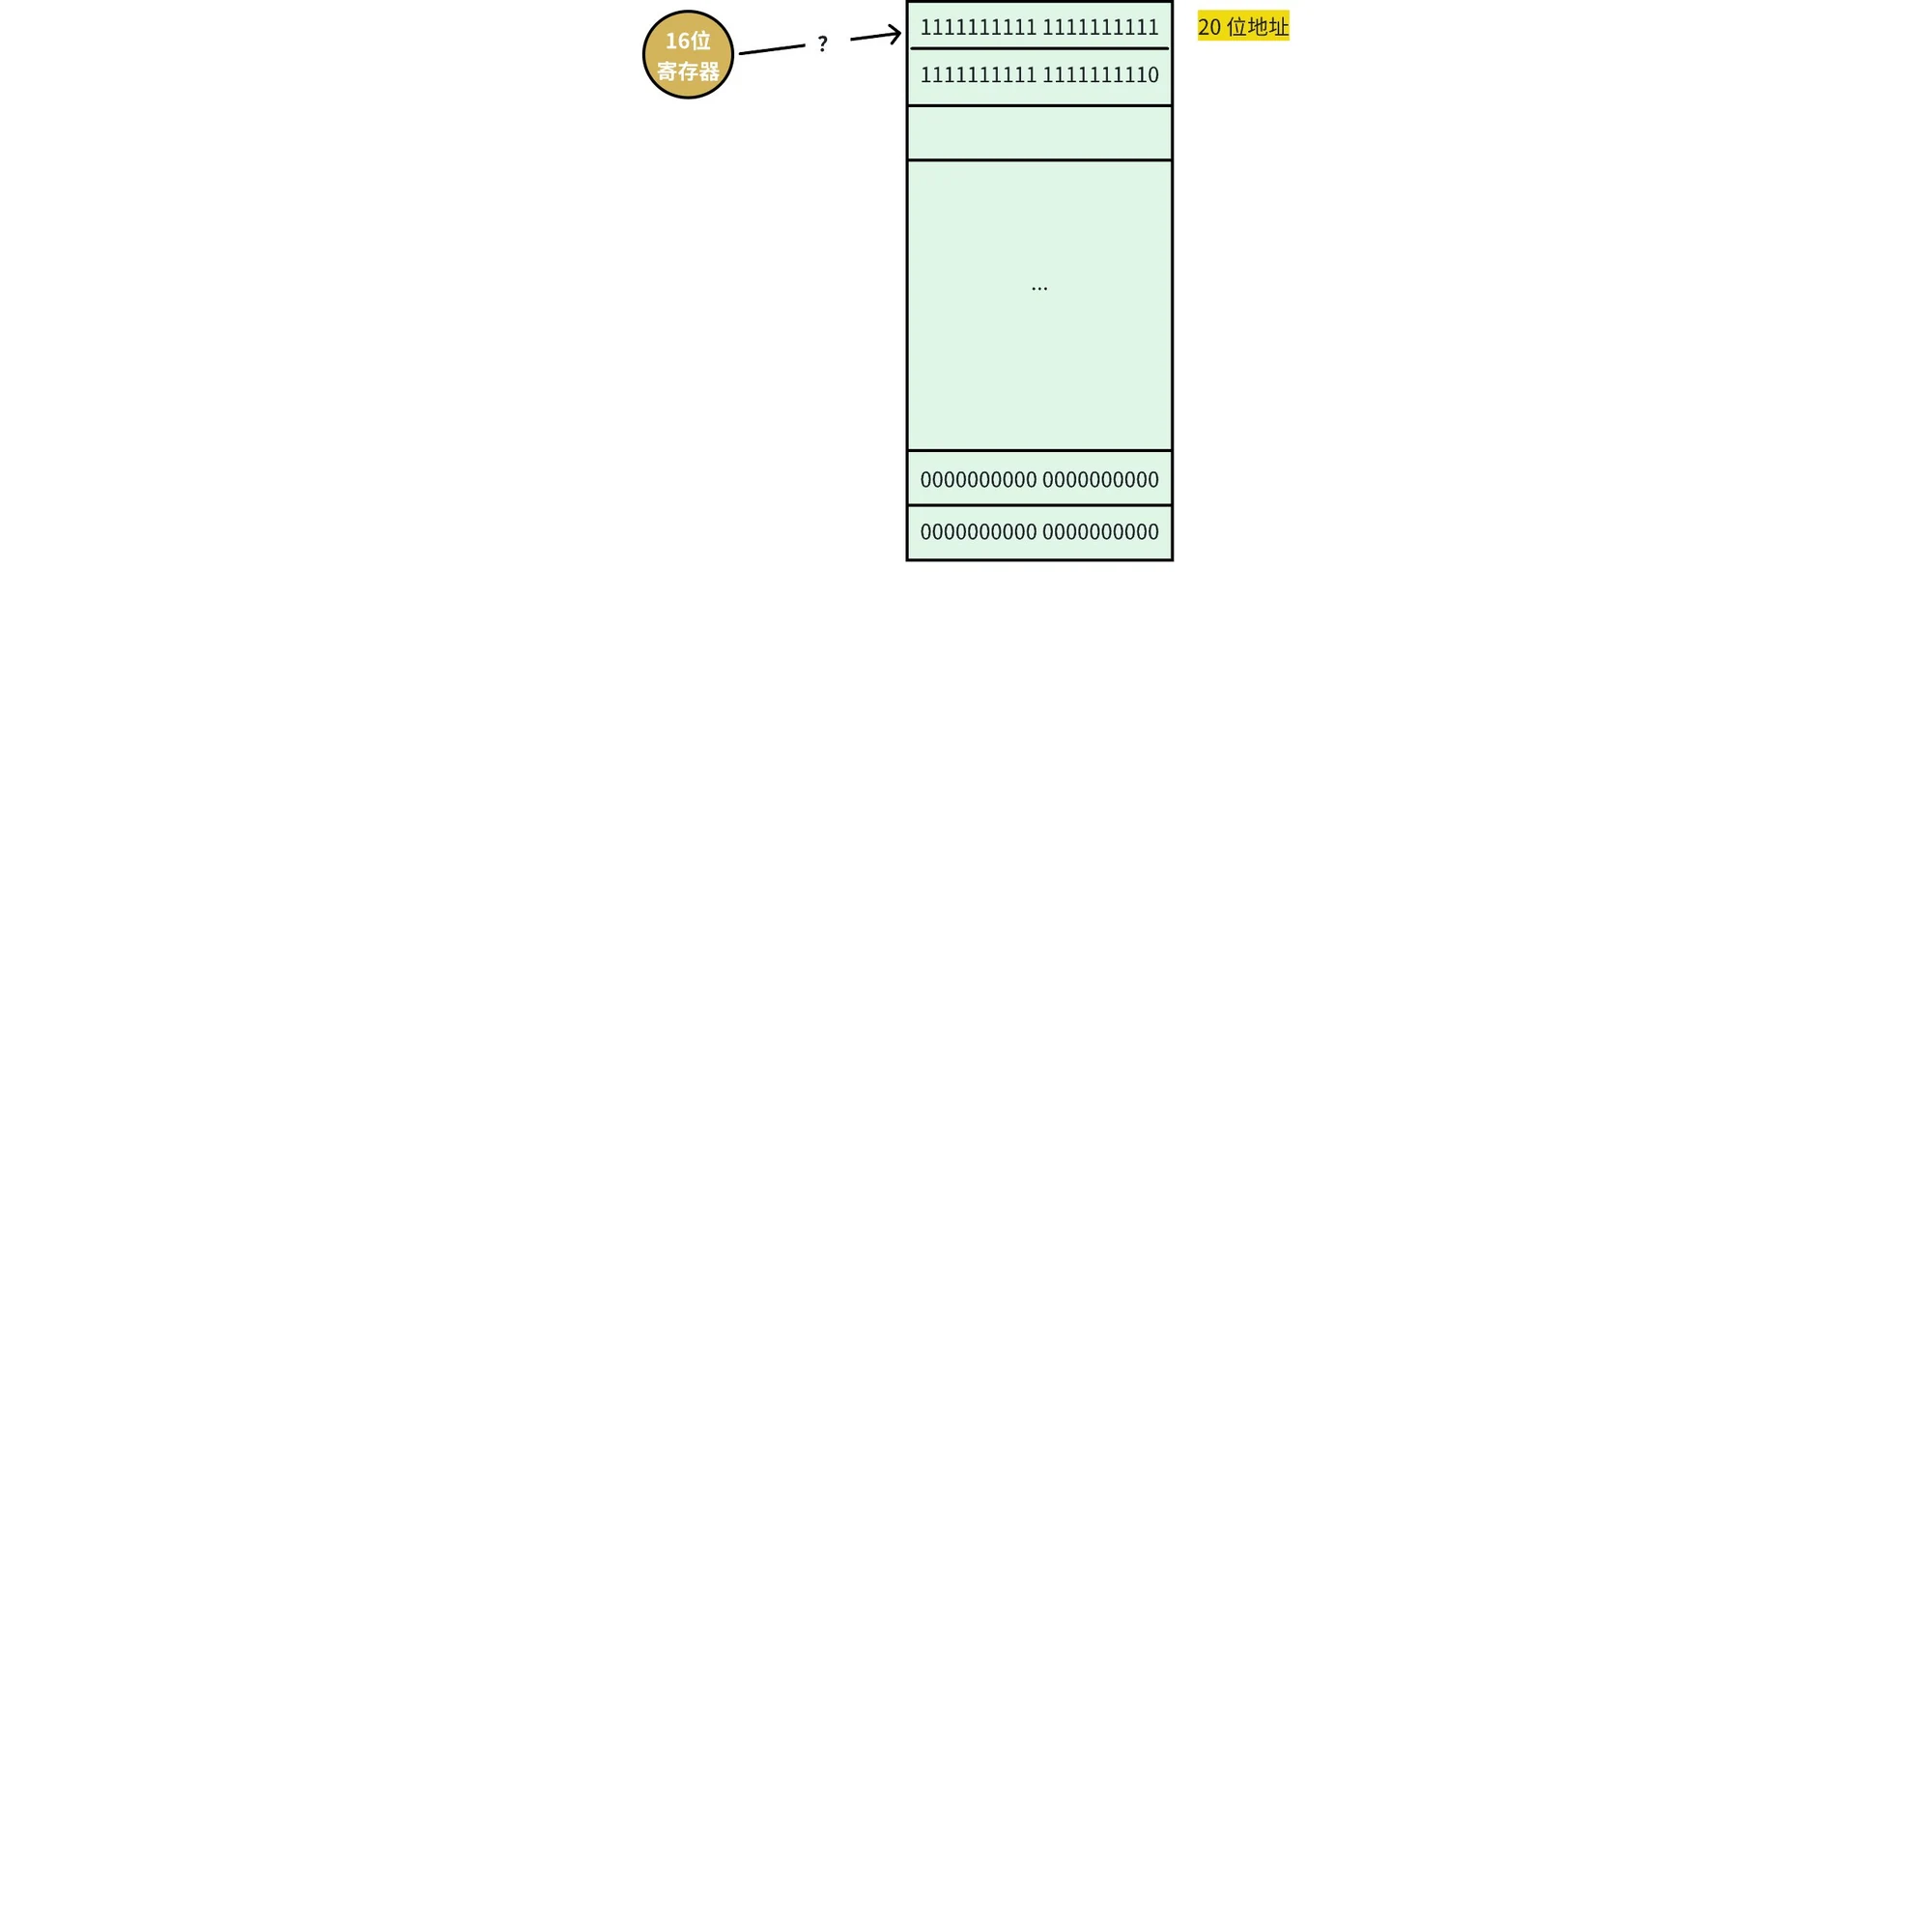
8086 的通用寄存器只有 16 位,最多表达 65536 个地址;它的地址总线却有 20 位,能寻址 1MB。差出来的 4 位,是理解后面所有内存管理机制的起点。
16 位寄存器怎么够到 20 位地址
4004 和 8080 的年代没有 MMU,程序里的地址就是物理地址,CPU 把地址送上总线,内存按地址取字节。同一时刻只跑一个程序,这套做法够用。多道程序出现后就不够了:编译时把绝对地址写死,程序装进内存后搬不动,操作系统想回收、合并空闲块都没法下手,外部碎片越攒越多。
8086 换了个办法。它把 1MB 空间切成许多逻辑段,每个段最长 64KB,用两个 16 位数表示一个地址:段基址和段内偏移。物理地址按
物理地址 = 段基址 × 16 + 段内偏移计算。×16 就是左移 4 位,左移之后段基址占 20 位地址的高 16 位,低 4 位补零。课件给的例子:段基址 0x0580 左移四位得到 0x05800,加上偏移 0x0008,落在 0x05808。
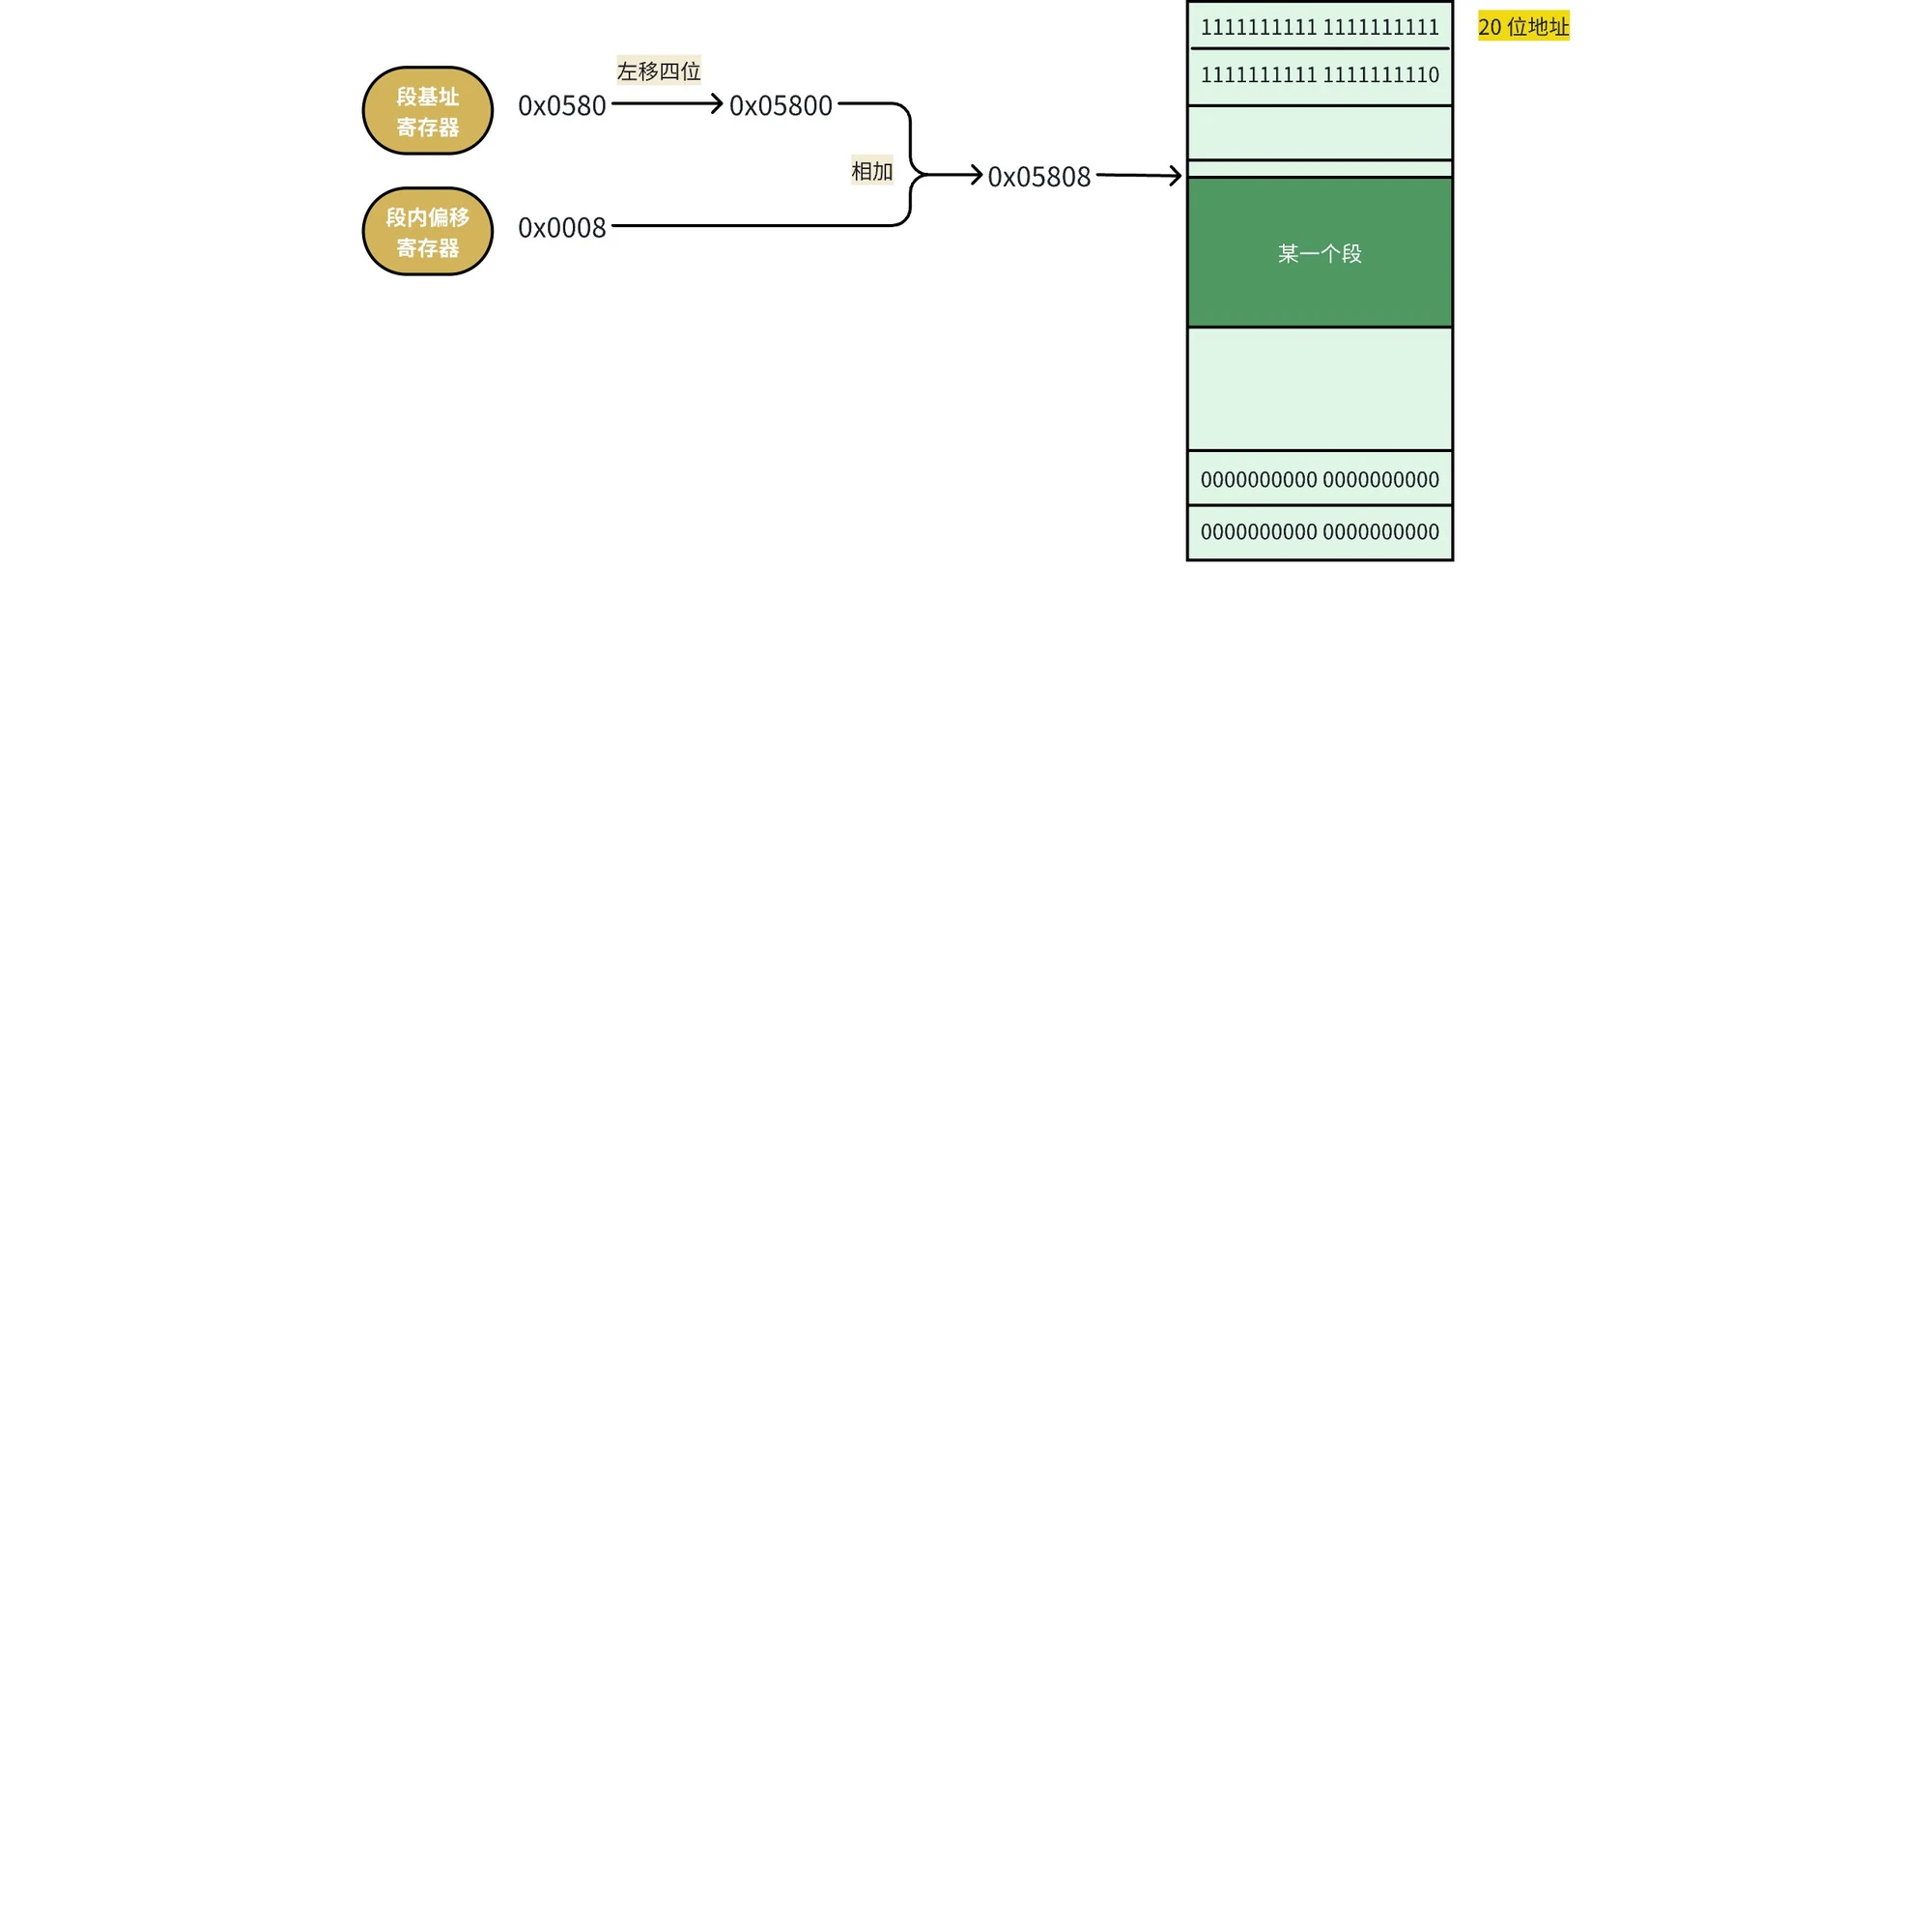
这种寻址方式叫实模式。它带来两个直接好处。第一,程序可以动态重定位:段基址一变,整个程序等于搬到新位置,CPU 每次访存现算,不用改指令。第二,程序可以切成代码段、数据段、栈段,各自用 CS、DS、SS、ES 指过去,不必连续。
代价是没有任何检查。段与段允许重叠,0x05808 既可以是 0x0580:0x0008,也可以是 0x057F:0x0018;硬件不检查段界限,也不检查访问权限,访问别人的段照样畅通。程序之间没有隔离,一个程序可以改另一个程序甚至操作系统的数据。
286 加了检查,386 才把段放宽
1982 年的 80286 把地址总线扩到 24 位,最大 16MB,同时带来保护模式:段的边界由硬件检查,越界触发异常;段有特权级,内核的段用户碰不了;描述符里有一位标记段当前在不在内存,不在就触发异常,由操作系统从磁盘换回来。段的元信息从寄存器搬进内存里的一张表,段寄存器里改放下标。
286 的通用寄存器还是 16 位,所以一个段最大仍是 64KB,想在 16MB 里访问一个大数组,得不停换段基址。80386 把通用寄存器和地址总线都拉到 32 位,寻址空间 4GB,只有段寄存器还是 16 位——为了兼容。
保护模式下寻址靠三样东西:全局描述符表(GDT)、段描述符、选择子。
GDT 是内存里的一个数组,每个元素 8 字节,最多 8192 项,因此整张表最大 64KB。它的位置和长度存在 GDTR 里:32 位保护模式下 GDTR 是 48 位,高 32 位是基址,低 16 位是界限。界限必须存,CPU 每次做段访问都要查表,它得知道表有多长,否则越界的索引会读到表后面的数据。
课件说"GDT 在内存中有且只有一个",这句要按 CPU 理解。GDTR 是每个逻辑处理器各自的寄存器,SMP 机器上每个核都有一份 GDT 和 GDTR,Linux 也是按 CPU 各建一套;LDT 另算。
段描述符的 8 个字节切得很碎:
| 字段 | 位宽 | 含义 |
|---|---|---|
| Base | 32,拆三段存放 | 段起始线性地址 |
| Limit | 20,拆两段存放 | 段大小,配合 G 位 |
| G | 1 | 粒度:0 按字节,1 按 4KB |
| D/B | 1 | 代码段用 16 位还是 32 位;栈段用 sp 还是 esp |
| L | 1 | 是否 64 位代码段,只在 IA-32e 下有意义 |
| AVL | 1 | 留给操作系统或应用自定义,Intel 保证不占用 |
| P | 1 | 段当前是否在内存 |
| DPL | 2 | 段特权级,0 到 3,越小权限越高 |
| S | 1 | 系统段还是代码/数据段 |
| TYPE | 4 | 具体类型,含义随 S 变化 |
S=1 时,这个描述符是代码段或数据段,TYPE 再区分两者,并标记读权限、写权限、增长方向和访问标记;S=0 时它是系统段,TYPE 区分中断门、陷阱门、调用门、任务门这类系统级入口。
Limit 加 G 决定段的上限:G=0 时单位是字节,20 位最大 1MB;G=1 时单位是 4KB,最大 4GB。Base 被拆成低 16 位、中间 8 位、末尾 8 位,是为了兼容 286 那套 6 字节描述符:老字段位置不能动,新加的位只能塞进原来空着的地方。
P 位是按需换入的入口。内存紧张时可以先只建描述符、把 P 置 0;程序真访问这个段时触发异常,操作系统从磁盘把内容换进来,再把 P 置 1。这是后来虚拟内存的雏形。
段寄存器里装的是选择子,不是基址:
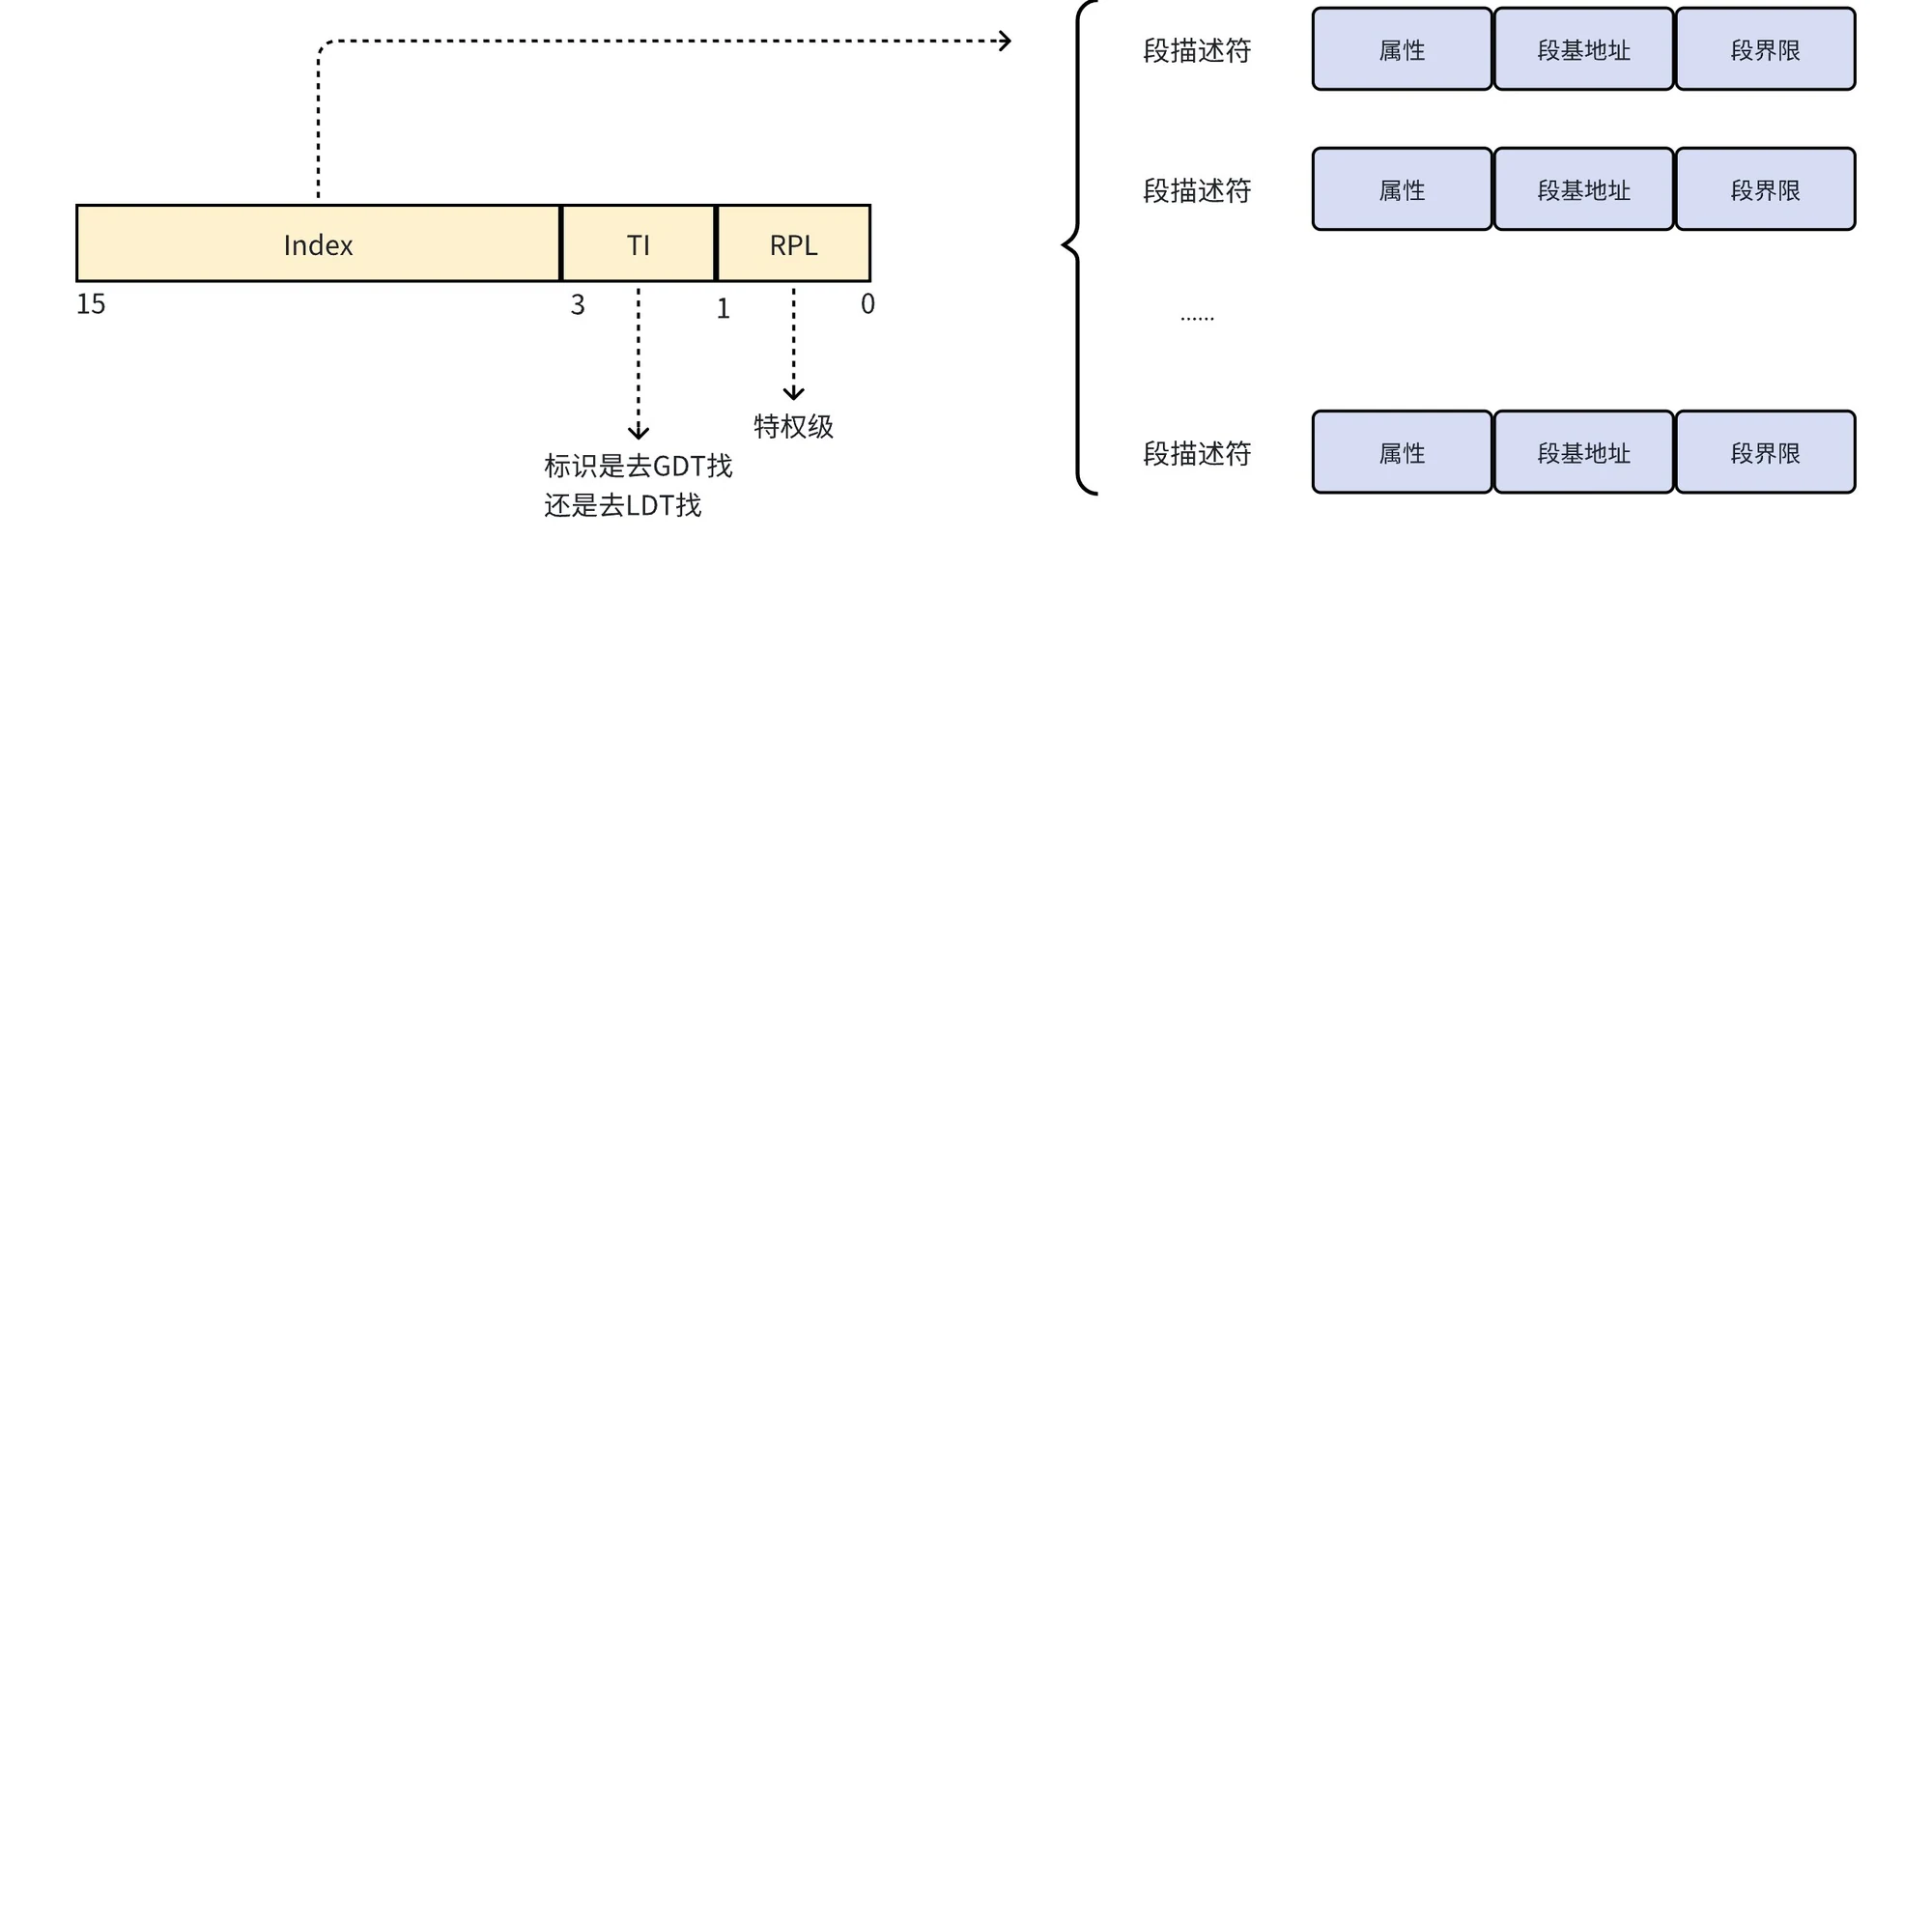
位 15..3  Index,0 到 8191,对应 GDT 里的 8192 个描述符
位 2      TI,0 查 GDT,1 查 LDT
位 1..0   RPL,请求特权级,0 到 3
Index = 0 那一项是空描述符,永远不能用;在 32 位保护模式下把 0 装进段寄存器会立刻触发异常,这其实是硬件在帮你抓"忘了初始化段寄存器"。
权限检查里有三个数字:CPL 是当前代码段的特权级,来自 CS 选择子的低 2 位;DPL 是目标段的特权级,写在描述符里;RPL 是这次访问"声称"的特权级,写在你拿的选择子里。访问数据段时,判定规则是
max(CPL, RPL) <= DPL 才允许课件只写了"RPL 低于 DPL 就拒绝",漏了 CPL。为什么要多一个 RPL?用户程序可以把一个指向内核数据段、低 2 位写成 0 的选择子交给内核去用;只看 CPL,内核在 Ring 0 就会替它开门。带上 RPL 后取两者中更弱的那个,塞进来的 0 也救不了它。
寻址到这里得到的是线性地址,不是物理地址。386 同时引入了分页,线性地址还要再按页表翻译一次。
32 位偏移把分段架空,剩下的是碎片
32 位偏移本身就能覆盖 4GB,一个段足够表达整个地址空间。理论上每个任务能用 GDT 8192 项加 LDT 8192 项、每段 4GB,合计 64TB,而当时的物理内存连 4GB 都不到。分段"把大空间切成小块"的能力已经没有实际价值。
操作系统做了个务实的决定:段机制保留,因为 x86 硬件要求每次访问都过一遍段检查;但把所有段的基址设成 0、界限设成最大。于是"基址加偏移"里的基址永远是 0,线性地址等于偏移本身。这叫平坦模式(flat model),Linux 就是这么做的,内核段和用户段基址都是 0,只是 DPL 不同(内核 0,用户 3)。
到了 64 位,CS、DS、ES、SS 的基址被硬件强制为 0 且不可改,只剩 FS、GS 还能当基址用;线程局部存储靠 arch_prctl(ARCH_SET_FS, addr) 设置 FS 来实现。
分段还留下一个粒度问题。在没有分页的机器上,平坦模式把整个进程当成一大段,进程地址空间必须以连续的方式映射到物理内存。课件那个例子很直接:
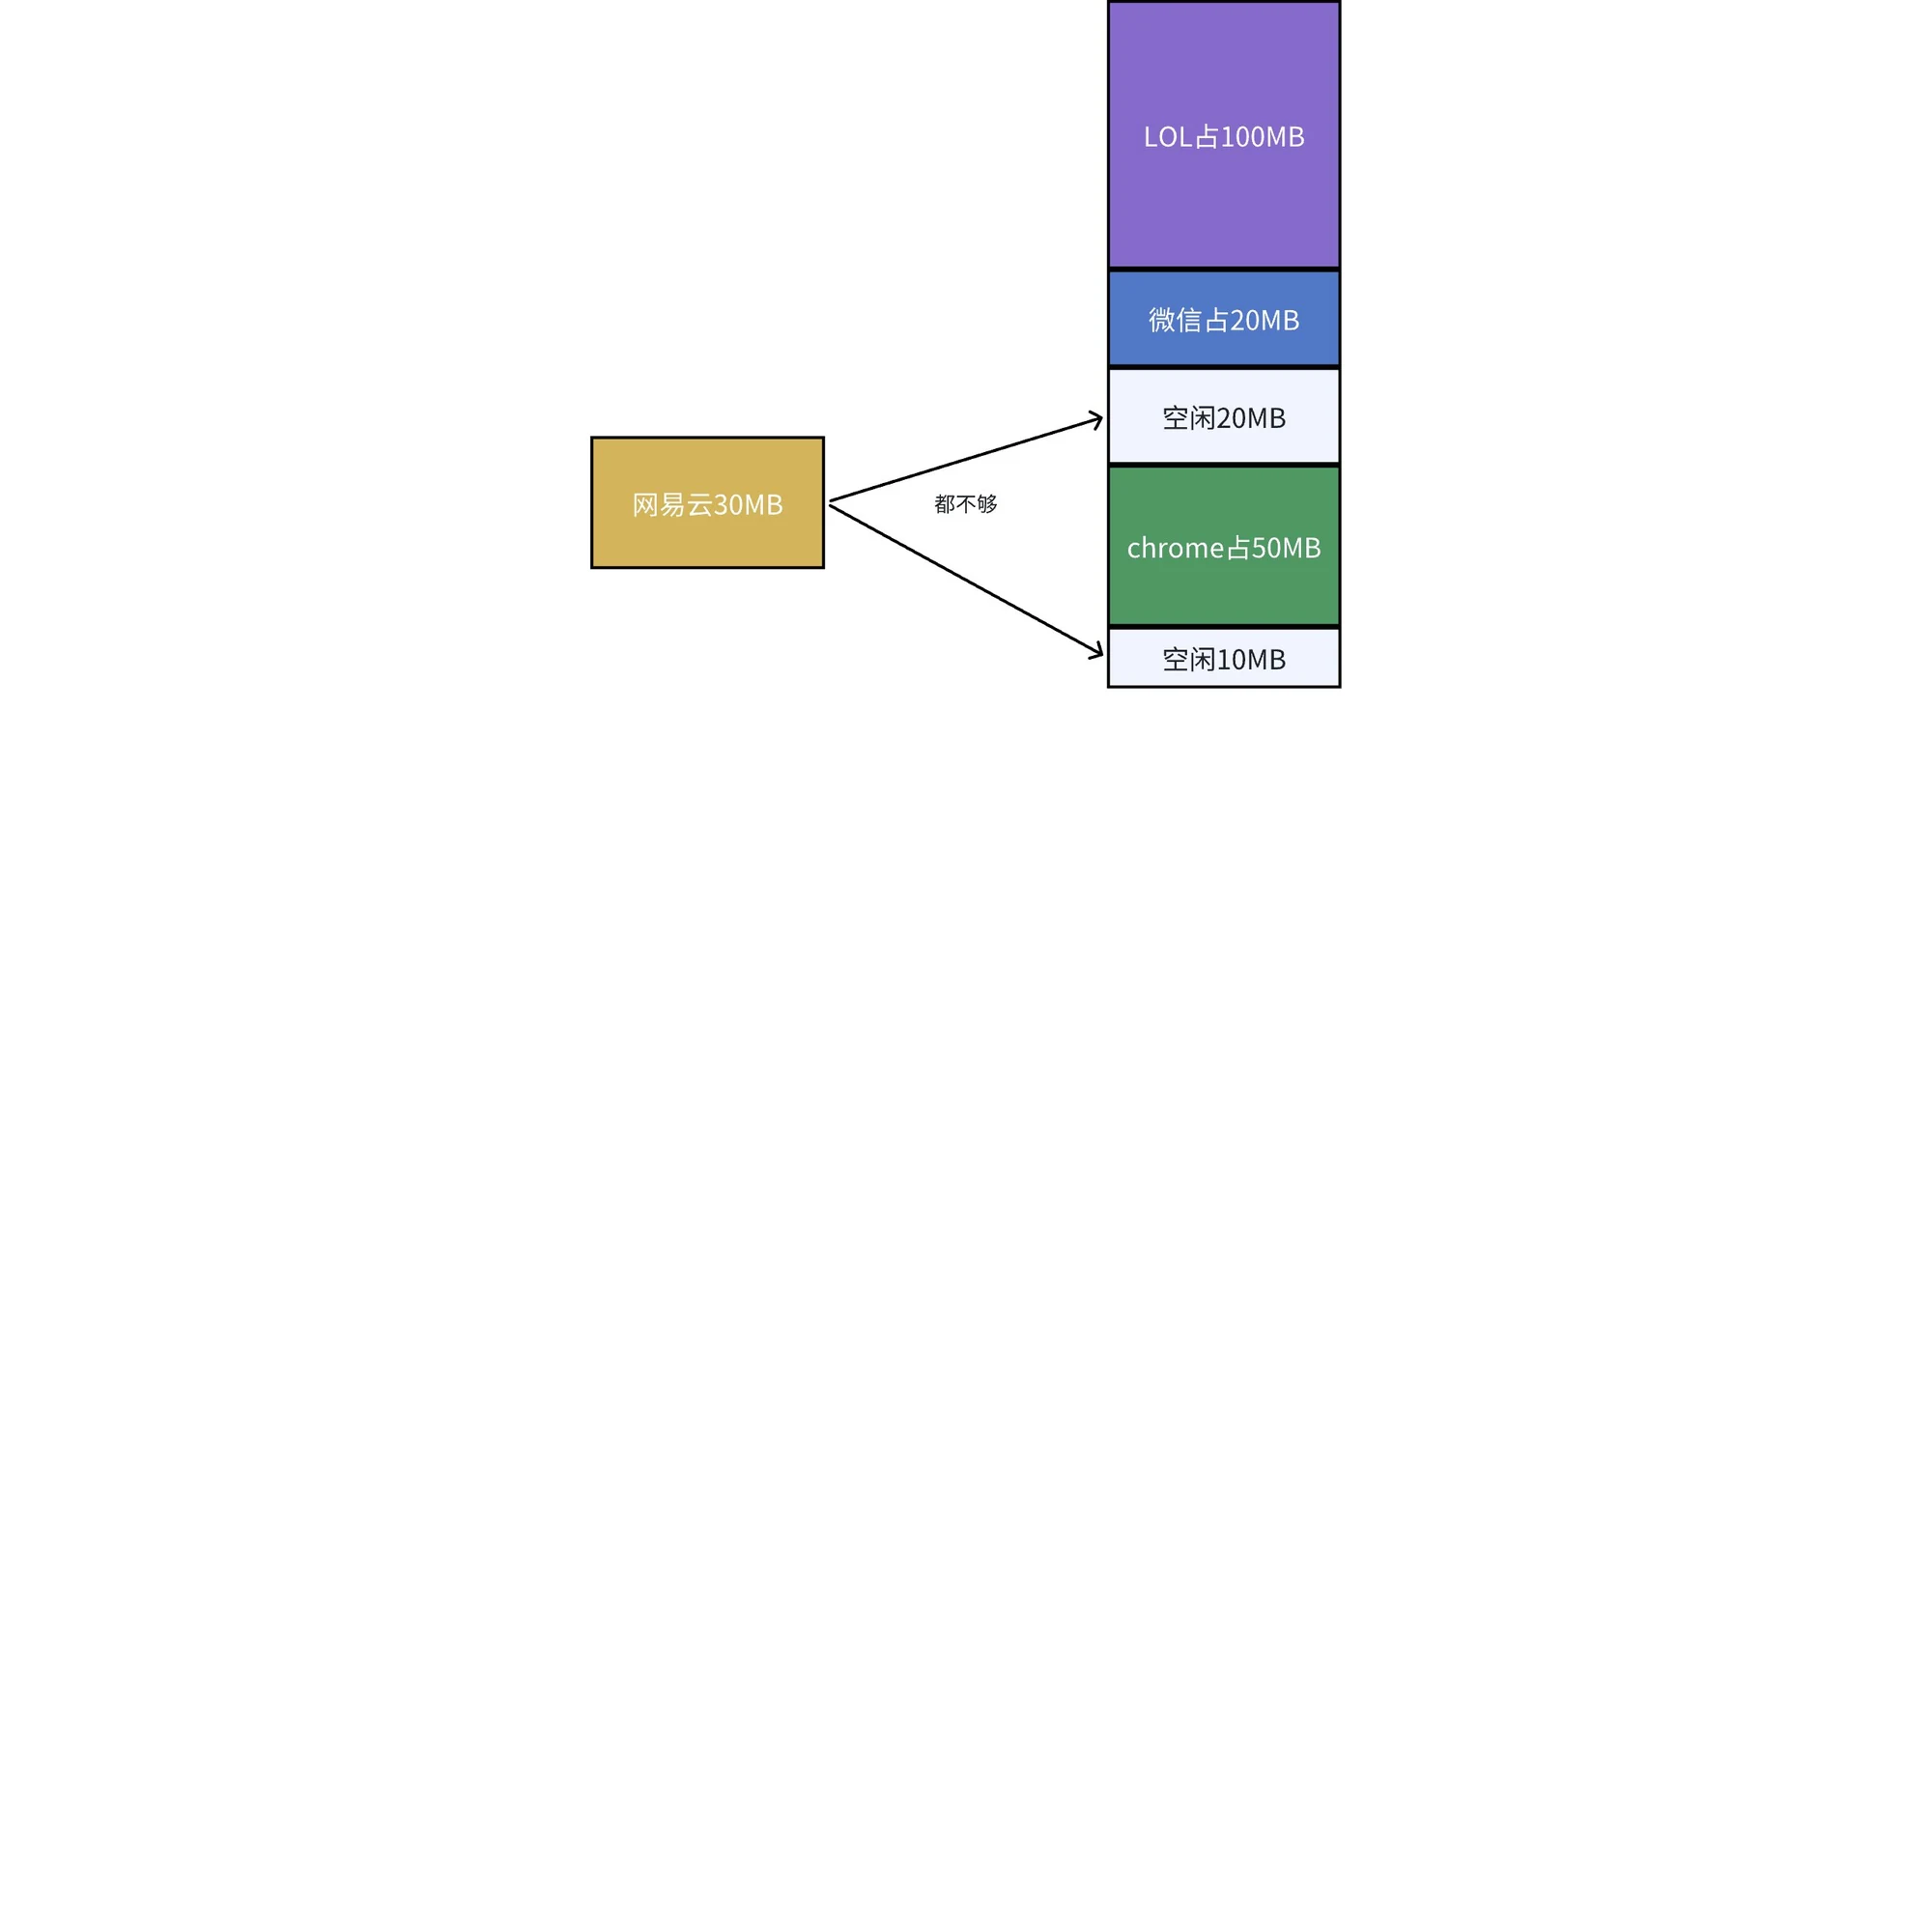
总空闲 30MB,网易云正好要 30MB,就是装不进去。要么把 chrome 的 50MB 先换到磁盘、再挪回来,让两段空闲连成一片,要么干等。分段解决了"表达力",没解决"粒度"。
分页把切分单位改成 4KB
分页换了切法:不按程序结构切,按固定大小的块切。物理内存等分成 4KB 一页(page frame),虚拟空间也等分成 4KB 一页,页对页映射。网易云的 30MB 变成 7680 个页,两段 20MB 和 10MB 的空闲也是页,页可以任意拼,不需要搬 chrome。
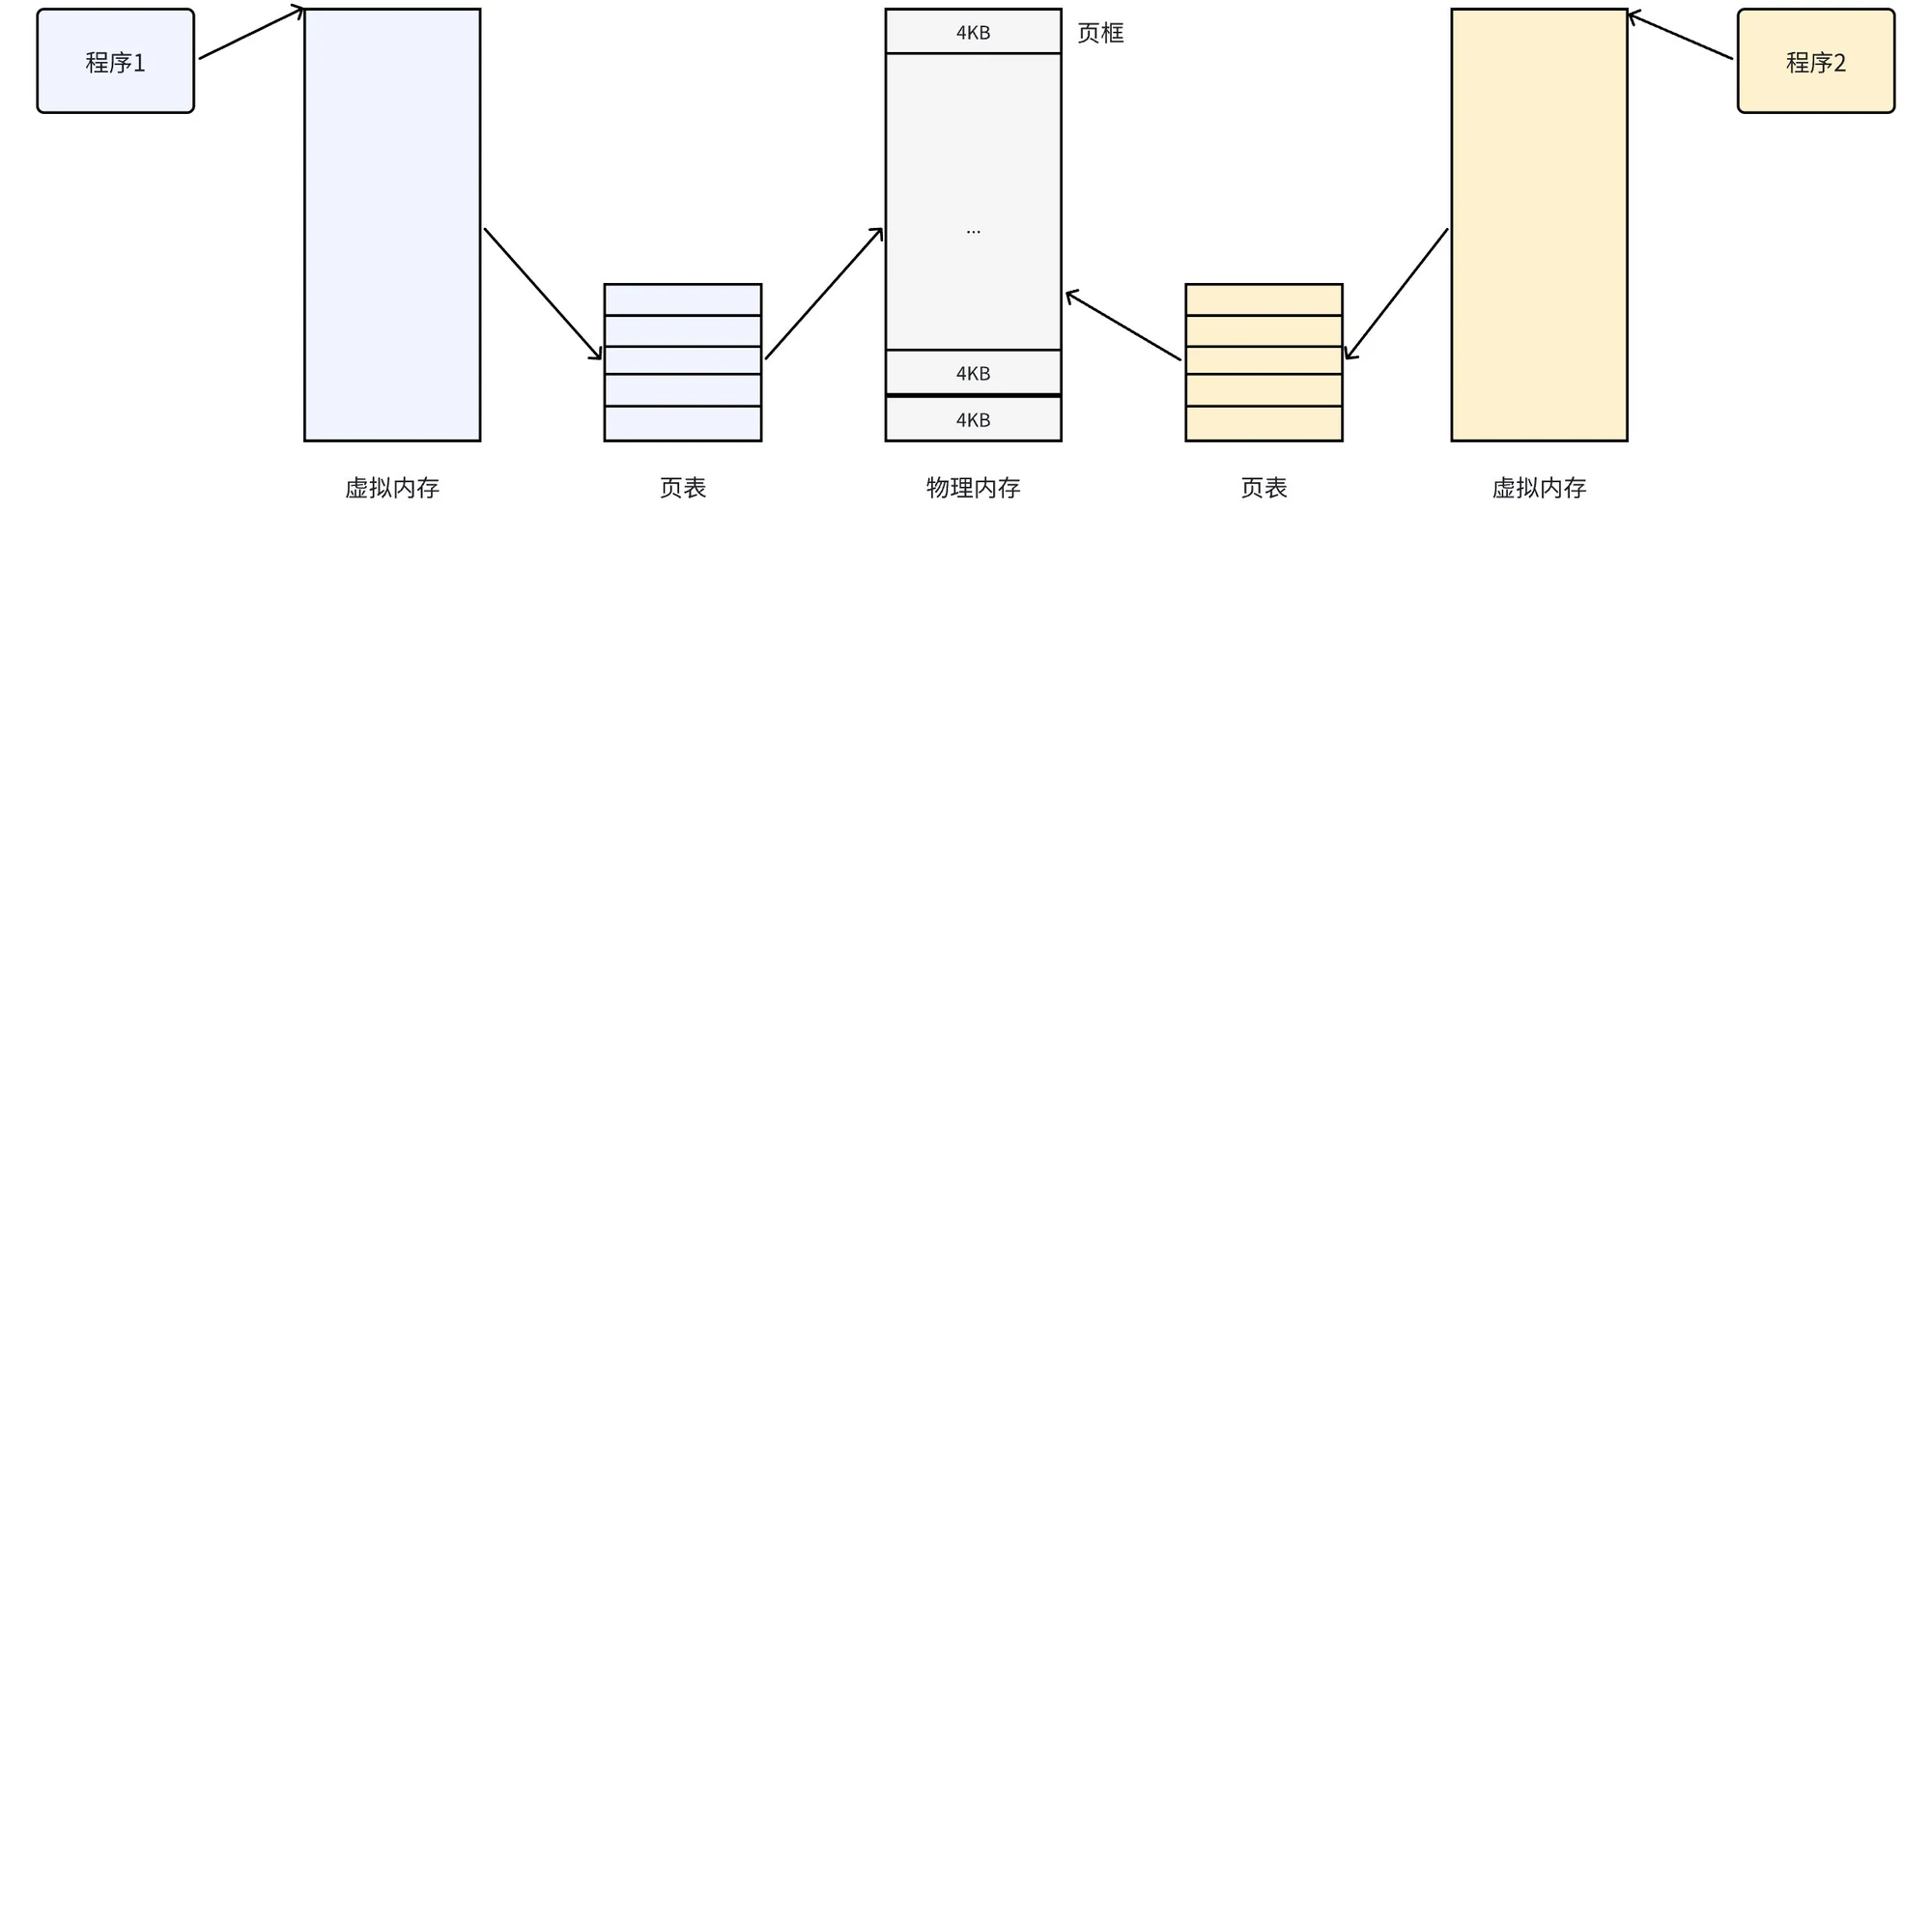
分页顺带解决三件事:换出的粒度从整段变成几页;程序启动不必把整个文件读进内存,缺页再补;每个进程有自己的页表,A 的虚拟地址在 B 的页表里根本翻译不出来,隔离从约定变成了硬件保证。
代价是内部碎片:4KB 的页只用了 100 字节,剩下 3996 字节也浪费。内存管理的权衡从来不是"消除碎片",而是把大块的外部碎片换成小块、可控的内部碎片。
为什么是 4KB?页越小,页表项越多、页表本身越大、TLB 一次能覆盖的范围越小;页越大,末尾那页浪费越多、缺页要搬的数据越多、写时复制的粒度越粗。386 选了 4KB,一直用到现在;需要大页的场景另开 2MB 和 1GB 档位。
课件有一句"分页机制是内存平坦模型的基础",这句把两件事绑死了。分段和分页是正交的:只要基址为 0、界限最大,不开分页(CR0.PG = 0)也是平坦的。分页负责的是虚拟地址到物理地址的映射与隔离,不是平坦的前提。
课件另一句"处理器仍然按照段机制加段偏移来定位一个物理地址"也不够准。段机制产出的结果是线性地址,分页再把线性地址翻译成物理地址;两段路是串联的,这就是段页结合。Linux 下"虚拟地址"和"线性地址"可以当同义词,原因是段基址为 0,线性地址等于偏移。
一级页表装不下 4GB,所以有二级和四级
32 位、4KB 页时,虚拟地址切成三段:高 10 位页目录索引、中间 10 位页表索引、低 12 位页内偏移。每级 1024 项,每项 4 字节,一张页表正好 4KB。
为什么不用一级?一级要为 4GB 空间准备 100 万个表项,每个进程 4MB,几十个进程就把内存吃光。两级的好处是空的那一大片可以整段不建:进程只用了 8MB,页目录里对应的项才指向二级页表,其余项为空。省下来的内存来自地址空间的稀疏性,不是"多一级就更省"这个动作本身。
64 位时代层级从两级变成四级:PML4、PDPT、PD、PT,每级 9 位,页内偏移还是 12 位,拼出 48 位虚拟地址。变多是不得已:64 位虚拟地址宽得离谱,必须靠多级稀疏表把用不到的地址空出来。Ice Lake 之后还有五级,每级再 9 位,虚拟地址扩到 57 位。
页表项里有几个关键位:P 在不在内存,RW 可写,US 用户可访问,A 访问过,D 脏。A 和 D 是换页算法的原材料:靠"访问过"判断哪些页还热,靠"脏"判断换出时要不要写回磁盘。
每次访存都让 CPU 走一遍页表,太慢,所以 MMU(内存管理单元)里有一层 TLB(Translation Lookaside Buffer),缓存最近的虚拟页到物理页框的翻译。命中就一步到位;没命中才去内存里走页表,四级页表意味着一次 miss 最多访问四次内存,再加上真正取数据的一次。进程切换会换页表,TLB 通常要刷新;PCID 能让部分翻译在切换后继续有效。大页的价值也在这里:2MB 一页,覆盖同样范围需要的 TLB 项少得多。
缺页异常和写时复制
页表项 P = 0 时,CPU 访问这个地址会触发缺页异常(page fault,教材常叫缺页中断,严格说它是异常不是中断)。内核拿到出错地址和错误码,判断原因:地址不在进程的合法映射里,给 SIGSEGV;地址合法但页没装进内存,就分配一个物理页框,从文件读入或填零,改好页表项,再回到那条指令重新执行。从磁盘读的叫 major fault,不需要 I/O 的叫 minor fault。
写时复制(copy-on-write,COW)用的也是这套机制。fork 时内核不复制父进程的私有物理页,只复制页表,并把父子双方的私有可写页在页表里标成只读;谁先写,谁触发保护异常,内核这时才复制那一页,把双方的权限改回来。没被写过的页一直共享,fork 的成本从"拷整个地址空间"降到"拷页表"。
一次 mov eax, [0x400000] 走完的路
把零件装起来,下面这张图把两段翻译串在了一条线上:
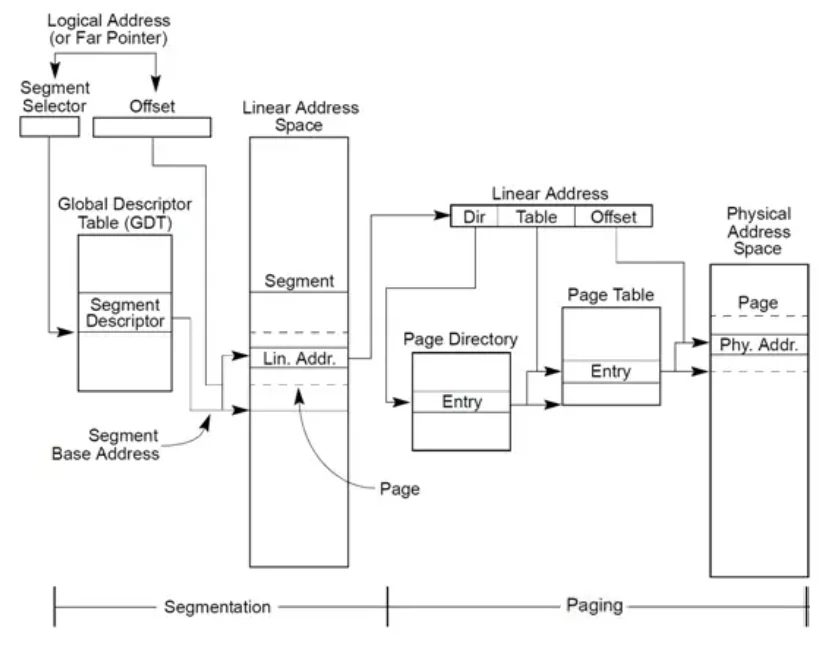
假设程序执行 mov eax, [0x400000],按 32 位二级页表走:
- CPU 拿到逻辑地址:
DS里的选择子加 32 位偏移0x400000。汇编里写的那个数只是偏移,选择子是隐含的。 - 用选择子查 GDT,拿到段基址(Linux 平坦模式下是 0)、界限和 DPL,做边界与权限检查。
- 基址加偏移算出线性地址
0x400000。 - MMU 先查 TLB;没命中就用
CR3里的页目录物理基址,取线性地址高 10 位查 PDE,PDE 指向页表,再用中间 10 位查 PTE,PTE 里存物理页框号。 - 物理页框号左移 12 位,拼上页内偏移。
- 发到内存总线。第 4 步如果遇到
P=0,触发缺页异常,内核补好页表后重新执行这条指令。
由此有三个能直接背下来的结论:通用寄存器里存的地址一定是虚拟地址,只有 CR3 这类专门存物理地址的寄存器例外;段机制没有关掉,它一直在跑,只是基址为 0 让它是恒等变换;Linux 下"虚拟地址"和"线性地址"可以当同义词,原因还是基址为 0。
想看自己机器上这套映射,读 /proc/self/maps 就够:
cat /proc/self/maps
getconf PAGESIZE
每行是 起始-结束 权限 偏移 设备 inode 路径。你会看到 [stack]、[heap]、[vvar]、可执行文件的几个映射,还有一堆没有路径的匿名映射。这些地址全是虚拟的,物理页框在哪里,进程看不到。
还没有评论 — 第一条由你来留。