一根网线接通两台计算机,不等于它们能通信。线路上跑的是电信号,0 和 1 靠频率或电平高低表示;一台机器用频率编码,另一台用强弱编码,两边都自称"用二进制传数据",实际一个字节也传不过去——这就像两个人都遵守"说话要有来有回"的规则,一个说中文,一个说葡萄牙语。
通信要成立,双方得约定到字节这一级:位怎么编码、一次发多少、字段怎么排、出错怎么办。这套约定就是协议。
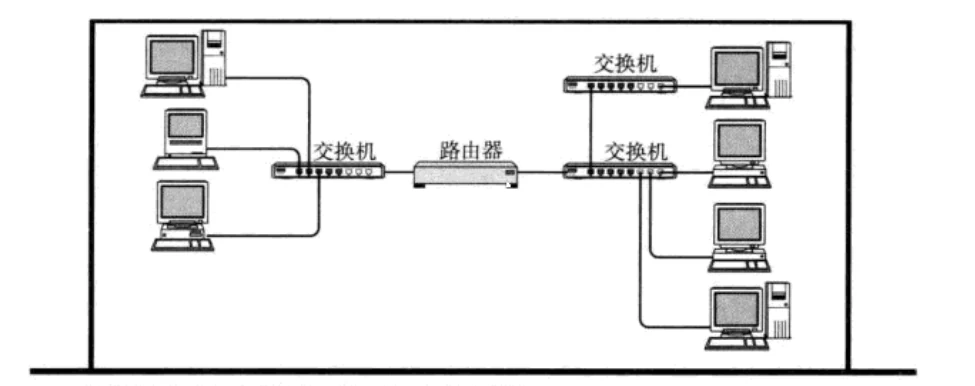
独立模式、局域网、广域网
最早的计算机彼此独立,数据靠人搬;每个人守着自己那台机器上的业务数据,换一台机器就得重新录一遍。后来机器连起来,数据能共享了。规模再扩大,连接方式分出两种名字:局域网 LAN(Local Area Network)用交换机和路由器把一片区域内的机器连在一起;广域网 WAN(Wide Area Network)把远隔千里的机器连起来。这两个词只是相对概念,一个国家级网络从更大的视角看,也不过是个大一点的局域网,没有"多少公里算 LAN"这种硬标准。
协议要由所有人遵守,就得有人定标准。IEEE 管 802 系列(以太网、无线局域网),ISO 管 OSI 参考模型,IETF 通过 RFC 发布互联网协议,ITU 管电信标准。这几家的产物决定了后来所有实现的样子:IPv4 地址为什么是 32 位、端口为什么是 16 位,都能追到某份标准里的取舍。
分层:两层就够说明问题,真实协议栈要更多
协议本身是软件。软件一大就拆模块,拆完模块之间只留接口,这样改一层不必动另一层。课件用打电话的例子把这个好处演示得很清楚:
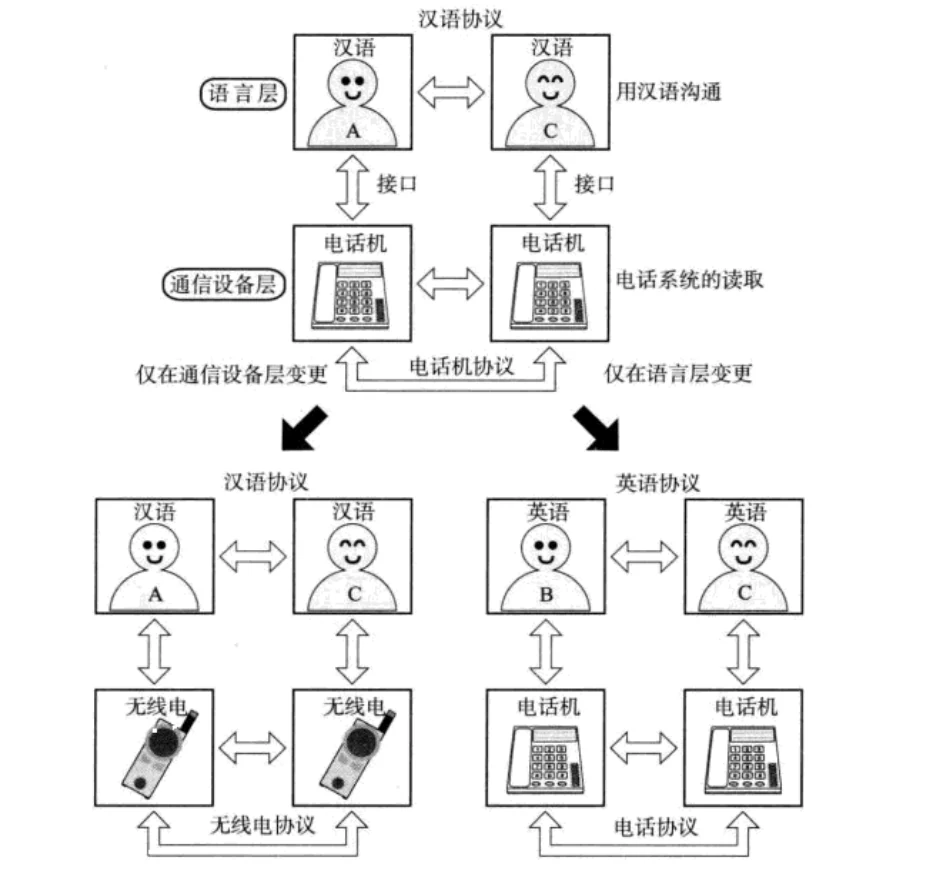
OSI(Open System Interconnection,开放系统互连)七层模型是 ISO 给出的参考框架,把网络从逻辑上分成应用、表示、会话、传输、网络、数据链路、物理七层。它最大的贡献是把"服务、接口、协议"三个概念分开:这层给上层提供什么、上下层怎么调用、同层之间怎么对话。它的毛病是复杂且难落地——表示层做编码转换、压缩加密,会话层做会话管理,这些工作在工程里基本留在用户态库里,没法塞进操作系统内核。所以实际实现的是五层。
| 层 | 负责什么 | 典型协议与设备 |
|---|---|---|
| 应用层 | 应用程序之间的沟通 | HTTP、SMTP、FTP、Telnet;代码在这一层 |
| 传输层 | 两台主机之间的数据传输,TCP 保证可靠 | TCP、UDP;内核里 |
| 网络层 | 地址管理与路由选择 | IP、ICMP;路由器 |
| 数据链路层 | 相邻设备之间帧的传送与识别,帧同步、冲突检测、差错校验 | 以太网;交换机、网卡驱动 |
| 物理层 | 光/电信号的传递方式 | 双绞线、光纤、电磁波;集线器 |
物理层离代码最远,讨论软件时常常直接省略,于是有了"TCP/IP 四层模型"这个叫法。
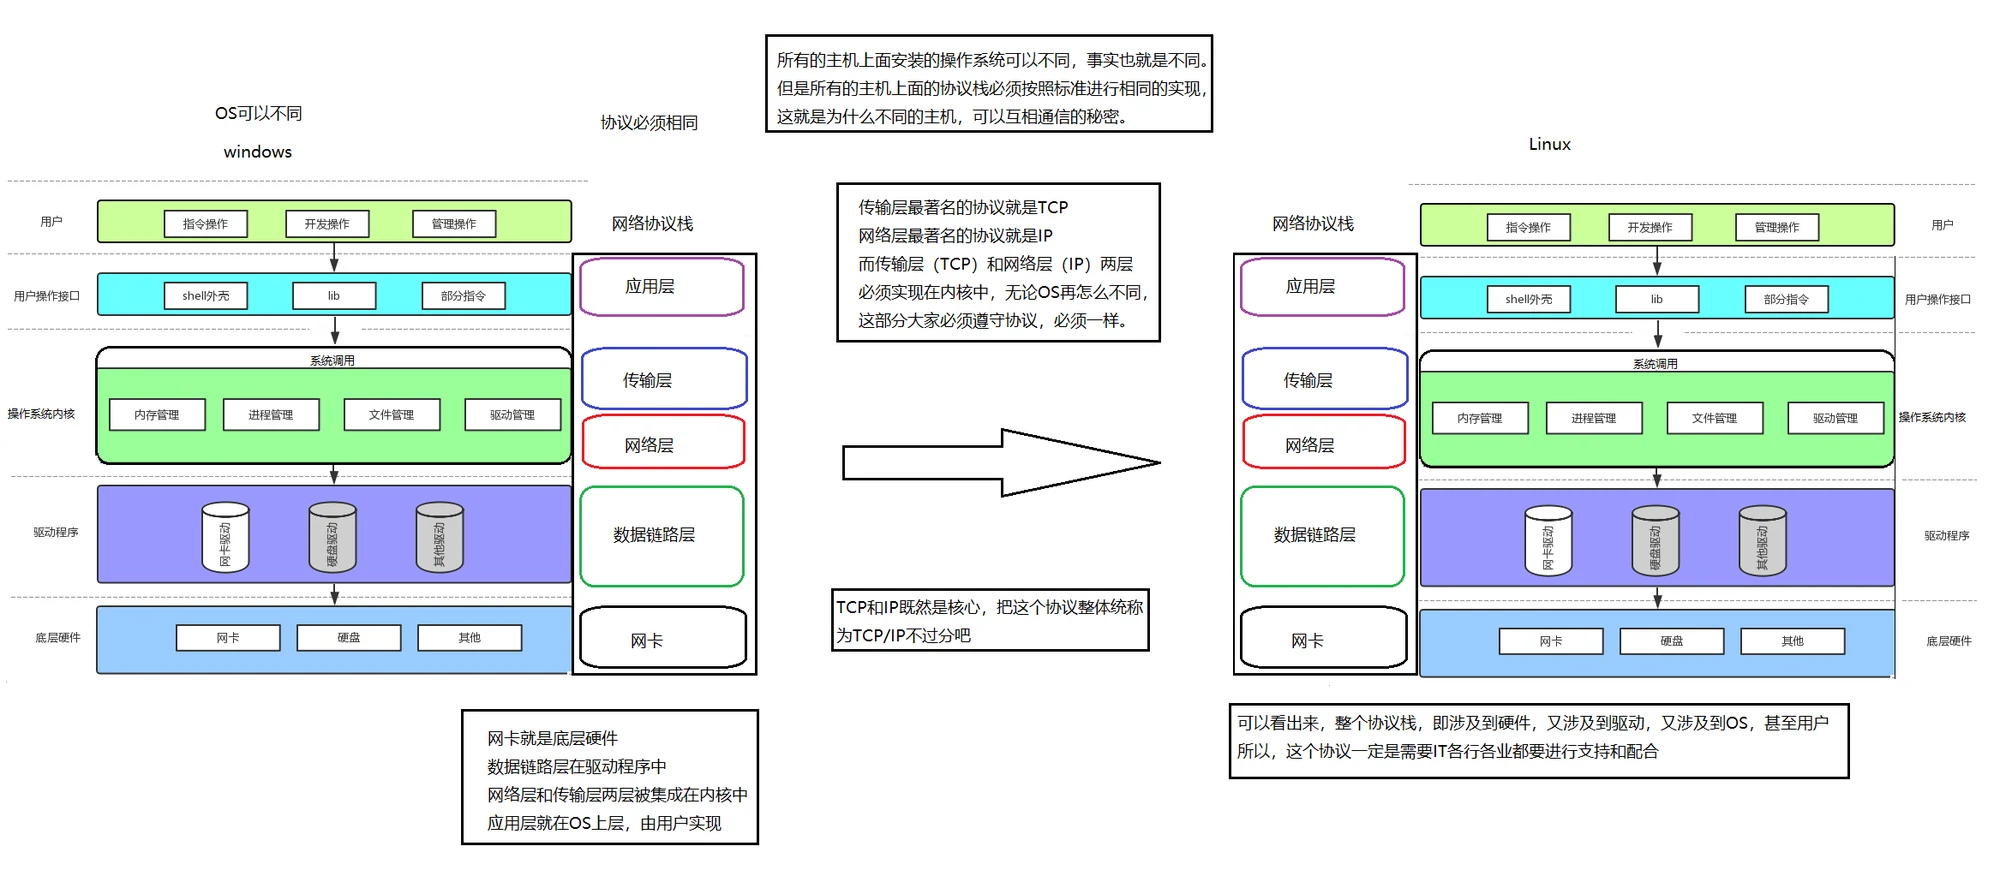
每台设备只实现自己该管的那几层
分层不只是纸面上的划分,它决定了硬件和软件各自做到哪一层:
- 一台主机,操作系统内核实现传输层到物理层;
- 一台路由器,实现网络层到物理层;
- 一台交换机,实现数据链路层到物理层;
- 一台集线器,只实现物理层。
这个对应关系不是绝对的:三层交换机能在网络层转发,路由器的端口转发也碰到了传输层的端口概念。
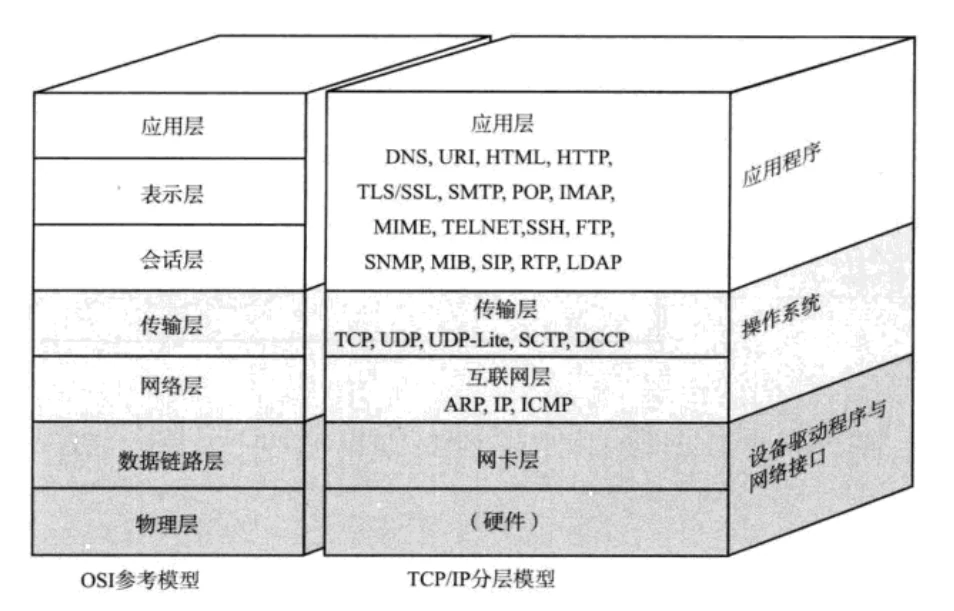
TCP/IP 与操作系统的关系也能从这张图读出来:应用层是用户写的进程,传输层、网络层在内核,链路层落在驱动。写网络程序时调用的 socket、sendto,入口都在内核里的传输层实现。所以网络编程写的是应用层程序,用的是传输层提供的接口。
为什么要专门有 TCP/IP?单机内部其实早有协议:设备和内存之间有内存协议,设备和磁盘之间有 SATA、IDE、SCSI,只是感知不到,因为链路短、环境可控、出问题的成本低。网络把距离拉远了,新问题随之出现——目标在哪、路怎么走、包丢了怎么办、发出去的数据对方怎么知道该交给谁。
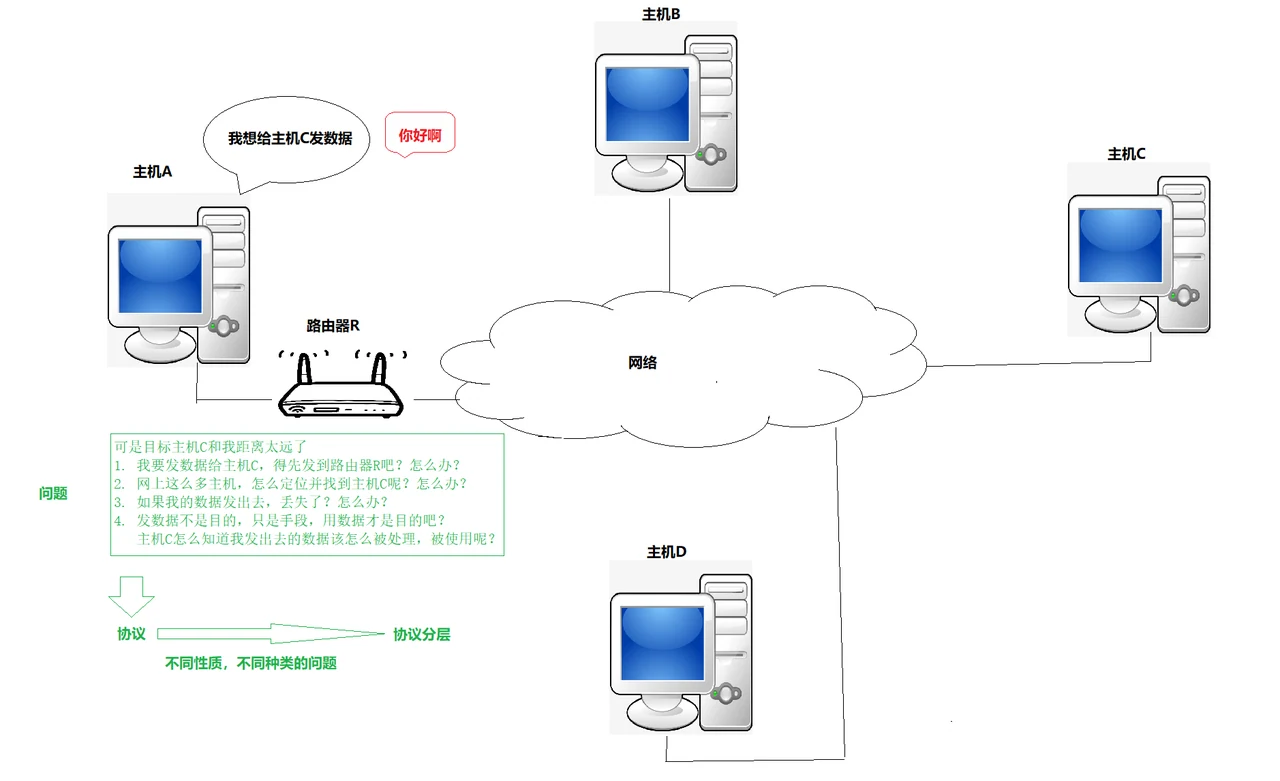
TCP/IP 能分层,前提是这些问题本身能分层。把"信号怎么翻转"和"包该往哪走"混在一个模块里,任何一处改动都会牵动全身。
协议的代码形态:两端认识同一个结构体
操作系统的源码主要用 C/C++ 写,于是协议在代码里最朴素的样子,就是一个双方都定义过的结构体:
struct protocol
{
    int a;
    int b;
    int c;
};
A 把这 12 个字节发出去,B 用同一个类型读回来,a、b、c 就是原来的 10、20、30,中间没有任何解析步骤。双方都认识这个类型,天然具备共识——所谓协议,就是通信双方都认识的结构化数据类型。
这个"巧合"有前提:两端的编译器对 int 宽度、结构体对齐、填充规则的处理必须一致,字节序也得相同。一边 LP64 一边 LLP64,long 就变了;一边默认对齐一边 #pragma pack(1),字段偏移就错位;小端机器发出去的数字,大端机器读出来是另一个值。所以工程化的协议不靠"抄同一份 struct",它把每个字段的偏移、宽度、字节序写进文档,两端照文档编解码。
学一个陌生协议,先问两句:它怎么解包?它靠哪个字段把载荷交给上层?这两问答得出来,剩下的细节都是查表。
报文 = 报头 + 有效载荷
每层协议处理数据时,会在前面加一段自己的控制信息。这段就是报头,剩下的叫有效载荷:
报文 = 报头 + 有效载荷报头里至少要有三类信息:报头自身多长、载荷多长、上层用的是什么协议。往下走一层加一个首部,这个过程叫封装(Encapsulation);到了对端,每层剥掉自己的首部,再按首部里的"上层协议字段"把数据交给对应的上层,这叫分用(Demultiplexing)。
不同层对整份报文有不同叫法,读文档时别被术语绕住:
| 层 | 叫法 | 英文 |
|---|---|---|
| 传输层 | 段 | segment |
| 网络层 | 数据报 | datagram |
| 链路层 | 帧 | frame |
传输过程也不是"直接从 A 发到 B"。数据先自顶向下逐层交给下层,最后由最底层的介质发出去;对方从底层收上来,再自底向上逐层交付。任何一层的报头,都是给对端同层看的,不是给最终程序看的。
MAC 决定这一跳,IP 决定终点
同一局域网内的两台主机可以直接通信,靠的是每台主机在链路上有唯一标识:MAC 地址。它长 48 位、6 个字节,写成 08:00:27:03:fb:19 这样的十六进制加冒号,出厂时烧在网卡里,通常唯一(虚拟机里的 MAC 是软件生成的,可能重复)。Windows 下 ipconfig /all 能看到它。
课件说 MAC "不能修改",这句不准确。Linux 上 ip link set dev eth0 address 02:00:00:00:00:01 就能改,不少网卡驱动支持。MAC 唯一性来自出厂分配,不是物理不可写。
共享式以太网在同一时刻只允许一台机器发送,多台同时发就会发生数据碰撞;所有发送方都要做碰撞检测和碰撞避免,没有交换机时,一个以太网就是一个碰撞域。收到帧的主机靠目标 MAC 判断这条报文是不是发给自己的。
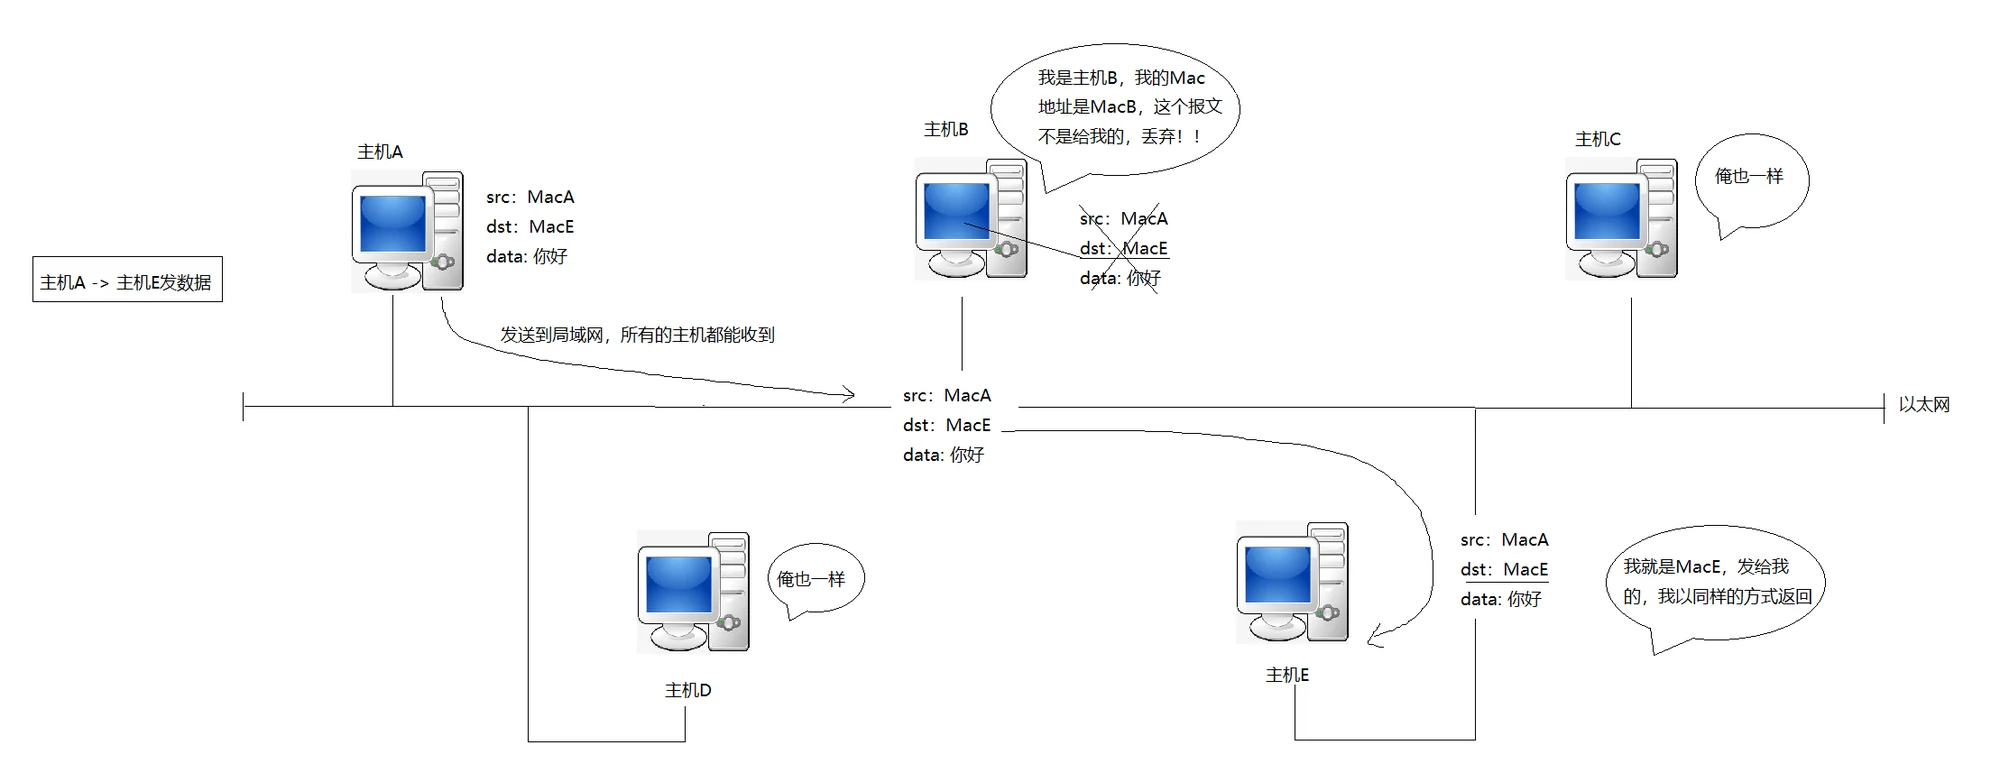
跨网段就不同了。帧到不了那么远,数据必须先交给路由器;路由器把帧解到网络层,查路由表决定下一跳,再用一条新的链路层头重新封装,交给下一段链路。
IPv4 地址是 4 字节、32 位整数,写成 192.168.0.1 这样的点分十进制,每一段是一个字节,取值范围 0–255。它标识的是网络中的主机,也是路由选择的依据。
两句话概括这对地址的区别:目的 IP 是长远目标,它说明最终要去哪台主机,一路基本不变;MAC 是下一阶段目标,它只说明这一段链路上下一站是谁,每经过一个路由器都要重写。
课件在这里留了一句"IP 地址在整个路由过程中一直不变(目前,我们只能这样说明,后面再修正)"。那个修正就是 NAT:家用宽带、云主机的公网出口都会改写源 IP 和端口,所以抓包里看到源地址变了,不是抓错了。
IP 层存在的意义也在这里:它提供一层虚拟网络,把以太网、WiFi、光纤、4G 全部统一成"IP 网络",把底层差异挡在上面。写一个 HTTP 服务,不必为每种物理介质写一版。
数据到主机不是终点:端口与 socket
IP 把包送到主机,但数据是给人的,人通过进程拿到数据——聊天的是 QQ,下载的是迅雷,浏览网页的是浏览器。把包交给正确的进程,才是传输层的活。
端口(port)是传输层的内容,16 位整数,用来告诉操作系统这份数据该交给哪个进程。IP + 端口 标识网络上某台主机上的某个进程。
课件的端口划分写的是"0–1023 知名端口,1024–65535 动态分配",这是过时说法。按 RFC 6335(BCP 165),端口分三段:
| 范围 | 名称 | 分配方式 |
|---|---|---|
| 0–1023 | System Ports(知名端口) | IANA 固定分配,HTTP 80、SSH 22 在这段 |
| 1024–49151 | User Ports(注册端口) | IANA 按申请分配 |
| 49152–65535 | Dynamic / Private Ports | 不分配,临时端口从这里取 |
Linux 给客户端分配的临时端口也没铺满整段,它的区间写在 /proc/sys/net/ipv4/ip_local_port_range,新内核默认是 32768 60999。这也回答了"客户端一行 bind 都没写,源端口从哪来"。
端口为什么不用 pid 代替?pid 只在本机有意义,重启就换号,一个进程还能同时服务成千上万条连接;而且把进程管理和网络绑在一起,系统会强耦合。10086 这个号码所有人都能拨,接电话的客服却随时在换——端口扮演的是那个公开号码,pid 是坐在工位上的人。所以传输层单独有了一套编号:一个进程可以绑定多个端口,一个端口默认只能被一个进程占用。
传输层报文里带两个端口:源端口和目的端口,分别说明"谁发的""发给谁"。{源 IP, 源端口, 目的 IP, 目的端口} 这个四元组标识一次通信的两端,把 IP 和端口合起来就是 socket。网络通信的本质,仍然是进程间通信。
两个传输层代表,先用四个词记住性格:
| 协议 | 连接 | 可靠性 | 数据形态 |
|---|---|---|---|
| TCP | 有连接 | 可靠传输 | 面向字节流 |
| UDP | 无连接 | 不可靠传输 | 面向数据报 |
网络字节序只约束多字节数值
内存里的多字节数据有大小端之分,网络数据流同样有。发送方按内存地址从低到高把缓冲区发出去,接收方也按低到高存进接收缓冲区,于是约定:先发出的字节是低地址,后发出的是高地址。TCP/IP 规定网络字节序为大端,也就是低地址放高字节。
课件写"所有发送到网络上的数据,都必须是大端的",这句话容易理解偏。真正被约束的只有多字节数值字段:端口号、IP 地址、报文里的长度字段。字符串、字节数组、单字节标志不涉及字节序,"你好"的 UTF-8 字节原样发出去就行;把 char 数组也做一遍"大端转换"没有意义。
为让同一份代码在大端机和小端机上都跑得对,标准库提供四个转换函数:
uint16_t htons(uint16_t hostshort);   /* host -> network,16 位,端口用 */
uint16_t ntohs(uint16_t netshort);    /* network -> host,16 位 */
uint32_t htonl(uint32_t hostlong);    /* host -> network,32 位,IP 用 */
uint32_t ntohl(uint32_t netlong);     /* network -> host,32 位 */
h 是 host,n 是 network,s 是 short(16 位),l 是 long(32 位)。主机是大端时这些函数原样返回,是小端时才真正翻转字节。所以调用它们不能靠运行结果验证,只能按"这个值会不会写进报文发出去"来判断:返回值看起来没变,也可能已经转过了。
socket 接口与 sockaddr 家族
传输层在内核,访问它只能通过系统调用。IPv4 常用的五个:
int socket(int domain, int type, int protocol);                 /* 创建套接字 */
int bind(int sockfd, const struct sockaddr *addr, socklen_t len); /* 绑定本地地址端口 */
int listen(int sockfd, int backlog);                            /* 转入监听,TCP 服务端 */
int accept(int sockfd, struct sockaddr *addr, socklen_t *len);   /* 取出一个连接,TCP 服务端 */
int connect(int sockfd, const struct sockaddr *addr, socklen_t len); /* 发起连接,TCP 客户端 */
socket 的 domain 用 AF_INET(IPv4)或 AF_INET6(IPv6),type 用 SOCK_DGRAM(UDP)或 SOCK_STREAM(TCP),protocol 通常写 0 让内核按前两个参数推断。
这五个接口的地址参数都写成 struct sockaddr *,因为同一套 API 要同时支持 IPv4、IPv6 和 UNIX Domain Socket,而它们的地址格式并不相同。IPv4 的地址结构定义在 netinet/in.h:
struct in_addr
{
    uint32_t s_addr;          /* 32 位 IPv4 地址,网络序 */
};

struct sockaddr_in
{
    sa_family_t    sin_family; /* 地址族,AF_INET */
    in_port_t      sin_port;   /* 16 位端口,网络序 */
    struct in_addr sin_addr;   /* 32 位地址,网络序 */
    char           sin_zero[8];/* 填充,让长度与 sockaddr 对齐 */
};
sockaddr 的头两个字节是地址族,内核据此判断后面该按哪种结构解释;sockaddr_in 就是"地址族 + 端口 + IP"三部分。调用时把 &local 强转成 (struct sockaddr *),第三个参数传 sizeof(local)——不要传 sizeof(struct sockaddr),它只有 16 字节,换上 IPv6 的地址结构就完全不够。
还没有评论 — 第一条由你来留。