epoll 不是“更快的 select”。它换了一套组织方式:fd 只在 epoll_ctl 时注册一次,内核为每个注册项挂一个回调;状态变化时回调把该项塞进就绪链表;epoll_wait 只检查链表,不再遍历全部 fd。
#include <sys/epoll.h>

int epoll_create(int size);
int epoll_create1(int flags);
int epoll_ctl(int epfd, int op, int fd, struct epoll_event *event);
int epoll_wait(int epfd, struct epoll_event *events, int maxevents, int timeout);
三个调用各管一段
epoll_create 创建一个 epoll 实例,返回句柄 fd。size 从 Linux 2.6.8 起被忽略,但必须传一个大于 0 的值,否则返回 EINVAL。用完要 close。新代码一般用 epoll_create1(EPOLL_CLOEXEC),免得这个 fd 泄漏到 exec 出来的子进程。
epoll_ctl 是注册函数,op 有三种:
EPOLL_CTL_ADD:把 fd 和关心的事件加进 epoll 实例。EPOLL_CTL_MOD:修改已注册 fd 的事件。EPOLL_CTL_DEL:把 fd 从实例里摘掉。它不关闭 fd,该close的还要自己close。
epoll_wait 收集就绪事件。events 是调用方分配好的数组,内核只往里面写,不会替你分配内存。maxevents 是数组容量,必须大于 0;它和 epoll_create 的 size 没有关系。课件写“maxevents 的值不能大于创建 epoll_create 时的 size”,这是 2.5 时代 size 还有意义时的残留说法;从 2.6.8 起 size 被忽略,maxevents 只要求大于 0,想传 1000 而 size 传 10 完全合法。timeout 单位毫秒,0 立即返回,-1 永久阻塞。返回值是本次写进数组的事件个数,0 表示超时,小于 0 表示出错。
eventpoll:一棵树加一条链
调用 epoll_create 时,内核创建一个 struct eventpoll。它有很多内部字段,和这一节直接相关的是这两个:
struct eventpoll {
    struct rb_root  rbr;      /* 红黑树根,存放所有注册项 */
    struct list_head rdlist;  /* 就绪链表,存放已就绪、等待返回的项 */
};
上面是只保留相关成员的摘录,真实结构还包含锁、等待队列等字段。每注册一个 fd,内核建一个 struct epitem。这个结构同时挂在两个地方:
struct epitem {
    struct rb_node   rbn;      /* 红黑树节点 */
    struct list_head rdllink;  /* 就绪链表节点 */
    struct epoll_filefd ffd;   /* 文件与 fd 信息 */
    struct eventpoll *ep;      /* 所属的 eventpoll */
    struct epoll_event event;  /* 关心的事件 */
};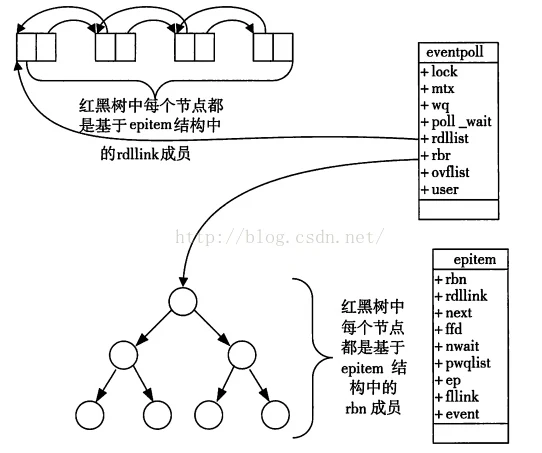
树负责“找得到、不重复”:同一个 fd 重复 ADD 会被 EEXIST 拒绝,查找和插入是 O(log n),n 是注册项总数。课件写“插入时间效率是 lgn,其中 n 为树的高度”,这里把 n 说错了:树高是 O(log n),不是 n;红黑树的节点总数才是那个 n。链表负责“就绪的排队”:一个 epitem 从树里被找到后,通过 rdllink 挂到 rdllist。
真正把事件塞进链表的不是 epoll_wait,是回调。EPOLL_CTL_ADD 时,内核通过 ep_ptable_queue_proc 为目标文件建一个 eppoll_entry,里面包含一个 wait_queue_t 项、指回 epitem 的 base 和等待队列头 whead;这个等待项的 func 被设成 ep_poll_callback,然后 add_wait_queue 挂到 socket 的等待队列上。网卡收数据、协议栈把数据放进接收队列后,sock_def_readable 调用 wake_up_interruptible,__wake_up_common 遍历等待队列并执行 ep_poll_callback,后者执行 list_add_tail(&epi->rdllink, &ep->rdllist)。epoll_wait 醒来只看 rdllist 空不空。
这条链上有两个容易忽略的点。eppoll_entry 是“挂在文件等待队列上的那一个等待项”,epitem 是“注册在 epoll 里的那一个监视项”,两者通过 base 关联;一个 fd 被多个 epoll 实例监视时,每个实例都有自己的 epitem 和 eppoll_entry。回调执行时拿的是 epitem,所以它知道该往哪个 eventpoll 的 rdllist 里加。
所以复杂度要分开说:
| 操作 | 复杂度 |
|---|---|
epoll_ctl 增删改 | O(log n),n 是注册项总数 |
| 检查有没有就绪项 | O(1),只看链表头 |
| 把就绪项拷进用户数组 | O(k),k 是本次就绪数 |
“epoll 是 O(1)”指的是等待这一步与总连接数无关,不是整个 API 都 O(1)。连接很多、活跃很少时,这个差别才明显;三五个固定连接,epoll 和 poll 的差距可以忽略。
事件位:有些能申请,有些只能收
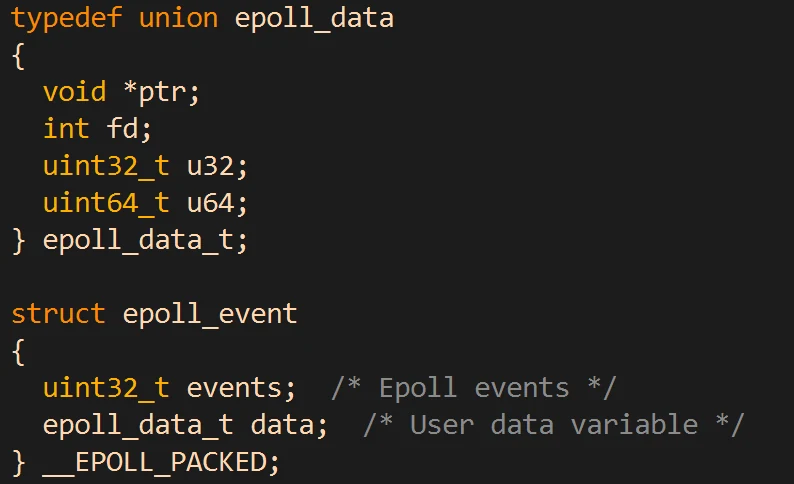
typedef union epoll_data {
    void    *ptr;
    int      fd;
    uint32_t u32;
    uint64_t u64;
} epoll_data_t;

struct epoll_event {
    uint32_t     events;  /* 关心的事件,也用于回填 */
    epoll_data_t data;    /* 用户数据,内核原样带回 */
};
可以写进 events 的位:
| 位 | 含义 |
|---|---|
EPOLLIN | 可读 |
EPOLLOUT | 可写 |
EPOLLPRI | 有紧急数据可读 |
EPOLLRDHUP | 对端关闭了写方向(需显式申请) |
EPOLLET | 边缘触发模式 |
EPOLLONESHOT | 只触发一次,之后需重新武装 |
EPOLLEXCLUSIVE | 多个 epoll 实例监视同一 fd 时只唤醒一个 |
EPOLLERR 和 EPOLLHUP 不需要申请。只要 fd 出错或挂断,它们一定会出现在返回的 events 里。这一点和 poll 的 POLLERR/POLLHUP/POLLNVAL 一样:
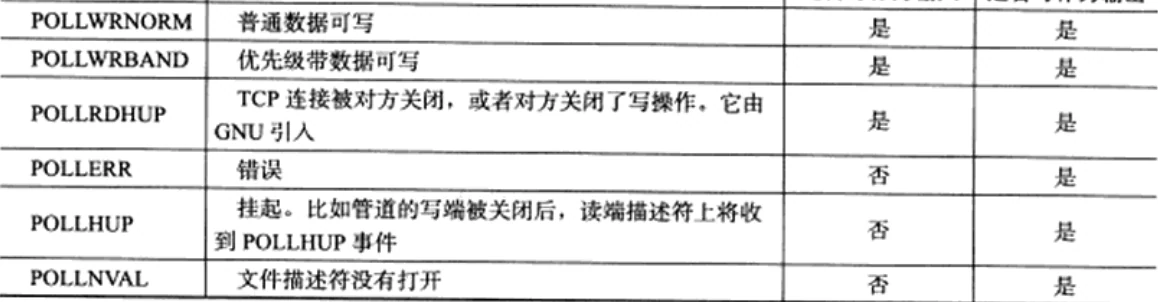
因此判断事件必须按位与:
if (evs[i].events & EPOLLIN)  { /* 可读 */ }
if (evs[i].events & EPOLLERR) { /* 出错 */ }
写成 evs[i].events == EPOLLIN,遇到 EPOLLIN | EPOLLRDHUP 或 EPOLLIN | EPOLLHUP 就会漏判。对端正常关闭恰好走这条组合。
mmap 的说法是错的
网上常见的说法是:epoll 用 mmap 把内核的就绪队列映射到用户态,因此省掉了数据拷贝。这个说法不成立。struct epoll_event 数组是调用方在用户空间自己分配的,内核必须把就绪项从内核内存拷进这个数组,epoll_wait 的返回值只是拷了多少个。课件在这一点上的判断是对的:没有 mmap 映射就绪队列这回事。
epoll 省下的是“每轮把全部 fd 从用户态拷进内核、再全部扫一遍”,不是“把结果拷回用户态”这一步。只要结果要出现在用户数组里,这次拷贝就省不掉。
LT 与 ET:区别在“沿”还是“电平”
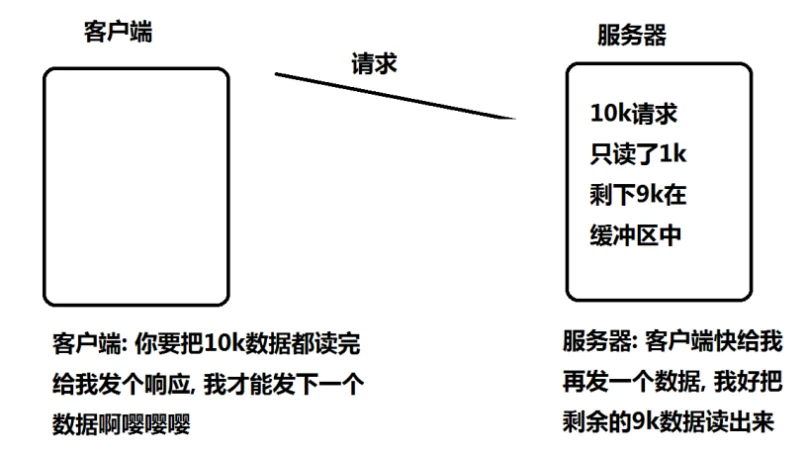
先把场景摆出来:socket 的接收缓冲区里来了 2 KB 数据,epoll_wait 返回可读;程序只 read 了 1 KB,还剩 1 KB。
LT(水平触发,level-triggered)是默认模式。只要缓冲区里还有数据,下一次 epoll_wait 仍然会立刻返回并报告可读。直到数据被读空,它才不再提醒。LT 允许你每次只处理一部分,剩下的下次再说;阻塞和非阻塞 fd 都能用。
ET(边缘触发,edge-triggered)只在状态发生跳变时提醒。数据从无到有,是一次沿;读到一半不读了,缓冲区里剩下的数据不会产生新的沿,下一次 epoll_wait 不会因为它返回。只有又来了新数据,或者状态再次变化,才会再提醒。
课件那句“ET 模式下,文件描述符上的事件就绪后,只有一次处理机会”,容易被读成“这个 fd 一辈子只通知一次”。准确的说法是:同一次状态变化只通知一次。fd 再次发生状态跳变,还会通知。
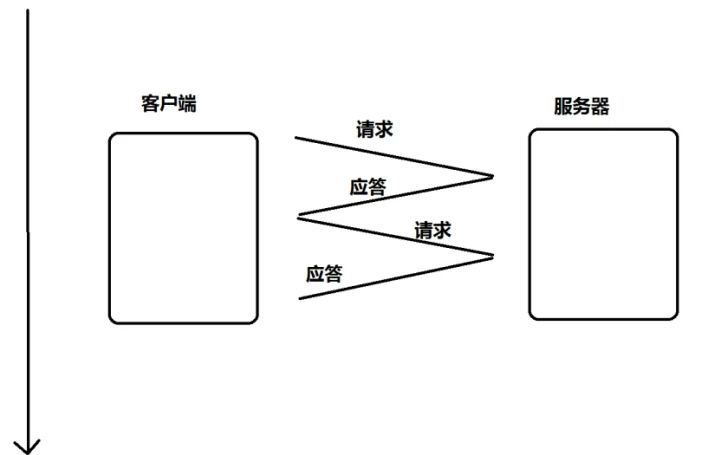
这张图解释的是 ET 下最常见的死锁。客户端发 10 KB,服务器只读 1 KB,剩 9 KB 在缓冲区;客户端等响应才发下一批,服务器等下一批数据才继续读。双方都没错,但事件不会再来了。
ET 为什么必须配非阻塞
接口不强制 ET 配非阻塞。内核不会因为 fd 是阻塞的就把 EPOLLET 拒掉。逼你非阻塞的是“读到没有为止”这件事需要退出条件。
ET 要求一次把缓冲区读干净,代码就得循环 read。如果 fd 是阻塞的,循环到缓冲区空的那一次 read 不会返回 EAGAIN,而是把线程挂起,整条事件循环被这一条连接拖住。只有非阻塞 fd 才会在没数据时立刻返回 EAGAIN/EWOULDBLOCK,给循环一个安全的出口。
正确的读循环是:
for (;;) {
    ssize_t n = recv(fd, buf, sizeof(buf), 0);
    if (n > 0) {
        /* 处理这一段数据,继续读 */
        continue;
    }
    if (n == 0) {
        /* 对端关闭 */
        break;
    }
    if (errno == EINTR)
        continue;
    if (errno == EAGAIN || errno == EWOULDBLOCK)
        break;              /* 读干净了,回去等事件 */
    /* 真正的错误 */
    break;
}
课件 ET 版里的 RecvNoBlock 在 EAGAIN 时执行 continue,这会把“读干净了”变成死循环:缓冲区已经空,下一次 recv 还是 EAGAIN,循环永远出不来。SendNoBlock 在 EAGAIN 时同样 continue,也是忙等。两处都应当 break,把控制权还给事件循环。写方向 EAGAIN 表示发送缓冲区满了,数据不能丢,要留在用户态发送缓冲区里,等 EPOLLOUT 再续发。
ET 的写侧比读侧麻烦。send 不保证一次发完,EAGAIN 之后剩余数据必须自己存着,并临时注册 EPOLLOUT;发空后立刻用 EPOLL_CTL_MOD 摘掉写事件。只做 echo 的 demo 可以不写这层,真实服务器早晚要补。
LT 没有这些问题:读不完下次还会被提醒,写不完下次也还会被提醒。ET 减少的是“没读完导致的重复通知”,不是凭空加速。如果 LT 版代码本来就每次读干净,两者的唤醒次数差不多。
ONESHOT、EXCLUSIVE 与惊群
EPOLLONESHOT 让一个 fd 触发一次后自动失效,之后必须用 EPOLL_CTL_MOD 重新武装。课件写“需要再次把这个 socket 加入到 EPOLL 红黑树里”,方向对但动作不对:fd 还在树上,只是事件被禁用了,重新 ADD 会得到 EEXIST,要用 MOD 覆盖事件位。它解决的是多线程处理同一条连接的问题:一个线程被唤醒后开始读,其他线程不该再被同一个 fd 叫醒。处理完、缓冲区状态重新安排好,再武装一次。
EPOLLEXCLUSIVE 从 Linux 4.5 起可用,用在 EPOLL_CTL_ADD 上,让多个 epoll 实例监视同一个 fd 时,内核只唤醒其中一个等待者。它针对的是监听 fd 的惊群:多个进程或线程各自 accept,新连接到来时全被叫醒,只有一个能成功。EPOLLEXCLUSIVE 不能用在 EPOLL_CTL_MOD,也不能和 EPOLLONESHOT 一起用。它只是减少无效唤醒,不保证绝对公平,也不解决同一 epoll 实例内多个线程并发 accept 的竞争。
一份能跑的 LT 服务器
#define _GNU_SOURCE

/* epoll_lt_echo.c
 * 编译:gcc -std=c11 -Wall -Wextra epoll_lt_echo.c -o epoll_lt_echo
 * 运行:./epoll_lt_echo,然后 nc 127.0.0.1 8888
 */
#include <arpa/inet.h>
#include <errno.h>
#include <fcntl.h>
#include <netinet/in.h>
#include <stdio.h>
#include <string.h>
#include <sys/epoll.h>
#include <sys/socket.h>
#include <unistd.h>

#define MAX_EVENTS 64

static int set_nonblock(int fd)
{
    int fl = fcntl(fd, F_GETFL);
    if (fl < 0)
        return -1;
    return fcntl(fd, F_SETFL, fl | O_NONBLOCK);
}

static void close_conn(int epfd, int fd)
{
    epoll_ctl(epfd, EPOLL_CTL_DEL, fd, NULL);  /* 只摘掉关心,不关闭 fd */
    close(fd);
}

int main(void)
{
    int lfd = socket(AF_INET, SOCK_STREAM, 0);
    if (lfd < 0) {
        perror("socket");
        return 1;
    }

    int yes = 1;
    setsockopt(lfd, SOL_SOCKET, SO_REUSEADDR, &yes, sizeof(yes));

    struct sockaddr_in addr;
    memset(&addr, 0, sizeof(addr));
    addr.sin_family = AF_INET;
    addr.sin_port = htons(8888);
    addr.sin_addr.s_addr = htonl(INADDR_ANY);

    if (bind(lfd, (struct sockaddr *)&addr, sizeof(addr)) < 0) {
        perror("bind");
        close(lfd);
        return 1;
    }
    if (listen(lfd, 128) < 0) {
        perror("listen");
        close(lfd);
        return 1;
    }

    if (set_nonblock(lfd) < 0) {
        perror("fcntl");
        close(lfd);
        return 1;
    }

    int epfd = epoll_create1(EPOLL_CLOEXEC);
    if (epfd < 0) {
        perror("epoll_create1");
        close(lfd);
        return 1;
    }

    struct epoll_event ev;
    memset(&ev, 0, sizeof(ev));
    ev.events = EPOLLIN;
    ev.data.fd = lfd;
    if (epoll_ctl(epfd, EPOLL_CTL_ADD, lfd, &ev) < 0) {
        perror("epoll_ctl ADD listen");
        close(epfd);
        close(lfd);
        return 1;
    }

    struct epoll_event evs[MAX_EVENTS];

    for (;;) {
        int n = epoll_wait(epfd, evs, MAX_EVENTS, -1);
        if (n < 0) {
            if (errno == EINTR)
                continue;
            perror("epoll_wait");
            break;
        }

        for (int i = 0; i < n; ++i) {
            int fd = evs[i].data.fd;
            uint32_t events = evs[i].events;

            if (fd == lfd) {
                for (;;) {
                    int cfd = accept(lfd, NULL, NULL);
                    if (cfd < 0) {
                        if (errno == EAGAIN || errno == EWOULDBLOCK)
                            break;       /* 连接已经接完 */
                        if (errno == EINTR)
                            continue;
                        perror("accept");
                        break;
                    }

                    memset(&ev, 0, sizeof(ev));
                    ev.events = EPOLLIN;
                    ev.data.fd = cfd;
                    if (epoll_ctl(epfd, EPOLL_CTL_ADD, cfd, &ev) < 0) {
                        perror("epoll_ctl ADD client");
                        close(cfd);
                    }
                }
                continue;
            }

            if (events & EPOLLIN) {
                char buf[4096];
                ssize_t r = read(fd, buf, sizeof(buf));
                if (r <= 0) {
                    close_conn(epfd, fd);
                    continue;
                }

                ssize_t sent = 0;
                while (sent < r) {
                    ssize_t w = write(fd, buf + sent, (size_t)(r - sent));
                    if (w <= 0)
                        break;
                    sent += w;
                }
                continue;
            }

            if (events & (EPOLLERR | EPOLLHUP)) {
                close_conn(epfd, fd);
            }
        }
    }

    close(epfd);
    close(lfd);
    return 0;
}
LT 版读一次就够:缓冲区里还有数据,下一次 epoll_wait 还会报可读。改成 ET 要做三件事:注册时 events 换成 EPOLLIN | EPOLLET;新连接 set_nonblock;把“读一次”换成上面那个读到 EAGAIN 的循环。监听 fd 若也用 ET,accept 必须循环到 EAGAIN,否则同时来一批连接时只能接一个,剩下的要等下一次状态跳变。
什么样的连接结构值得上 epoll
epoll 的收益来自“注册项很多、活跃项很少”。上万条客户端连接、任意时刻只有一部分在收发,这种入口服务适合 epoll。系统内部几台机器之间的固定长连接,总共三五个 fd,用 epoll 只是把代码写长,不会更快。
三者的账可以直接对照:
| select | poll | epoll | |
|---|---|---|---|
| 监视名单 | fd_set 位图,每次调用重建 | pollfd 数组,可长期保留 | epoll_ctl 注册一次 |
| 数量上限 | FD_SETSIZE,默认 1024 | 受内存限制 | 受 fd 上限和内存限制 |
| 每轮用户态到内核态 | 拷三张位图 | 拷整个数组 | 不拷名单,只拷就绪事件 |
| 每轮扫描 | 从 0 到 nfds - 1 | 遍历全部元素 | 只处理 rdllist 里的就绪项 |
| 返回内容 | 就绪位,还要 FD_ISSET 判断 | revents,还要遍历判断 | 就绪事件数组,直接按 data 分发 |
| 触发方式 | 只有 LT | 只有 LT | LT 和 ET |
另一个误判是“ET 一定比 LT 快”。ET 省的是重复通知,前提是 LT 代码没有一次读干净。写法正确时,两者的系统调用次数接近;写法不正确时,ET 会把问题从“多绕一圈”变成“连接卡死”。LT 是更安全的默认值,只有确认需要减少通知次数时再换 ET。
还没有评论 — 第一条由你来留。