POST http://job.xjtu.edu.cn/companyLogin.do HTTP/1.1
Host: job.xjtu.edu.cn
Connection: keep-alive
Content-Length: 36
Content-Type: application/x-www-form-urlencoded
这是一条从浏览器里抓下来的真实请求。首行是方法、目标、版本,下面一行一个头,空行之后是 36 字节的表单正文。注意请求行里的目标是一个绝对 URI——这是发给代理时的写法;直接发给源服务器时通常只写路径,例如 /companyLogin.do。两种形态都合法,解析器两种都得认。
这正是应用层协议的两种来源:自己约定一套(比如算两个数的计算器协议),或者用已经有人替你定好的那一套。HTTP 是后者,它的语法简单到可以手写解析,但每一条规则背后都有过坑。
报文的骨架只有四段
请求和响应的结构是对称的:一行起始行,若干头部,一个空行,然后是正文。起始行在请求里是"方法 目标 版本",在响应里是"版本 状态码 状态码描述"。
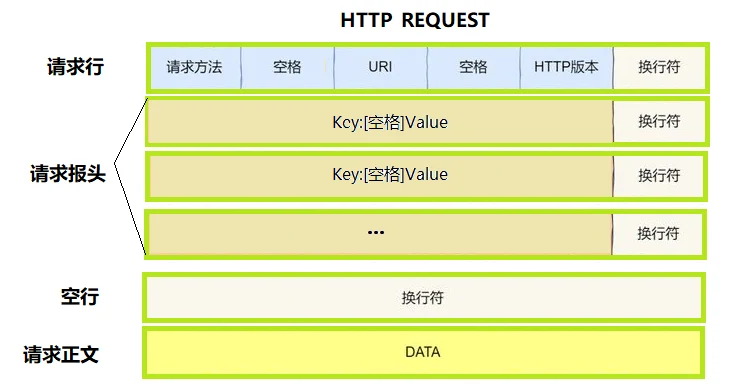
头部行的格式是 Key: Value,冒号后面允许有空格;空行表示头部结束,空行之后的全部字节都是正文。头部字段名不区分大小写,值区分。响应把起始行换成"版本 状态码 状态码描述",其余三段一一对应。这一层语法没有歧义,真正的难点全在"正文有多长",后面单独讲。
课件里的示例服务器用 sprintf(buf, "HTTP/1.0 200 OK\nContent-Length:%lu\n\n%s", strlen(hello), hello) 拼报文。Chrome 照样能显示页面,因为浏览器容错。标准要求的是 CRLF(回车加换行),严格的客户端、代理和安全设备不一定替你容错。能跑不等于合规,这和 TCP 粘包是同一类陷阱:本机自测通过,只证明你的客户端宽容。
URL、请求目标和百分号编码
URL 由协议、主机、端口、路径、查询串组成,请求行里的"目标"是其中的路径加查询串部分,不含协议和主机——主机放在 Host 头里,这正是 HTTP/1.1 支持虚拟主机的前提:同一个 IP 上可以挂多个站点,靠 Host 区分。
查询串里出现的 ?、:、/、& 这些字符,在 URL 里有语法含义,不能原样出现。转义规则是百分号编码(percent-encoding):把要传的字符按编码(现代网页一般是 UTF-8)拆成字节,每个字节写成 %XX,XX 是两位十六进制。中文"你"的 UTF-8 字节是 E4 BD A0,编码后是 %E4%BD%A0。
课件用"把字符转成十六进制,从右到左取 4 位,每 2 位做一位"来描述这个过程,这个描述是错的:百分号编码的作用单位是字节,不是"取 4 位"。按那套规则去编,编出来的串和标准实现不一致,服务端解出来必然乱码。浏览器地址栏里能直接看到真实结果:
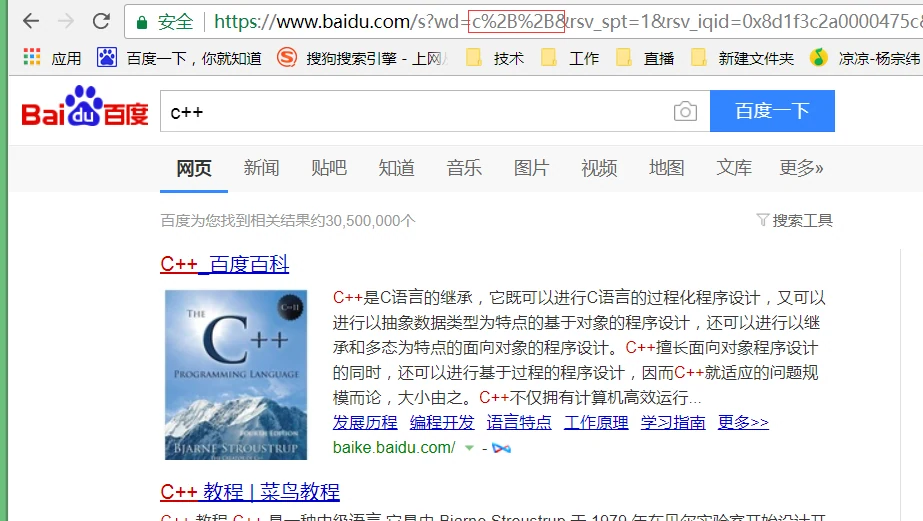
表单编码 application/x-www-form-urlencoded 还多一条约定:空格写成 +。所以真正的加号必须写成 %2B,否则会被解码成空格。同一个字符在两套规则下含义不同,解码方必须知道自己按哪套来。
方法决定语义,状态码写给中间设备
课件列了方法表,GET 取资源、POST 传实体主体、PUT 传文件到指定位置、HEAD 只要头部、DELETE 删除、OPTIONS 查支持的方法;表里还带了 TRACE、CONNECT、LINK、UNLINK。
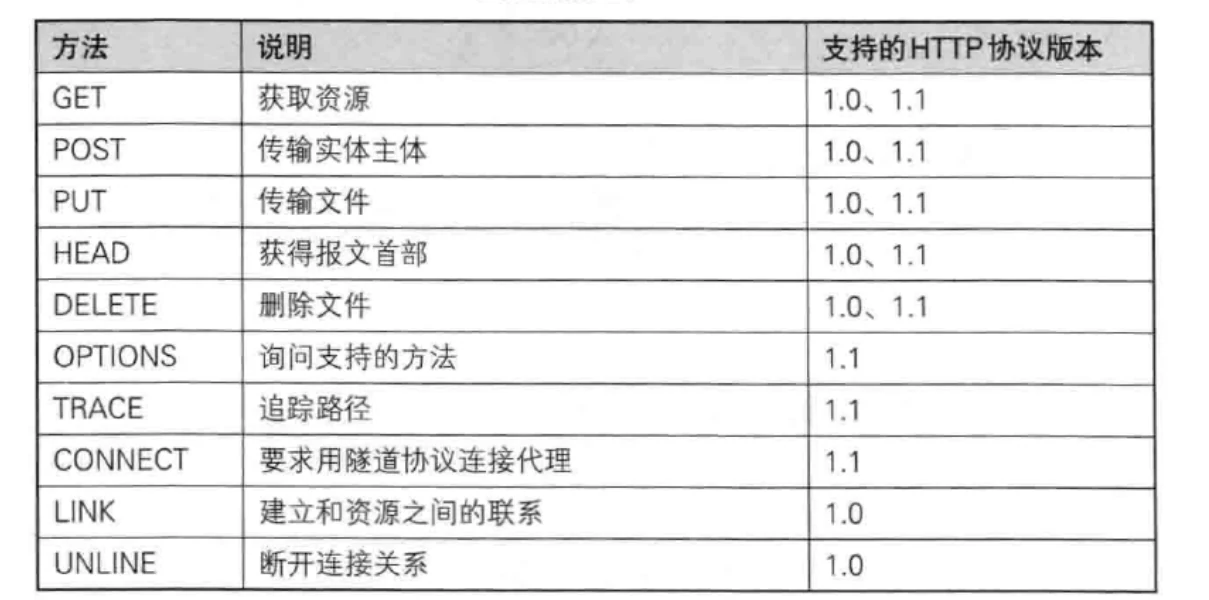
这张表的版本栏有一处需要修正。RFC 1945 定义的 HTTP/1.0 只有 GET、HEAD、POST 三个方法,PUT 和 DELETE 是 HTTP/1.1 才正式写进标准的;表里把它们的支持版本标成 1.0、1.1,是常见教材的简化写法。
比"哪个方法干什么"更要紧的是两个语义属性:安全(safe)和不改变服务器状态,幂等(idempotent)是执行一次和执行 N 次效果相同。GET、HEAD、OPTIONS 是安全的;PUT、DELETE 和它们一起是幂等的;POST 两个都不是。这条界线决定了谁能重试:网络抖一下,GET 和 PUT 可以放心重发,POST 不能,否则就是重复下单。支付接口要一个幂等键,根子在这里。
HEAD 的响应不能有正文,只回头部。用 curl -i 和 curl --head 对比同一台服务器,头部基本一致,后者的正文是空的——课件里两次抓到的 Content-Length 不同(2381 和 277),是因为两次请求之间页面内容变了,ETag 也跟着变了,不是 HEAD 把长度改小了。OPTIONS 的响应通常带 Allow: GET, HEAD, POST, OPTIONS,正文长度可以是 0;跨域预检(CORS)也走这个方法,响应里再带一组 Access-Control-Allow-*。一个不认识的服务器可能直接回 405 并带上 Allow,这比 404 更有信息量。
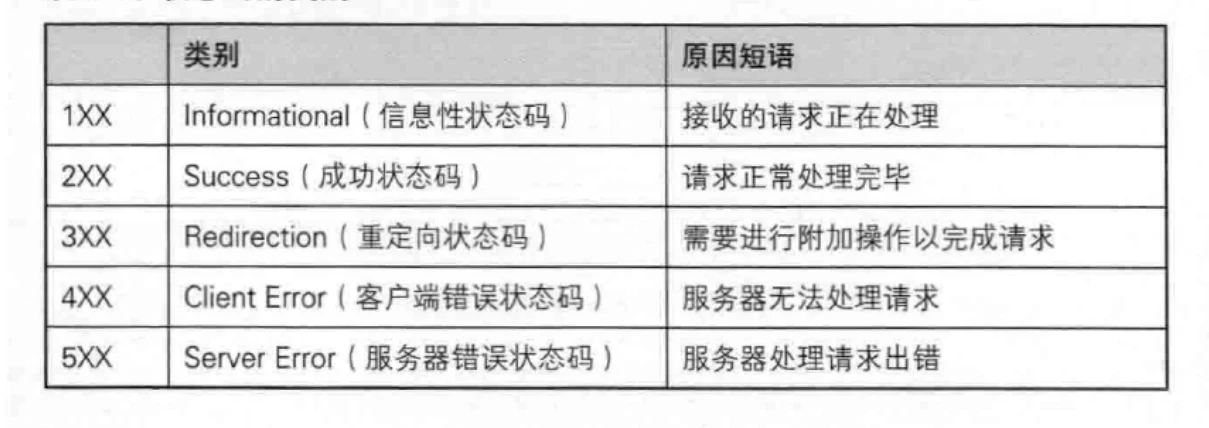
细节上最容易写错的是 3xx。301 永久移动,浏览器和搜索引擎会记住;302 是临时移动,历史语义很糊——早年很多客户端收到 302 后会把 POST 改成 GET 再发。为了把话说明白,后来补了 303(明确要求改用 GET)和 307(明确要求保持方法和正文),再往后还有 308(永久且保持方法)。课件把 302 写成"Found 或 See Other",这是两个状态码:302 是 Found,303 才是 See Other。登录成功后跳首页,用 303 比 302 更准确。
这几种重定向都离不开 Location:响应头里不写目标地址,浏览器不知道该去哪,再正确的状态码也只是告诉它"资源搬家了"。301 的响应里 Location 是永久的新地址,302 是临时的,语义由状态码区分,语法完全一样。
304 表示"你缓存的那份还能用",它自己不能带正文;204 表示成功但没什么可说的,也不能带正文。给 304 塞一段 HTML,浏览器会把它当成下一段响应,和正文定界没做对是同一个坑。401 是"你没证明你是谁",客户端该去认证;403 是"我知道你是谁,但你不能碰这个"。502 和 504 都出在代理链上:前者是上游回了一个无效响应,后者是上游没在限定时间内回应。
其余几个按语义记:100 Continue 用在大文件上传,服务器先告诉客户端"可以继续发";201 Created 配一个 Location 指向新资源;400 Bad Request 是请求语法或定界不对,500 是服务端自己出错,503 是维护或过载、通常在响应头里带一个 Retry-After。
正文多长,只能有一个答案
判断一条消息的正文长度只有三类依据:
- 头部有
Content-Length: N,空行之后恰好 N 字节; - 头部有
Transfer-Encoding: chunked,正文由若干块组成,每块是"长度\r\n数据\r\n",以0\r\n\r\n收尾; - 两者都没有:请求侧视为没有正文,响应侧只能以连接关闭为界。
课件说"如果 Body 存在,则在 Header 中会有一个 Content-Length 属性来标识 Body 的长度",这句只覆盖了第一类。分块传输的响应里根本没有 Content-Length:
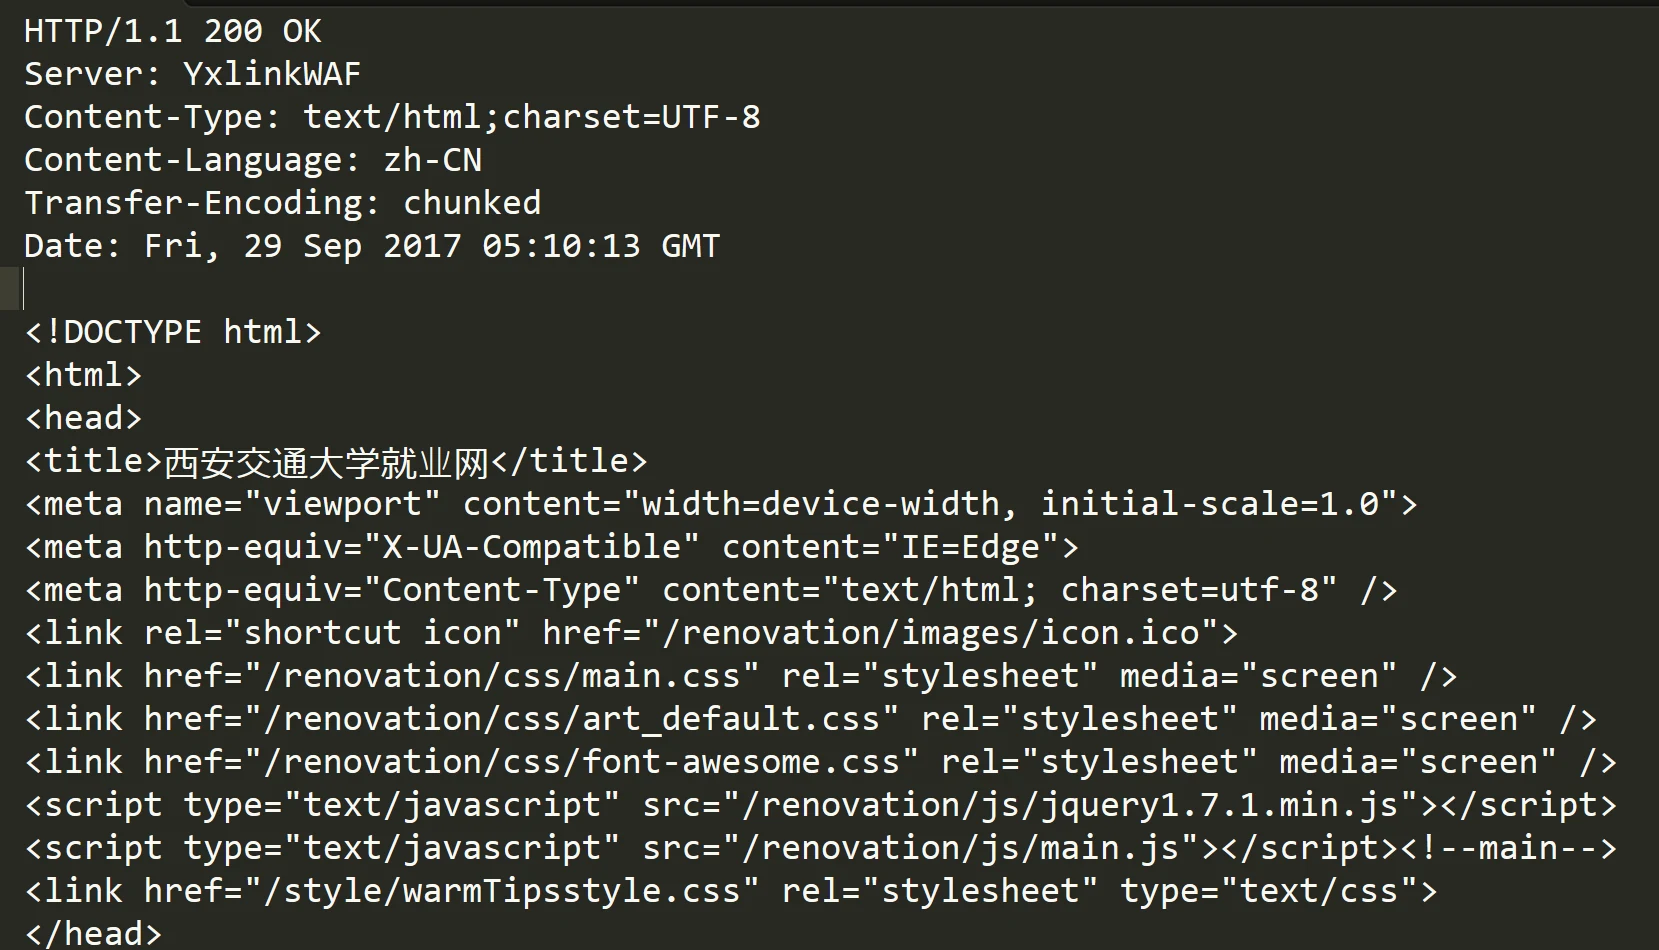
两个头同时出现时,Transfer-Encoding 覆盖 Content-Length,而且接收方应当把它当成错误——这种报文常常是请求走私的原料:代理和后端如果选边站的规则不一致,攻击者就能让同一段请求被前者看成两条、被后者看成一条。手写解析器最省事也最安全的做法是直接回 400,别猜。
还有一个常被说反的事实。课件开头写"HTTP 是一个无连接、无状态的协议,即每次请求都需要建立新的连接",后面又写"HTTP/1.1 默认使用持久连接",两句话自相矛盾。无状态说的是协议不替客户端保存上下文,和连接是否复用无关;连接复用由版本和 Connection 头决定:HTTP/1.1 默认使用持久连接(persistent connection),要关就写 Connection: close;HTTP/1.0 默认不持久,想复用必须显式写 Connection: keep-alive。
长连接一旦成立,一条 TCP 连接上就会串行地跑很多个请求,解析器再也不能假设"读到 EOF 就是一条消息结束",也不能假设"一次 read 就是一条请求"。
每个头部字段都在管一件事
浏览器发来的头不是凑格式,它们分工明确:
| 字段 | 谁在看 | 作用 |
|---|---|---|
Host | 服务器 | 1.1 必填,虚拟主机靠它选站点 |
Accept / Accept-Encoding / Accept-Language | 服务器 | 内容协商:类型、压缩、语言 |
User-Agent | 服务器、统计 | 客户端软件与版本(可以伪造,别拿它做权限判断) |
Referer | 服务器、防盗链 | 上一跳地址(拼写就是这么错进标准的) |
Cookie | 服务器 | 浏览器替你带上的会话标识 |
Authorization | 服务器 | 认证信息,常见形式是 Basic base64(用户名:密码) |
Content-Type | 双方 | 正文的媒体类型,表单是 application/x-www-form-urlencoded |
Content-Length / Transfer-Encoding | 服务器 | 正文定界,二选一 |
Connection | 双方 | 这条连接接下来留不留 |
Location | 客户端 | 3xx 时告诉它去哪 |
Date / Server | 客户端、统计 | 响应生成时间和服务端软件标识 |
Cache-Control / ETag / Last-Modified / Expires | 缓存 | 什么时候可以复用本地副本 |
Content-Encoding | 客户端 | 正文用 gzip/br 压过,要先解压再解析 |
抓包时也常见另一种被误读的正文:响应头写着 Content-Encoding: gzip,正文却是一串看不懂的字节。那不是乱码,是压缩后的数据,要先解压再解析;如果只看二进制内容,很容易把它当成加密。
Cookie 的特殊之处是它由浏览器按站点存取并自动回传,规则单独讲。
一个能处理第二条请求的服务器
课件的最小服务器用 10KB 缓冲区一次读完,然后拼一个 HTTP/1.0 响应。单请求场景下它能工作,但有几处真实的缺陷:socklen_t len; 没有初始化就传给 accept,accept 需要它作为输入缓冲区长度,未初始化是未定义行为;响应只用 \n 不用 CRLF;没有处理正文长度,浏览器发 POST 时正文可能还没到就回了包。
下面这版把"接收、定界、消费"三件事分开,一条连接上可以连续处理多个请求:
/* http_min.c —— gcc -std=c11 -Wall -Wextra http_min.c -o http_min */
#define _POSIX_C_SOURCE 200809L
#include <stdio.h>
#include <stdlib.h>
#include <stdint.h>
#include <string.h>
#include <strings.h>
#include <errno.h>
#include <signal.h>
#include <unistd.h>
#include <arpa/inet.h>
#include <netinet/in.h>
#include <sys/socket.h>

#define BUF_SIZE 8192

/* 返回空行之后第一个字节的下标;没找到完整的头部返回 -1 */
static long head_end(const char *buf, size_t n)
{
    for (size_t i = 0; i + 3 < n; ++i)
        if (buf[i] == '\r' && buf[i + 1] == '\n' &&
            buf[i + 2] == '\r' && buf[i + 3] == '\n')
            return (long)(i + 4);
    return -1;
}

/* 在头部范围内找 Content-Length,找不到返回 0 */
static size_t content_length(const char *head, size_t n)
{
    const char *p = head, *end = head + n;
    while (p < end) {
        const char *nl = memchr(p, '\n', (size_t)(end - p));
        if (nl == NULL) break;
        if ((size_t)(nl - p) > 15 && strncasecmp(p, "Content-Length:", 15) == 0)
            return (size_t)strtoul(p + 15, NULL, 10);      /* strtoul 跳过前导空格 */
        p = nl + 1;
    }
    return 0;
}

static int serve_one(int cfd)
{
    char buf[BUF_SIZE];
    size_t used = 0;

    for (;;) {
        long he = head_end(buf, used);
        size_t need = 0;
        if (he >= 0)
            need = (size_t)he + content_length(buf, (size_t)he);

        if (he < 0 || used < need) {            /* 头部不全,或正文不全 */
            if (used == sizeof(buf)) return -1; /* 缓冲区满了还凑不齐,断开 */
            ssize_t n = recv(cfd, buf + used, sizeof(buf) - used, 0);
            if (n == 0) return 0;               /* 客户端关闭 */
            if (n < 0) {
                if (errno == EINTR) continue;
                return -1;
            }
            used += (size_t)n;
            continue;
        }

        /* 到 need 为止是一条完整请求;这里只回固定页,真正的业务在 need 之内取 */
        const char *body = "<h1>hello world</h1>";
        char resp[512];
        int rn = snprintf(resp, sizeof(resp),
            "HTTP/1.1 200 OK\r\n"
            "Content-Type: text/html; charset=utf-8\r\n"
            "Content-Length: %zu\r\n"
            "Connection: keep-alive\r\n"
            "\r\n%s", strlen(body), body);
        if (rn < 0) return -1;
        if (write(cfd, resp, (size_t)rn) != (ssize_t)rn) return -1;

        memmove(buf, buf + need, used - need);  /* 只消费这一条 */
        used -= need;
    }
}

int main(int argc, char **argv)
{
    if (argc != 2) {
        fprintf(stderr, "用法: %s port\n", argv[0]);
        return 1;
    }

    signal(SIGPIPE, SIG_IGN);                        /* 客户端提前断开时不杀进程 */

    int lfd = socket(AF_INET, SOCK_STREAM, 0);
    if (lfd < 0) { perror("socket"); return 1; }

    struct sockaddr_in addr;
    memset(&addr, 0, sizeof(addr));
    addr.sin_family = AF_INET;
    addr.sin_addr.s_addr = htonl(INADDR_LOOPBACK);   /* 只监听本机,避免误暴露 */
    addr.sin_port = htons((uint16_t)strtoul(argv[1], NULL, 10));

    if (bind(lfd, (struct sockaddr *)&addr, sizeof(addr)) < 0) {
        perror("bind");
        return 1;
    }
    if (listen(lfd, 16) < 0) { perror("listen"); return 1; }

    for (;;) {
        int cfd = accept(lfd, NULL, NULL);           /* 不关心对方地址,可以不传缓冲 */
        if (cfd < 0) {
            if (errno == EINTR) continue;
            perror("accept");
            continue;
        }
        serve_one(cfd);                              /* 单线程,一次服务一条连接 */
        close(cfd);
    }
}
serve_one 里那个 need 就是"消费多少字节"的答案。没有它,第二条请求会被当成第一条的正文,这正是手写服务器只会处理一次请求的常见原因。单线程模型一次只能服务一条连接,服务完这条才回到 accept;要并发就得 fork、线程池或者事件循环。
这段只按 Content-Length 定界,头部里出现 Transfer-Encoding: chunked 会被当成没有正文;它也无条件回 Connection: keep-alive,不理会客户端写的是 close。把这两条补上,才算覆盖了 HTTP/1.1 请求侧的定界规则。
真正把 GET 做成静态文件服务,还要补三件课件提到但没展开的事:把 URL 解码后映射到 Web 根目录下的文件,拒绝包含 .. 的路径,按扩展名给出 Content-Type;找不到文件回 404,方法不支持回 405 并带 Allow。读文件时按二进制打开,别按文本模式——图片和字体不是文本。还有一条不用处理的请求:Chrome 会额外发一条 GET /favicon.ico,那是浏览器在找标签页图标,返回 404 不影响页面。
这张图只能证明响应格式对了、浏览器愿意渲染。它证明不了服务器能处理第二条请求、能处理 chunked、能在 HEAD 时不发正文。手写 HTTP 服务器最危险的地方就在这里:最小可用版本太容易做出来,剩下的边界条件要花十倍时间。课件建议把状态码改成 404、403、504 看浏览器反应,这一步值得做——它能让你看到浏览器拿到"没有正文的 404"时,仍然会自己渲染一个错误页。
版本演进留下的痕迹
| 版本 | 加了什么 | 留下的问题 |
|---|---|---|
| 0.9 | 只有 GET,只有 HTML,没有头部 | 无法协商任何东西 |
| 1.0 | POST/HEAD、MIME、状态码、缓存 | 默认一次连接一个请求 |
| 1.1 | 持久连接、管道化、分块编码、Host | 队头阻塞;头部明文重复 |
| 2.0 | 二进制帧、多路复用、头部压缩、服务器推送 | 一个 TCP 连接上所有流仍受同一个拥塞窗口 |
| 3.0 | QUIC(基于 UDP)、更快的握手 | 部署依赖 UDP 可达性 |
1.1 时代留下的 Host、Content-Length、Transfer-Encoding、Connection 这套机制,直到今天仍是写服务器时必须处理的东西;2.0 和 3.0 改的是传输层怎么把这些语义搬得更快,语义本身没变。
还没有评论 — 第一条由你来留。