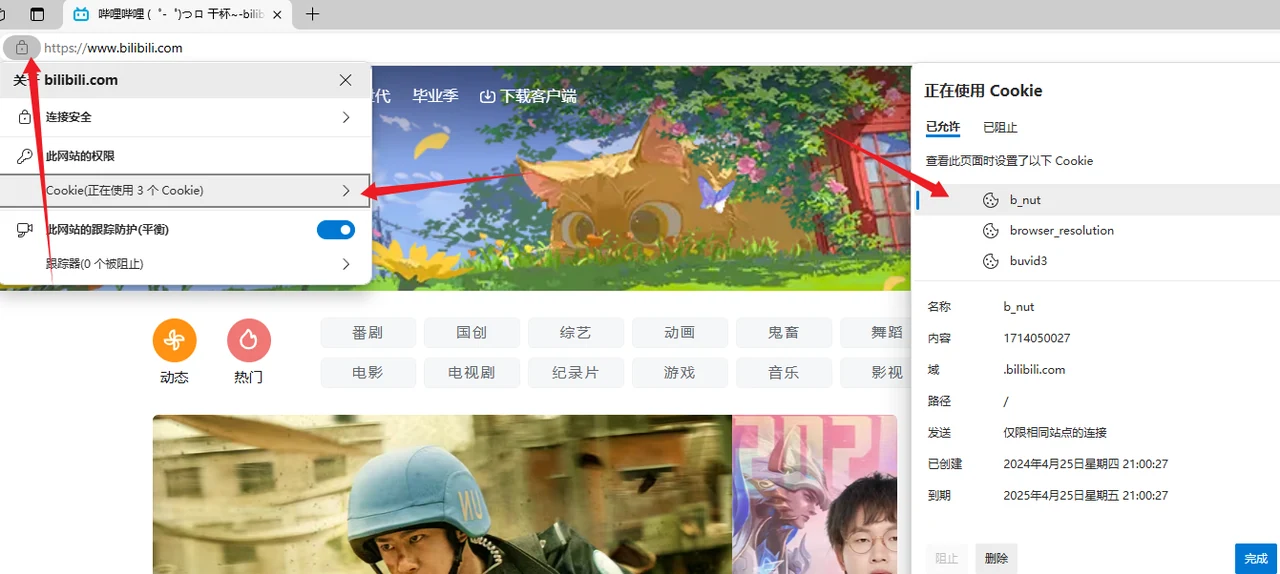
这三条能说明"这是同一台设备、屏幕多大、什么时候来过",没有一条能说明"这是哪个账号"。HTTP 本身不记人:服务端收到 GET / 和下一个 GET /,协议里没有任何字段能回答"这两次是不是同一个人"。这件事是刻意的——任何一台机器都能处理任何一个请求,扩容和重启都不用带上下文。代价是所有上下文必须由请求本身携带,位置只有两处:客户端,或者服务端。
一次请求里有两行头,它们不是同一种格式
Cookie 是服务器写给浏览器、由浏览器存下的一小段文本,之后向同一站点发请求时自动带上。写入用响应头 Set-Cookie,回传用请求头 Cookie:
# 响应侧:一条 cookie 一个头,属性跟在分号后面
Set-Cookie: uid=alice; Path=/; HttpOnly
Set-Cookie: theme=dark; Max-Age=31536000

# 请求侧:所有 cookie 挤在一个头里,属性全部消失
Cookie: uid=alice; theme=dark
把 Path=/ 当成一个名叫 Path 的 cookie 塞回请求头,是手写解析器常见的错觉。浏览器回传时只带 name=value,用分号和空格分隔,属性一个都不带。
name 和 value 的字符也有限制:分号、逗号、空格、双引号、反斜杠都不能直接出现。想塞 JSON,先做百分号编码或 Base64,那是应用层自己的约定。浏览器内部存的也不是"名字 → 值",主键是 (name, domain, path) 三元组,所以同一个名字可以同时存在两条:Path=/ 的 uid=alice 和 Path=/admin 的 uid=bob,访问 /admin/x 时两条都会被带上。解析器如果假设"名字唯一",就会随机取到一条。
Cookie 分两类:没有过期时间的叫会话 Cookie(session cookie),浏览器关闭即失效;带 Expires 或 Max-Age 的叫持久 Cookie(persistent cookie),落在浏览器的用户配置目录里,通常以二进制或 SQLite 形式保存,直接打开看是乱码,要在浏览器设置里看(Chrome 的 chrome://settings/cookies,或者地址栏左侧那把锁里按站点查看)。用途上最重要的一条是用户认证与会话管理,另外还有行为跟踪和偏好缓存。因为它存在客户端,被篡改和被窃取都是固有风险。
Domain、Path、Expires:默认值都比直觉更宽或更严
Domain 决定这条 cookie 回传给哪些主机。不写这个属性的是 host-only cookie,只回传给写下它的那个主机;写了 Domain=.example.com 才会在子域之间共享。域名写一个和当前站点无关的值,整条 cookie 会被浏览器丢掉,所以 evil.com 无法给 bank.com 写 cookie —— 这一层是浏览器在守,不是服务器。
Path 决定回传的路径范围。它的默认值不是"设置它的路径",而是 RFC 6265 给出的一套 default-path 算法:请求路径为空或以 / 开头且只有一个 / 时取 /,否则取最右边那个 / 之前的部分。
| 下发时的 URL | 不写 Path 时的默认值 |
|---|---|
/ | / |
/a | / |
/a/b | /a |
/a/b/login | /a/b |
在 /a/b 上设置的 cookie,默认范围是 /a,比"设置它的路径"更宽。这个差异在小站点上永远暴露不出来,在"登录接口挂在 /user/login、业务接口挂在 /api/"的站点上,就会变成"登录成功,下一个接口又提示未登录"。
匹配规则也不是字符串前缀:/a 只匹配 /a 和 /a/...,不匹配 /apple。手写判断时用 startswith,就会把 /apple 也算进去。
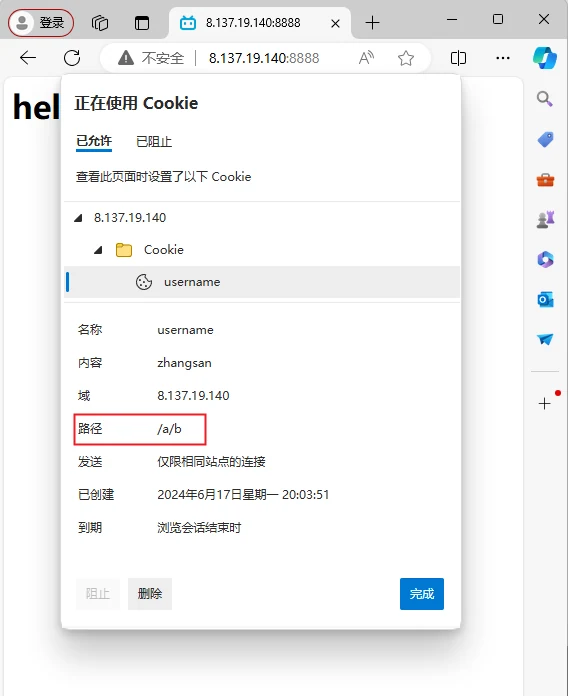
课件用一条 Set-Cookie: username=zhangsan; path=/a/b; 做了实验,浏览器面板里路径确实变成了 /a/b;此时访问 /a/x、/、/x/y 都不会带上它,访问 /a/b 才会。
过期有两种写法:Expires 是绝对时刻,Max-Age 是相对秒数;两个同时出现时 Max-Age 优先。Max-Age=0 表示立即删除,登出时下发一条同名同路径的 Max-Age=0 是最标准的"抹掉"动作。两个都不写,就是会话 Cookie。
Expires 的格式是 HTTP-date,标准形态(IMF-fixdate)只有一种:
Wed, 18 Dec 2024 12:00:00 GMT课件示例写的是 expires=Thu, 18 Dec 2024 12:00:00 UTC,两处都不对:2024 年 12 月 18 日是星期三,不是星期四;规范里的时区标记是 GMT,UTC 不在这个格式里。浏览器大多容错,功能上还能跑,但示例本身自相矛盾,照着抄进代码就是给自己埋雷。
GMT 和 UTC 在秒级上基本等价,区别在定义基础:GMT 以本初子午线的平太阳时为基准,UTC 以原子钟的秒长为基础再做闰秒修正,所以时间系统里用 UTC、HTTP 报文里沿用 GMT 这个历史标记。真正要记住的是"必须按 UTC 换算后再打印",而不是"时区标记写哪个都行"。
生成这个字符串必须用 UTC。localtime() 会按进程时区换算,服务器换个时区,用户的 cookie 就提前或延后几小时过期。课件用了 gmtime(),注释里那句"不能用 localtime"是对的,但 gmtime 返回的是函数内部的静态缓冲区,在用线程池处理请求的服务器里,两个线程同时调用会互相覆盖。要用 gmtime_r:
/* http_date.c —— gcc -std=c11 -Wall -Wextra http_date.c -o http_date */
#define _POSIX_C_SOURCE 200809L
#include <stdio.h>
#include <time.h>

static const char *const kDays[]   = {"Sun","Mon","Tue","Wed","Thu","Fri","Sat"};
static const char *const kMonths[] = {"Jan","Feb","Mar","Apr","May","Jun",
                                      "Jul","Aug","Sep","Oct","Nov","Dec"};

/* 生成 seconds 秒之后的 HTTP-date;成功返回写入长度,失败返回 -1 */
int http_date_after(long seconds, char *out, size_t cap)
{
    time_t t = time(NULL) + seconds;
    struct tm tm;
    if (gmtime_r(&t, &tm) == NULL) return -1;

    return snprintf(out, cap, "%s, %02d %s %d %02d:%02d:%02d GMT",
                    kDays[tm.tm_wday], tm.tm_mday, kMonths[tm.tm_mon],
                    tm.tm_year + 1900, tm.tm_hour, tm.tm_min, tm.tm_sec);
}
两个安全属性,外加后来补的 SameSite
Secure 让浏览器只在安全连接(HTTPS)上回传这条 cookie,防止它在明文 HTTP 里被截获。HttpOnly 禁止客户端脚本通过 document.cookie 读写它,挡的是被注入的脚本偷走会话号;它挡不住"用你的身份发请求",因为请求照样会自动带上 cookie。
SameSite 控制跨站请求带不带这条 cookie。Strict 最严格,从别的站点跳过来时不带;Lax 允许顶层的 GET 导航带上,POST 和子请求不带;None 必须同时加 Secure。Chrome 80 之后,没有声明 SameSite 的 cookie 默认按 Lax 处理,这是 CSRF 防护的第一道默认防线。课件的实验代码一个属性都没加。
三个属性解决的是三个不同的问题:Secure 管传输,HttpOnly 管脚本读取,SameSite 管跨站携带。把它们当成"安全开关"一起打开,仍然防不住服务端自己把身份判断做错。
把用户名写进 cookie,等于让浏览器替你判断身份
课件的实验代码用三个函数演示写入、过期和路径:
std::string ProveCookieWrite()     { return "Set-Cookie: username=zhangsan;"; }
std::string ProveCookieTimeOut()   { return "Set-Cookie: username=zhangsan; expires=" +
                                            ExpireTimeUseRfc1123(60) + ";"; }
std::string ProvePath()            { return "Set-Cookie: username=zhangsan; path=/a/b;"; }
写入之后刷新,浏览器自动提交:
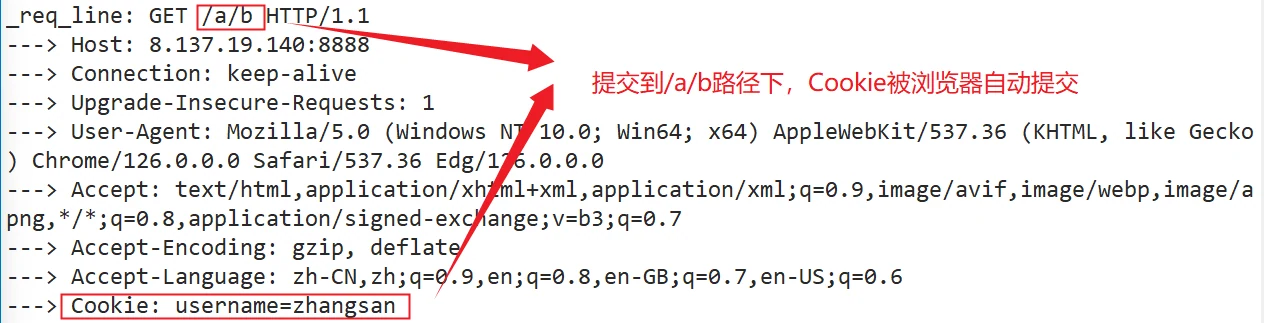
它能证明 cookie 被写入、被自动回传,同时也演示了一个不该上线的设计。username 存在浏览器里,而浏览器属于用户,用户可以把值改成 admin,服务端如果直接把它当当前用户,就越权了。课件自己也问了这个问题:"如果写入的是用户的私密数据呢?比如用户名密码、浏览痕迹。"
结论很直接:cookie 里只能放标识,不能放身份。用户名、余额、是不是 VIP,这些字段即使签名或加密后能防篡改,它仍然是一份能被偷走并重放的凭证,而且改密码、封号之后没法立刻作废。身份必须由服务端在收到标识后自己去查。
Session:纸条上只写编号,数据留在服务端
Session 的做法是:登录成功后服务器生成一个编号,把用户数据存进自己的表里,编号通过 cookie 发回浏览器;之后每个请求带着编号来,服务器拿编号查数据。这张表可以放内存,也可以放数据库或 Redis——放内存时重启即丢,放共享存储时多个服务实例才能看到同一份会话。除了登录态,购物车、临时表单这类"还没写进数据库"的数据也常放在这里。课件用一个 unordered_map 做这张表:
class Session
{
public:
    Session(const std::string &username, const std::string &status)
        : _username(username), _status(status) { _create_time = time(nullptr); }

    std::string _username;
    std::string _status;
    uint64_t    _create_time;
};

class SessionManager
{
public:
    std::string AddSession(std::shared_ptr<Session> s)
    {
        std::string id = std::to_string(rand() + time(nullptr));
        _sessions.insert(std::make_pair(id, s));
        return id;
    }
    std::shared_ptr<Session> GetSession(const std::string &id)
    {
        auto it = _sessions.find(id);
        return it == _sessions.end() ? nullptr : it->second;
    }
private:
    std::unordered_map<std::string, std::shared_ptr<Session>> _sessions;
};
编号的生成方式必须改。课件用 rand() + time(),rand() 的种子是 srand(time ^ getpid),种子可猜,返回值再叠加一个时间戳,熵依然很低。会话号是认证凭证,和密码等价,必须来自密码学随机源,128 位起步:
// session_id.cc —— g++ -std=c++17 session_id.cc -o session_id
#include <sys/types.h>
#include <sys/random.h>
#include <cstddef>
#include <cstdio>
#include <string>

std::string NewSessionId()
{
    unsigned char raw[16];
    size_t got = 0;

    while (got < sizeof(raw)) {
        ssize_t n = getrandom(raw + got, sizeof(raw) - got, 0);
        if (n < 0) return std::string();          // 被信号打断也可能走到这里
        got += (size_t)n;
    }

    std::string id;
    id.reserve(32);
    for (size_t i = 0; i < sizeof(raw); ++i) {
        char hex[3];
        std::snprintf(hex, sizeof(hex), "%02x", raw[i]);
        id += hex;
    }
    return id;                                    // 32 个十六进制字符 = 128 bit
}

int main()
{
    std::puts(NewSessionId().c_str());
    return 0;
}
课件的 HttpRequest::Parse 还有一处解析缺陷:它把整条 Cookie 头拿去做 strncmp(cookie.c_str(), "sessionid=", 10),只有会话号恰好排在第一个键值对时才命中。请求头里 Cookie: a=1; sessionid=xxx; b=2 完全合法,正确做法是按 ; 切开,每段跳过前导空格,再比对第一个 = 之前的名字:
/* cookie_get.c —— 从 "a=1; sessionid=abc; b=2" 里取指定名字的值 */
#include <stdio.h>
#include <string.h>

int cookie_get(const char *header, const char *name, char *out, size_t cap)
{
    size_t nlen = strlen(name);
    const char *p = header;

    while (*p) {
        while (*p == ' ' || *p == ';') p++;        /* 跳过分隔符与前导空格 */
        if (*p == '\0') break;

        const char *end = strchr(p, ';');          /* 这一段的结束 */
        if (end == NULL) end = p + strlen(p);

        const char *eq = memchr(p, '=', (size_t)(end - p));
        if (eq != NULL && (size_t)(eq - p) == nlen && strncmp(p, name, nlen) == 0) {
            size_t vlen = (size_t)(end - eq - 1);
            if (vlen >= cap) return 0;
            memcpy(out, eq + 1, vlen);
            out[vlen] = '\0';
            return 1;
        }
        p = end;
    }
    return 0;
}

int main(void)
{
    char value[64];
    const char *header = "a=1; sessionid=abc; b=2";
    if (cookie_get(header, "sessionid", value, sizeof(value)))
        printf("sessionid=%s\n", value);           /* sessionid=abc */
    return 0;
}
服务端这张表还要处理几件事:会话要有超时,超过时间自动失效;用户登出要主动删除;服务重启后表就空了,浏览器还留着旧编号,查不到就按未登录处理并下发一条 Max-Age=0 清掉,别让它一直挂着。
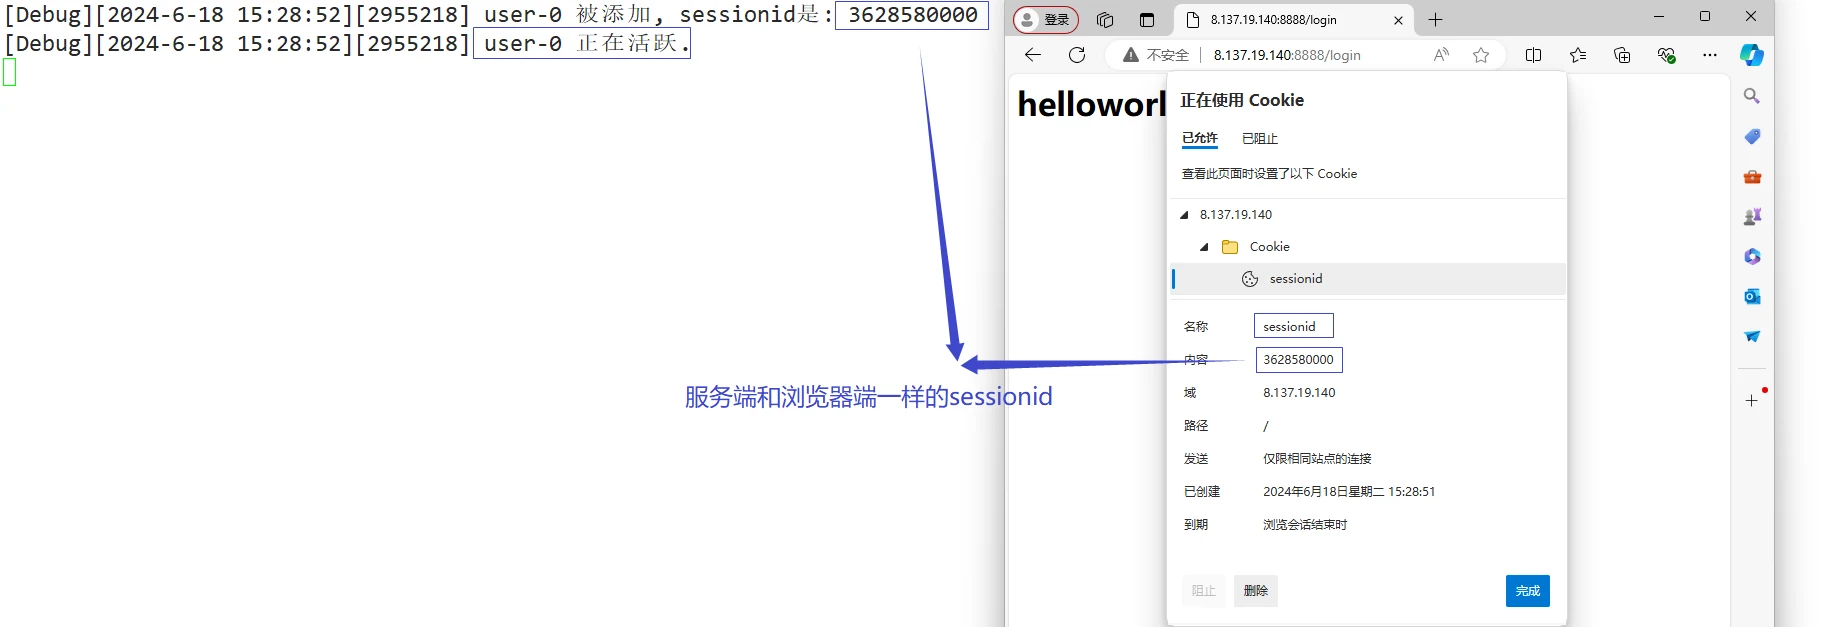
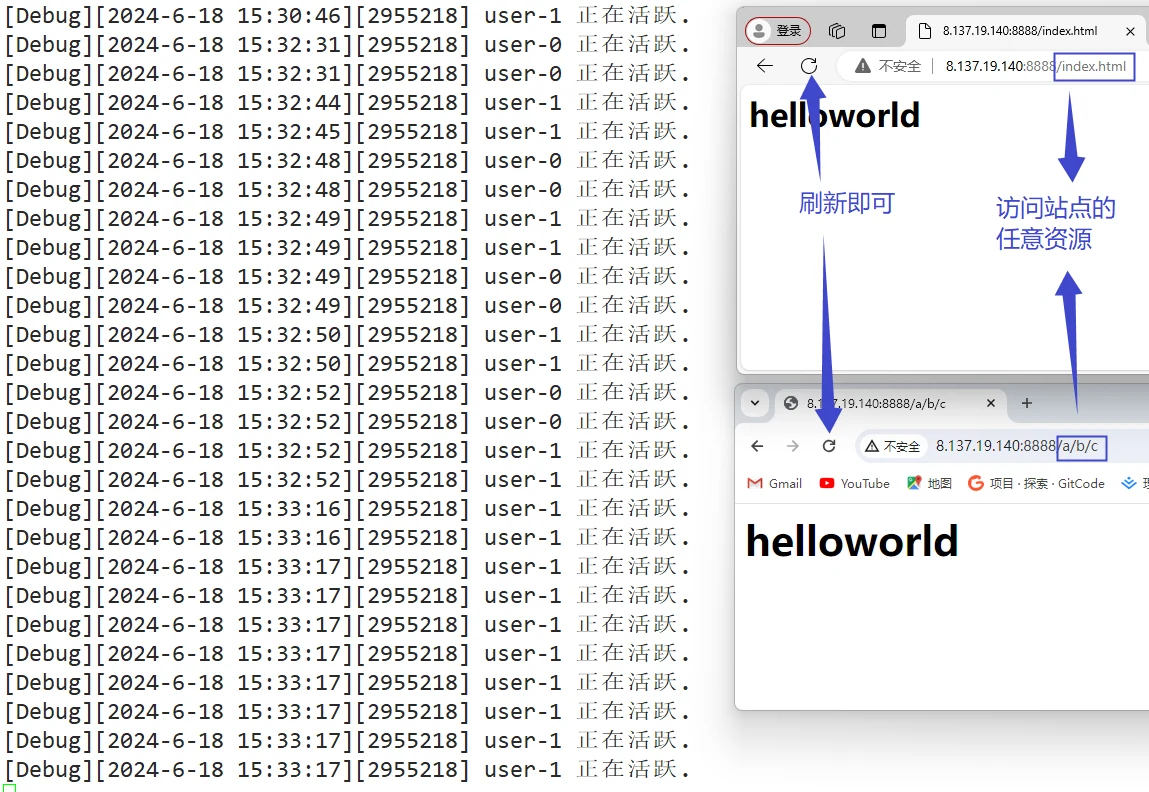
还有一个边界:表的键如果是"用户名",第二个浏览器登录就会把第一个踢下线;想多端同时在线,键必须是会话号,用户信息放在值里。课件的实验用两个浏览器各访问一次 /login,服务端日志里出现了 user-0 和 user-1 两个编号,正是这个结构:
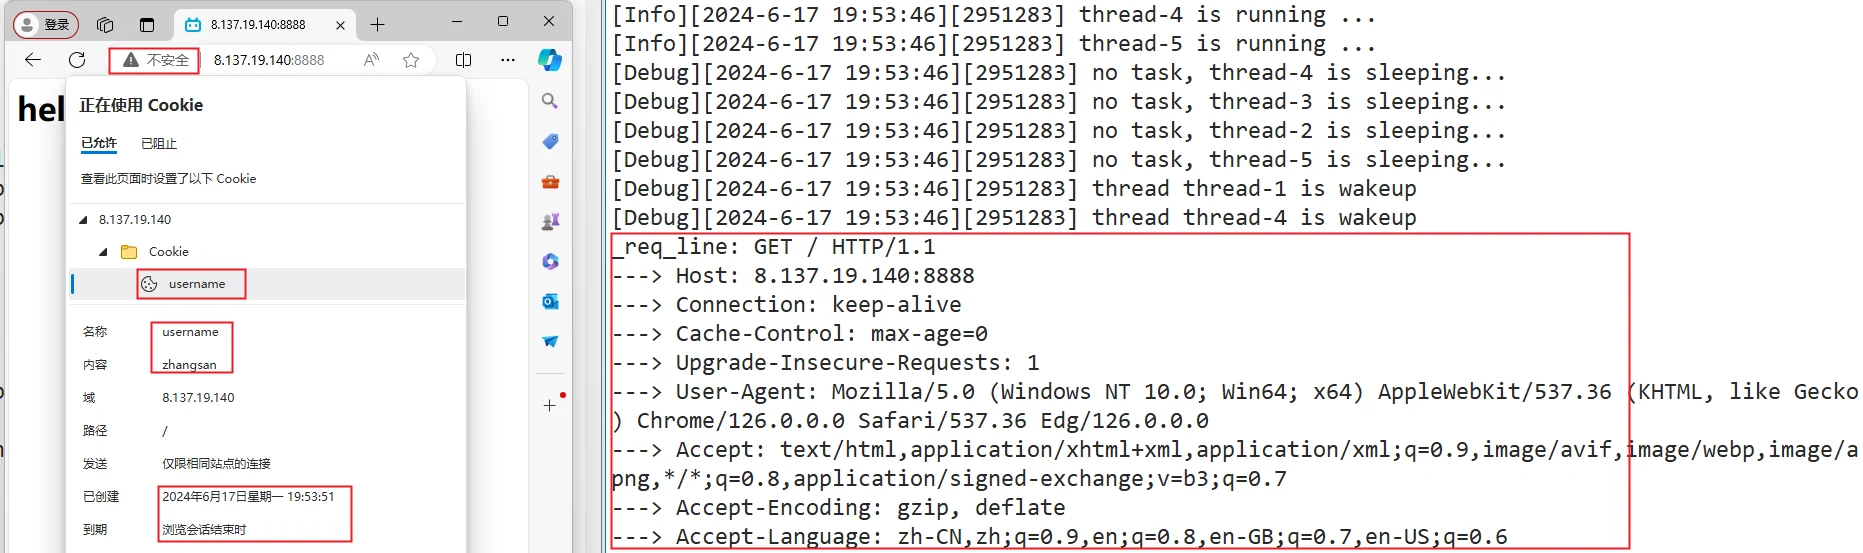
做实验前要先清掉该站点的历史 cookie。浏览器里还躺着上一次的 sessionid,它会照样自动提交,服务端也就"认得"那个老会话,日志里不会出现新增。课件也提醒 Chrome 的 cookie 在实验里表现特殊,这时最可靠的办法不是反复清缓存,而是把服务器收到的请求头打印出来,直接看 Cookie 那一行到底带了什么。
状态放客户端还是放服务端
| 维度 | Cookie | Session |
|---|---|---|
| 数据放在哪 | 客户端浏览器 | 服务端内存、数据库或缓存 |
| 容量 | 每个 cookie 很小,还受条数限制 | 受服务端内存/存储限制 |
| 被篡改 | 客户端随手就能改,必须校验 | 改编号只能撞库,数据本身动不了 |
| 失效控制 | 靠 Expires/Max-Age,客户端可以不遵守 | 服务端随时删,登出立即生效 |
| 水平扩展 | 天然跟着请求走 | 需要共享存储或粘性会话 |
| 跨站共享 | 受 Domain/SameSite 限制 | 只要编号能带过去就能用 |
Cookie 是载体,Session 是内容,它们不是二选一的关系:Session 通常就靠 cookie 携带编号。真正的选择是"状态放客户端还是放服务端"。第三条路是把状态放回客户端但加签名(JWT 这类 token):省掉服务端存储,代价是撤销困难,改密码或封号之后,已签发的 token 在过期前仍然有效。选哪条,取决于你能不能接受"有一段时间撤不掉"。
协议本身始终是无状态的。它记住你,靠的是浏览器替你带一张纸条,服务器在纸条背后留了一间仓库。纸条能被改,仓库不会被改——这就是纸条上只能写编号的原因。
还没有评论 — 第一条由你来留。