网络 IO 的系统调用都可以拆成同样的两段:先等数据就绪,再把数据从内核缓冲区拷到用户缓冲区。read 返回之前,这两段一定都发生过;区别只在于等待期间谁在占用时间、拷贝由谁发起。五种 IO 模型就是围绕这两段做的五种安排。
课件用钓鱼打比方:等鱼咬钩是“等待”,把鱼抄进鱼篓是“拷贝”。这个比喻真正有用的地方在于成本对比——等鱼的时间取决于鱼,抄鱼的时间取决于手。实际网络里,等待常常是毫秒到秒级,拷贝是内存到内存的微秒级。所以提升 IO 效率的主要空间在等待,不在拷贝。
阻塞 IO:调用把两段都包了
套接字默认就是阻塞的。调用 recvfrom 后,如果内核接收缓冲区里没有数据,进程被挂起,放进该 socket 的等待队列,CPU 上不再调度它;数据到达、被拷进用户缓冲区之后,内核唤醒进程,recvfrom 返回。
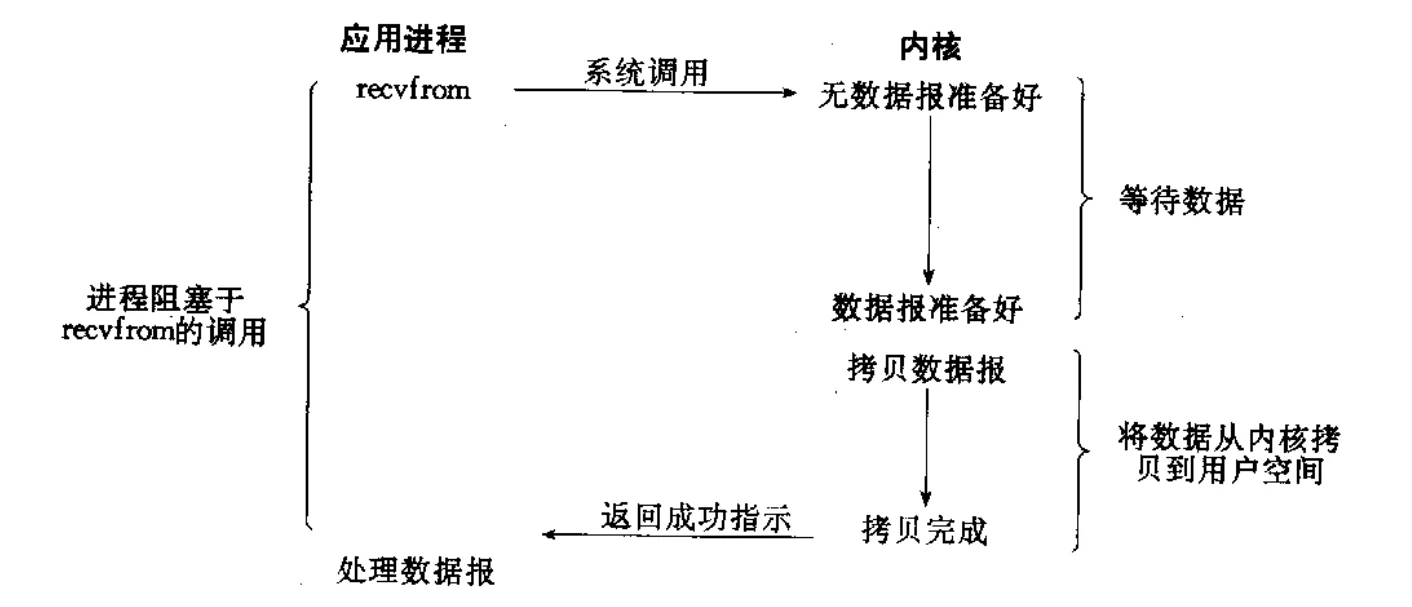
图里两个阶段是串行的:等待阶段进程睡着,拷贝阶段进程也睡着。代码写起来最顺,读到的就是数据,不需要处理“暂时没有”的分支。代价是一个线程只能守一条连接,连接数一多就得靠线程堆,线程栈、内核栈和上下文切换都会跟着涨。
非阻塞 IO:把等待改成反复询问
把 fd 设成 O_NONBLOCK 之后,数据没到,recvfrom 不再挂起进程,而是立刻返回 -1,errno 置为 EWOULDBLOCK。在 Linux 上这个值和 EAGAIN 相同,判断时两个都认,代码才 portable。
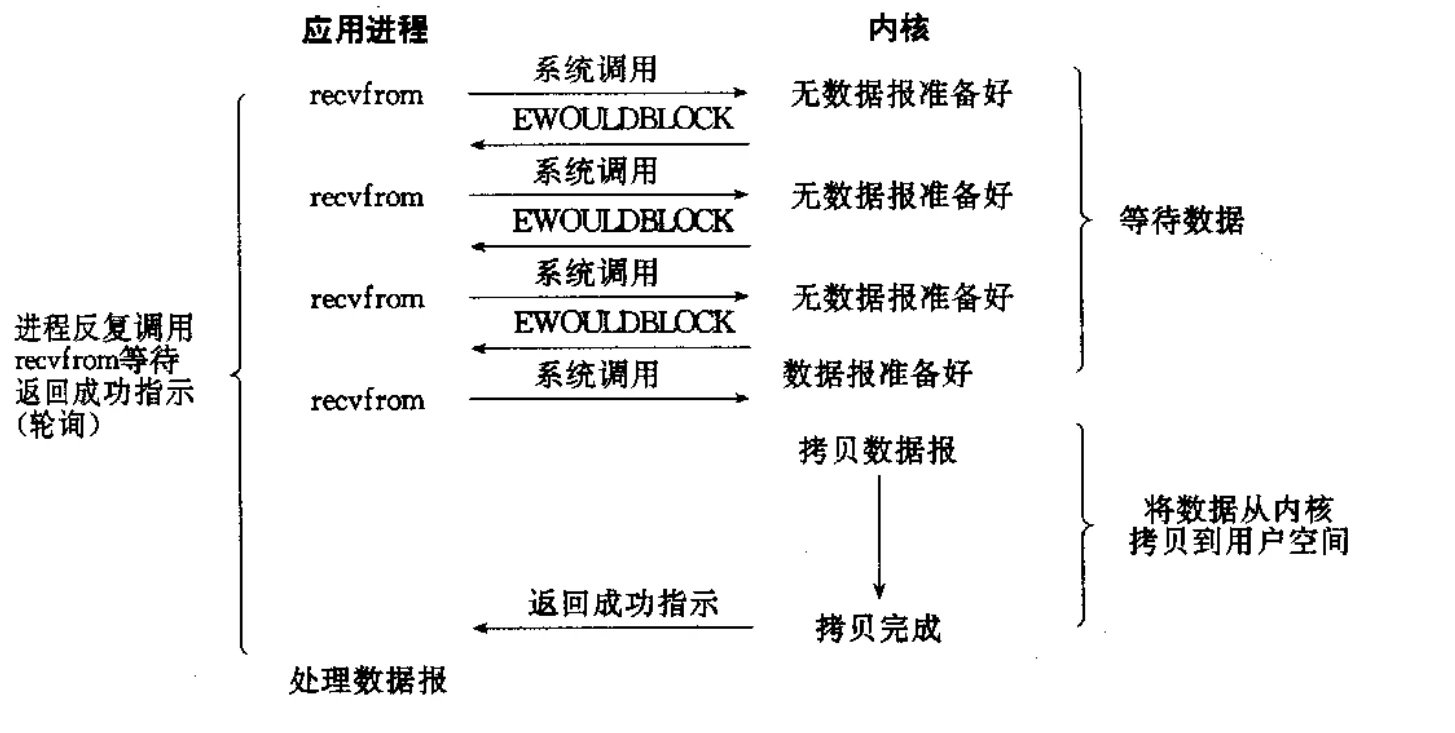
图里的四次调用就是轮询。它让一个线程有机会照看多条连接:问完 A 没数据,可以去问 B。但如果程序没有别的事可做,这个循环就退化成不停地把同样的系统调用打进内核。每次调用都要陷入内核、检查缓冲区、返回用户态,CPU 时间花在“问”上,业务一点没推进。课件对这件事的判断是准确的:轮询对 CPU 是较大的浪费,只在特定场景下使用。
多路转接:把询问集中成一次
多路转接(IO multiplexing)不再让每个 fd 各自问一遍,而是把一批 fd 交给 select、poll 或 epoll,一次调用同时等待它们。任意一个就绪,调用返回,并告诉你是哪些 fd。
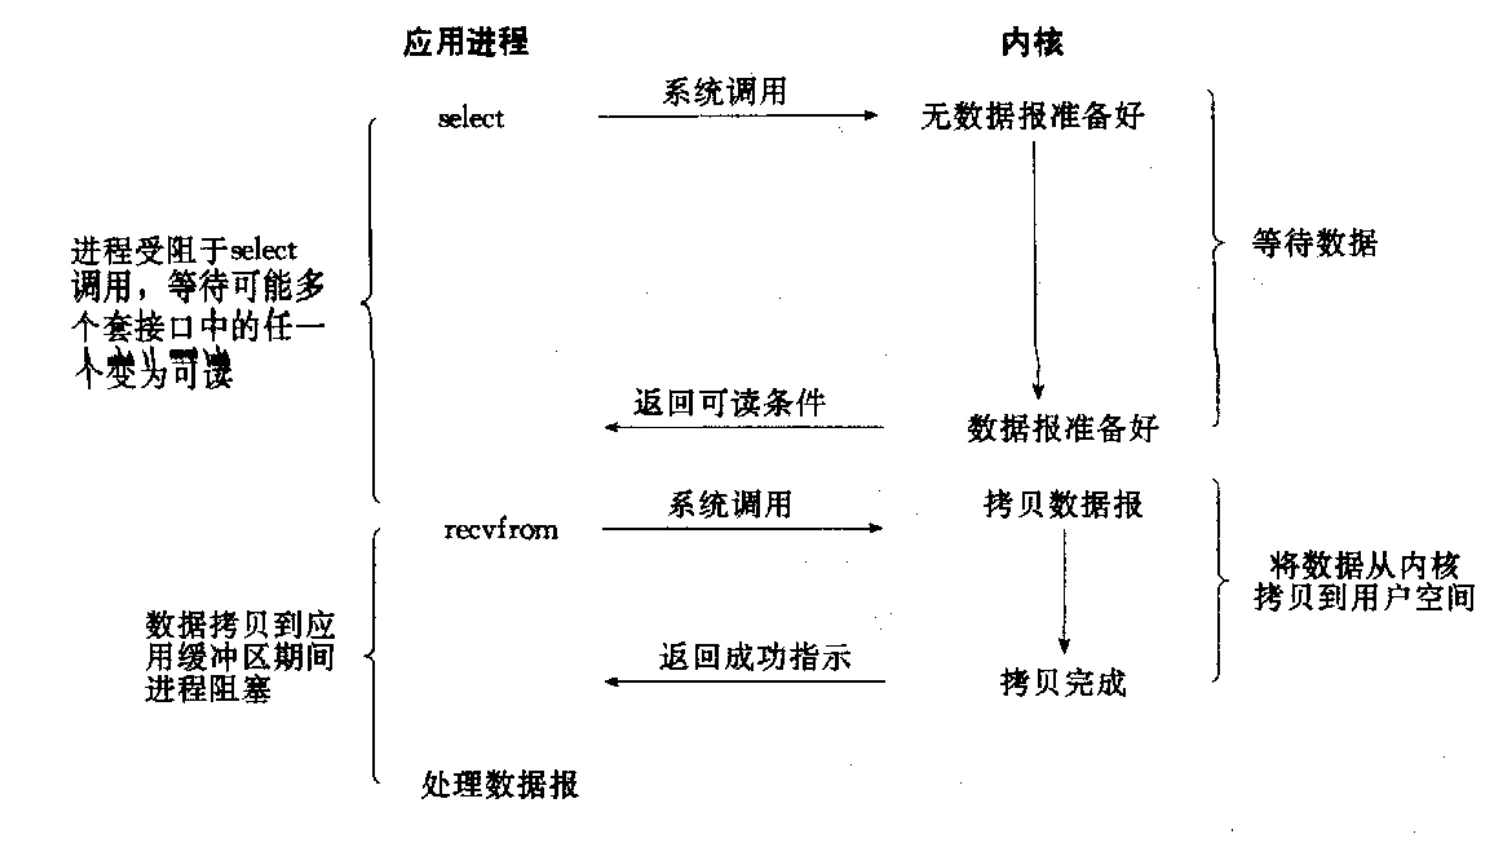
从图上看,它和阻塞 IO 的结构很像,都是“调用 → 内核准备数据 → 返回 → 拷贝”。差别在等待的粒度:阻塞 IO 等的是一个 fd,多路转接等的是一组 fd。它返回的只是“谁就绪了”,数据还在内核里,拷贝仍由进程自己做。所以多路转接并没有把 IO 变成异步,它只是把等待这件事集中管理。
信号驱动:让内核来通知
信号驱动 IO 先用 sigaction 注册 SIGIO 的处理函数,再通过 fcntl 的 F_SETOWN 指定信号的接收者、用 O_ASYNC 打开异步通知。之后进程继续执行,不阻塞在任何读调用上;数据到达时内核递送 SIGIO,处理函数里再调用 recvfrom 读数据。
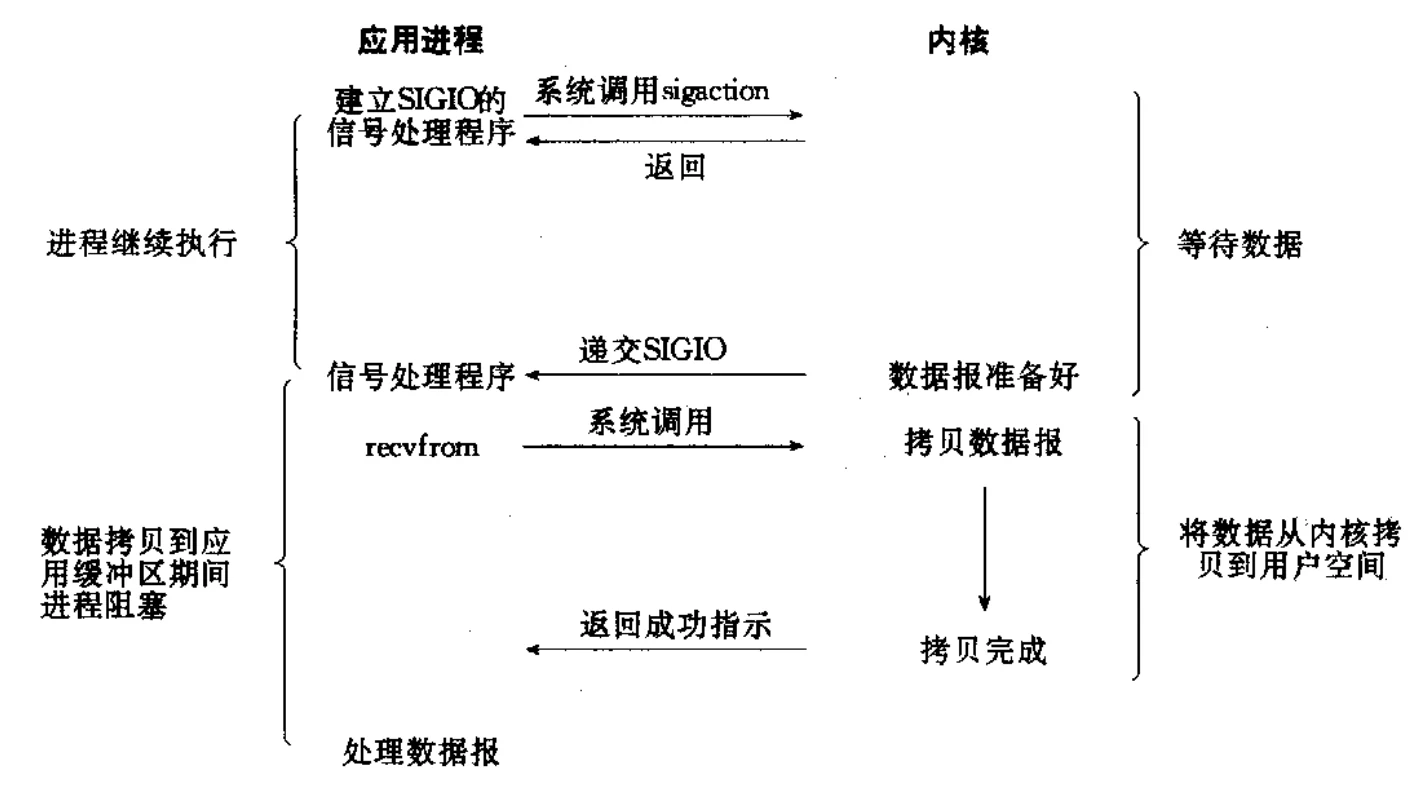
注意图的下半段:信号只是通知“可以开始读了”,拷贝这一步没被内核接手。信号处理函数里调用 recvfrom,如果数据还没完全就绪或者读取过程中需要等待,进程照样会阻塞。
信号驱动还有两个工程上的毛病。传统信号不排队,等待期间来多个 SIGIO,进程只记一次;多个 fd 都设了异步通知时,信号本身不告诉你是哪一个 fd 就绪,还是得回去遍历。它适合少量 fd、事件不密集的场景,不适合高并发服务器。
异步 IO:连拷贝也交出去
异步 IO 调用 aio_read 之后立刻返回,进程继续执行。内核完成等待、完成拷贝,最后用信号通知“数据已经放进你给的缓冲区了”。
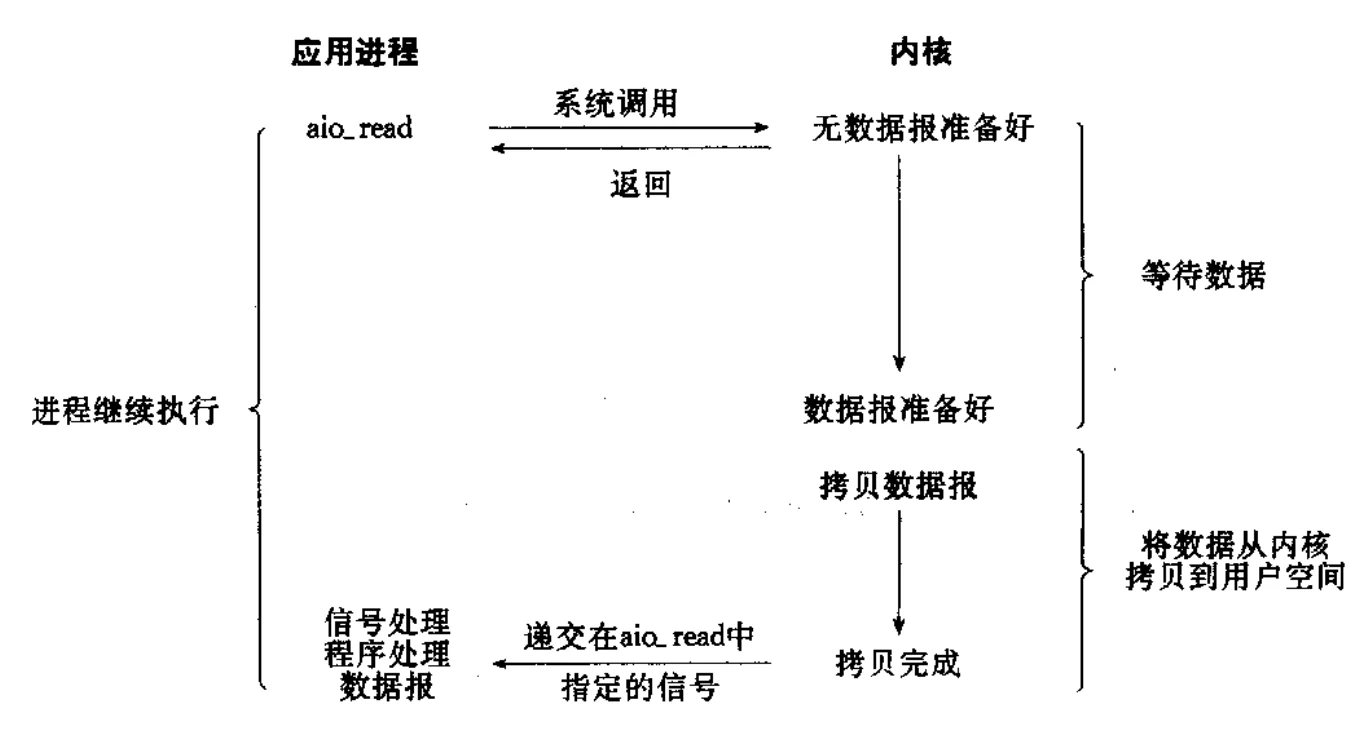
和信号驱动的差别就在拷贝这一段:信号驱动通知的是“可以开始拷贝”,异步 IO 通知的是“已经拷贝完成”。课件先从通信角度给过一对定义:同步调用在结果出来之前不返回,异步调用发出后立刻返回,结果靠状态、通知或回调交付。放到 IO 模型上,POSIX 的判据收敛为一句:发起请求的进程是否被阻塞到 IO 完成。按这个判据,阻塞、非阻塞、多路转接、信号驱动都属于同步 IO,只有最后一种属于异步 IO。
Linux 上 glibc 的 POSIX aio_* 长期是用后台线程模拟的,并不是内核原生异步;真正原生的方案是 io_uring,用提交队列和完成队列把请求与结果都放进用户态和内核共享的环形缓冲区。
同步/异步与阻塞/非阻塞是两根轴
两组概念回答的问题不同:
- 阻塞/非阻塞:调用发出后,当前线程在等待结果时是否被挂起。
- 同步/异步:这个 IO 操作什么时候算完成,完成通知由谁发出。
一根轴描述线程状态,一根轴描述完成时机。判断一个模型属于哪一类,看它有没有把拷贝也交出去,而不是看调用会不会立刻返回。
“同步”还有第三副面孔。多线程里的同步互斥,说的是多个执行流访问临界资源时的次序约束,和同步通信、同步 IO 都不是一回事。看到这个词,先确认上下文。
fcntl 的五类功能,设非阻塞只用了第三类
#include <fcntl.h>

int fcntl(int fd, int cmd, ... /* arg */);
cmd 决定后面追加什么参数。课件列出的五类功能是:
| 功能 | cmd |
|---|---|
| 复制文件描述符 | F_DUPFD |
| 获取/设置文件描述符标志 | F_GETFD / F_SETFD |
| 获取/设置文件状态标志 | F_GETFL / F_SETFL |
| 获取/设置异步 IO 所有权 | F_GETOWN / F_SETOWN |
| 获取/设置记录锁 | F_GETLK / F_SETLK / F_SETLKW |
设非阻塞走第三类:先用 F_GETFL 取出当前状态标志,再 F_SETFL 写回,写回时或上 O_NONBLOCK。不能直接 fcntl(fd, F_SETFL, O_NONBLOCK),那会把原有的 O_APPEND 等标志一并清掉。
#define _POSIX_C_SOURCE 200809L

#include <errno.h>
#include <fcntl.h>
#include <stdio.h>
#include <time.h>
#include <unistd.h>

int SetNoBlock(int fd)
{
    int fl = fcntl(fd, F_GETFL);
    if (fl < 0) {
        perror("fcntl F_GETFL");
        return -1;
    }
    if (fcntl(fd, F_SETFL, fl | O_NONBLOCK) < 0) {
        perror("fcntl F_SETFL");
        return -1;
    }
    return 0;
}

int main(void)
{
    char buf[1024];
    const struct timespec pause = {0, 1000000};   /* 1ms */

    if (SetNoBlock(STDIN_FILENO) < 0)
        return 1;

    for (;;) {
        ssize_t n = read(STDIN_FILENO, buf, sizeof(buf) - 1);
        if (n < 0) {
            if (errno == EAGAIN || errno == EWOULDBLOCK) {
                /* 没有数据,这是非阻塞的正常返回 */
                nanosleep(&pause, NULL);
                continue;
            }
            if (errno == EINTR)
                continue;
            perror("read");
            break;
        }
        if (n == 0) {
            printf("input closed\n");
            break;
        }
        buf[n] = '\0';
        printf("input: %s\n", buf);
    }
    return 0;
}
O_NONBLOCK 是文件状态标志,挂在打开文件描述(open file description)上,不在某个进程的 fd 槽位上。dup、fork 出来的描述符共享同一份状态标志,在一个进程里改掉,另一个进程会一起受影响。
轮询示例里两个必须改的地方
课件最后那段读标准输入的循环,核心结构是“非阻塞读 → 失败 → 睡一秒 → 再试”。它有两个问题。
第一,把所有 read_size < 0 都当成错误调 perror。EAGAIN 不是错误,是“现在没数据”,每轮打一行日志既误导排查,也拖慢循环。要单独判 EAGAIN/EWOULDBLOCK,直接重试或去干别的。
第二,漏了 read_size == 0。对终端或管道,read 返回 0 表示输入结束,不是“暂时没数据”。不处理 0,关闭终端之后循环会一直打印空串。
轮询的代价还体现在“睡多久”上。sleep(1) 把响应延迟拉到了一秒;把 sleep 去掉,循环会把一个核跑满。这两者之间没有免费的中间值,这正是多路转接要解决的问题:让内核替你等,有事件再叫醒。
高级 IO 这个筐里还有什么
课件把非阻塞 IO、记录锁、System V 流机制、IO 多路转接、readv/writev、存储映射 IO(mmap)统称为高级 IO,这一讲重点只取多路转接。这个划分是课程语境下的归拢,不是内核里的正式分类。其中 readv/writev 解决的是“一次调用读写多个不连续缓冲区”,mmap 解决的是“把文件映射进地址空间、省掉一次复制”,它们和五种模型的分类不是同一套维度。
五种模型不是五个可以随便替换的 API,而是一条按“谁承担等待、谁承担拷贝”排列的谱系:阻塞 IO 两段都由进程承担;非阻塞 IO 把等待改成轮询;多路转接把等待集中给一个系统调用;信号驱动把等待的通知交给内核;异步 IO 连拷贝也交给内核。后面要讲的 select、poll、epoll,都站在“集中等待”这一档上。
还没有评论 — 第一条由你来留。