一个公网 IP 后面挂着一整个办公室的机器,外网回来的包目的地址全都一样,路由器凭什么知道该还给哪一台?IPv4 地址不够用是 NAT 出现的原因,但 NAT 真正的本体是那张记录"谁被改写成了谁"的表,地址改写只是表面动作。
私网地址出门时被换掉
IPv4 只有 2^32 个地址,扣掉保留段和特殊用途,远不够每台设备分一个。RFC 1918 划出三段私有地址:10.0.0.0/8、172.16.0.0/12、192.168.0.0/16。这三段可以在无数个互不相干的网络里重复出现,公网路由器不转发它们。
NAT(Network Address Translation)路由器站在私网和公网的边界上,把出去的包的源地址换成自己的公网地址,把回来的包的目的地址换回内网地址。公网地址必须唯一,私网地址不需要,这是整套方案能成立的前提。
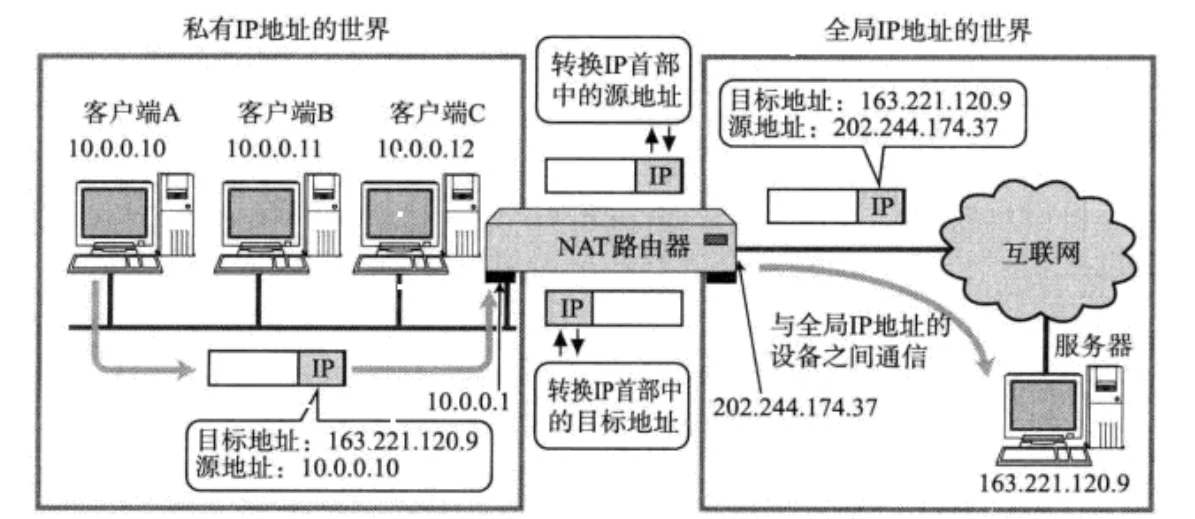
转换表在第一个包经过时自动生成,之后每个包都查表。没有这张表,回来的包只能看到"公网地址",不知道原主是谁。课件把这套流程画成"出去改源地址、回来改目的地址"两步,这两步谁都会背,真正的工作量在中间那张表上。
只改 IP 不够,端口也得改
如果局域网里两台机器同时访问同一个外网服务器,回包的目的 IP 完全相同,只改 IP 的 NAT 就分不清了。解决办法是把端口一起改,这就是 NAPT(Network Address Port Translation)。
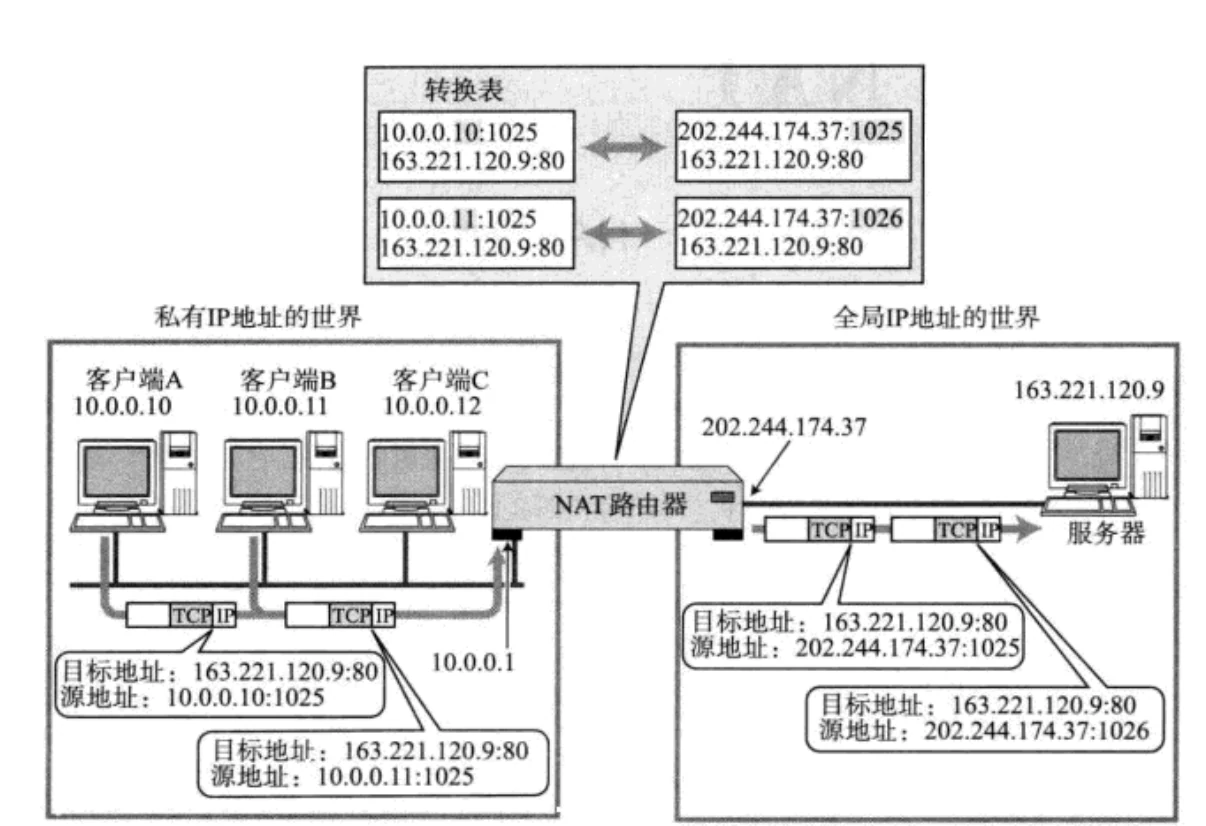
这张表看着简单,键其实不止两项。一条映射要同时记住内网 IP、内网端口、外网 IP、外网端口、协议,再加上目的地址,才能在回包时唯一确定该还给哪条连接。两条不同的内网连接只要目的不同,出口端口可能被分配成不同的值;反过来,同一个内网端口访问不同目标,也可能拿到不同的公网端口。理解了这点,后面端口耗尽、多级 NAT、打洞成败才有解释。
按实现方式,NAT 常分成三类:
- 静态 NAT:一个私网地址固定对应一个公网地址,一对一,配置时就写死。
- 动态 NAT:维护一个公网地址池,有连接时分配一个,连接结束归还。
- NAPT:一个公网地址靠端口复用承载大量内网连接,家用路由器干的都是这个。
课件说"NAT 工作在网络层,直接对 IP 地址进行替换",这只描述了基本 NAT。RFC 3022 对 NAPT 的定义是:把多个网络地址及其 TCP/UDP 端口,翻译成单一网络地址及其对应端口。真正部署的 NAPT 必须改传输层端口,并且要重算校验和——IP 头校验和要改,TCP/UDP 校验和因为伪首部里含 IP 地址也要改。把它纯粹归到第三层,就没法解释 NAT 设备为什么还跟端口耗竭、跟 ALG 这些应用层补丁纠缠不清。
表项的寿命和 NAT 的三个硬伤
课件说"在 TCP 的情况下建立连接时生成表项,断开连接后就删除表项"。工程上没这么干脆。Linux 的 conntrack 按状态加超时回收:TCP 正常挥手结束后,表项还会在 TIME_WAIT 那一段继续留着(默认 120 秒),防止最后几个包找不到归属;UDP 没有连接可谈,只能靠超时。
$ sysctl net.netfilter.nf_conntrack_udp_timeout \
          net.netfilter.nf_conntrack_udp_timeout_stream
net.netfilter.nf_conntrack_udp_timeout = 30
net.netfilter.nf_conntrack_udp_timeout_stream = 120
单向的 UDP 流 30 秒没有后续包就作废,两个方向都见过包的流按 120 秒算。这两个数字解释了一大类现象:走 UDP 的服务超过对应的超时没动静,映射就作废,外面的包再也进不来。做 P2P 或自建 UDP 服务的人要定时发心跳,是协议之外的手段,目的是不让中间那张表忘掉你;间隔设 20 秒还是 25 秒,取决于出口是一台家用路由还是三层 NAT 叠在一起。
课件列的三条缺陷都成立,但第一条要加限定:
- 无法从外部主动向内部建立连接——准确说是"没做端口映射时无法主动发起"。端口映射(DNAT)就是标准的入站方案:在 NAT 设备上写一条固定规则,把公网某端口的目标地址翻译成内网某台机器。它绕开了"表项必须由内网先发起"的限制。
- 转换表的生成和销毁有额外开销——连接数上百万时,conntrack 表本身会成为性能瓶颈和内存压力。
- NAT 设备故障会断开所有连接——所有连接状态都集中在那个盒子里,即使有热备,切换瞬间状态也未必完整,已建立的 TCP 连接会断。
还有一层课件没提,但很常见:FTP、SIP 这类协议把 IP 和端口写在应用层载荷里,只改 IP 头没用。设备要靠 ALG(Application Level Gateway)去翻载荷,实现起来容易出问题,关掉 ALG 反而更稳的场景不少。这也说明 NAT 对应用并非完全透明,所谓"透明"只到传输层为止。
正向代理:替客户端出面
正向代理(forward proxy)站在客户端这一侧,代表客户端向目标服务器发请求。客户端明确知道自己在用代理,目标服务器看到的来源是代理,不知道真正的客户是谁。
流程分五步:客户端把请求发给代理;代理按配置处理(查缓存、做内容过滤、检查访问策略);代理把处理后的请求转发给目标;目标把响应回给代理;代理再把响应交给客户端。
它能做的事都围绕"替客户端出面"这个位置展开:
- 缓存常用资源,重复请求直接从代理取,省一次往返;
- 按规则过滤请求和响应,屏蔽广告站、恶意站;
- 做访问控制,例如限制工作时间访问娱乐站点;
- 隐藏客户端真实 IP;
- 在多个目标之间分摊请求。
典型场景是企业出口的统一上网管理、学校图书馆的资源和带宽分配、家长端的内容过滤,以及需要从受限网络访问外部资源的场合。游戏加速器也属于这一类:客户端先连到较近的加速节点,由节点再接到游戏服务器,链路绕开了原来那段拥塞的路。
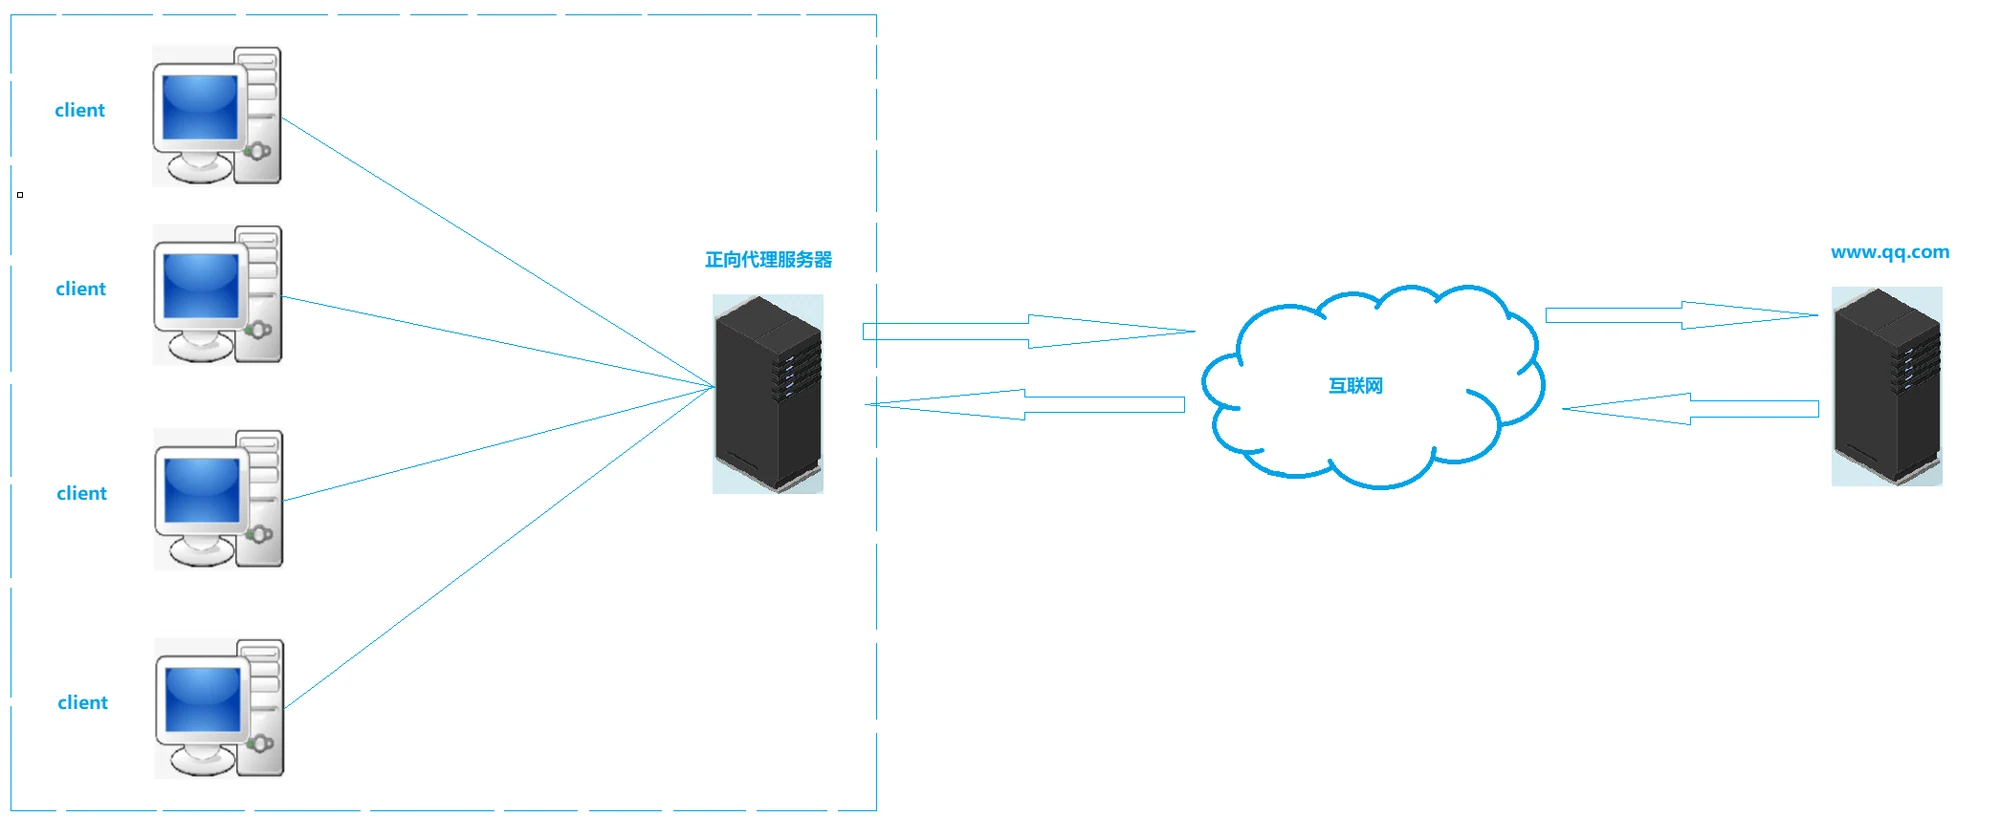
课件在讲正向代理时列了 Nginx。需要区分一下:Nginx 最常扮演的是反向代理,正向代理的经典实现是 Squid。Nginx 通过 proxy_pass 转到上游、配合 resolver 也能做正向转发,但这不是它的主战场。
另外,代理"能看见应用层"这句话有边界。纯 HTTP 代理能读到请求行和头;HTTPS 走的是 CONNECT 建立隧道,代理之后只是转发字节,看不到内容,除非它自己做了证书替换(中间人解密)。
反向代理:站在服务器前面
反向代理(reverse proxy)站在 Web 服务器前面,接收客户端请求,再转发给后端。客户端不知道背后有几台服务器,它以为自己在跟一台机器通信。
- 负载均衡:按策略把请求分发到多台后端,提升并发能力。
- 安全保护:隐藏后端真实 IP,统一配置访问控制,减少后端被直接攻击的面。
- 缓存加速:缓存后端响应,重复请求直接返回,降低后端压力。
- 内容过滤与重写:增删请求头、改写路径,支撑 URL 重写、统一认证这类需求。
- 动静分离:静态资源放在代理上直接返回,动态请求才转给后端。
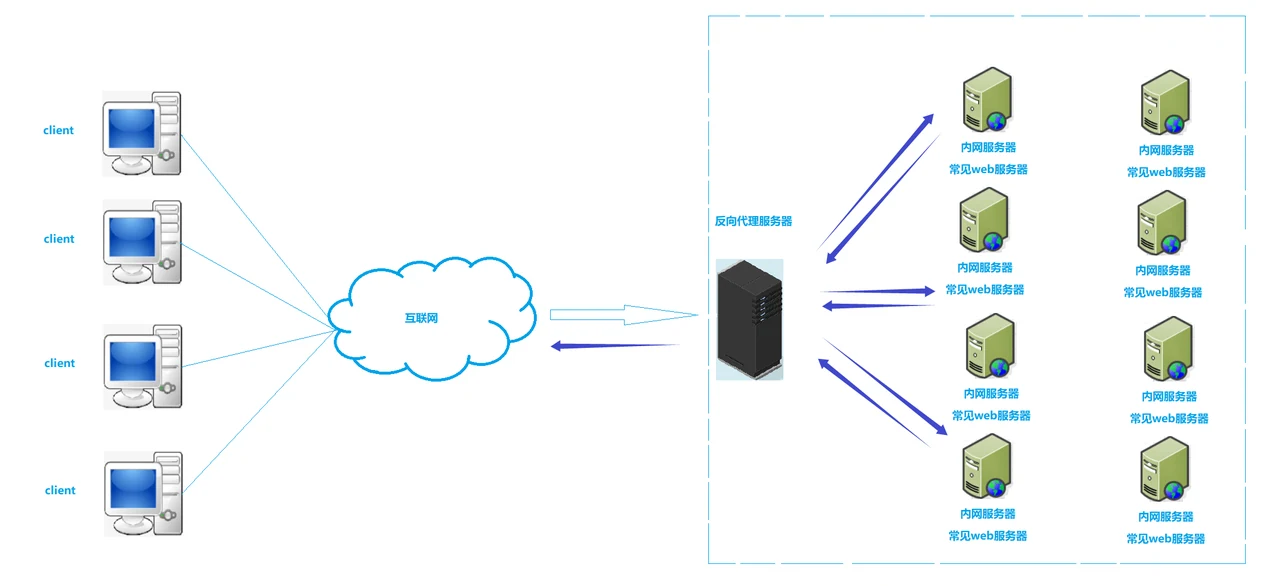
CDN(Content Delivery Network)就是反向代理的大规模版本:每个边缘节点都是一个反向代理,缓存源站内容,就近响应。课件把 CDN 归到反向代理原理下,这个归类准确。
课件还说"反向代理往往作为一个缓存"。缓存只是它的一项可选能力。真正的核心是"代表后端接收请求":Nginx 默认的 proxy_pass 一行缓存都不配,照样是标准的反向代理;CDN 的价值大头是就近接入和回源保护,不只是命中率。
课件用代购打比方:自己去日本买尿不湿不方便,托在日本的表姐去超市买了寄回来,超市眼里的买家只有表姐,表姐就是正向代理;后来找她代购的人多了,她干脆囤一批货在家里,谁来要就直接发,不必再跑超市,这时她变成了反向代理。方向是唯一的分界线:代理站在客户端前面,还是站在服务端前面。
NAT 与代理差在哪几层
两者都做"中转",但中转的层次和对象完全不同。
| 对比项 | NAT | 代理服务器 |
|---|---|---|
| 解决的问题 | IP 地址不足 | 具体的应用需求,如访问控制、加速、隐藏来源 |
| 工作层次 | 网络层(NAPT 还要动传输层) | 应用层 |
| 改写对象 | IP 头、端口、校验和 | 整个请求,可读可改可缓存 |
| 部署位置 | 一般集成在路由器、防火墙上 | 一个软件程序,部署在服务器上 |
| 使用范围 | 通常放在局域网出口 | 局域网、广域网、跨网都可以 |
一句话概括:NAT 改的是信封上的地址,不拆信;代理是把信拆开看一遍,再重新写一封。所以 NAT 天生对应用透明,却也天生处理不了把地址写在正文里的协议;代理天生能看见应用层,也就天生多一层开销和配置。
内网穿透:打洞能成的条件,和中继的兜底
内网机器没有公网地址,外部无法主动连进来。要把服务露出去,只有三条路。
第一条是端口映射,前提是有公网 IP 且能登录路由器。性能最好,不在链路上多加一跳,也不动应用层内容,但拿不到公网 IP 就无从谈起,多级 NAT 下还得每一层都配。
第二条是打洞(hole punching)。两端先通过一台公网服务器交换各自的公网地址和端口,然后同时向对方发包,让各自出口的 NAT 表里临时开一个洞,之后直连。能否成功取决于出口 NAT 的类型:全锥型只要内网先发过一个包,任何外部地址都能顺着映射进来;受限型还要求来源 IP 对得上;对称型对每个目的地分配不同的公网端口,双方拿到的地址对不上,打洞基本失败。这也是同类软件有时直连、有时中转的原因——不是软件写得好不好,是出口设备的类型用户决定不了。
第三条是反向隧道,frp、ngrok 这类工具的做法。内网机器主动连上一台有公网 IP 的服务器,维持一条长连接,外部访问服务器上的映射端口,流量顺着这条连接送回内网。
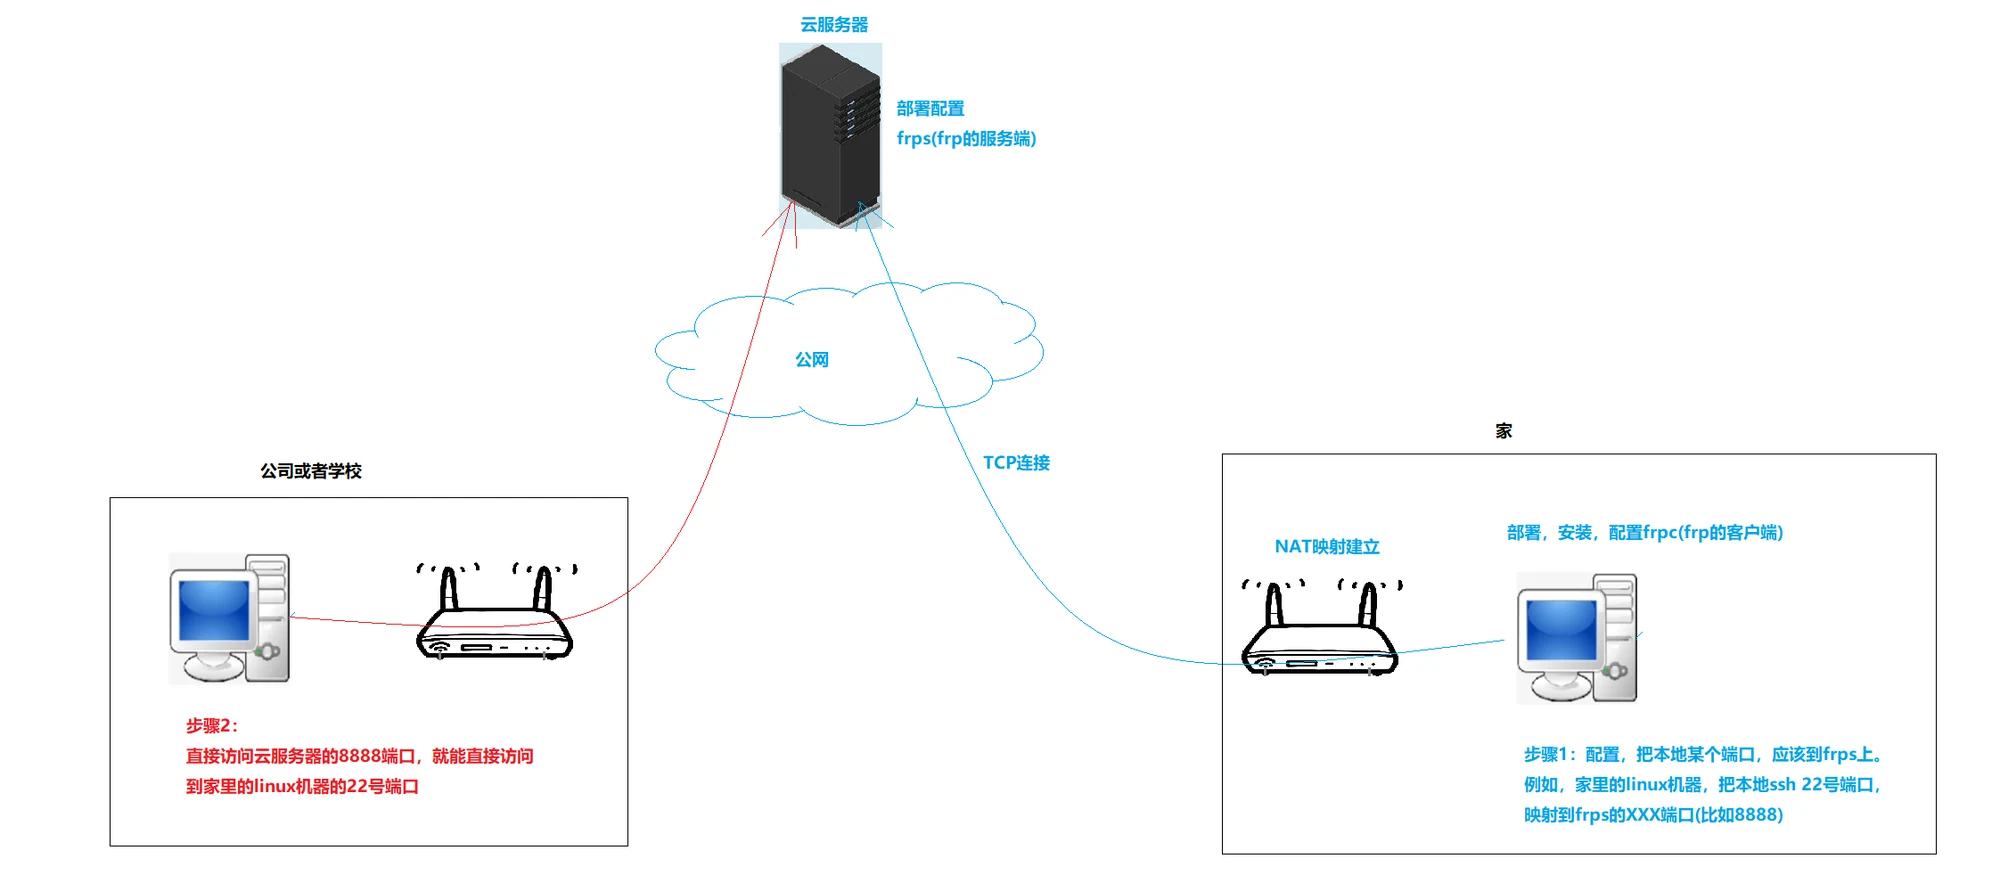
对 NAT 来说,这条连接始终是"内网主动外连",出口没有任何理由拦。代价是多一跳、带宽全走服务器;好处是不依赖 NAT 类型——只要能访问外网就行,而这一条几乎是所有网络的底线。
三条路的取舍:能拿到公网 IP 就做端口映射;拿不到但两端 NAT 友好就试打洞;都不成立就租一台服务器当中转。frp 里的 xtcp 属于第二条,打洞成功时流量不过服务器,失败时自动退回中转;成不成取决于两边的 NAT 类型,不取决于配置文件写得多漂亮。
还没有评论 — 第一条由你来留。