一个 a.out 放在磁盘上时不占 CPU、不占内存页、也没有 PID。运行起来之后,内核给它分配 task_struct、地址空间和一堆资源,它才开始“活着”。同一份 a.out 可以同时跑出十个进程,十个进程的代码段来自同一个文件,PID、打开的文件和地址空间却各是各的。程序和进程的差别就在这一层。
程序是文件,进程是内核登记的执行实例
可执行文件是磁盘上的 ELF,包含代码、只读数据、符号表和入口地址,它是静态的。进程是这个文件被加载后的一次执行:内核为它建立 task_struct,建立页表把虚拟地址映射到物理页,把 CPU 寄存器设到入口,再把它挂进调度队列。课件给的等式是“进程 = 内核数据结构 + 自己的程序代码和数据”,这个说法抓住了核心。
数据在硬件之间的流动受冯诺依曼结构约束:
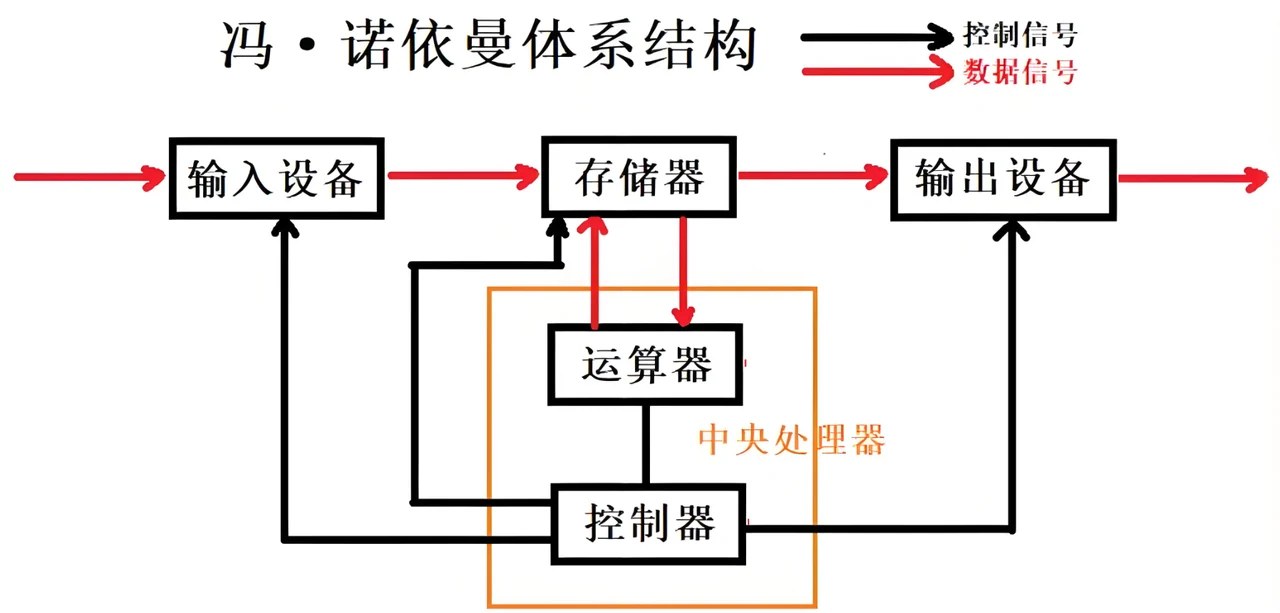
不考虑缓存时,CPU 不能直接读写键盘或显示器,外设也不能直接和 CPU 交换数据,所有数据都要经过内存。键盘输入先写进内存,CPU 从内存取指令和操作数,算完再写回内存,显示器从内存取像素。QQ 发一条消息,数据从键盘进内存,经网卡发出;对方收到后从网卡进内存,再送到显示器。
操作系统站在硬件和应用之间:对下管理 CPU、内存、磁盘、网卡,对上给应用提供执行环境。狭义的操作系统指内核,负责进程管理、内存管理、文件管理和驱动管理;广义还包括 shell、glibc、系统服务这些用户态程序。
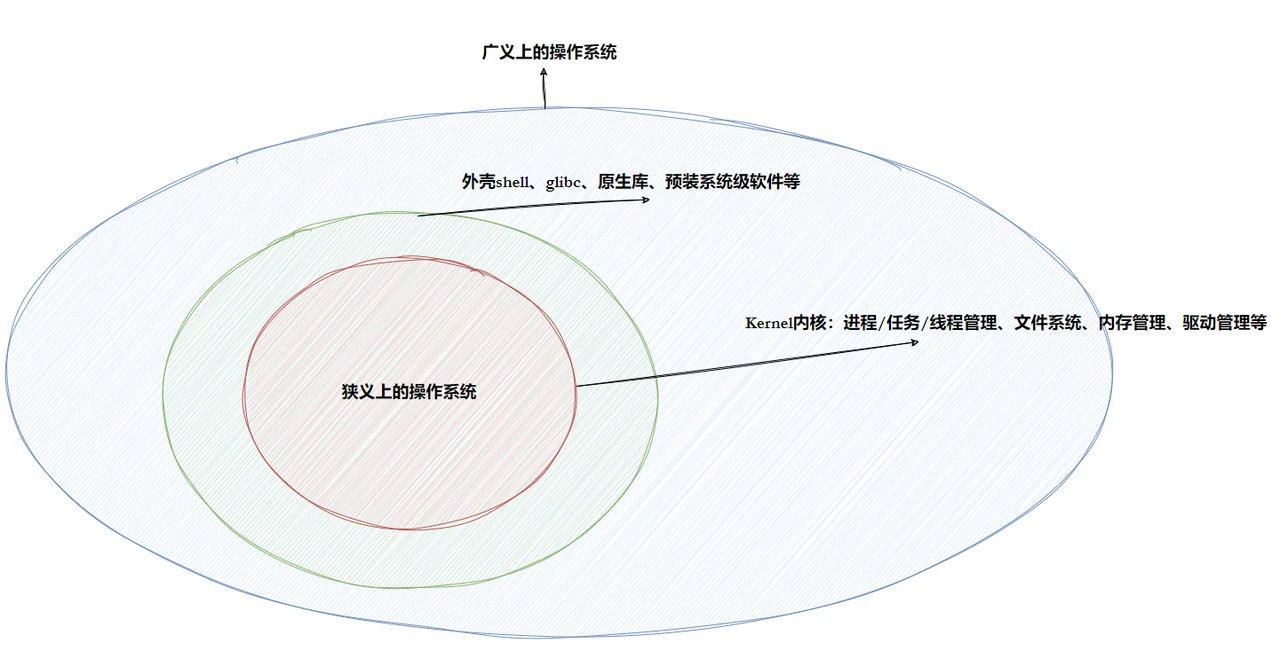
内核不会把内部函数直接暴露给应用。应用通过系统调用进入内核,系统调用功能基础、参数偏底层,glibc 把它们封装成 fopen、malloc 这类库函数,应用再用库函数写业务。fork、wait、open 是系统调用,printf、fopen 是库函数,这条界线在后面讲 IO 时会反复用到。
task_struct 记什么,进程怎么被组织
描述进程的结构体叫进程控制块(PCB,process control block),Linux 里的实现是 task_struct,定义在内核源码的 include/linux/sched.h。它装在内存里,字段大致分八类:
- 标识符:
pid、tgid,用来区分进程和线程组; - 状态:运行、睡眠、停止、僵尸等,以及退出码和终止信号;
- 优先级:调度时谁先上;
- 程序计数器:下一条要执行的指令地址;
- 内存指针:
mm指向地址空间,还记录与其他进程共享的内存块; - 上下文:CPU 寄存器的现场,切换时保存和恢复;
- I/O 状态:打开的文件表、分配的设备和挂起的 I/O 请求;
- 记账信息:累计 CPU 时间、时钟数、时间限制等。
课件说“所有进程都以 task_struct 双链表的形式存在内核里”。双链表确实是其中一套索引:内核用 tasks 链表串起所有进程,方便遍历。
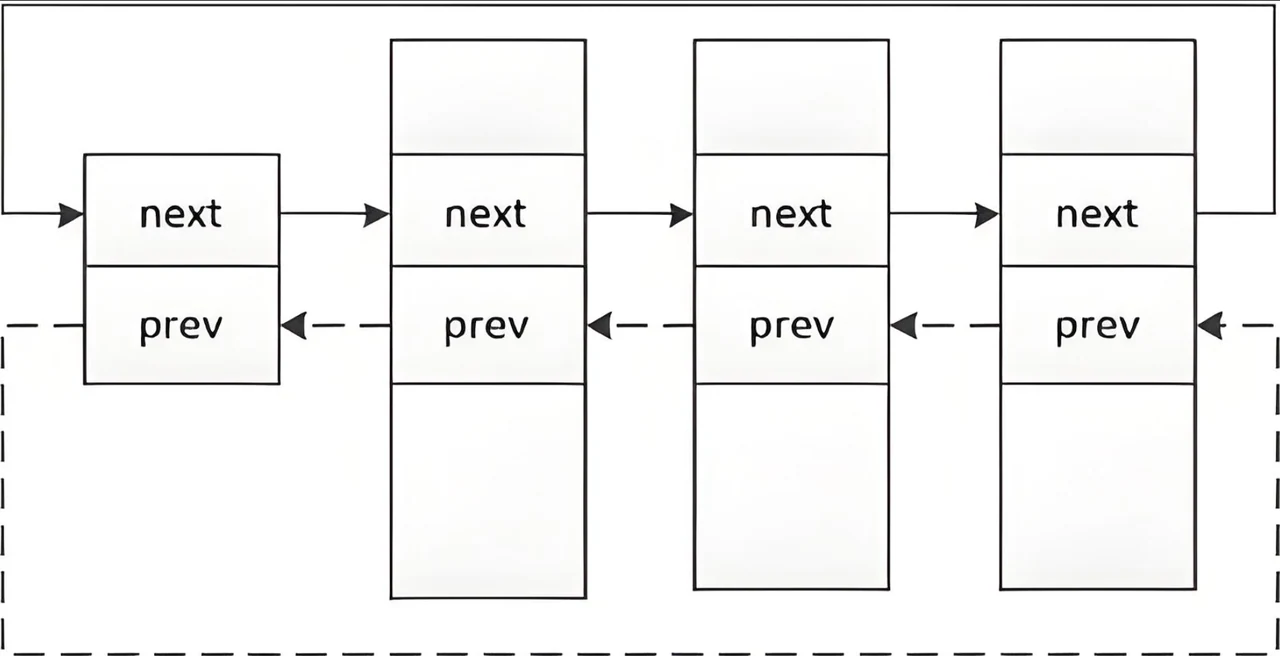
但只有链表不够。按 PID 查一个进程,用的是哈希表;调度器挑下一个要跑的,看的是每个 CPU 的运行队列;普通进程还按虚拟运行时间挂在红黑树上。同一条 task_struct 同时挂在多套结构里,是为了让“遍历全部”“按 PID 查”“挑最高优先级”各自都能快,不是重复存储。
查看进程有两条路:用户态工具 /proc 和 ps、top。ps aux 列出所有进程:a 包含其他用户的进程,x 把没有控制终端的后台进程也带上,u 用用户友好的格式列出 CPU、内存占用;ps axj 额外给出进程组、会话和父进程;ps -l 的长格式带 PRI 和 NI。/proc/<pid> 是内核暴露的目录,里面有 cwd(当前目录的符号链接)、exe(可执行文件路径)、fd(打开的文件描述符)、environ(环境变量)等。程序自己可以用 getpid() 和 getppid() 拿到 PID 和父 PID:
#include <stdio.h>
#include <sys/types.h>
#include <unistd.h>

int main(void)
{
    printf("pid: %d\n", getpid());
    printf("ppid: %d\n", getppid());
    return 0;
}
状态字母与僵尸、孤儿
内核源码里的状态数组给出七个字母和对应的位值:
| 字母 | 名称 | 含义 |
|---|---|---|
R | running | 正在 CPU 上运行,或在运行队列里等着运行 |
S | sleeping | 可中断睡眠,等事件完成,能被信号唤醒 |
D | disk sleep | 不可中断睡眠,通常在等磁盘 I/O,信号也叫不醒 |
T | stopped | 被 SIGSTOP 或终端 Ctrl+Z 暂停,可被 SIGCONT 继续 |
t | tracing stop | 被调试器 ptrace 跟踪而暂停 |
X | dead | 已死亡,只是返回状态,不会出现在进程列表里 |
Z | zombie | 已退出,但父进程还没读取退出状态 |
位值是 R=0、S=1、D=2、T=4、t=8、X=16、Z=32。教材还会画“创建、就绪、运行、阻塞、挂起”的通用状态图,Linux 把“就绪”和“运行”都归在 TASK_RUNNING 里,所以 R 不代表一定正在占 CPU。
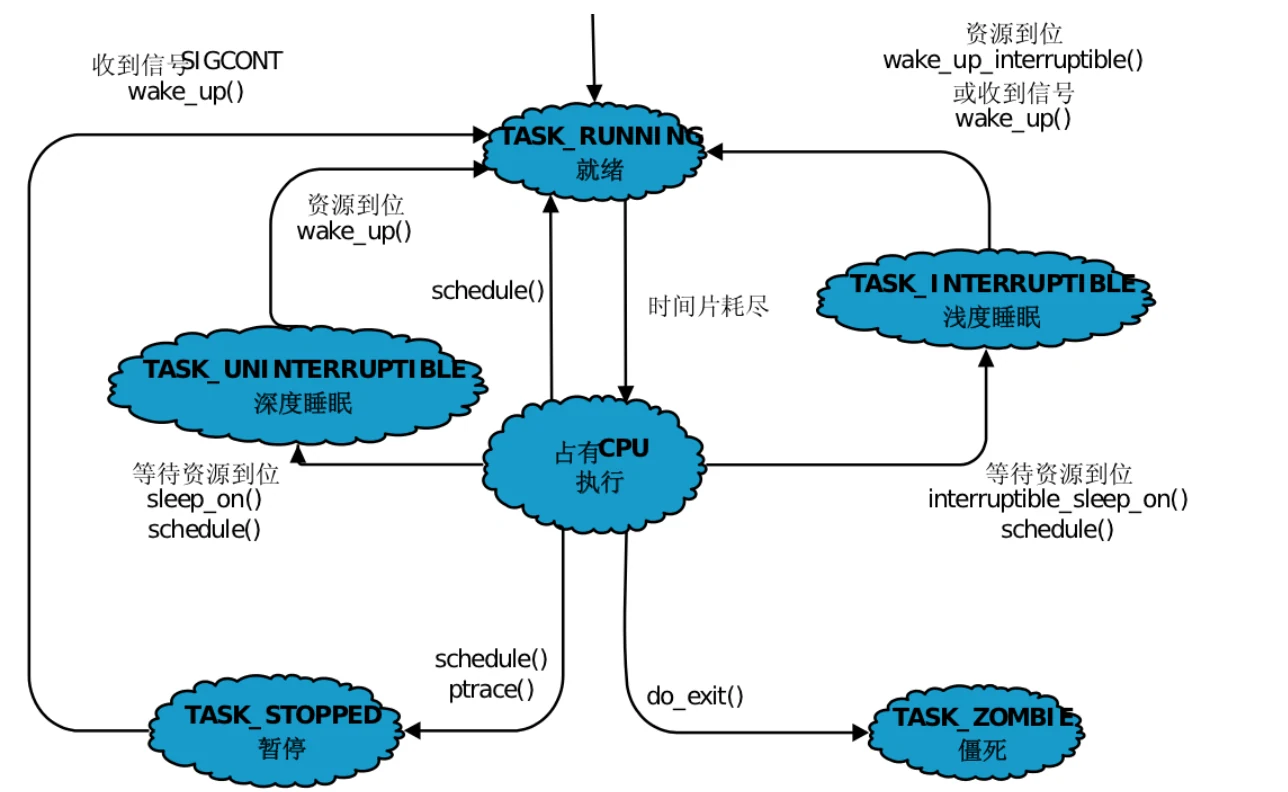
子进程退出后,代码和数据可以释放,但退出码必须留着给父进程看。父进程没有调用 wait 或 waitpid 时,内核保留这个 task_struct,状态标成 Z。这就是僵尸进程:它已经没有执行流,只剩一份 PCB,所以 kill -9 也杀不掉;能清掉它的只有父进程读取退出状态,或者父进程自己也退出。
#include <stdio.h>
#include <stdlib.h>
#include <sys/types.h>
#include <unistd.h>

int main(void)
{
    pid_t id = fork();
    if (id < 0) {
        perror("fork");
        return 1;
    }
    if (id == 0) {
        printf("child %d will exit\n", getpid());
        sleep(2);
        exit(0);
    }
    printf("parent %d sleeps, child %d becomes zombie\n", getpid(), id);
    sleep(30);
    return 0;
}
编译运行后,在另一个终端用 ps -eo pid,ppid,stat,cmd 能看到子进程状态是 Z、命令名后面带 <defunct>。僵尸的危害不只是“看着难受”:每个僵尸都占着一个 PID 和一份 task_struct,父进程不停创建子进程又不回收,PID 会被耗尽,fork 最终失败。
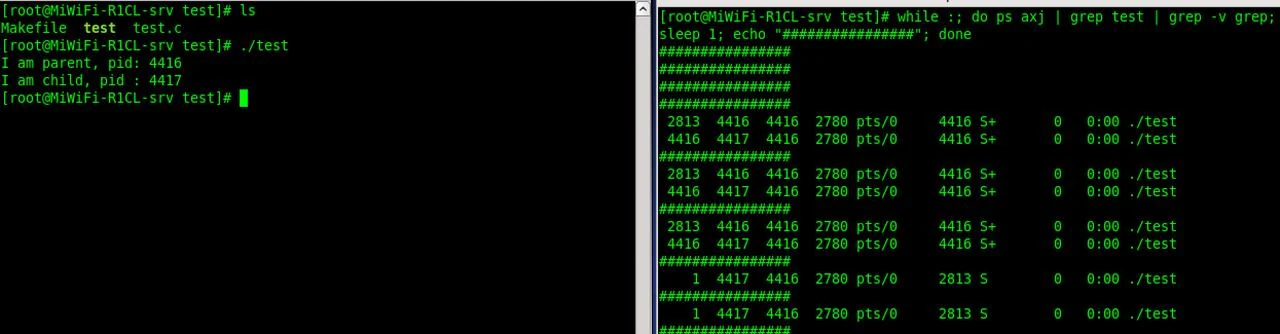
父进程先退出、子进程后退出,子进程成为孤儿进程。它会被 PID 1 的 init 或 systemd 收养,退出时由收养者回收,所以孤儿本身不会长期停在 Z。
#include <stdio.h>
#include <stdlib.h>
#include <sys/types.h>
#include <unistd.h>

int main(void)
{
    pid_t id = fork();
    if (id < 0) {
        perror("fork");
        return 1;
    }
    if (id == 0) {
        printf("child %d, ppid %d\n", getpid(), getppid());
        sleep(10);
        printf("child after parent exit, ppid %d\n", getppid());
        return 0;
    }
    printf("parent %d exits\n", getpid());
    sleep(1);
    exit(0);
}
fork 的两次返回与写时拷贝
#include <unistd.h>
pid_t fork(void);
fork 从已有进程创建一个新进程,原进程是父,新进程是子。返回值有三种:子进程里返回 0,父进程里返回子进程的 PID,失败返回 -1。父进程需要 PID 才能 wait 指定的孩子;子进程拿到 0 就知道“我是被创建出来的那一个”,不需要知道自己的 PID(getpid() 随时能取)。
“一个函数返回两次”不是函数写了两个 return,而是 fork 在内核里复制出一个执行流后,两个执行流都从 fork 的调用点继续跑。内核把返回值分别写进两个进程的 rax:子进程写 0,父进程写子 PID。两个进程各自有一份寄存器和栈,所以 if 与 else 在各自的空间里分别成立,不是同一个变量同时等于 0 又大于 0。
#include <stdio.h>
#include <sys/types.h>
#include <unistd.h>

int main(void)
{
    pid_t ret = fork();
    if (ret < 0) {
        perror("fork");
        return 1;
    }
    if (ret == 0)
        printf("child: pid=%d ret=%d\n", getpid(), ret);
    else
        printf("parent: pid=%d ret=%d\n", getpid(), ret);
    return 0;
}
调用的瞬间,内核做四件事:给子进程分配新的 task_struct 和地址空间描述;复制父进程的部分内核数据;把子进程挂进进程列表和调度队列;让父子各自从 fork 返回。复制的是页表,不是物理页内容。
写时拷贝(copy-on-write,COW)就发生在这里:父子进程的页表先指向同一批物理页,这些页被标成只读。任何一方写入,CPU 触发页错误,内核才发现“这一页要私有”,于是复制一份新页、改页表、把写权限打开。没有写入的页一直共享。这样 fork 可以很快返回,不必立刻复制整个地址空间;父子真正分开是在第一次写入时。
课件有一句“父子进程代码共享,数据各自开辟空间,私有一份(采用写时拷贝)”,前半句和后半句互相打架。按 COW 的规则,数据在 fork 后也是共享的,直到某一方写入才复制;如果 fork 后立刻复制全部数据,就不需要写时拷贝这个机制了。
fork 失败通常有两个原因:系统里的进程数到上限,或当前用户的进程数超过限制。fork 之后父子两个执行流谁先拿到 CPU、谁先跑完,由调度器决定,代码不能假设子进程一定先执行。fork 的常见用法有两种:父进程复制自己,让子进程处理另一段逻辑(例如每个客户端一个子进程);子进程从 fork 返回后立刻调用 exec,去执行一个完全不同的程序。
地址空间:每个进程都以为自己独占内存
在 32 位 Linux 上跑一段打印地址的程序,能看到各区域的相对位置:
#include <stdio.h>
#include <stdlib.h>
#include <unistd.h>

int g_uninit;
int g_init = 10;
static int s_init = 20;

int main(int argc, char *argv[], char *envp[])
{
    const char *ro = "readonly";
    char *p1 = malloc(16);
    char *p2 = malloc(16);

    printf("main      %p\n", (void *)main);
    printf("g_init    %p\n", (void *)&g_init);
    printf("g_uninit  %p\n", (void *)&g_uninit);
    printf("s_init    %p\n", (void *)&s_init);
    printf("rodata    %p\n", (void *)ro);
    printf("heap1     %p\n", (void *)p1);
    printf("heap2     %p\n", (void *)p2);
    printf("stack     %p\n", (void *)&p1);
    printf("argv[0]   %p\n", (void *)argv[0]);
    printf("env[0]    %p\n", (void *)envp[0]);

    free(p1);
    free(p2);
    return 0;
}| 区域 | 放什么 | 增长方向 |
|---|---|---|
| 代码段 text | 机器指令,main 的地址就在这里 | 固定 |
| 只读数据 rodata | 字符串字面量、const 全局量 | 固定 |
| 数据段 data | 已初始化的全局变量、静态变量 | 固定 |
| BSS | 未初始化或初始化为 0 的全局变量、静态变量 | 固定 |
| 堆 heap | malloc、new 申请的空间 | 向高地址 |
| 共享库 | libc.so 等映射进来的代码和数据 | 固定或随加载器 |
| 栈 stack | 局部变量、函数调用现场 | 向低地址 |
| 参数与环境 | argv 字符串、envp 字符串 | 位于用户空间最高处 |
g_init 和 s_init 在 data,g_uninit 在 BSS,字符串 "readonly" 在 rodata,malloc 两次得到的地址相差一个分配块的大小,局部指针 p1 自己在栈上。argv 和 envp 指向的字符串位于栈的上方。
这些地址都不是物理地址。让父进程先 fork,子进程把全局变量改成 200,父子打印同一个 &g_val,会看到地址相同、值不同:
#include <stdio.h>
#include <stdlib.h>
#include <sys/types.h>
#include <unistd.h>

int g_val = 100;

int main(void)
{
    pid_t id = fork();
    if (id < 0) {
        perror("fork");
        return 1;
    }
    if (id == 0) {
        g_val = 200;
        printf("child: %d at %p\n", g_val, (void *)&g_val);
    } else {
        sleep(1);
        printf("parent: %d at %p\n", g_val, (void *)&g_val);
    }
    return 0;
}
同一个虚拟地址,在子进程的页表里映射到一块新物理页,在父进程的页表里仍映射到原来那块。C 语言里看到的地址全是虚拟地址,物理地址由页表翻译,用户态看不到。
内核用 mm_struct(内存描述符)描述一个进程的用户空间。task_struct 里的 mm 指针指向它;普通进程有自己的 mm_struct,内核线程的 mm 为 NULL,借用其他进程的 active_mm,因为内核部分的映射在所有进程里都一样。mm_struct 里既有两套组织 VMA 的索引(mmap 单链表和 mm_rb 红黑树),也直接记着各段的边界:start_code/end_code 管代码段,start_data/end_data 管数据段,start_brk/brk 管堆的起止,start_stack 记栈顶,arg_start/arg_end 和 env_start/env_end 记参数字符串与环境字符串的范围。
一段连续、权限相同的虚拟内存叫 VMA(virtual memory area),用 vm_area_struct 描述,记录 vm_start、vm_end、vm_flags、vm_file 等。VMA 少时用 mmap 单链表串,多时用 mm_rb 红黑树查。
虚拟地址空间解决的是直接使用物理地址的三个问题:任意进程都能读写任意内存,没有隔离;程序每次加载的物理位置不确定;换出时只能整块进程搬走。有了页表,进程只能访问自己映射过的页,物理页可以放在任意位置,malloc 先只占虚拟区间、访问时才分配物理页(延迟分配),换页也可以按页做,内存管理和进程管理因此解耦。
优先级、nice 与 O(1) 运行队列
CPU 少、进程多,谁先跑由优先级决定。ps -l 的两列最关键:PRI 是优先级,值越小越早执行;NI 是 nice 值,是优先级的修正量。nice 的范围是 -20 到 19,共 40 级,负值让进程更“不客气”,优先级更高。
课件给的公式是 PRI(new) = PRI(old) + nice。在 2.6 内核的普通进程里,静态优先级等于 120 + nice,所以 nice = -20 对应 100,nice = 19 对应 139;实时进程单独占 0 到 99。把 nice 调小,进程更容易被调度,但普通用户只能调高自己的 nice,调低要 root。
ps -l
top                 # 进去按 r,输入 PID,再输入 nice 值
nice -n 10 ./a.out  # 以 nice=10 启动
renice -n 5 -p 1234 # 改已运行进程的 nice
#include <sys/resource.h>
int getpriority(int which, int who);
int setpriority(int which, int who, int prio);which 可以取 PRIO_PROCESS、PRIO_PGRP、PRIO_USER,who 是对应的 ID。getpriority 返回当前值,setpriority 设置新值,失败返回 -1 并设置 errno。由于 -1 本身也是合法 nice 值,调用 getpriority 前先把 errno 置 0,返回 -1 时再看 errno 是否真的出错。
进程之间有竞争性:CPU 只有少量,大家都要用,所以需要优先级来排先后。也有独立性:每个进程有自己的地址空间、打开文件表和寄存器现场,一个进程崩溃不会直接改掉另一个进程的变量。多个进程在多颗 CPU 上同时跑叫并行;在一颗 CPU 上按时间片轮转、让每个进程都向前推进叫并发。
上下文切换(context switch)发生在时间片用完、进程阻塞或更高优先级进程就绪时:内核把当前进程的寄存器保存到它的栈和 task_struct,再从下一个进程保存的现场恢复寄存器,跳到它上次停下的位置。时间片本质上是一个计数器,用完就被换下。
Linux 2.6 的 O(1) 调度器给每个 CPU 一个运行队列,队列里有两组优先级数组:活动队列放时间片还没用完的进程,过期队列放时间片已经用完的进程。queue[140] 的每个下标对应一个优先级,相同优先级的进程按 FIFO 排队;bitmap[5] 用 5 个 32 位字(160 位)标记 141 个优先级队列是否非空,找最高优先级只要从 bitmap 里找第一个非零位,耗时与进程数量无关。
活动队列里的进程逐渐减少,过期队列逐渐增多。活动队列空了以后,交换 active 和 expired 两个指针,过期队列变成新的活动队列,同时重新计算时间片。这就是“O(1)”的来源:选下一个进程不需要遍历所有进程。
环境变量:从 environ 到 getenv
环境变量是操作系统给进程准备的一组 KEY=VALUE 字符串,常见的有 PATH(命令搜索路径)、HOME(家目录)、SHELL(当前 shell,通常是 /bin/bash)。PATH 让 shell 能直接找到 ls,链接器也靠相关环境变量找到库。
echo $PATH
export MYENV="hello world"
env
unset MYENV
set
export 把变量放进环境表,env 打印整张环境表,unset 删除,set 同时显示 shell 本地变量和环境变量。只在命令行写 MYENV=hello 而不 export,它只是 shell 的本地变量,不会进环境表。
环境表在进程里是一张字符指针数组,每个指针指向一个以 \0 结尾的 KEY=VALUE 字符串,数组末尾以 NULL 收尾。程序有三种取法:
#include <stdio.h>
#include <stdlib.h>

extern char **environ;

int main(int argc, char *argv[], char *envp[])
{
    for (int i = 0; envp[i]; i++)
        printf("envp[%d] = %s\n", i, envp[i]);

    for (int i = 0; environ[i]; i++)
        printf("environ[%d] = %s\n", i, environ[i]);

    const char *path = getenv("PATH");
    printf("PATH = %s\n", path ? path : "(null)");
    return 0;
}
main 的第三个参数 envp 是环境表;environ 是 libc 里定义的全局指针,没有放在任何头文件里,用之前要 extern 声明;getenv 按名字查,找不到返回 NULL。
课件把 getenv、putenv 归到“通过系统调用获取或设置环境变量”。getenv、setenv、putenv 都是 libc 提供的库函数,不是系统调用;它们读写的是进程地址空间里的 environ 数组,不进入内核。真正把环境表交给新程序的是 execve 的第三个参数,系统调用层面只有这一处。
环境变量会被子进程继承:父进程 fork 后,子进程拿到同一份环境表;exec 装载新程序时,默认把当前环境表传过去。这也解释了 export 的必要性——只有进了环境表的变量才会被 exec 传下去。可以写个小程序验证:
#include <stdio.h>
#include <stdlib.h>

int main(void)
{
    const char *v = getenv("MYENV");
    printf("MYENV = %s\n", v ? v : "(not found)");
    return 0;
}
export MYENV="hello world" 后再运行,能打印出来;只写 MYENV=hello 就运行,程序看到的是 (not found)。想让变量每次登录都存在,可以写进 ~/.bashrc 或 ~/.bash_profile,但那属于 shell 的启动配置,不是进程本身的机制。
还没有评论 — 第一条由你来留。