装好系统之后,写代码这条链路是固定的:用包管理器补工具,用编辑器写源文件,用编译器把源文件变成可执行文件,用构建工具把重复的编译命令收进 Makefile,用调试器在出错时停下来看变量,用版本控制器把每次改动存下来。每一环都有自己的“输入—输出”,下面按这个顺序拆。
包管理器:把依赖关系从人脑挪到仓库
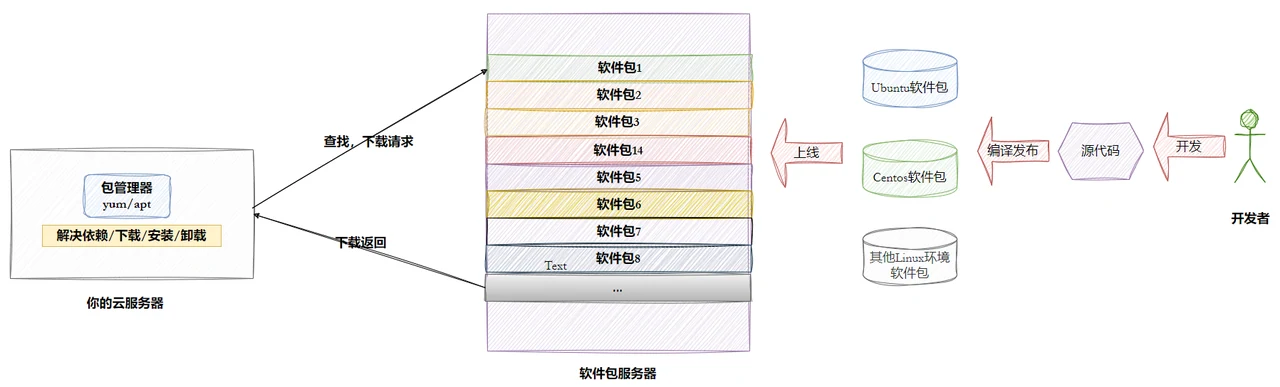
Linux 下装软件最原始的办法是下载源码自己编译,麻烦在于依赖:一个程序可能依赖 libc.so、libssl.so、libhttp.so,后者又依赖 libc++.so。包管理器把“已编译好的程序 + 依赖清单”放在远端仓库,本地只负责按清单取回并安装。
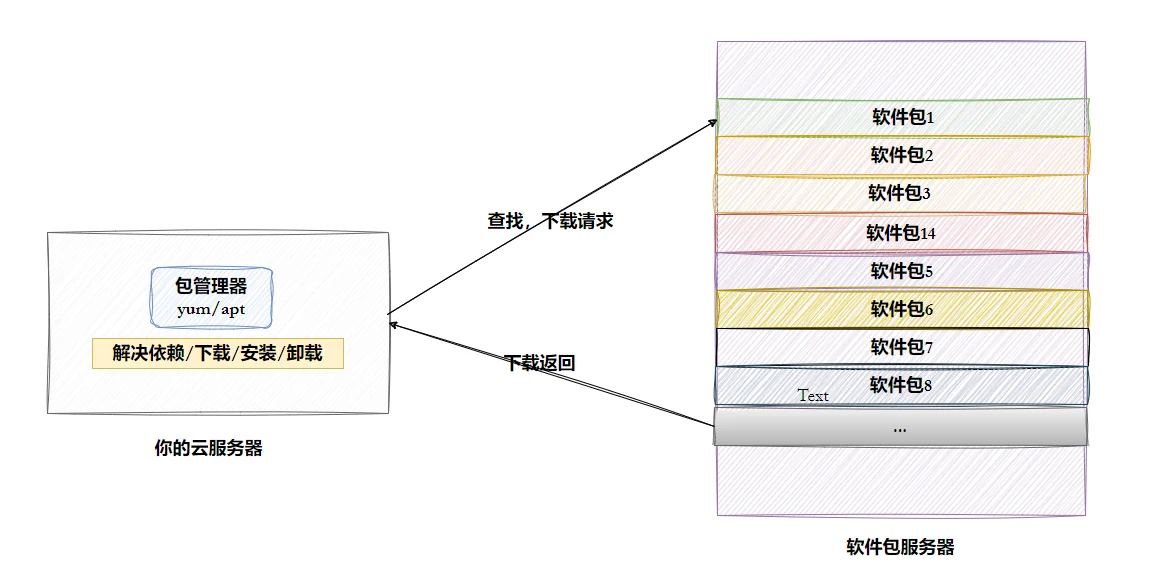
CentOS、RHEL、Fedora 用 yum,Ubuntu、Debian 用 apt,两者都自动解决依赖。软件包文件名带四段信息:包名、主次版本号、发行号、架构,例如 lrzsz.x86_64 0.12.20-36.el7。x86_64 是 64 位,i686 是 32 位,el7 对应 CentOS 7 / RHEL 7,末列的 base、epel 是软件源名字。
# CentOS
yum list | grep lrzsz
sudo yum install -y lrzsz
sudo yum remove -y lrzsz

# Ubuntu
apt search lrzsz
sudo apt install -y lrzsz
sudo apt remove -y lrzsz
安装要向系统目录写文件,普通用户要加 sudo 或切到 root。同一个包管理器一次只能跑一个安装进程,装到一半再开另一个会报错。所有在线操作都要求网络畅通,ping 一下仓库域名就能确认。
软件源本身是配置文件:CentOS 在 /etc/yum.repos.d/*.repo,CentOS-Base.repo 是标准源,epel.repo 是扩展源,扩展源可以用 sudo yum install -y epel-release 装上;Ubuntu 在 /etc/apt/sources.list 和 /etc/apt/sources.list.d/。国内镜像(阿里云、清华 TUNA、中科大、北交大、上海交大、网易)把同一批包放在离你更近的服务器上,换源后 yum clean all && yum makecache 或 apt update 重建索引。
vim:三种模式是三个互斥的输入状态
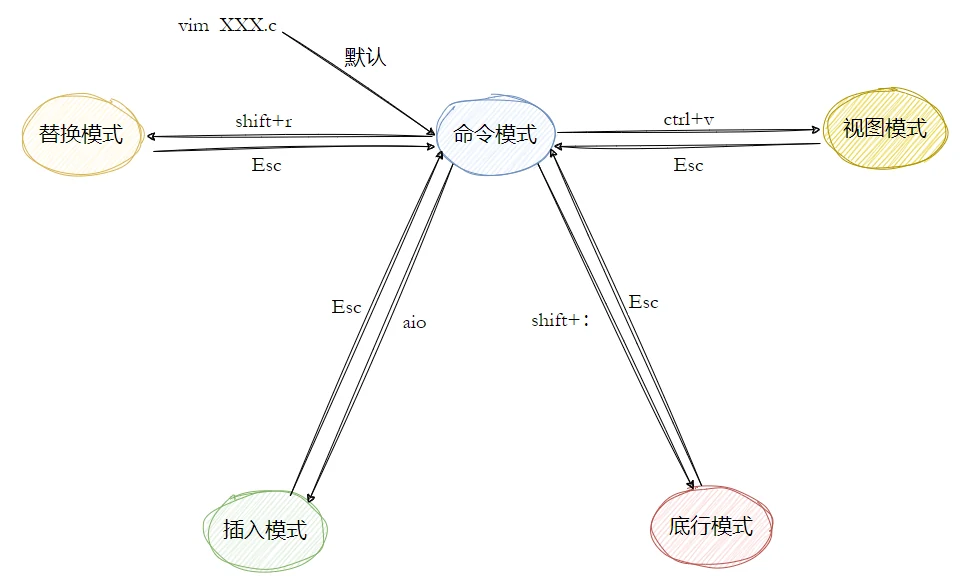
vi 和 vim 都是多模式编辑器,vim 兼容 vi 并增加了语法高亮、可视模式等特性。刚打开 vim test.c 时处于命令模式,此时字母是命令,不是文字;按 i、a、o 才进入插入模式,按 Esc 回到命令模式;在命令模式按 : 进入底行模式,按 Esc 回来。
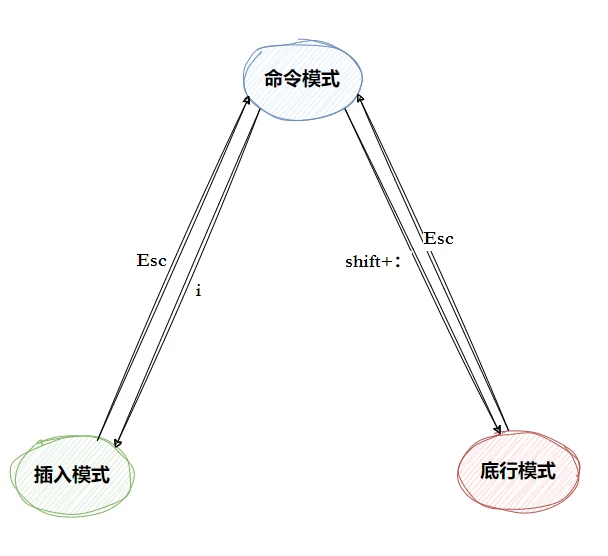
i 从光标当前位置开始插入,a 从光标后一个位置开始,o 在当前行下面新开一行并从行首插入。vim 内部其实有 12 种模式(6 种基本模式加 6 种附加模式),: 后输入 help vim-modes 可以看全;日常先掌握这三种。
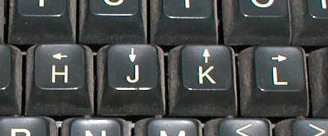
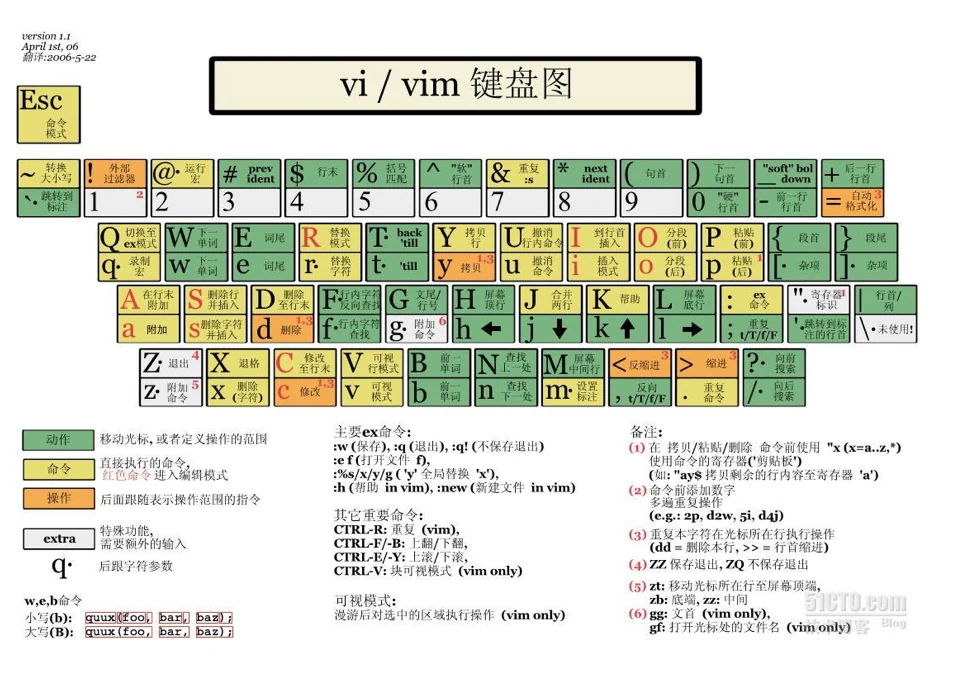
命令模式的移动键不用方向键,h、j、k、l 分别是左、下、上、右。
常用移动与编辑命令:
| 按键 | 作用 |
|---|---|
G | 到文件末尾 |
gg | 到文件开头 |
$ / ^ | 到当前行行尾 / 行首 |
w / e / b | 到下一个词首 / 词尾 / 上一个词首 |
5l、5| | 5l 向右移 5 个字符;5| 跳到当前行第 5 列 |
Ctrl+b / Ctrl+f | 向后 / 向前翻一页 |
Ctrl+u / Ctrl+d | 向后 / 向前翻半页 |
x / X | 删光标处一个字符 / 删光标前一个字符 |
6x / 20X | 删光标后(含自己)6 个 / 删光标前 20 个 |
dd / 6dd | 删当前行 / 从当前行往下删 6 行 |
yw / 6yw | 复制到词尾 / 复制 6 个词 |
yy / 6yy | 复制当前行 / 往下复制 6 行 |
p | 把复制缓冲区的内容粘贴到光标处 |
r / R | 替换一个字符 / 进入替换模式连续替换到 Esc |
u / Ctrl+r | 撤销 / 恢复撤销 |
cw / c3w | 改到词尾 / 改 3 个词 |
Ctrl+g | 显示当前行号 |
15G | 跳到第 15 行 |
所有与 y 有关的复制都要配 p 才算完成粘贴。d、y、c 这类操作符后面可以接移动命令,dw 删一个词、d$ 删到行尾,都是这个组合规则。课件把 5l 解释成“跳到第 5 个字符”,这是把相对移动当成了绝对定位:l 是向右移一格,前面加数字表示移几格,向右 5 格不等于第 5 列。要跳到某一列用 5|,竖线才是“到第 N 列”。
底行模式负责保存、退出、查找和替换:
| 命令 | 作用 |
|---|---|
:w | 保存 |
:wq | 保存并退出 |
:q | 退出,未保存时会被拒绝 |
:q! | 强制退出,不保存 |
:set nu | 显示行号 |
:15 | 跳到第 15 行 |
/关键字 | 向下查找,n 继续向下 |
?关键字 | 向上查找,n 继续向上 |
:%s/old/new/g | 全文替换 |
配置分两层:/etc/vimrc 对所有用户生效,~/.vimrc 只对当前用户生效。常用三行是 syntax on、set nu、set shiftwidth=4。插件可以补全功能,例如 TagList 在左侧列出函数名、WinManager 把文件浏览器和 TagList 合成一栏,解压后把 doc 放到 ~/.vim/doc、plugin 放到 ~/.vim/plugin,再在 .vimrc 里设置变量。不熟悉的按键可以用 vimtutor 跟着练一遍。
gcc:四个阶段各自产出一类文件
gcc 把 .c 变成可执行文件要经过四步,每一步都能单独停下来看产物:
| 阶段 | 做什么 | 命令 | 产物 |
|---|---|---|---|
| 预处理 | 展开头文件、替换宏、处理条件编译、删注释 | gcc -E hello.c -o hello.i | hello.i 预处理后的 C 文本 |
| 编译 | 检查语法,把 C 翻译成汇编 | gcc -S hello.i -o hello.s | hello.s 汇编文本 |
| 汇编 | 把汇编翻译成机器指令 | gcc -c hello.s -o hello.o | hello.o 可重定位目标文件 |
| 链接 | 合并目标文件和库,解析符号 | gcc hello.o -o hello | hello 可执行文件 |
#include <stdio.h>

int main(void)
{
    printf("hello gcc\n");
    return 0;
}
gcc -E hello.c -o hello.i
gcc -S hello.i -o hello.s
gcc -c hello.s -o hello.o
gcc hello.o -o hello
./hello预处理只做文本替换,不做语法检查;编译阶段才报语法错误;汇编阶段把助记符变成目标文件里的机器码;链接阶段把 printf 这类外部符号从库里找出来。gcc hello.c -o hello 是把四步一次跑完的简写。
课件写“-E 不生成文件,需要重定向到输出文件”。更准确地说:不写 -o 时预处理结果打到标准输出,写了 -o 就直接落盘,上面的例子属于后者。
链接分静态和动态两种。静态链接在生成可执行文件时把库代码复制进去,产物大,但运行时不依赖库文件,后缀是 .a;动态链接只记录“需要哪个库”,运行时由动态加载器把 .so 映射进来,多个程序可以共享同一份库代码。gcc 默认动态链接,-static 强制静态链接。Windows 下对应 .lib 和 .dll。ldd hello 打印依赖的共享库,file hello 能看到是否动态链接、是否带调试信息。
ldd hello
file hello
gcc -static hello.c -o hello_static
printf 的实现就在 libc.so.6 里,编译时 stdio.h 只提供声明,链接器到默认库路径找实现。静态库需要单独安装,CentOS 上是 yum install glibc-static libstdc++-static -y。
常用选项:
| 选项 | 作用 |
|---|---|
-E | 只预处理 |
-S | 编译到汇编,不汇编不链接 |
-c | 编译到目标文件 |
-o file | 指定输出文件名 |
-g | 生成调试信息 |
-O0~-O3 | 优化级别,数字越大优化越强 |
-Wall | 打开常用警告 |
-w | 关闭所有警告 |
-static | 静态链接 |
-shared | 生成共享库 |
-I dir | 增加头文件搜索路径 |
-L dir | 增加库搜索路径 |
-l name | 链接名为 libname 的库 |
课件写“-O1 为缺省值”,这一句不对。GCC 不写优化选项时等同于 -O0,也就是不优化;-O1 是打开一组基础优化,不是默认值。调试时通常显式写 -O0 -g,避免优化把变量和语句重排。
课件还把 -shared 解释成“尽量使用动态库”。-shared 的语义是产出一个共享对象(.so),通常还要配 -fPIC 生成位置无关代码;默认链接本来就用动态库,不需要 -shared 去“尽量使用”。
make:目标、依赖、配方三行
一个工程有很多 .c 文件,手动敲每条 gcc 命令既重复又容易漏。make 读取 Makefile,按“目标 : 依赖”的规则决定先编译谁、后编译谁,只重做那些依赖比目标新的部分。
myproc: myproc.c
	gcc -o myproc myproc.c

.PHONY: clean
clean:
rm -f myproc第一行是依赖关系:myproc 依赖 myproc.c;第二行是配方,开头必须是一个 Tab,用空格会得到 missing separator。make 不带参数时找当前目录下的 Makefile 或 makefile,把第一个目标当作最终目标。目标不存在,或者任一依赖的 mtime 比目标新,就执行配方;依赖本身又不存在时,先在文件里找生成这个依赖的规则,一层层往下推。
.PHONY: clean 把 clean 声明成伪目标,make 不再拿它跟同名文件比时间戳,每次都执行。伪目标的判定依据是“它被写进了 .PHONY 的依赖列表”,写成一行没有依赖的 .PHONY: 不声明任何东西。课件进度条的 Makefile 正好写成了空的 .PHONY:,那样 clean 仍是普通目标,目录里只要有个名叫 clean 的文件,make clean 就会回答 'clean' is up to date.。
课件还说“对于所定义命令的错误,make 根本不理”。实际相反:配方里的命令返回非零状态,make 立即停止并打印 Error 1;只有命令前加 - 或整体加 make -i 才会忽略。make 不理的是“命令输出里的警告”,不是命令的退出状态。
变量和模式规则可以把重复收掉:
BIN = myproc
CC = gcc
SRC = $(wildcard *.c)
OBJ = $(SRC:.c=.o)
CFLAGS = -g -Wall -c
LDFLAGS = -o

$(BIN): $(OBJ)
	$(CC) $(LDFLAGS) $@ $^

%.o: %.c
	$(CC) $(CFLAGS) $<

.PHONY: clean
clean:
	rm -f $(OBJ) $(BIN)
$(wildcard *.c) 取当前目录所有 .c,$(SRC:.c=.o) 把列表里的后缀逐个换成 .o。自动变量 $@ 是目标名,$^ 是所有依赖,$< 是第一个依赖。配方前的 @ 表示不回显这条命令。
gdb:先让程序带着调试信息出生
gcc 默认生成的程序没有调试信息,file 的输出里不会出现 with debug_info。课件说“不加 -g 程序无法被编译”,这句要改成“程序照样能编译,只是 gdb 拿不到源码行号、变量名和类型”。没有 -g 时仍能反汇编调试,但看不到源码级信息。
#include <stdio.h>

int Sum(int s, int e)
{
    int result = 0;
    for (int i = s; i <= e; i++)
        result += i;
    return result;
}

int main(void)
{
    int start = 1;
    int end = 100;
    printf("I will begin\n");
    int n = Sum(start, end);
    printf("[%d-%d]=%d\n", start, end, n);
    return 0;
}
gcc -g -O0 mycmd.c -o mycmd
gdb mycmd进入 gdb 后,quit 或 Ctrl+D 退出。
| 命令 | 作用 |
|---|---|
list / l | 从上次位置列出 10 行源码;l 10、l main、l mycmd.c:1 可指定位置 |
run / r | 从头连续执行 |
next / n | 单步,遇函数调用不进去 |
step / s | 单步,进入函数内部 |
break 10 / b main | 在行号或函数开头设断点 |
info break | 查看断点列表 |
finish | 执行到当前函数返回并停下 |
print start+end / p x | 打印表达式或变量 |
set var i=10 | 修改变量的值 |
continue / c | 从当前位置继续运行 |
delete / d 2 | 删除全部断点 / 删除 2 号断点 |
disable breakpoints | 禁用所有断点 |
enable breakpoints | 启用所有断点 |
display x / undisplay 1 | 每次停下都显示 x / 取消 1 号跟踪 |
until 20 | 运行到第 20 行 |
backtrace / bt | 查看调用栈及参数 |
info locals | 查看当前栈帧的局部变量 |
watch result 会在变量被改写时停下,gdb 会打印旧值和新值。条件断点有两种写法,语法不同:
(gdb) b 9 if i == 30      # 新建断点时就带条件
(gdb) condition 2 i==30   # 给 2 号已有断点追加条件,这里没有 if
cgdb 在 gdb 外面套一层源码窗口,Esc 进代码屏,i 回 gdb 屏。
git:工作区、暂存区、本地仓库
版本控制器记录每次改动,让任何一次提交都能找回来,也方便多人合并。Git 是分布式的,每个人本地都有一份完整历史。安装后在 GitHub 建仓库,复制仓库地址,git clone 到本地。
首次提交前要配身份,否则 Git 会用“登录名@主机名”拼一个默认地址,提交记录里的作者就不是你:
git config --global user.name "Your Name"
git config --global user.email you@example.com
Git 把文件分成三个位置:工作区是正在编辑的文件;暂存区(index)是下一次提交要包含的快照;本地仓库是已经提交的历史。git add 把工作区的改动放进暂存区,git commit 把暂存区写成一个提交,git push 把本地提交送到远端。
git status
git diff
git add main.c
git add .
git commit -m "add progress bar"
git push
git log --oneline
git pull
git add . 把当前目录下的改动全部暂存,. 表示当前目录,不是“提交”的参数。git commit -m 的说明要写清这次改了什么,git log 才能看懂。.gitignore 列出不该进仓库的文件(编译产物、编辑器临时文件),课件写成 .ignore,正确文件名是 .gitignore。git push 首次会要求输入用户名和密码,配置 SSH key 或凭据助手之后可以免密。
回车、行缓冲与进度条
打字机的字车走到行尾要先把打印头推回行首(carriage return),再转动滚筒换到下一行(line feed)。终端保留了这两个动作:\r 把光标移到当前行行首,\n 换到下一行。只写 \r 不写 \n,下一次输出会覆盖同一行。
#include <stdio.h>
#include <unistd.h>

int main(void)
{
    int i = 10;
    while (i >= 0) {
        printf("%-2d\r", i);
        fflush(stdout);
        i--;
        sleep(1);
    }
    printf("\n");
    return 0;
}
printf 写的是标准库的用户态缓冲区,不调用 fflush 时内容可能停在缓冲区里,屏幕上什么都看不到。标准输出连着终端时是行缓冲,遇到 \n 就刷;重定向到文件时变成全缓冲,要等缓冲区满或进程退出才刷。倒计时和进度条每次都用 \r 回到行首,所以必须手动 fflush(stdout)。
#include <stdio.h>
#include <string.h>
#include <unistd.h>

#define NUM 101
#define STYLE '='

static void show_progress(double total, double current)
{
    char buffer[NUM];
    memset(buffer, 0, sizeof(buffer));

    const char *label = "|/-\\";
    int len = strlen(label);
    static int cnt = 0;

    int filled = (int)(current * 100 / total);
    if (filled > NUM - 1)
        filled = NUM - 1;
    for (int i = 0; i < filled; i++)
        buffer[i] = STYLE;

    double rate = total > 0 ? current / total : 0;
    cnt %= len;
    printf("[%-100s][%5.1f%%][%c]\r", buffer, rate * 100, label[cnt]);
    fflush(stdout);
    cnt++;
}

int main(void)
{
    double total = 1024.0;
    double current = 0.0;
    double speed = 16.0;

    while (current < total) {
        show_progress(total, current);
        usleep(30000);
        current += speed;
        if (current > total)
            current = total;
    }
    show_progress(total, total);
    printf("\ndownload %.2f MB done\n", total);
    return 0;
}
BIN = progress
SRC = progress.c
$(BIN): $(SRC)
gcc -g -Wall -o $@ $^
.PHONY: clean
clean:
rm -f $(BIN)[%-100s] 里的负号表示左对齐,宽度固定 100,所以每次覆盖时整行宽度不变,不会留下上一次的残影。usleep 的参数是微秒,30 毫秒一步,1024 MB 按 16 MB 一步走完大约两秒。
还没有评论 — 第一条由你来留。