一个进程里可以有多条执行路线,这是线程最朴素的定义。四条对照:单线程进程只有一个执行流,单进程多线程有多条执行流处在同一块地址空间里,多个单线程进程是几块互不相干的地址空间,多个多线程进程则是几组各管各的地址空间。
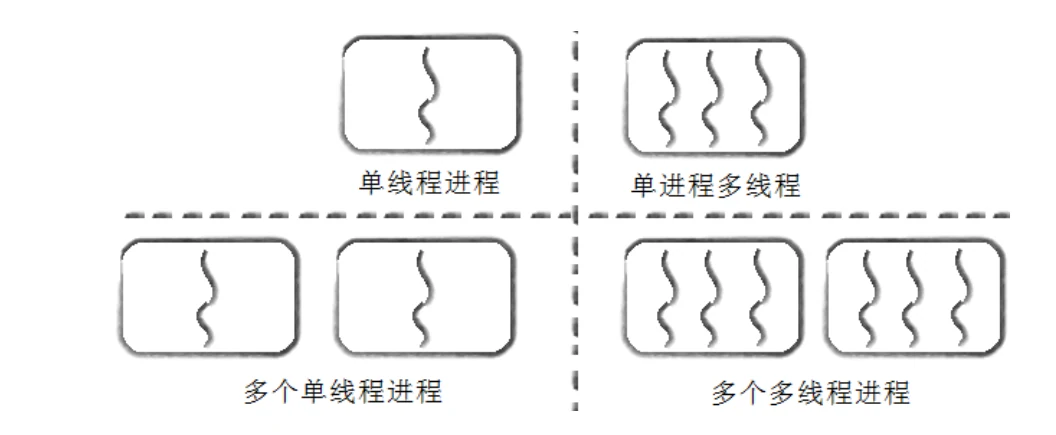
差别全在外框。线程在进程内部运行,本质是在同一块进程地址空间内运行。要理解"共享地址空间"为什么能让线程之间传递数据、又为什么会互相破坏,得先看地址空间本身是怎么搭起来的。
分页:地址空间可以被切成私有的和共享的
如果不用虚拟内存,每个程序在物理内存里必须连续存放。程序的代码和数据长度各不相同,物理内存就被切成大大小小不等的块;程序退出后回收,留下的是零散碎片。
解决办法是把物理内存按固定长度切成页框(page frame),把虚拟地址空间按同样大小切成页(page),再用页表把连续的虚拟页映射到不连续的物理页框。页框是存储区域,页是数据块,它可能在任何页框里,也可能在磁盘上。
内核要为每个物理页维护一个 struct page:
struct page {
    unsigned long flags;    /* PG_locked、PG_uptodate 等状态位 */
    int _mapcount;          /* 有多少页表项指向这一页 */
    void *virtual;          /* 内核虚拟地址,高端内存为 NULL */
};
flags 一位一个状态,至少能表示 32 种;_mapcount 减到 -1 说明没人引用,可以重新分配;virtual 是内核侧映射地址,高端内存没有常驻映射时为 NULL。按每页 40 字节估算,4 GB 物理内存有 1048576 个页,描述结构约占 40 MB,代价可以接受。
页大小是权衡出来的:太大,页内剩余空间浪费;太小,页表变长、换页更频繁。历史上取值在 512 B 到 8 KB 之间,今天 x86-64 与 x86 的普通页都是 4 KB。课件说"64 位体系结构一般会支持 8 KB 的页",这条在 x86-64 上不成立——8 KB 是部分体系结构(例如某些 ARM、Alpha 配置)的选项,本机用 getconf PAGE_SIZE 得到的是 4096。
单级页表的问题在体量。32 位、4 KB 页,4 GB 空间需要 1048576 个页表项;每项 4 字节,一张表就是 4 MB,还要连续占 1024 个页框。这跟"让物理页离散"的初衷正好相反。
于是把页表本身也离散化:拆成 1024 张页表,每张 1024 项、自身一页 4 KB,再用一张页目录表指向这 1024 张页表。总数还是 4 MB,但一个只用 10 MB 空间的程序,向上取整到 4 MB 的倍数需要 3 张页表,实际只占 12 KB 页目录加 12 KB 页表。
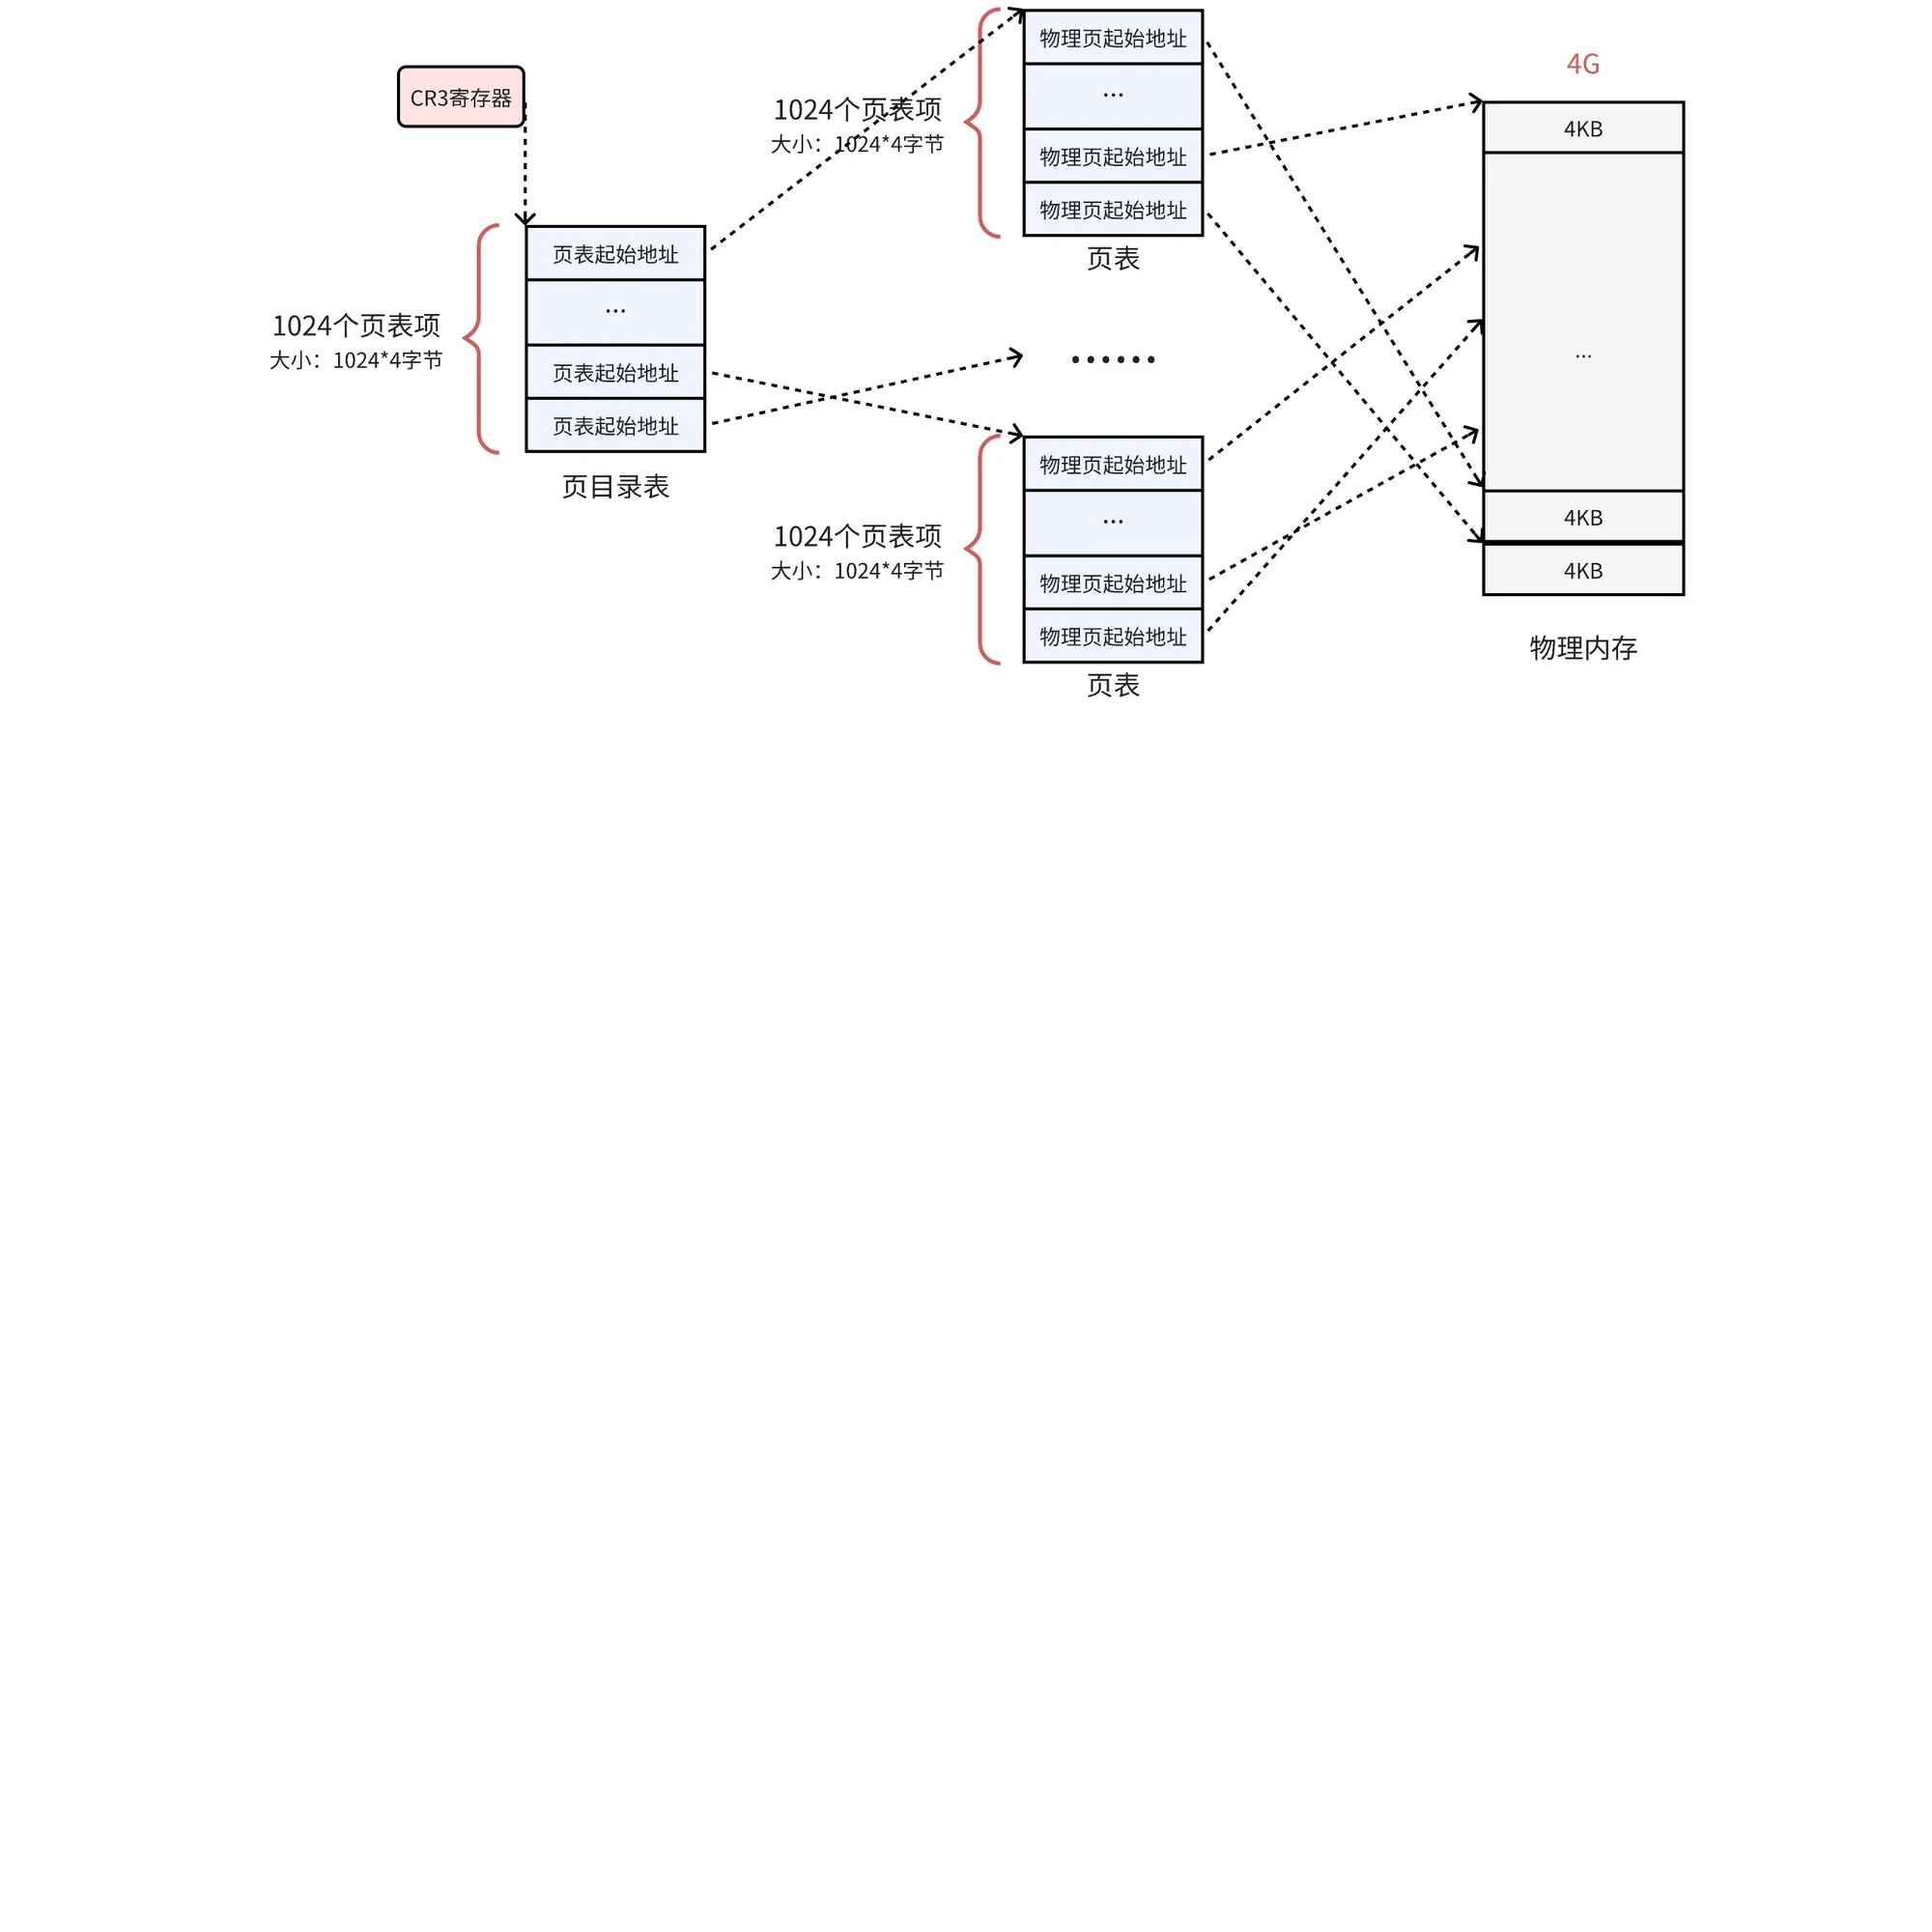
地址转换由 MMU 做:虚拟地址低 12 位是页内偏移,高 20 位拆成两个 10 位,先查页目录,再查页表,最后拼上偏移。物理页地址一定 4 KB 对齐,末 12 位全为 0,所以页表项只存高 20 位就够了。页表级数越多,查一次地址要走的步骤越多,TLB(Translation Lookaside Buffer)就是为这个加的缓存;命中直接出物理地址,未命中才走页表,并把结果回填。
三种缺页要分清:硬缺页(major)物理内存里没有这一页,要去磁盘读;软缺页(minor)页已经在内存里,只是当前进程的页表还没建立映射,常见于共享内存;无效缺页(invalid)地址本身非法,比如越界或空指针解引用,内核报 SIGSEGV 直接终止进程。区分缺页和越界靠两步检查:页号是否合法,地址是否落在当前进程的映射范围内。越界不一定立刻报错——只要还落在某个已映射区间里,写坏的是自己的数据,不是别人的。
回到线程。既然地址空间是"一串虚拟页加一张页表",划分资源就变成划分地址空间:栈区一段给主线程,共享区里再切出若干段给其他线程当栈,代码段和数据段谁都能看。内核侧的表现是多个 task_struct 指向同一个 mm_struct:
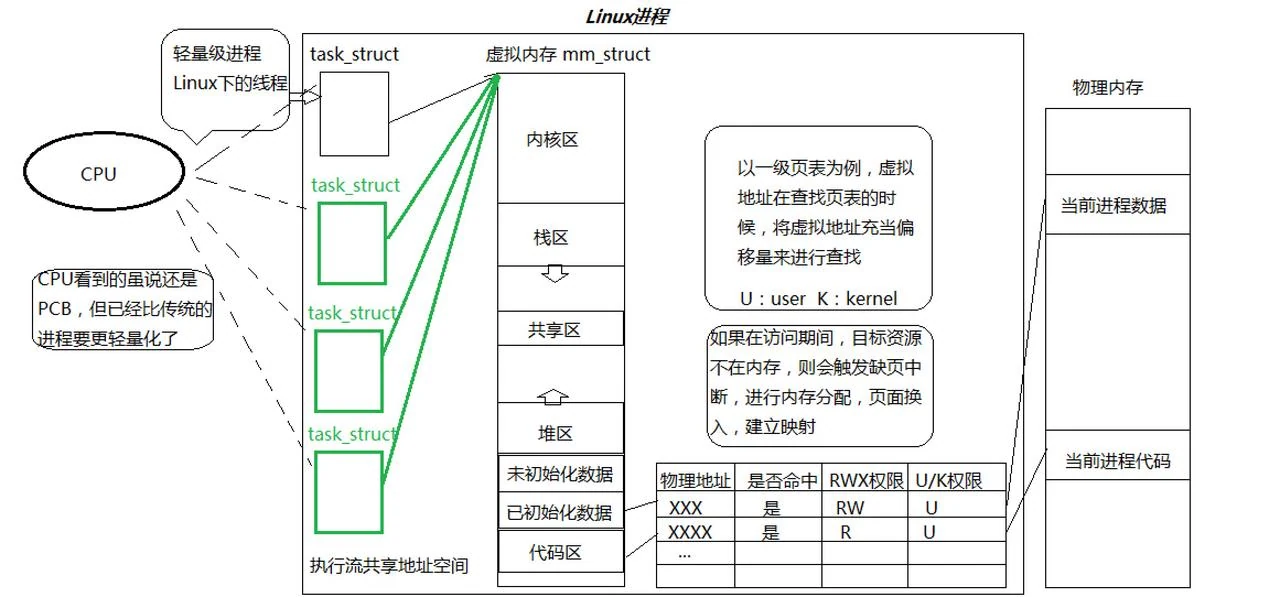
这就是 Linux 线程的实现方式:不为线程发明新结构,只让一批 task_struct 共用一个地址空间。线程的私有资源,就是那些没有共享的部分。
共享的和私有的
| 共享 | 私有 |
|---|---|
| 代码段、数据段、堆 | 线程 ID |
| 文件描述符表 | 一组寄存器(上下文) |
| 每种信号的处理方式 | 栈 |
| 当前工作目录 | errno |
| 用户 ID、组 ID | 信号屏蔽字 |
| 进程的资源和环境 | 调度优先级 |
两处容易记错。
信号的处理方式(SIG_IGN、SIG_DFL 还是自定义函数)是全进程共享的,任何线程调用 sigaction 都影响所有线程;但信号屏蔽字是每个线程一份,一个线程 sigprocmask 屏蔽了 SIGINT,别的线程照收不误。errno 也是线程私有,所以 printf 里拼 strerror(errno) 不会串味。
堆是共享的,所以一个线程 malloc 的指针可以直接给另一个线程 free。栈是私有的,把一个线程栈上的局部变量地址交给另一个线程用,对方拿到的是随时可能失效的指针。
线程出异常会带走整个进程。某个线程除零或踩空指针,内核发信号,默认动作终止的是进程,进程里所有线程一起退出。线程之间没有进程那样的地址空间隔离,一个线程写坏全局数据,别的线程立刻受影响。
pthread_create 与两个不相干的 ID
线程函数都在 pthread.h 里,名字以 pthread_ 开头,链接要加 -pthread(它会同时打开 -lpthread 和线程安全的编译选项)。
int pthread_create(pthread_t *thread, const pthread_attr_t *attr,
                   void *(*start_routine)(void *), void *arg);
thread 传出线程 ID,attr 为 NULL 表示默认属性,start_routine 是线程入口,arg 是传给它的唯一参数。成功返回 0,失败返回错误码。
pthreads 系列函数不设置 errno,错误码直接由返回值给出,所以判断失败要用返回值,别去读 errno:
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <pthread.h>
#include <unistd.h>

static void *worker(void *arg)
{
    const char *name = (const char *)arg;
    while (1) {
        printf("%s running\n", name);
        sleep(1);
    }
    return NULL;
}

int main(void)
{
    pthread_t tid;
    int ret = pthread_create(&tid, NULL, worker, "worker");

    if (ret != 0) {
        fprintf(stderr, "pthread_create: %s\n", strerror(ret));
        return 1;
    }

    while (1) {
        printf("main running\n");
        sleep(1);
    }
    return 0;
}
编译 gcc t.c -o t -pthread。跑起来能看到两行输出交替出现——两个执行流在同一个终端上抢着打印。
pthread_t 这个 ID 和内核的线程 ID 不是一回事:
ps -aL | head -1 && ps -aL | grep 't$'PID LWP TTY TIME CMD
2711838 2711838 pts/235 00:00:00 t
2711838 2711839 pts/235 00:00:00 tPID 相同、LWP 不同。LWP 是内核眼里的线程标识,也就是轻量级进程的 pid,syscall(SYS_gettid) 拿到的就是它。PID 相同说明它们属于同一个进程(内核里叫线程组)。
pthread_self() 返回的 pthread_t 则是另一套编号:它是 NPTL 线程库在进程地址空间里为线程控制块(TCB)分配的地址。地址只在进程内唯一,内核不认识它。所以同一个线程会有两个"ID",一个给内核调度,一个给线程库管理。
pthread_t pthread_self(void);退出、等待与分离
只结束某个线程而不结束进程,有三种方式:
- 线程函数
return,返回值就是退出状态; - 线程自己调用
pthread_exit(void *value_ptr); - 别的线程调用
pthread_cancel(pthread_t thread)取消它。
第一条对主线程不适用:从 main 返回等价于调用 exit,整个进程结束。
pthread_exit 的参数和 return 的值有一个共同约束:它们指向的内存必须是全局的或用 malloc 分配的,不能是线程函数栈上的局部变量。因为 join 的线程拿到这个指针时,目标线程的栈已经回收了。
void pthread_exit(void *value_ptr);   /* 不返回 */
int  pthread_cancel(pthread_t thread); /* 成功返回 0,失败返回错误码 */
不 join 也不 detach 的线程,退出之后资源不释放——TCB 和栈还占着,新的线程也不会复用那块地址。这就是线程版的资源泄漏。pthread_join 负责收:
int pthread_join(pthread_t thread, void **value_ptr);调用者挂起等待,直到 thread 终止。value_ptr 指向的单元里放什么,取决于目标线程怎么退出:
return的,放返回的那个指针;- 被
pthread_cancel取消的,放常量PTHREAD_CANCELED; - 自己调
pthread_exit的,放传给pthread_exit的参数; - 不关心退出状态,传
NULL。
#include <stdio.h>
#include <stdlib.h>
#include <pthread.h>
#include <unistd.h>

static void *by_return(void *arg)
{
    int *p = malloc(sizeof(int));
    (void)arg;
    if (p != NULL)
        *p = 1;
    return p;
}

static void *by_exit(void *arg)
{
    int *p = malloc(sizeof(int));
    (void)arg;
    if (p != NULL)
        *p = 2;
    pthread_exit(p);
    return NULL;
}

static void *by_cancel(void *arg)
{
    (void)arg;
    while (1) {
        printf("thread 3 running\n");
        sleep(1);
    }
    return NULL;
}

int main(void)
{
    pthread_t tid;
    void *ret = NULL;

    pthread_create(&tid, NULL, by_return, NULL);
    pthread_join(tid, &ret);
    printf("return: %d\n", *(int *)ret);
    free(ret);

    pthread_create(&tid, NULL, by_exit, NULL);
    pthread_join(tid, &ret);
    printf("exit: %d\n", *(int *)ret);
    free(ret);

    pthread_create(&tid, NULL, by_cancel, NULL);
    sleep(3);
    pthread_cancel(tid);
    pthread_join(tid, &ret);
    printf("cancel: %s\n", ret == PTHREAD_CANCELED ? "PTHREAD_CANCELED" : "other");

    return 0;
}
编译 gcc join.c -o join -pthread。取消点在 sleep 这类可取消的系统调用上,所以第三个线程能被及时打断。
不需要返回值时,join 是负担。pthread_detach 告诉系统"这个线程退出时自己释放资源":
int pthread_detach(pthread_t thread);可以由别的线程分离,也可以自己分离自己:pthread_detach(pthread_self())。joinable 与分离是互斥状态,一个线程不能既 joinable 又 detached;对已分离的线程调用 pthread_join 会失败(返回 EINVAL)。分离要赶在对方退出之前做,晚一步资源已经漏了。
线程栈是固定的,所以会被写满
线程栈和主线程栈的行为不一样。
主线程的栈就是 main 用的那块,随函数调用向下生长,上限由 ulimit -s 决定(常见 8 MB)。超出上限才报段错误,在这之前访问尚未映射的栈下方页面是被允许的,内核会给你补上。
子线程的栈在创建时一次定好,从 mmap 拿一块匿名内存,大小默认也是 8 MB,之后不能增长,用完就溢出。源码里就是那句 mmap(NULL, size, prot, MAP_PRIVATE | MAP_ANONYMOUS | MAP_STACK, -1, 0)。栈底通常还 mprotect 出一页保护页(guard page),越界写会立刻触发 SIGSEGV,而不是悄悄改坏别的映射。
要改大小,用线程属性:
#include <stdio.h>
#include <string.h>
#include <pthread.h>
#include <unistd.h>

static void *worker(void *arg)
{
    char big[1024 * 1024];      /* 1 MB 的局部数组,放进栈里 */
    big[0] = 'x';
    big[sizeof(big) - 1] = 'y';
    printf("%s: stack array ok\n", (const char *)arg);
    return NULL;
}

int main(void)
{
    pthread_t tid;
    pthread_attr_t attr;
    int ret;

    pthread_attr_init(&attr);
    pthread_attr_setstacksize(&attr, 32 * 1024);   /* 32 KB,故意不够 */
    ret = pthread_create(&tid, NULL, worker, "small");
    if (ret != 0) {
        fprintf(stderr, "create: %s\n", strerror(ret));
        pthread_attr_destroy(&attr);
        return 1;
    }
    pthread_join(tid, NULL);
    pthread_attr_destroy(&attr);

    pthread_attr_init(&attr);
    pthread_attr_setstacksize(&attr, 8 * 1024 * 1024);
    ret = pthread_create(&tid, NULL, worker, "normal");
    if (ret != 0) {
        fprintf(stderr, "create: %s\n", strerror(ret));
        pthread_attr_destroy(&attr);
        return 1;
    }
    pthread_join(tid, NULL);
    pthread_attr_destroy(&attr);
    return 0;
}
编译 gcc stack.c -o stack -pthread。第一次大概率在 pthread_create 时就失败(返回 EINVAL,栈太小,连 TCB 和 TLS 都放不下),也可能进去之后踩保护页。第二次正常。要记得 pthread_attr_destroy。
线程栈的位置也能算出来:
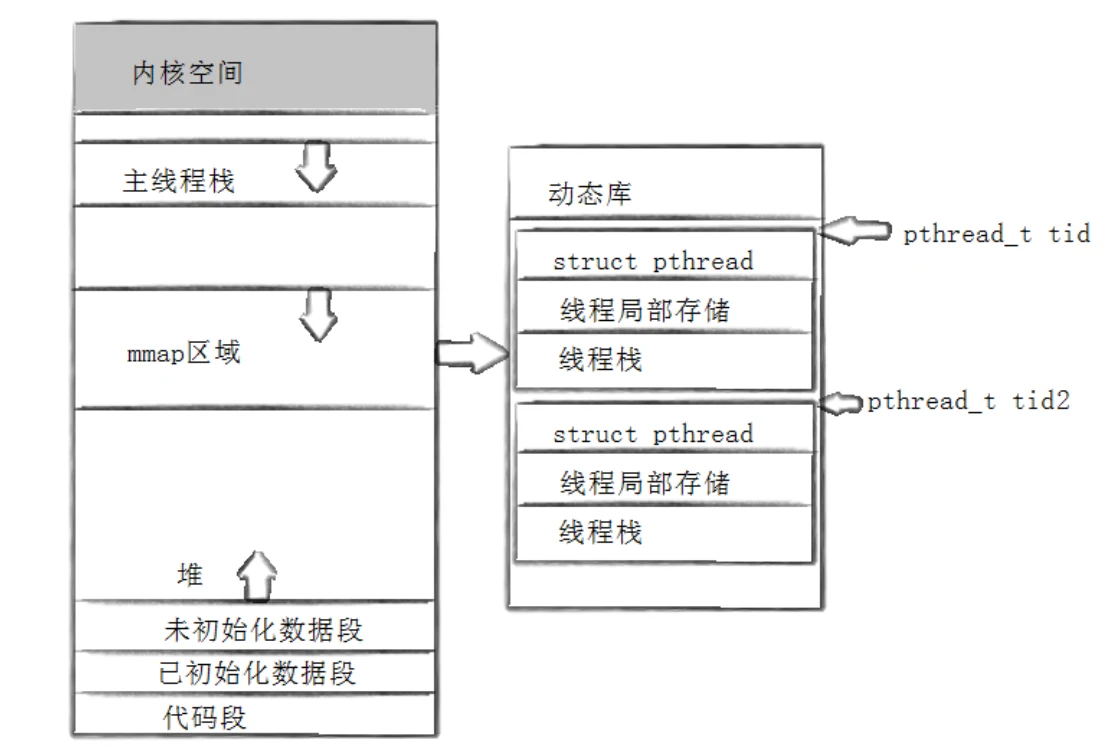
主线程栈在栈区,子线程栈在共享区(也就是 mmap 区域),因为 pthread 库本身就在共享区,它用 mmap 给线程分栈,自然落在同一片区域。
栈是私有的,但"私有"只是约定:同一进程的其他线程拿到地址仍然能读写,内核不做检查。所谓线程安全,靠的是约定和同步,不是硬隔离。
线程局部存储:每个线程一份
需要"每个线程各有一份"的变量,用线程局部存储(Thread Local Storage,TLS):
#include <stdio.h>
#include <pthread.h>
#include <unistd.h>

static __thread int counter = 0;

static void *worker(void *arg)
{
    int i;
    (void)arg;
    for (i = 0; i < 5; i++) {
        counter++;
        printf("thread %lu counter=%d\n", (unsigned long)pthread_self(), counter);
        usleep(100000);
    }
    return NULL;
}
编译 gcc tls.c -o tls -pthread。两个线程各自从头数到 5,互不干扰,说明 counter 每个线程一份,虽然源码里只定义了一次。
__thread 是 GCC 扩展,对应 C11 的 _Thread_local。它的实现方式是把变量放进每个线程的 TLS 块,地址由 TCB 里的指针加上偏移算出,访问速度和普通全局变量差不多。
需要动态分配、按 key 取值的场景,用 pthread 的接口:pthread_key_create 建一个键,pthread_setspecific 存指针,pthread_getspecific 取回来,销毁时可以用 pthread_key_create 提供的析构函数自动释放。这套接口现在多半被 __thread 取代。
线程的代价,以及 clone 那一层
用线程的理由写在实现里:创建比进程便宜,因为不用复制页表;切换比进程便宜,因为地址空间不变,不需要换页表,TLB 和硬件 cache 也不用整体失效;占资源少,能吃到多核。
代价也有几条:计算密集型线程数量超过核数时,多出来的线程只会增加调度和同步开销;线程之间缺乏保护,一个线程的错误会波及全进程;进程是访问控制的基本粒度,某个线程调用的系统调用会影响整个进程;多线程的调试难度明显高于单线程。
内核层面,线程是用 clone 造出来的,参数里带一组 CLONE_* 标志:
#define _GNU_SOURCE
#include <sched.h>
#include <stdio.h>
#include <stdlib.h>
#include <sys/wait.h>
#include <unistd.h>

#define STACK_SIZE (1024 * 1024)

static int child_func(void *arg)
{
    (void)arg;
    printf("child: PID=%d\n", getpid());
    return 0;
}

int main(void)
{
    char *stack = malloc(STACK_SIZE);
    pid_t pid;

    if (stack == NULL) {
        perror("malloc");
        return 1;
    }

    pid = clone(child_func, stack + STACK_SIZE, CLONE_VM | SIGCHLD, NULL);
    if (pid == -1) {
        perror("clone");
        free(stack);
        return 1;
    }

    printf("parent: PID=%d, child=%d\n", getpid(), (int)pid);
    waitpid(pid, NULL, 0);
    free(stack);
    return 0;
}
编成 gcc clone.c -o clone。这里只带 CLONE_VM,父子共享地址空间,其余资源仍然分开,所以子进程有自己的文件描述符表和信号处理方式——介于进程和线程之间。pthread 库用的标志集更全:CLONE_VM | CLONE_FS | CLONE_FILES | CLONE_SIGHAND | CLONE_THREAD | CLONE_SETTLS | CLONE_PARENT_SETTID | CLONE_CHILD_CLEARTID,一条一条正好对应上一张表里"哪些共享"的每一行。
CLONE_VM 共享地址空间,CLONE_FS 共享文件系统信息(含当前工作目录),CLONE_FILES 共享 fd 表,CLONE_SIGHAND 共享信号处理函数表,CLONE_THREAD 让新任务进入同一个线程组(于是 getpid 相同),CLONE_SETTLS 指定新线程的 TLS 块,后两个则让内核把 tid 写进用户指定的位置、在退出时清零,pthread_join 就靠这个感知线程结束。
所以"线程比进程轻"不是抽象的性能形容词,它就是少复制几样东西:页表、目录项、fd 表、信号处理表。少复制的每一样,都变成了线程之间必须共享的资源。
还没有评论 — 第一条由你来留。