int ticket = 100; 写在文件作用域,四个线程同时读写。这样的变量叫共享资源(shared resource)。共享资源不会自动变成临界资源(critical resource)——一张只读的配置表被多少线程读都没事;临界资源说的是"访问方式必须互斥"的那部分共享数据。临界区(critical section)是每个线程内部访问它的那段代码,互斥(mutual exclusion)说的是任何时刻只有一个执行流在临界区里,原子性(atomicity)则指一次操作不会被调度打断,只有完成和未完成两种状态。
四个线程卖一百张票,程序先不加锁:
#include <stdio.h>
#include <unistd.h>
#include <pthread.h>

int ticket = 100;

void *route(void *arg)
{
    const char *id = (const char *)arg;
    while (1) {
        if (ticket > 0) {
            usleep(1000);
            printf("%s sells ticket:%d\n", id, ticket);
            ticket--;
        } else {
            break;
        }
    }
    return NULL;
}

int main(void)
{
    pthread_t t1, t2, t3, t4;

    pthread_create(&t1, NULL, route, (void *)"thread 1");
    pthread_create(&t2, NULL, route, (void *)"thread 2");
    pthread_create(&t3, NULL, route, (void *)"thread 3");
    pthread_create(&t4, NULL, route, (void *)"thread 4");

    pthread_join(t1, NULL);
    pthread_join(t2, NULL);
    pthread_join(t3, NULL);
    pthread_join(t4, NULL);
    return 0;
}
跑完在终端里留下这样的尾巴:
thread 4 sells ticket:1
thread 2 sells ticket:0
thread 1 sells ticket:-1
thread 3 sells ticket:-2
代码里明明有 if (ticket > 0),还是卖出了负数。原因有三条,且互相叠加:
if判断为真之后,线程可能就在这一行被切走,别的线程也判断为真;usleep(1000)模拟业务耗时,这一毫秒里其他线程可以长驱直入;ticket--本身不是原子操作。
第三条可以拆开看。把程序编出来反汇编一份:
objdump -d a.out > test.objdumpticket-- 对应的三条指令是:
mov    0x2004e3(%rip),%eax      # load:把 ticket 读进寄存器
sub    $0x1,%eax                # update:寄存器里减一
mov    %eax,0x2004da(%rip)      # store:写回 ticket 的内存地址
读、改、写。单核上线程可能在 mov 之后被切走,多核上两颗核可以真正同时执行这三条。两种情况结果一样:写回的值基于过期的旧值,两个线程都读到 100,都算成 99,都写回 99。售票程序的问题不是 if 写错了,而是"检查"和"修改"之间没有任何东西拦着别的执行流。
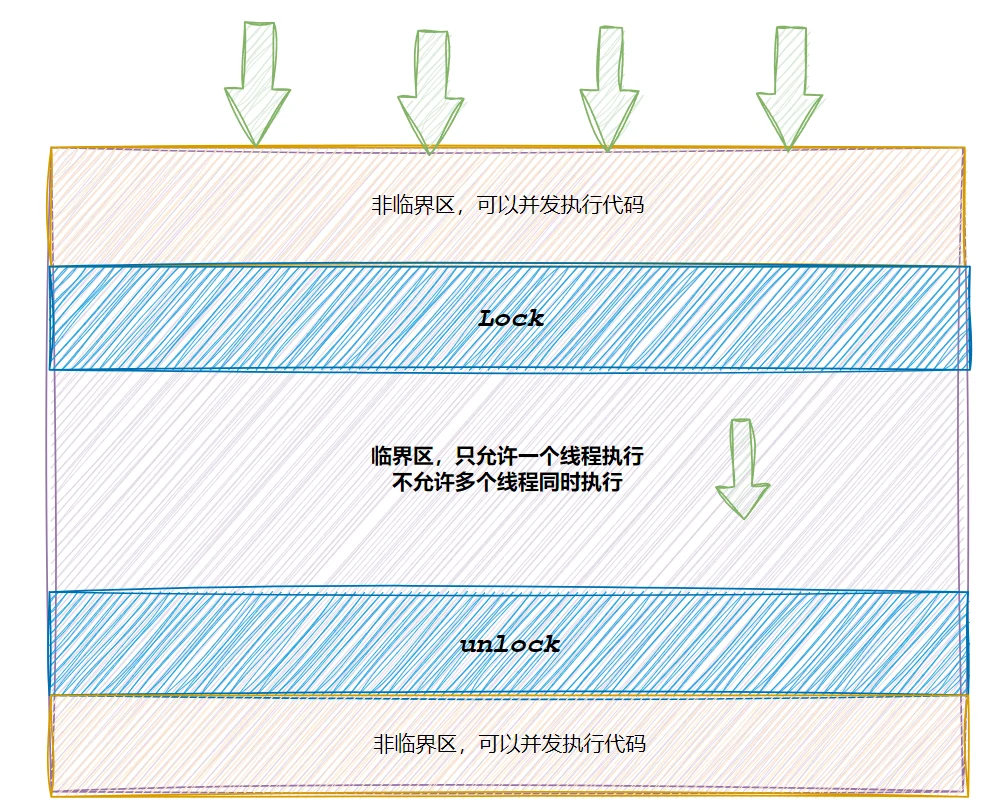
要让临界区正确工作,需要满足三点:进入临界区后不允许其他线程再进;同时申请时只放一个进去;不在临界区的线程不能阻止别人进入。满足这三点的东西就是一把锁,Linux 给的那把叫互斥量(mutex)。
互斥量:四个接口、一条交换指令、一层封装
| 接口 | 作用 | 返回值 |
|---|---|---|
pthread_mutex_init | 动态初始化,attr 传 NULL 即默认属性 | 0 成功,否则错误号 |
pthread_mutex_destroy | 销毁 | 0 成功,否则错误号 |
pthread_mutex_lock | 加锁,已被占用时阻塞 | 0 成功,否则错误号 |
pthread_mutex_unlock | 解锁 | 0 成功,否则错误号 |
初始化有两条路。静态分配用宏:
pthread_mutex_t mutex = PTHREAD_MUTEX_INITIALIZER;这只适用于静态分配的、用默认属性的互斥量。动态分配走 pthread_mutex_init(&mutex, NULL),要在运行时改属性时才需要填 attr。两者对应的销毁规则不同:宏初始化出来的不需要 pthread_mutex_destroy。
销毁有三条约束,课件写得很清楚,也是实际会踩到的:不要销毁一个正在加锁的互斥量(会返回 EBUSY);销毁以后不能再有线程尝试加锁;静态初始化的不用销毁。锁是共享的,销毁时机由最后一个使用者决定,不能由某个线程随手释放。
pthread_mutex_lock 的行为分两种情况:锁空闲时锁上并返回 0;已经被别人持有、或同时有人竞争但没抢到时,调用线程挂起,等锁释放再被唤醒。这些函数成功返回 0,失败返回错误号,不是 -1 也不是 errno。所以不能用 perror 检查它们的返回值;课件里那种"先存进 int n,再写一句 (void)n"的写法,等于把这个错误码直接丢掉。
把售票程序补上锁:
#include <stdio.h>
#include <pthread.h>
#include <unistd.h>

int ticket = 100;
pthread_mutex_t mutex = PTHREAD_MUTEX_INITIALIZER;

void *route(void *arg)
{
    const char *id = (const char *)arg;
    while (1) {
        pthread_mutex_lock(&mutex);
        if (ticket > 0) {
            usleep(1000);
            printf("%s sells ticket:%d\n", id, ticket);
            ticket--;
            pthread_mutex_unlock(&mutex);
        } else {
            pthread_mutex_unlock(&mutex);
            break;
        }
    }
    return NULL;
}

int main(void)
{
    pthread_t t1, t2, t3, t4;

    pthread_create(&t1, NULL, route, (void *)"thread 1");
    pthread_create(&t2, NULL, route, (void *)"thread 2");
    pthread_create(&t3, NULL, route, (void *)"thread 3");
    pthread_create(&t4, NULL, route, (void *)"thread 4");

    pthread_join(t1, NULL);
    pthread_join(t2, NULL);
    pthread_join(t3, NULL);
    pthread_join(t4, NULL);
    pthread_mutex_destroy(&mutex);
    return 0;
}
注意 else 分支里的那次解锁:退出循环前必须把锁还回去,漏掉这一句,其他三个线程就永远停在 pthread_mutex_lock 上。手写锁的 bug 大多长在这种提前退出的分支上。
课件的修复版示例在 .c 里写了 return nullptr;。这是 C++ 的关键字,C 编译器不认(C23 才有 nullptr),按 C 编译会报 nullptr 未声明,应当写 NULL。
这段代码还有一处值得改:usleep(1000) 被关在临界区里,四个线程等于排队睡 1 毫秒,卖 100 张票要 100 毫秒,而睡眠期间锁一直被占着。临界区里不该有 sleep、文件 IO、网络请求这类慢操作,锁的粒度只该包住真正读写共享数据的那几行。
锁的原子性来自一条交换指令
++i 和 i++ 都不是原子的,要实现锁,得先有一个不可分割的动作。多数体系结构提供了 swap 或 exchange 指令,它把寄存器和内存单元的内容一次交换完成。只有一条指令,就保证了原子性:即便在多处理器上,访问内存的总线周期也有先后,一个处理器的交换执行时,另一个只能等总线周期。
课件给出的 lock/unlock 伪代码把这件事摊开:
lock:
    movb  $0, %al
    xchgb %al, mutex
    if (al 寄存器的内容 > 0) {
        return 0;
    } else
        挂起等待;
    goto lock;

unlock:
    movb  $1, mutex
    唤醒等待 Mutex 的线程;
    return 0;
mutex 的取值约定是 1 表示空闲、0 表示被占。加锁时先把 al 清零,再用 xchgb 与 mutex 交换:交换后 al 拿到的是别人的旧值。旧值是 1,说明刚才没人占,自己拿走了,返回成功;旧值是 0,说明锁已在别人手里,自己虽然写了个 0 进去但没拿到,只能挂起,醒来后 goto lock 重来。解锁就是往回写 1,并唤醒等待队列。
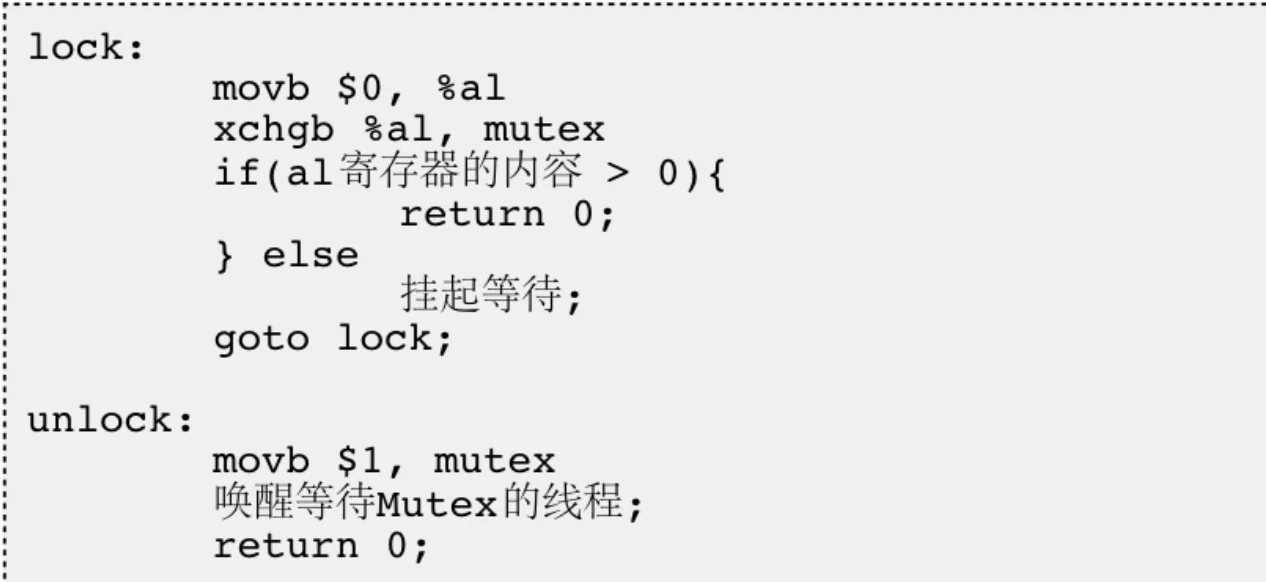
真实的 glibc 不是这么自旋的,它用 futex(fast userspace mutex):无竞争时一条 lock cmpxchg 在用户态完成,有竞争才进内核排队睡眠。上面这段伪代码描述的是语义,不是实现。
把锁按 RAII(Resource Acquisition Is Initialization)封一层,能消掉"漏解锁"这类错误:
#pragma once
#include <pthread.h>

namespace LockModule
{
class Mutex
{
public:
    Mutex(const Mutex &) = delete;
    const Mutex &operator=(const Mutex &) = delete;

    Mutex() { pthread_mutex_init(&_mutex, nullptr); }
    ~Mutex() { pthread_mutex_destroy(&_mutex); }

    void Lock() { pthread_mutex_lock(&_mutex); }
    void Unlock() { pthread_mutex_unlock(&_mutex); }
    pthread_mutex_t *GetMutexOriginal() { return &_mutex; }

private:
    pthread_mutex_t _mutex;
};

class LockGuard
{
public:
    explicit LockGuard(Mutex &mutex) : _mutex(mutex) { _mutex.Lock(); }
    ~LockGuard() { _mutex.Unlock(); }

private:
    Mutex &_mutex;
};
}
LockGuard 在构造时加锁、析构时解锁,任何一条 return、break 或异常路径都会自动还锁。C++11 的 std::mutex 配 std::lock_guard 是同一种东西,这里封装一份是为了后面几个类统一用。
条件变量:等之前先要把锁丢掉
互斥只保证不冲突,不保证顺序。一个线程拿着锁去检查队列,发现是空的,它除了退出去再进来什么也做不了,这就是忙等(busy waiting)。条件变量(condition variable)解决的是这种情况:让线程在某件事发生之前挂起,别人做完那件事再通知它。
课件给的定义值得抄下来:同步是在保证数据安全的前提下,让线程按某种特定顺序访问临界资源,以避免饥饿;竞态条件(race condition)是因为时序问题导致程序异常。这两句分别回答了"谁先谁后"和"为什么同样的代码有时错有时对"。
接口成对,比互斥量多一个唤醒:
| 接口 | 作用 |
|---|---|
pthread_cond_init(&cond, NULL) | 动态初始化,也可用 PTHREAD_COND_INITIALIZER 静态初始化 |
pthread_cond_destroy(&cond) | 销毁,同样不能在有人等待时调用 |
pthread_cond_wait(&cond, &mutex) | 挂起直到被唤醒,调用期间自动释放并重新获取 mutex |
pthread_cond_signal(&cond) | 唤醒至少一个等待者 |
pthread_cond_broadcast(&cond) | 唤醒全部等待者 |
最小例子:两个线程在条件变量上循环等待,主线程每秒广播一次。
#include <iostream>
#include <string>
#include <unistd.h>
#include <pthread.h>

pthread_cond_t cond = PTHREAD_COND_INITIALIZER;
pthread_mutex_t mutex = PTHREAD_MUTEX_INITIALIZER;

void *active(void *arg)
{
    std::string name = static_cast<const char *>(arg);
    while (true) {
        pthread_mutex_lock(&mutex);
        pthread_cond_wait(&cond, &mutex);
        std::cout << name << " 活动..." << std::endl;
        pthread_mutex_unlock(&mutex);
    }
    return nullptr;
}

int main(void)
{
    pthread_t t1, t2;
    pthread_create(&t1, nullptr, active, (void *)"thread-1");
    pthread_create(&t2, nullptr, active, (void *)"thread-2");

    sleep(3);
    while (true) {
        pthread_cond_broadcast(&cond);
        sleep(1);
    }
    pthread_join(t1, nullptr);
    pthread_join(t2, nullptr);
    return 0;
}
输出是 thread-1 活动...、thread-2 活动... 交替出现的序列——注意两个线程被唤醒后还要重新抢 mutex,谁先抢到谁先打印,顺序不固定。把 broadcast 换成 signal,一次只有一个线程能出来,另一个继续保持等待。
pthread_cond_wait 内部做三件事,顺序很关键:把调用线程挂到 cond 的等待队列上;原子地释放传入的 mutex;被唤醒后重新竞争 mutex,抢到才返回。
为什么要传锁?因为解锁和等待如果不是一个原子动作,中间就有一个窗口:
/* 错误设计:解锁之后、等待之前,信号可能已经发出 */
pthread_mutex_lock(&mutex);
while (condition_is_false) {
    pthread_mutex_unlock(&mutex);
    pthread_cond_wait(&cond, &mutex);
    pthread_mutex_lock(&mutex);
}
pthread_mutex_unlock(&mutex);
假设生产者恰好在这条缝里拿到锁、改了条件、发了 signal。信号只对此刻正在等待的线程有效,等待者还没挂进去,这个信号就丢了,消费者随后调用 pthread_cond_wait,等一个不会再来的通知,永久阻塞。这也是课件强调"解锁和等待必须是一个原子操作"的原因。
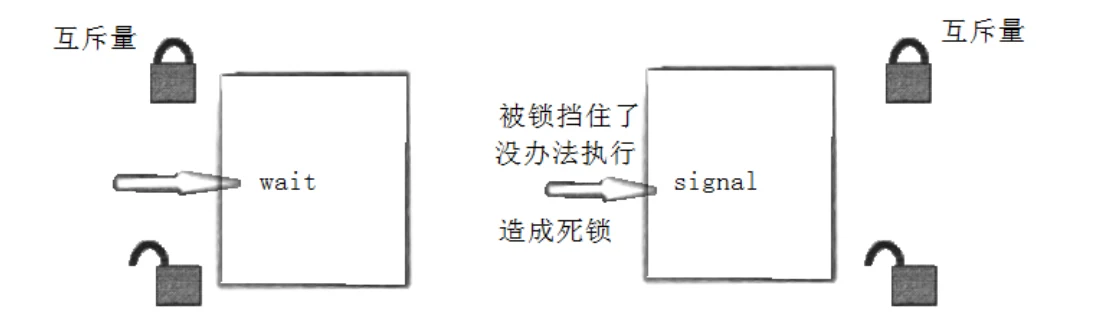
课件在这一节还有一句表达不准确的话:"进入该函数后,会去看条件量等于 0 不?等于,就把互斥量变成 1……"。条件变量里没有"条件量",pthread_cond_wait 也不读任何共享条件——条件是否成立要由调用者在 while 里自己判断,wait 只负责挂起、交锁、回来时再拿锁。这一条对写代码很实用:别指望 wait 帮你过滤条件。
等待必须写成 while 而不是 if。理由有三层:POSIX 允许虚假唤醒(spurious wakeup),线程可能没收到信号却返回;broadcast 唤醒多个线程后它们排队抢锁,每个都要重新判断;signal 唤醒的那个线程醒来时,条件可能已经被另一个线程改回假。所以判断必须回到循环里:
while (queue_empty())
    pthread_cond_wait(&cond, &mutex);
课件在阻塞队列里用的正是 while,只是规范段落里把"用 if 行不行"这个问号留在了注释里。
一个队列,两个条件变量
生产者消费者模型用一个缓冲区把生产者和消费者解耦:生产者把数据放进阻塞队列就走,消费者从队列里取,双方不直接通信。它的三个好处是解耦、支持并发、支持忙闲不均——队列相当于一个水库,削掉上游的突发流量。
课件用"321"记这个结构:三种关系、两个角色、一个交易场所。三种关系是生产者与消费者之间既同步又互斥、生产者之间互斥、消费者之间互斥;两个角色是生产者线程和消费者线程;一个场所是那块被共同访问的共享缓冲区。
阻塞队列与普通队列的区别只有两条:空的时候取元素阻塞,满的时候放元素阻塞。用互斥量加两个条件变量实现:
#ifndef __BLOCK_QUEUE_HPP__
#define __BLOCK_QUEUE_HPP__

#include <queue>
#include <pthread.h>

template <typename T>
class BlockQueue
{
public:
    explicit BlockQueue(int cap) : _cap(cap)
    {
        pthread_mutex_init(&_mutex, nullptr);
        pthread_cond_init(&_product_cond, nullptr);
        pthread_cond_init(&_consum_cond, nullptr);
    }

    ~BlockQueue()
    {
        pthread_mutex_destroy(&_mutex);
        pthread_cond_destroy(&_product_cond);
        pthread_cond_destroy(&_consum_cond);
    }

    void Enqueue(const T &in)
    {
        pthread_mutex_lock(&_mutex);
        while ((int)_queue.size() == _cap) {
            pthread_cond_wait(&_product_cond, &_mutex);
        }
        _queue.push(in);
        pthread_mutex_unlock(&_mutex);
        pthread_cond_signal(&_consum_cond);
    }

    void Pop(T *out)
    {
        pthread_mutex_lock(&_mutex);
        while (_queue.empty()) {
            pthread_cond_wait(&_consum_cond, &_mutex);
        }
        *out = _queue.front();
        _queue.pop();
        pthread_mutex_unlock(&_mutex);
        pthread_cond_signal(&_product_cond);
    }

private:
    std::queue<T> _queue;
    int _cap;
    pthread_mutex_t _mutex;
    pthread_cond_t _product_cond;
    pthread_cond_t _consum_cond;
};
#endif
为什么是两个条件变量而不是一个加 broadcast?一个也能跑,但生产者放完数据会把所有消费者和生产者的等待者一起叫醒,被叫醒的生产者发现还是满的,回去接着等。两个条件变量让"队列非空"和"队列不满"各自有一队人,唤醒只落在该动的那些线程上。
课件版本还在两个条件旁各挂了一个等待计数 _productor_wait_num/_consumer_wait_num,发出信号前先判断 if (_consumer_wait_num > 0)。原因是 pthread_cond_signal 在无人等待时什么也不做、信号直接消失;有计数就能避免"以为通知过了"的判断错误,也能省掉无意义的系统调用。
课件特别标了 // 伪唤醒 和 // 保证代码的健壮性,说的就是这里的 while——被唤醒后重新检查满/空,别假定醒来就一定能干活。
另外注意这份实现里把 signal 放在了 unlock 之后,临界区因此更短;课件版本把 signal 放在锁内,两种写法都正确,前者少一次"被唤醒却先卡在锁上"的调度。
单生产者单消费者时其实不加锁也不会错——队列头尾各由一个线程碰;改成多生产多消费后代码一行没变仍然正确,因为锁一直保护着整条队列。锁提前放对位置,扩展就是加线程数。
信号量与环形队列
POSIX 信号量(semaphore)和条件变量解决的是同一类问题,但它是带计数的:sem_wait 把值减 1,值已经是 0 时阻塞;sem_post 把值加 1 并唤醒一个等待者。
#include <semaphore.h>

int sem_init(sem_t *sem, int pshared, unsigned int value);
value 是初值;pshared 为 0 表示线程间共享,非 0 表示进程间共享(此时信号量本身必须位于一块共享内存中,否则另一个进程看不到它)。另有 sem_destroy、sem_wait(P 操作)、sem_post(V 操作)。
课件给的封装很短:
#pragma once
#include <semaphore.h>

class Sem
{
public:
    explicit Sem(int n) { sem_init(&_sem, 0, n); }
    ~Sem() { sem_destroy(&_sem); }
    void P() { sem_wait(&_sem); }
    void V() { sem_post(&_sem); }

private:
    sem_t _sem;
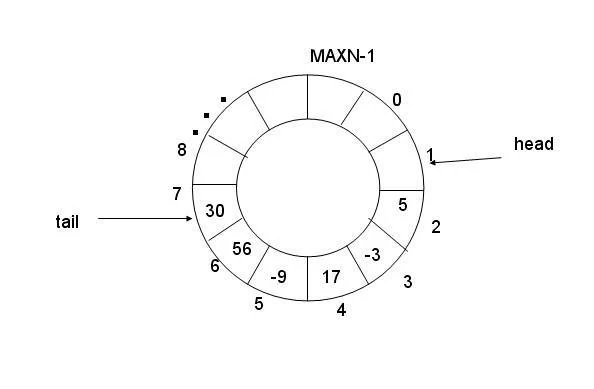
};环形队列用数组加取模模拟成一个环。环的难点是空和满长得一样,课件列了三种判断办法:加计数器、加标记位、故意空出一个位置。这里不需要这三种,因为信号量本身就是计数器:room_sem 初值是容量,表示还有几个空位;data_sem 初值是 0,表示已有几个元素。
#include <vector>
#include <pthread.h>
#include "Sem.hpp"          /* 上面那份封装,存成文件即可 */

template <typename T>
class RingQueue
{
public:
    explicit RingQueue(int cap)
        : _ring(cap), _cap(cap), _productor_step(0), _consumer_step(0),
          _room(cap), _data(0)
    {
        pthread_mutex_init(&_productor_mutex, nullptr);
        pthread_mutex_init(&_consumer_mutex, nullptr);
    }

    void Enqueue(const T &in)
    {
        _room.P();
        pthread_mutex_lock(&_productor_mutex);
        _ring[_productor_step++] = in;
        _productor_step %= _cap;
        pthread_mutex_unlock(&_productor_mutex);
        _data.V();
    }

    void Pop(T *out)
    {
        _data.P();
        pthread_mutex_lock(&_consumer_mutex);
        *out = _ring[_consumer_step++];
        _consumer_step %= _cap;
        pthread_mutex_unlock(&_consumer_mutex);
        _room.V();
    }

private:
    std::vector<T> _ring;
    int _cap;
    int _productor_step;
    int _consumer_step;
    Sem _room;
    Sem _data;
    pthread_mutex_t _productor_mutex;
    pthread_mutex_t _consumer_mutex;
};
两把锁而不是一把:多个生产者只争写位置,多个消费者只争读位置,两组下标互不重叠,用一把锁会把读和写也串起来。唯一需要跨组协调的是"满了"和"空了",那由信号量挡住。
顺序必须是先 P() 再 lock()。反过来,队列满时生产者会拿着锁去睡,消费者想取数据时先卡在锁上,取不出来也就放不出空位,两边都醒不来。课件这份实现里 P 在前、V 在最后,正好是"先占资源,再动数据,最后归还资源"。
线程池:一条任务队列加固定数量的线程
线程池解决线程创建销毁的开销:任务短、数量大时,创建线程的时间可能比任务本身还长,突发请求下无限创建线程还会把内存和调度推到极限。固定线程池启动时建好 N 个线程,所有线程从一条任务队列里取任务。
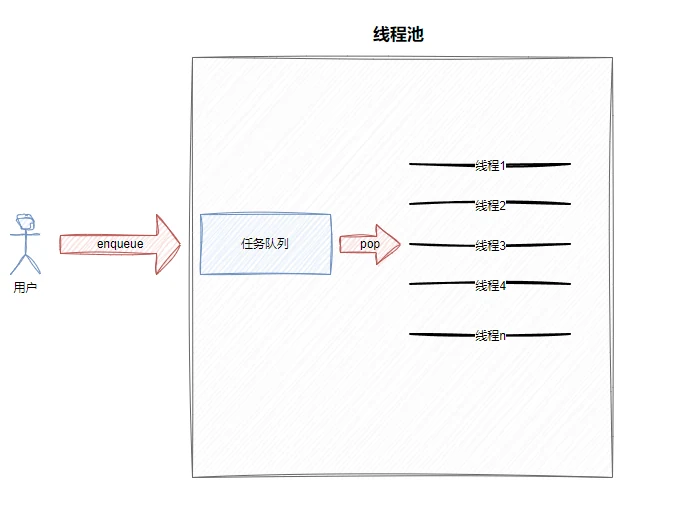
工作线程的主循环只有三步,但退出条件要写对。一个最小可跑的结构:
#include <functional>
#include <pthread.h>
#include <queue>
#include <vector>

class ThreadPool
{
public:
    using Task = std::function<void()>;

    explicit ThreadPool(int n) : _num(n), _waitnum(0), _running(true)
    {
        pthread_mutex_init(&_mutex, nullptr);
        pthread_cond_init(&_cond, nullptr);
        _threads.resize(_num);
        for (int i = 0; i < _num; i++)
            pthread_create(&_threads[i], nullptr, &ThreadPool::Entry, this);
    }

    ~ThreadPool()
    {
        pthread_mutex_destroy(&_mutex);
        pthread_cond_destroy(&_cond);
    }

    void Stop()
    {
        pthread_mutex_lock(&_mutex);
        _running = false;
        pthread_cond_broadcast(&_cond);
        pthread_mutex_unlock(&_mutex);
    }

    void Join()
    {
        for (auto &t : _threads)
            pthread_join(t, nullptr);
    }

    bool Enqueue(const Task &task)
    {
        pthread_mutex_lock(&_mutex);
        if (!_running) {
            pthread_mutex_unlock(&_mutex);
            return false;
        }
        _queue.push(task);
        if (_waitnum > 0)
            pthread_cond_signal(&_cond);
        pthread_mutex_unlock(&_mutex);
        return true;
    }

private:
    static void *Entry(void *arg)
    {
        static_cast<ThreadPool *>(arg)->Run();
        return nullptr;
    }

    void Run()
    {
        while (true) {
            pthread_mutex_lock(&_mutex);
            while (_queue.empty() && _running) {
                _waitnum++;
                pthread_cond_wait(&_cond, &_mutex);
                _waitnum--;
            }
            if (_queue.empty() && !_running) {
                pthread_mutex_unlock(&_mutex);
                break;
            }
            Task t = _queue.front();
            _queue.pop();
            pthread_mutex_unlock(&_mutex);
            t();
        }
    }

    int _num;
    std::vector<pthread_t> _threads;
    std::queue<Task> _queue;
    pthread_mutex_t _mutex;
    pthread_cond_t _cond;
    int _waitnum;
    bool _running;
};
Run 里两个 while 的含义不同。内层是条件变量的等待条件:队列空且还在运行就睡;外层是线程生命周期。中间那个 if 处理 Stop 之后的收尾——队列空且已停止才退出,队列里还有任务就继续取完。所以 Stop 只是"不再接收新任务",不是"立刻丢掉线程",Enqueue 里那句 if (!_running) 才是拒收的开关。
Stop 必须持锁改 _running,再广播;否则线程可能刚判断完 _running 为真就睡下去,错过这次唤醒,然后一直等一个不会再有任务来的队列。析构之前要先 Stop 再 Join,线程还在 Run 里转的时候销毁互斥量是未定义行为。
日志这块课件用策略模式(strategy pattern)做:LogStrategy 只暴露 SyncLog,ConsoleLogStrategy 写 std::cerr(显示器也是临界资源,内部要加锁),FileLogStrategy 追加到文件。Logger 持有策略指针,LogMessage 是内部类,构造时拼好 [时间][等级][pid][文件][行号] - 前缀,重载 operator<< 继续追加,析构时调用策略落盘——一条语句写完,析构即刷新。__FILE__ 和 __LINE__ 由 LOG(type) 宏注入,不用手写。
课件的时间格式化有一处错误:
snprintf(timebuffer, sizeof(timebuffer), "%4d-%02d-%02d %02d:%02d:%02d",
         curr.tm_year + 1900, curr.tm_mon, curr.tm_mday,
         curr.tm_hour, curr.tm_min, curr.tm_sec);
struct tm 里 tm_year 是从 1900 起算的年数、tm_mon 是 0~11,所以年份要 +1900(这里写了),月份要 +1(漏了)。课件跑出来的日志里八月会显示成 07。另外年份用 %4d,遇到三位数的年份不会补零,写 %04d 更稳。
线程池做成单例,课件给了饿汉、懒汉、双重检查三版。饿汉版是 static T data; 加 GetInstance 返回地址;懒汉版第一次调用时 new,但两个线程同时进来可能 new 两次;双重检查版用 if (inst == NULL) { lock; if (inst == NULL) inst = new T(); } 把锁限制在第一次。
这里要更正一处:课件注释写"需要设置 volatile 关键字,否则可能被编译器优化"。volatile 只管"每次从内存读",不提供任何跨线程的顺序保证,inst = new T() 里"分配内存"和"写指针"之间仍可能被重排,另一个线程拿到非空指针时对象还没构造完,这是数据竞争。C++11 的写法是把锁省掉:
template <typename T>
class Singleton
{
public:
    static T *GetInstance()
    {
        static T inst;
        return &inst;
    }

private:
    Singleton() = default;
};
函数内的静态局部变量,C++11 起由标准保证"第一次经过时初始化,且只初始化一次、多线程安全"(编译器会插入一个原子守卫)。要动态分配就配 std::atomic<T*> 加 acquire/release,或者干脆用 std::call_once。volatile 在这两种方案里都不需要。
死锁:申请一把锁原子,申请两把就不是
死锁(deadlock)的定义是:一组执行流各占着不会释放的资源,又都去申请别人占着的资源,于是永久等待。线程 A 持有锁 1 等锁 2,线程 B 持有锁 2 等锁 1,两条箭头首尾相接。
申请一把锁是原子的,申请两把不是——两把锁之间存在时间窗,只要两个线程的申请顺序相反,就必然有一对能卡住。
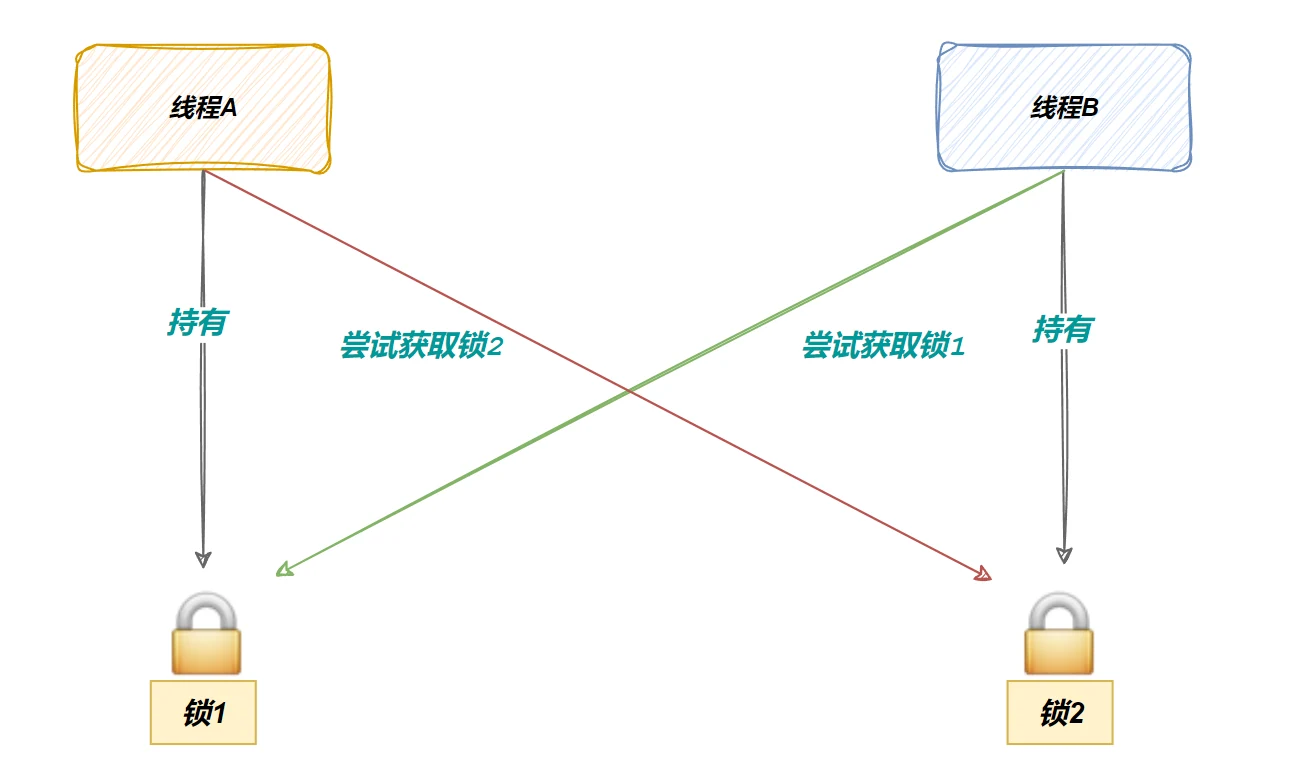
死锁成立要同时满足四个条件,缺一不可:
- 互斥:一个资源每次只能被一个执行流使用;
- 请求与保持:申请新资源时阻塞,但已获得的资源不放;
- 不剥夺:已获得的资源在使用完之前不能被强行抢走;
- 循环等待:若干执行流之间形成头尾相接的等待环。
课件用两个共享计数器和两把锁演示了后果。不加锁时十个线程各加一万次,结果对不齐:
Shared Resource 1: 94416
Shared Resource 2: 94536
把两把锁一次性拿走,两个数都回到 100000:
#include <mutex>
#include <thread>
#include <vector>
#include <iostream>

int shared_resource1 = 0;
int shared_resource2 = 0;
std::mutex mtx1, mtx2;

void access_shared_resources()
{
    std::unique_lock<std::mutex> lock1(mtx1, std::defer_lock);
    std::unique_lock<std::mutex> lock2(mtx2, std::defer_lock);
    std::lock(lock1, lock2);

    for (int i = 0; i < 10000; ++i) {
        ++shared_resource1;
        ++shared_resource2;
    }
}

int main()
{
    std::vector<std::thread> threads;
    for (int i = 0; i < 10; ++i)
        threads.emplace_back(access_shared_resources);
    for (auto &t : threads)
        t.join();
    std::cout << shared_resource1 << " " << shared_resource2 << std::endl;
    return 0;
}
std::lock 用一套内部的尝试与回退算法,保证要么两把都拿到,要么一把都不拿,中间不会出现"拿了一把再等另一把"。它配合 defer_lock 构造的 unique_lock 使用,析构时自动解锁。
其余三种避免手段是:加锁顺序统一(所有线程按同一编号顺序申请)、资源一次性分配(要么全给要么不给)、超时机制(try_lock_for 拿不到就退回去重试,避免无限等待)。死锁检测算法和银行家算法属于理论工具,实际工程里主要靠前两条。
可重入、STL 与几种"锁"的说法
线程安全说的是多个线程访问共享资源时结果正确;可重入(reentrant)说的是一个函数在执行完之前被另一个执行流再次进入,结果仍然正确。重入有两种来源:多线程,以及信号处理函数打断当前执行流。
| 常见的线程不安全 | 常见的不可重入 |
|---|---|
| 不保护共享变量的函数 | 调用了 malloc/free(堆由全局链表管理) |
| 函数状态随调用而变化 | 调用了标准 IO 库函数 |
| 返回指向静态变量指针的函数 | 函数体内用了静态数据结构 |
| 调用了线程不安全函数的函数 | 返回静态或全局数据 |
两者之间的关系不难记:可重入一定是线程安全的;线程安全不一定可重入——给函数加锁能让多线程正确,但同一个线程重入时锁还没释放,非递归互斥量会自锁,所以它不可重入。
课件有一句要收窄:"如果一个函数中有全局变量,那么这个函数既不是线程安全也不是可重入的"。只有在写全局变量时才成立;只读的全局表是线程安全的,课件自己后面的列表里也写了"每个线程对全局变量只有读取权限时一般是安全的"。两处说法对不上,按后者为准。
STL 容器默认不是线程安全的。这不是疏忽,是取舍:加锁会吃掉性能,而且不同容器的锁法不一样(哈希表是锁表还是锁桶),标准没法替所有场景做决定,只能交给调用者。unique_ptr 只在一个代码块内生效,不涉及共享;shared_ptr 的引用计数由多个对象共用,标准实现用原子操作(CAS)保证计数的增减是原子的。注意原子的是计数,shared_ptr 对象本身的读写、以及它指向的对象都不是线程安全的。
课件最后列了几种锁的名字,后面加餐课才展开,这里各留一句:悲观锁取数据前先加锁;乐观锁不加锁,更新前用版本号或 CAS 校验;CAS 是"比较当前内存值与期望值,相等才写新值,不等就重试",通常是一个自旋过程;自旋锁、读写锁按名字即可理解使用场景。
还没有评论 — 第一条由你来留。